
Ver5.0 엑셀 때문에 유전자 이름이 바뀌었다? 🧬📅 과학계를 뒤흔든 '자동 날짜 변환' 사건 총정리
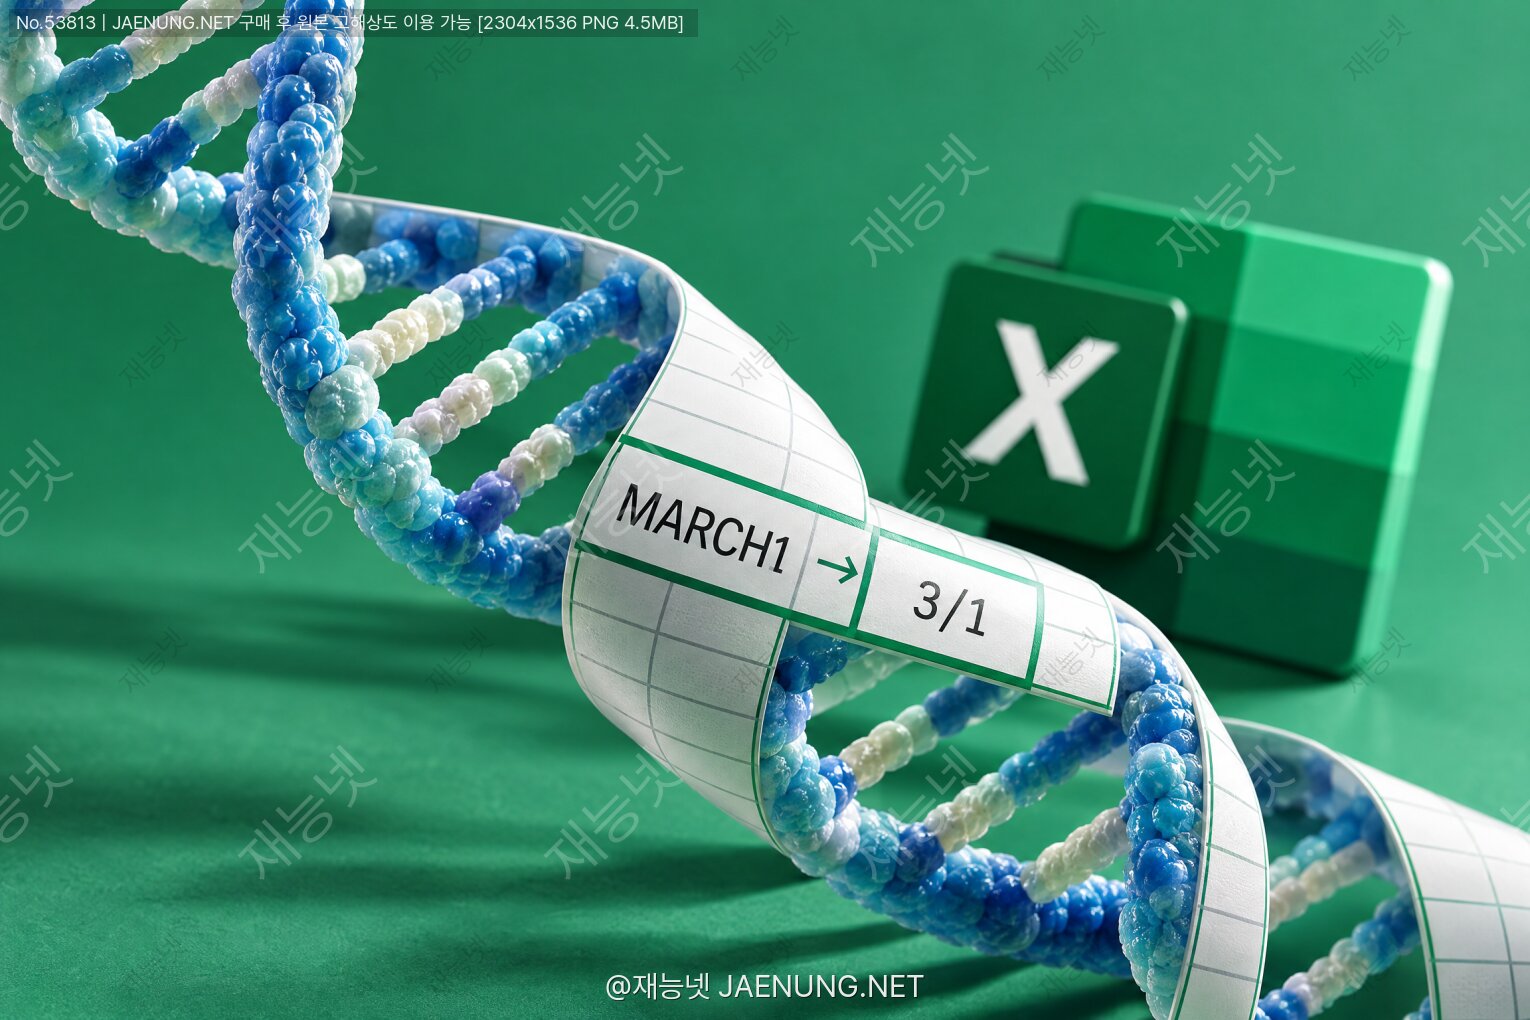
엑셀 때문에 유전자 이름이 바뀌었다? 🧬📅 과학계를 뒤흔든 '자동 날짜 변환' 사건 총정리
친구야, 이거 실화야. 전 세계 과학자들이 쓰는 유전자 공식 이름이 실제로 바뀌었는데, 그 이유가 놀랍게도 엑셀(Excel)이 자꾸 유전자 이름을 날짜로 바꿔버려서였어. 😂
"MARCH1"을 입력했더니 "1-Mar"(3월 1일)이 되고, "SEPT2"를 넣었더니 "2-Sep"(9월 2일)이 되는 바로 그 현상! 오늘은 이 웃프고도 진지한 이야기를 처음부터 끝까지 팩트로만 털어볼게.
1. 도대체 무슨 일이 있었던 거야? 🤔
엑셀은 사용자를 "도와주려고" 입력값을 자동으로 해석해. 날짜처럼 생긴 글자를 보면 "아, 날짜 쓰려고 했구나!" 하고 곧바로 날짜 데이터로 바꿔버리지. 가계부 쓸 때는 고마운 기능인데, 유전학 연구자에게는 그야말로 재앙이었어.
인간 유전자 중에는 이름이 영어 월(月) 약자와 숫자로 이루어진 것들이 있었거든. 예를 들어 MARCH1(Membrane-Associated Ring-CH-type finger 1), SEPT1~SEPT14(Septin 계열), DEC1(Deleted in Esophageal Cancer 1) 같은 이름들이야. 이걸 엑셀에 붙여넣으면 각각 3월 1일, 9월 1일, 12월 1일로 바뀌어. 더 무서운 건 엑셀이 그 값을 내부적으로 날짜 일련번호(숫자)로 저장하기 때문에, 나중에 서식을 "텍스트"로 바꿔도 원래 이름으로 돌아오지 않는다는 거야. 예를 들면 "43891" 같은 숫자로 보일 뿐이지.
📌 엑셀이 날짜를 저장하는 방식엑셀(Windows 기본 1900 날짜 체계)은 1900년 1월 1일을 1로 두고 하루마다 1씩 늘어나는 일련번호로 날짜를 저장해. 그래서 "SEPT2"가 "2-Sep"으로 변하는 순간, 셀 안에는 그 해 9월 2일에 해당하는 숫자가 들어가 있어. 원래 글자 "SEPT2"는 흔적도 없이 사라진 거지. 😱
날짜만 문제가 아니었어. 일본 이화학연구소(RIKEN)의 클론 식별자처럼 "2310009E13"같이 생긴 ID는 엑셀이 "E"를 지수 표기로 해석해서 2.31E+13이라는 부동소수점 숫자로 바꿔버렸지. 이 역시 원래 값이 손실되는 치명적인 변환이야.
2. 처음 경고한 사람들: 2004년 논문 📄
이 문제를 학계에 공식적으로 알린 건 2004년이야. 미국 국립암연구소(NCI) 소속 Barry Zeeberg 등의 연구진이 학술지 BMC Bioinformatics에 「Mistaken Identifiers: Gene name errors can be introduced inadvertently when using Excel in bioinformatics」라는 논문을 발표했어.
이들은 엑셀 기본 설정이 유전자 기호를 날짜로, RIKEN 식별자를 부동소수점 숫자로 되돌릴 수 없게 바꾼다는 사실을 보고했고, 이런 오류가 공개 데이터베이스에까지 흘러들어가 있다고 경고했어. 즉 "누군가의 엑셀 실수"가 "모두가 내려받는 데이터"를 오염시킬 수 있다는 뜻이었지.
하지만 경고는 경고일 뿐… 사람들은 계속 엑셀을 썼어. 왜냐고? 너무 편하니까! 😅
3. 얼마나 심각했을까? 숫자로 보는 충격 📊
2016년, 호주 베이커 심장·당뇨연구소(Baker IDI)의 Mark Ziemann, Yotam Eren, Assam El-Osta 연구팀이 학술지 Genome Biology에 「Gene name errors are widespread in the scientific literature」를 발표했어. 이들은 2005~2015년 사이 주요 학술지 18곳에 실린 논문의 보충자료(엑셀 파일)를 자동으로 스캔했는데, 결과가 꽤 충격적이었어.
2016년 연구에서는 유전자 목록이 담긴 엑셀 보충자료를 포함한 논문 3,597편 중 704편(약 19.6%)에서 유전자 이름 오류가 발견됐어. 대략 다섯 편 중 한 편꼴이지. 연구팀은 이 비율이 해마다 줄기는커녕 오히려 연평균 15%씩 늘고 있다고 보고했어.
그럼 그 뒤로는 좋아졌을까? 아니었어. 2021년 Ziemann 연구팀(Mandhri Abeysooriya 등)이 PLOS Computational Biology에 낸 후속 연구 「Gene name errors: Lessons not learned」에서는 2014~2020년 논문 11,117편 중 3,436편(약 30.9%)에서 오류가 확인됐어. 제목부터 "교훈을 얻지 못했다"라니, 과학자들의 한숨이 들리는 것 같지 않아? 😮💨
⚠️ 왜 이게 위험할까?논문 보충자료는 다른 연구자들이 그대로 내려받아 재분석해. 날짜로 변한 유전자는 분석 과정에서 "없는 유전자"로 취급되어 조용히 빠져버리거나, 엉뚱하게 매칭될 수 있어. 특정 질병과 관련된 유전자가 하필 SEPTIN 계열이었다면? 중요한 결과가 통째로 묻힐 수도 있다는 얘기야.
4. 결국 유전자 이름을 바꿔버린 HGNC ✍️
유전자 이름은 아무나 붙이는 게 아니야. 인간 유전자의 공식 명칭은 HGNC(HUGO Gene Nomenclature Committee, 인간 유전체 기구 유전자 명명 위원회)가 관리해. 이 위원회는 2020년 학술지 Nature Genetics에 새 「인간 유전자 명명 가이드라인(Guidelines for human gene nomenclature)」을 발표하면서, "데이터 처리와 검색에 영향을 주는 기호"도 변경 사유가 될 수 있다는 원칙을 담았어. 바로 엑셀 자동 변환 문제를 염두에 둔 거야.
그 결과 날짜로 오인될 수 있는 유전자 기호들이 하나둘 새 이름을 얻었어. 해외 IT 매체 The Verge는 2020년 8월, 지난 1년간 이런 이유로 약 27개의 인간 유전자 기호가 바뀌었다고 보도했지.
| 옛 기호 | 엑셀에서 변한 모습 | 새 공식 기호 |
|---|---|---|
| MARCH1 ~ MARCH11 | 1-Mar 등 (3월) | MARCHF1 ~ MARCHF11 |
| SEPT1 ~ SEPT14 | 1-Sep 등 (9월) | SEPTIN1 ~ SEPTIN14 |
| MARC1, MARC2 | 1-Mar, 2-Mar | MTARC1, MTARC2 |
| DEC1 | 1-Dec (12월) | DELEC1 |
재밌는 건, HGNC가 이름을 바꾸는 걸 원래 아주 신중하게 한다는 점이야. 유전자 이름은 수십 년치 논문, 데이터베이스, 진단 보고서에 얽혀 있어서 함부로 바꾸면 혼란이 생기거든. 그런데도 바꿨다는 건 그만큼 엑셀 문제가 컸다는 뜻이지. 결국 "소프트웨어를 바꾸기보다 이름을 바꾸는 게 더 현실적"이라는 판단이 내려진 셈이야. 이 사건이 "과학이 엑셀에 졌다"는 밈으로 퍼진 이유이기도 해. 🤣
💡 알아두면 좋은 포인트새 이름으로 바뀌었다고 옛 데이터가 자동으로 고쳐지진 않아. 과거 논문이나 공개 데이터셋에는 여전히 MARCH1, SEPT2 같은 옛 기호와 이미 날짜로 망가진 값이 남아 있어. 그래서 지금도 연구자들은 옛 데이터를 다룰 때 별칭(alias) 변환표를 함께 써야 해.
5. 타임라인으로 한 번에 정리 🕰️
Zeeberg 등, BMC Bioinformatics에서 엑셀의 유전자명 자동 변환 오류를 최초로 체계적으로 보고
Ziemann 등, Genome Biology 논문. 유전자 목록 포함 논문의 약 19.6%에서 오류 발견
HGNC 새 가이드라인(Nature Genetics) 발표, SEPTIN·MARCHF 등으로 개명
후속 연구 「Lessons not learned」, 오류율 약 30.9%로 오히려 증가
마이크로소프트, Microsoft 365용 엑셀에 '자동 데이터 변환' 끄기 옵션 도입
6. 마이크로소프트의 반격: 자동 변환 끄기 옵션 ⚙️
오랫동안 엑셀에는 날짜 자동 변환을 전역으로 끄는 스위치가 없었어. 그러다 2023년, 마이크로소프트는 Microsoft 365용 엑셀(Windows·Mac)에 "자동 데이터 변환(Automatic Data Conversion)" 설정을 추가했어. 공식 블로그에서도 과학자 커뮤니티의 요청을 언급했지.
경로는 파일 → 옵션 → 데이터 → 자동 데이터 변환(Mac은 Excel → 환경설정 → 편집)이고, 여기서 다음 네 가지를 각각 끌 수 있어.
단, 이 옵션은 비교적 최신 버전의 Microsoft 365 엑셀에서 제공되기 때문에 구버전(예: 오래된 영구 라이선스 버전)에서는 메뉴가 없을 수 있어. 또 동료 컴퓨터에서 파일을 다시 열고 저장하는 과정에서 변환이 일어날 수 있으니, 팀 전체가 같은 원칙을 지키는 게 중요해.
7. 내 데이터를 지키는 실전 방법 🛡️
꼭 유전학자가 아니어도 이 문제는 남 얘기가 아니야. 상품코드 "1-2", 우편번호 "01234", 사번 "00057", 주민번호 같은 긴 숫자, 카드번호… 엑셀이 "친절하게" 망가뜨리는 데이터는 우리 일상에도 널려 있거든. 실무에서 바로 쓰는 방법을 정리해 볼게.
✅ 방법 1. 입력 전에 열 서식을 '텍스트'로열 전체를 선택 → 마우스 오른쪽 → 셀 서식 → 텍스트. 반드시 데이터를 넣기 전에 해야 해. 이미 날짜로 바뀐 뒤에 서식을 바꾸면 일련번호만 보일 뿐 원래 글자는 돌아오지 않아.
✅ 방법 2. 작은따옴표(') 붙여 입력'SEPT2처럼 앞에 작은따옴표를 붙이면 엑셀이 텍스트로 인식해. 따옴표 자체는 셀에 표시되지 않아. 몇 개만 입력할 때 간편해.
✅ 방법 3. CSV는 더블클릭 대신 '가져오기'로CSV·TXT 파일을 더블클릭으로 열면 엑셀이 즉시 자동 변환을 해버려. 대신 데이터 탭 → 텍스트/CSV에서로 불러와 파워 쿼리 편집기에서 해당 열의 데이터 형식을 텍스트로 지정하자. 파워 쿼리가 자동으로 넣은 '변경된 유형' 단계를 삭제하거나 수정하는 것도 방법이야.
✅ 방법 4. 자동 데이터 변환 옵션 끄기Microsoft 365 사용자라면 앞서 본 옵션에서 날짜 변환 항목 체크를 해제해 두자. 한 번 설정해 두면 마음이 편해.
✅ 방법 5. 대용량 데이터는 전용 도구로유전체처럼 수만 행의 데이터는 R, Python(pandas) 같은 프로그래밍 도구로 다루는 게 안전해. 읽어들일 때 자료형을 문자열로 지정하면 변환 걱정이 없어.
파이썬을 쓴다면 이렇게 열 자료형을 문자열로 고정할 수 있어.
import pandas as pd

# 유전자 기호 열을 문자열로 고정해서 읽기
df = pd.read_csv("genes.csv", dtype={"gene_symbol": str})
print(df.head())
이미 망가진 파일을 받았을 때 빠르게 점검하려면, 유전자 기호 열에서 날짜 서식인 셀을 찾아보면 돼. 예를 들어 A2 셀이 실제 날짜 숫자인지 확인하려면 이런 수식이 쓸 만해.
=IF(ISNUMBER(A2),"⚠️ 숫자/날짜로 변환됨","정상 텍스트")Ziemann 연구팀은 이런 오류를 자동 탐지하는 웹 도구 Gene Name Errors Screen을 공개하기도 했어. 논문 보충자료를 업로드하기 전에 한 번 돌려보면 좋겠지?
8. 이 사건이 우리에게 남긴 교훈 🎓
이 이야기는 단순히 "엑셀 나빠!"로 끝나는 게 아니야. 오히려 도구의 기본값이 얼마나 큰 힘을 갖는지 보여주는 사례야. 수많은 사람이 기본 설정 그대로 쓰기 때문에, 작은 자동 기능 하나가 전 세계 과학 문헌의 30%에 흔적을 남길 수도 있었던 거지.
실무에서 엑셀을 매일 쓰는 직장인이라면 더더욱 공감될 거야. 코드번호 앞의 0이 사라져 거래처 데이터가 꼬이거나, 긴 계좌번호 뒷자리가 0으로 바뀌는 일은 정말 흔하거든. 이런 데이터 정리, 파워 쿼리 자동화, 엑셀 서식 설계가 막막하다면 재능넷에서 엑셀 전문가의 도움을 받아보는 것도 좋은 방법이야. 한 번 제대로 템플릿을 만들어 두면 두고두고 시간을 아낄 수 있지.
🧬 한 줄 요약엑셀이 MARCH1·SEPT2 같은 유전자 기호를 날짜로 바꾸는 문제가 2004년부터 보고됐고, 논문의 약 20~30%에서 오류가 확인되자 2020년 HGNC가 MARCHF1·SEPTIN2 등으로 이름을 바꿨어. 2023년엔 엑셀에도 자동 변환 끄기 옵션이 생겼지. 결론: 데이터 넣기 전에 '텍스트 서식' 먼저! 이것만 기억해도 너는 이미 데이터 고수야. 😎
다음에 엑셀에 뭔가를 붙여넣을 때, 혹시 "3월 1일"이 튀어나오면 오늘 이야기가 떠오를 거야. 그때 씩 웃으면서 "아, 이게 그 유전자 이름까지 바꾼 기능이구나!" 하고 우아하게 서식을 바꿔주자. 엑셀을 잘 쓰는 사람은 기능을 많이 아는 사람이 아니라, 엑셀이 몰래 하는 일을 아는 사람이니까! 재능넷 지식인의 숲에서 또 재밌는 이야기로 만나자. 👋
참고 자료
Zeeberg BR et al. (2004) "Mistaken Identifiers: Gene name errors can be introduced inadvertently when using Excel in bioinformatics", BMC Bioinformatics 5:80 – https://bmcbioinformatics.biomedcentral.com/articles/10.1186/1471-2105-5-80
Ziemann M, Eren Y, El-Osta A. (2016) "Gene name errors are widespread in the scientific literature", Genome Biology 17:177 – https://genomebiology.biomedcentral.com/articles/10.1186/s13059-016-1044-7
Abeysooriya M et al. (2021) "Gene name errors: Lessons not learned", PLOS Computational Biology – https://journals.plos.org/ploscompbiol/article?id=10.1371/journal.pcbi.1008984
Bruford EA et al. (2020) "Guidelines for human gene nomenclature", Nature Genetics 52 – https://www.nature.com/articles/s41588-020-0669-3
The Verge (2020.08) "Scientists rename human genes to stop Microsoft Excel from misreading them as dates" – https://www.theverge.com/2020/8/6/21355674/human-genes-rename-microsoft-excel-misreading-dates
HGNC 공식 사이트 – https://www.genenames.org
Microsoft 지원 "Control data conversions in Excel" – https://support.microsoft.com/office/control-data-conversions-in-excel-for-windows-and-mac-c50e6a5a-46b0-4e0c-a8dc-4f86e57f6b51
관련 키워드

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.


아직 댓글이 없습니다.