
Ver5.0 ⚡ CPU 캐시는 왜 빠를까? L1·L2·L3 메모리 계층의 원리와 성능의 비밀 🧠
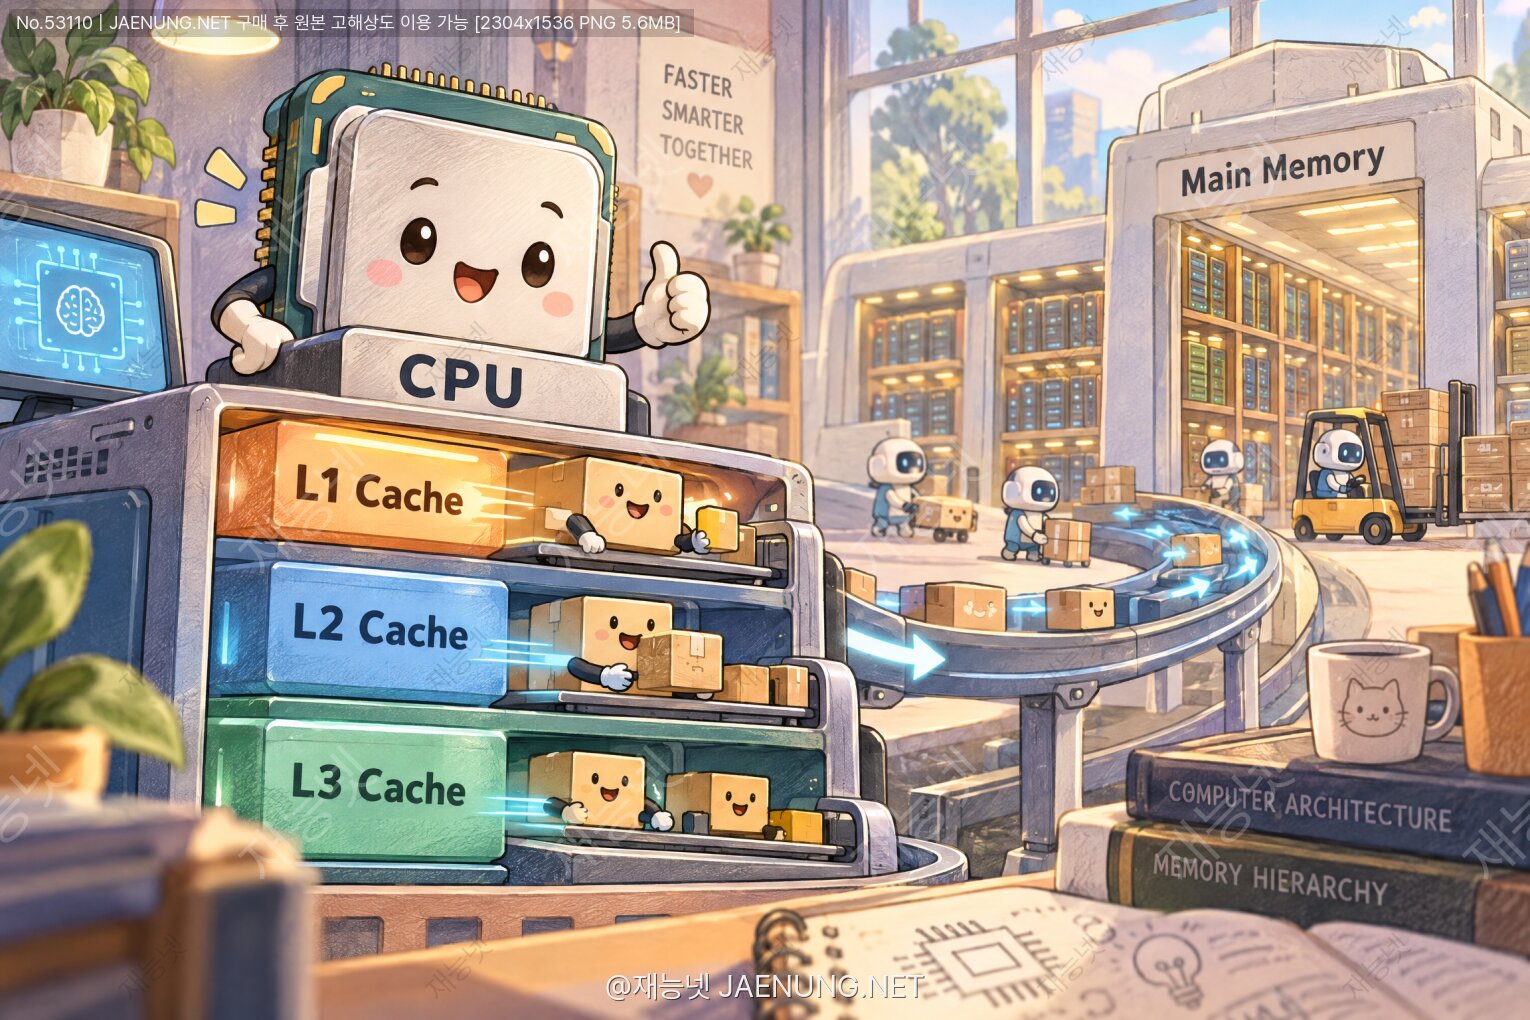
⚡ CPU 캐시는 왜 빠를까? L1·L2·L3 메모리 계층의 원리와 성능의 비밀 🧠
야, 혹시 이런 생각 해본 적 있어? "요즘 CPU는 몇 GHz씩 돌아간다는데, RAM이 16GB, 32GB나 되는데 왜 굳이 몇 MB짜리 '캐시'라는 걸 또 따로 둘까?"
오늘은 그 질문 하나로 CPU 속을 끝까지 파고들어 볼 거야. 다 읽고 나면 CPU 스펙표에서 "L2 2MB, L3 36MB" 같은 숫자가 그냥 숫자가 아니라 설계자들이 물리 법칙과 싸운 흔적으로 보이게 될 거라고 장담해 😎
지연 시간은 최신 데스크톱 CPU 기준의 대략적인 크기 감각이며, 제품·클럭마다 달라져.
🚀 1. 출발점: CPU는 너무 빠르고 메모리는 너무 느리다
먼저 상황 파악부터 하자. 요즘 데스크톱 CPU는 4~6GHz 정도로 돌아가. 5GHz면 1클럭이 0.2나노초(ns)야. 그리고 최신 코어는 한 클럭에 명령어를 여러 개씩 처리하지. 그런데 메인 메모리(DRAM)에서 데이터를 하나 가져오려면 보통 수십~100ns 정도가 걸려. 계산해보면 메모리 한 번 기다리는 동안 CPU는 수백 클럭을 멍때릴 수 있다는 얘기야.
이 격차를 컴퓨터 구조 분야에서는 메모리 벽(Memory Wall)이라고 불러. 1990년대 중반 Wulf와 McKee가 논문에서 이 표현을 쓰면서 유명해졌는데, 핵심 주장은 간단했어. "프로세서 속도는 해마다 엄청 빨라지는데 DRAM 지연 시간은 그만큼 줄지 않는다. 이대로 가면 결국 CPU 성능은 메모리가 결정하게 된다."
실제로 DRAM은 용량과 대역폭(한 번에 퍼나르는 양)은 세대마다 크게 늘었지만, "첫 데이터가 도착할 때까지의 시간", 즉 지연 시간(latency)은 수십 년째 수십 ns 언저리에 머물러 있어. DDR4에서 DDR5로 넘어가도 지연 시간이 확 줄진 않았지.
🕐 사람 시간으로 바꿔보면 체감이 확 와
1ns를 1초라고 쳐볼게.
• L1 캐시 접근 ≈ 1초 (책상 위 메모 보기)
• L2 캐시 접근 ≈ 3~5초 (서랍 열기)
• L3 캐시 접근 ≈ 10~20초 (방 책장 가기)
• 메인 메모리 ≈ 1분 반 내외 (집 앞 편의점 다녀오기)
• NVMe SSD 읽기(약 100µs) ≈ 하루 넘게 (다른 도시 창고 택배 받기)
• HDD 탐색(수 ms) ≈ 몇 달
그러니까 CPU 입장에서 메모리 접근은 "잠깐 편의점"이고, 디스크는 "이민"이야 😂
그럼 해결책은? "빠른 메모리를 크게 만들면 되잖아!"라고 하고 싶겠지만, 그게 안 돼. 빠른 메모리는 비싸고, 크고, 전기를 많이 먹고, 무엇보다 크게 만들수록 느려져. 이게 오늘 이야기의 핵심 아이러니야. 그래서 설계자들이 낸 답이 바로 "작고 빠른 것부터 크고 느린 것까지 층층이 쌓자", 즉 메모리 계층(Memory Hierarchy)이야.
🔬 2. 캐시가 빠른 첫 번째 이유: 재료부터 다르다 (SRAM vs DRAM)
캐시와 메인 메모리는 둘 다 "메모리"지만 만드는 방식 자체가 달라.
한 비트를 저장하는 데 보통 트랜지스터 6개(6T)를 써. 트랜지스터 두 쌍이 서로 물고 늘어지는 "래치" 구조라서 전원만 있으면 값이 계속 유지돼. 읽을 때도 값이 안 깨지고 신호가 강해서 빠르게 읽혀.
대신 한 비트에 6개니까 면적이 크고 비싸.
한 비트를 트랜지스터 1개 + 커패시터 1개(1T1C)로 저장해. 작은 축전기에 전하가 있으면 1, 없으면 0. 엄청 촘촘하게 만들 수 있어서 싸고 대용량이야.
단점은 전하가 새서 주기적으로 리프레시해야 하고, 읽을 때 미세한 전하를 증폭하는 과정이 필요해 느려.
여기에 하나 더. DRAM은 CPU 칩 바깥, 메인보드의 메모리 슬롯에 꽂혀 있어. 반면 캐시 SRAM은 CPU 다이(실리콘 칩) 안, 코어 바로 옆에 있지. 데이터를 가지러 칩 밖으로 나가서 메모리 컨트롤러를 거쳐 DRAM 칩의 행(row)을 열고, 열(column)을 고르고, 다시 돌아오는 과정 전체가 지연 시간이 되는 거야. DRAM 스펙의 CL(CAS Latency), tRCD, tRP 같은 타이밍 숫자가 바로 이 단계들의 대기 시간이야.
💡 그럼 전부 SRAM으로 만들면?
이론상 가능하지만 32GB를 SRAM으로 만들면 칩 면적이 현실적으로 불가능한 수준이 되고 가격도 감당이 안 돼. 실제로 최신 CPU에서 수십 MB의 캐시만으로도 다이 면적의 상당 부분을 차지해. 게다가 아래에서 볼 이유 때문에, 그렇게 큰 SRAM은 어차피 빠르지도 않아.
📏 3. 두 번째 이유: 작고 가까워야 빠르다 (물리 법칙 이야기)
"그럼 L3도 SRAM이고 L1도 SRAM인데 왜 L1이 훨씬 빨라?" 아주 좋은 질문이야. 같은 SRAM이어도 크기와 거리가 속도를 갈라.
배선 지연: 칩 안의 신호는 금속 배선을 타고 가는데, 배선이 길수록 저항(R)과 용량(C)이 커져서 신호가 느려져. 미세 공정이 될수록 트랜지스터는 빨라지는데 가는 배선의 RC 지연은 오히려 골칫거리가 됐어. 큰 캐시는 배선이 길 수밖에 없지.
찾는 범위: 캐시가 크면 "내가 찾는 데이터가 어디 있나" 확인할 칸(엔트리)이 많아져. 주소를 디코딩하고, 긴 비트라인에서 신호를 감지하고, 여러 태그를 비교하는 회로가 전부 커지고 느려져.
빛의 속도도 한계: 빛은 진공에서 1ns에 약 30cm를 가. 칩 배선 속 신호는 그보다 훨씬 느려. 5GHz의 1클럭(0.2ns)이면 이상적으로도 몇 cm 수준이고, 실제 배선 속도는 훨씬 짧아서 다이를 가로질러 갔다 오는 것도 클럭 여러 개가 들어. 그래서 정말 빨라야 하는 L1은 코어의 실행 유닛 바로 옆에 붙어 있어.
포트와 전력: L1은 한 클럭에 여러 번 읽고 쓸 수 있어야 해(로드 2~3개, 스토어 1~2개 동시). 이런 다중 포트 구조는 비싸서 작은 용량에서만 감당돼.
그래서 결론이 이거야. 빠름과 큼은 동시에 가질 수 없다. 그러니 작고 빠른 것을 가까이, 크고 느린 것을 멀리 두고 계층을 만든다. 이게 L1·L2·L3가 존재하는 이유야.
🎯 4. 세 번째 이유(진짜 핵심): 프로그램은 '버릇'이 있다 — 지역성
여기까지 들으면 이런 의문이 들어야 정상이야. "아니 캐시가 겨우 몇 MB인데, 그게 GB 단위 메모리를 어떻게 커버해?"
비밀은 지역성(Locality of Reference)이라는 프로그램의 습관에 있어. 캐시는 사실 "미래를 예측하는 장치"에 가까워. 그리고 그 예측이 생각보다 엄청 잘 맞아.
"방금 쓴 건 곧 또 쓴다."
반복문의 카운터 변수, 자주 호출되는 함수 코드, 계속 갱신되는 합계 변수 같은 것들. 한 번 캐시에 올려두면 그 뒤 수천 번 접근이 전부 캐시에서 해결돼.
"방금 쓴 것 근처도 곧 쓴다."
배열을 처음부터 끝까지 도는 코드, 순서대로 실행되는 명령어들. 그래서 캐시는 1바이트만 가져오지 않고 주변 덩어리를 통째로 가져와.
그 "덩어리"를 캐시 라인(cache line)이라고 해. x86 계열(인텔·AMD)과 대부분의 ARM 코어에서 캐시 라인 크기는 64바이트야. (애플 M 시리즈처럼 일부 칩은 128바이트 라인을 쓰기도 해.) 네가 int 하나(4바이트)를 읽으면 CPU는 그걸 포함한 64바이트를 통째로 가져와. 그러면 바로 옆 15개의 int는 공짜로 따라온 셈이지. 배열을 순서대로 읽으면 16번 중 1번만 느리고 15번은 캐시 히트가 되는 거야.
🙋 친구: 결국 캐시가 빠른 이유가 SRAM이라서야, 지역성 때문이야?
🧑💻 나: 둘 다! SRAM+가까운 거리는 "캐시에 있을 때 빠른 이유"고, 지역성은 "필요한 게 캐시에 있을 확률이 높은 이유"야. 아무리 빠른 캐시도 데이터가 없으면(미스) 소용없거든. 일반적인 프로그램에서 L1 히트율은 90%대가 흔해. 그래서 평균적으로 보면 메모리가 거의 캐시 속도처럼 느껴지는 거지.
📐 5. 숫자로 증명하기: 평균 메모리 접근 시간(AMAT)
계층이 얼마나 효과적인지 공식 하나로 보여줄게. 컴퓨터 구조 교과서(Hennessy & Patterson)에 나오는 AMAT(Average Memory Access Time)이야.
계층이 여러 개면 미스 페널티 자리에 다음 단계의 AMAT가 재귀적으로 들어가. 예시 숫자로 해보자. (설명용 가정 숫자야.)
• L1: 히트 시간 1ns, 미스율 5%
• L2: 히트 시간 4ns, (L1에서 놓친 것 중) 미스율 30%
• L3: 히트 시간 15ns, (L2에서 놓친 것 중) 미스율 40%
• DRAM: 90ns
L3 단계 = 15 + 0.4 × 90 = 51ns
L2 단계 = 4 + 0.3 × 51 = 19.3ns
L1 단계 = 1 + 0.05 × 19.3 ≈ 1.97ns
👉 캐시가 없었다면 매번 90ns. 캐시가 있으니 평균 약 2ns. 약 45배 차이야!
이 계산에서 꼭 눈여겨볼 점이 있어. L1 미스율이 5%에서 10%로만 올라가도 AMAT는 1 + 0.1 × 19.3 ≈ 2.93ns로 50% 가까이 나빠져. 미스율 몇 %의 차이가 성능을 크게 흔든다는 거지. 그래서 CPU 설계자들도, 고성능 코드를 짜는 개발자들도 캐시 미스를 그렇게 집요하게 줄이려는 거야.
🏢 6. L1, L2, L3 각각의 역할: 한 팀의 포지션 분담
이제 주인공들을 하나씩 소개할게. 셋 다 캐시지만 성격이 완전히 달라. 축구팀으로 치면 포지션이 다른 거야.
| 구분 | L1 | L2 | L3 |
|---|---|---|---|
| 위치 | 코어 내부, 실행 유닛 바로 옆 | 코어별 전용(대부분) | 여러 코어가 공유 |
| 대표 용량 | 명령어/데이터 각 32~64KB 안팎 | 코어당 512KB~2MB, 일부 3MB 이상 | 수 MB~수십 MB (일부 96MB 이상) |
| 대략적 지연 | 약 4~5클럭 | 약 12~17클럭 | 약 40~80클럭 |
| 핵심 목표 | 극한의 속도 | L1 미스 흡수, 균형 | DRAM 접근 최소화, 코어 간 공유 |
※ 수치는 최근 인텔·AMD 데스크톱 CPU 공개 자료에서 흔히 보이는 범위를 정리한 것이며, 세대와 모델에 따라 차이가 있어.
🥇 L1 캐시: 코어의 손바닥
L1은 보통 명령어 캐시(L1I)와 데이터 캐시(L1D)로 나뉘어 있어. 이유는 단순해. CPU는 매 클럭 "다음 명령어 가져오기"와 "데이터 읽고 쓰기"를 동시에 하거든. 하나의 캐시를 둘이 같이 쓰면 줄을 서야 하니까 아예 두 개로 쪼갠 거야. 이런 구조를 수정된 하버드 구조(Modified Harvard Architecture)라고 불러. 메모리는 하나지만 캐시 단계에서는 명령어와 데이터 길을 분리하는 방식이지.
L1은 지연 시간이 클럭 단위로 성능에 직결돼서, 1클럭만 늘어나도 설계팀이 크게 고민할 정도야. 최근 예를 들면 인텔의 P코어(Golden Cove 계열)는 L1D를 48KB로, AMD Zen 4는 32KB를 쓰고, 애플 M1의 고성능 코어는 L1I 192KB, L1D 128KB라는 큰 용량으로 화제가 됐어. 왜 이런 차이가 생기는지는 뒤에서 "VIPT"라는 재미있는 비밀로 설명해줄게 😏
🥈 L2 캐시: 든든한 미드필더
L2는 L1보다 몇 배 느리지만 수십 배 커. L1에서 놓친 데이터를 대부분 여기서 받아내는 게 역할이야. 최근 추세는 L2가 점점 커지는 것이야. 인텔은 Raptor Lake P코어에서 코어당 2MB, 그 이후 세대에서는 더 크게 늘렸고, AMD는 Zen 4에서 코어당 1MB로 늘렸지. L2가 크면 무거운 작업의 데이터 묶음(워킹셋)을 코어 가까이에 더 많이 둘 수 있어.
애플 M 시리즈는 구성이 조금 달라. 고성능 코어 클러스터가 큰 L2를 함께 공유하고(M1은 P코어 클러스터에 12MB), 그 아래에 SoC 전체가 쓰는 시스템 레벨 캐시(SLC)가 있어. "L3"라는 이름이 없다고 계층이 없는 게 아니라, 이름과 경계를 다르게 나눈 거야.
🥉 L3 캐시: 모두의 공용 창고
L3는 보통 모든 코어가 공유해. 그래서 Last Level Cache(LLC)라고도 불러. 역할은 크게 두 가지야.
① DRAM에 가기 전 마지막 방어선: 큰 용량으로 미스를 최대한 흡수해.
② 코어 간 데이터 교환소: 코어 A가 쓴 데이터를 코어 B가 읽을 때 DRAM까지 안 가고 L3에서 주고받을 수 있어.
인텔은 L3를 코어마다 "조각(slice)"으로 나눠 링 버스나 메시 네트워크로 연결해. 그래서 어떤 조각에 있느냐에 따라 지연이 조금씩 달라. AMD는 코어 8개를 묶은 CCD(칩렛) 단위로 L3를 공유하게 했고, Zen 4 기준 CCD 하나에 32MB야. 그리고 여기서 명물이 탄생하지 👇
🎮 AMD 3D V-Cache 이야기
AMD는 L3 SRAM 칩을 코어 칩 위에 수직으로 쌓는 기술을 상용화했어. 2022년의 Ryzen 7 5800X3D는 기존 32MB L3 위에 64MB를 얹어 총 96MB L3를 만들었지. 게임처럼 워킹셋이 크고 메모리 접근이 불규칙한 작업에서 성능이 크게 오르면서 "게이밍 CPU"로 유명해졌어. 캐시 용량이 실제 체감 성능을 바꾼다는 걸 보여준 대표 사례야. 대신 초기 모델은 쌓은 칩의 발열 때문에 클럭이 일반 모델보다 조금 낮았는데, 이게 바로 "용량 vs 속도" 트레이드오프의 생생한 예시지.
🗂️ 7. 캐시는 데이터를 어떻게 찾을까? 태그·인덱스·오프셋
캐시가 빠르려면 "찾는 것"도 빨라야 해. 수만 개의 캐시 라인을 하나하나 뒤지면 망하겠지? 그래서 캐시는 주소 자체를 쪼개서 위치를 바로 계산해.
주소를 이렇게 나눠서 봐.
• 오프셋: 64바이트 라인 안에서 몇 번째 바이트인지. 64 = 2⁶이니까 주소의 하위 6비트.
• 인덱스: 캐시의 몇 번 "세트(set)"에 들어갈지. 이건 계산으로 바로 정해져서 검색이 필요 없어.
• 태그: 같은 세트에 들어올 수 있는 주소는 여러 개니까, 지금 들어 있는 게 "진짜 그 주소의 데이터"인지 확인하는 이름표.
그리고 각 세트에 몇 칸(웨이)을 두느냐에 따라 캐시 구조가 세 가지로 나뉘어.
세트당 1칸. 주소가 들어갈 자리가 딱 하나로 정해져. 회로가 단순하고 빠르지만, 같은 자리에 매핑되는 두 데이터를 번갈아 쓰면 서로 계속 쫓아내는 충돌 미스가 생겨.
세트당 N칸. 정해진 세트 안의 N칸 중 아무 데나 들어갈 수 있어. 충돌이 크게 줄어. 실제 CPU 캐시는 대부분 이 방식이고 L1은 8~12웨이, L3는 12~16웨이 이상이 흔해.
아무 칸에나 들어갈 수 있어. 충돌은 최소지만 모든 칸의 태그를 동시에 비교해야 해서 비싸. 그래서 엔트리가 적은 TLB 같은 곳에서 주로 써.
집합 연관 캐시는 세트 안의 모든 웨이 태그를 병렬로 동시에 비교해. 하나씩 순서대로 보는 게 아니라 비교기 N개가 한꺼번에 "나야?"를 외치는 거지. 이게 하드웨어라서 가능한 속도야. 웨이가 많을수록 히트율은 오르지만 비교기와 전력이 늘어서 L1처럼 초고속이 필요한 곳은 적당한 선에서 타협해.
🧩 미스의 세 종류: 3C 모델
캐시 미스는 원인에 따라 세 가지로 분류해. 마크 힐(Mark Hill)이 정리한 유명한 분류야.
강제 미스(Compulsory): 처음 보는 데이터라 어쩔 수 없이 나는 미스. "콜드 미스"라고도 해. 프리페칭으로 줄일 수 있어.
용량 미스(Capacity): 쓰는 데이터 전체가 캐시보다 커서 나는 미스. 캐시를 키우거나 작업을 작은 블록으로 나눠야 해.
충돌 미스(Conflict): 공간은 남는데 하필 같은 세트에 몰려서 나는 미스. 연관도를 높이면 줄어.
멀티코어 시대에는 여기에 네 번째 C, 일관성 미스(Coherence)가 추가돼. 다른 코어가 데이터를 바꿔서 내 캐시 사본이 무효화될 때 생기는 미스인데, 이건 뒤에서 자세히!
🔁 8. 자리가 꽉 차면 누굴 내보낼까? 교체 정책
세트의 웨이가 다 찼는데 새 데이터가 들어와야 하면, 누군가는 쫓겨나야 해. 이걸 정하는 게 교체 정책(Replacement Policy)이야.
• LRU (Least Recently Used): 가장 오래 안 쓴 놈을 내보낸다. 시간 지역성에 딱 맞는 아이디어지만, 웨이가 많으면 정확한 순서를 추적하는 비용이 커져.
• 의사 LRU (Pseudo-LRU): 트리 구조의 비트 몇 개로 "대충 오래된 쪽"을 고르는 근사 방식. 하드웨어 비용이 훨씬 적어서 실제 CPU에서 많이 써.
• RRIP 계열 등 적응형 정책: 한 번 쓰고 다시 안 쓰는 스트리밍 데이터가 캐시를 오염시키는 문제("캐시 스래싱")를 막으려고 등장한 방식들. 새로 들어온 데이터를 바로 귀하게 대접하지 않고, 재사용되는지 지켜본 뒤 우선순위를 높여.
예를 들어 동영상 파일을 쭉 읽는 작업은 데이터를 한 번만 보고 버려. 순수 LRU라면 이런 데이터가 정작 자주 쓰는 중요한 데이터를 밀어내버려. 그래서 최신 CPU의 L3는 이런 접근 패턴을 감지해 적응하는 정책들을 쓰는 것으로 알려져 있어. 다만 제조사들이 정확한 알고리즘을 공개하지 않는 경우가 많아서, 연구자들이 역공학으로 분석하곤 해.
✍️ 9. 쓰기는 어떻게 할까? Write-back vs Write-through
읽기만 있으면 쉬운데 쓰기가 들어오면 복잡해져. 캐시에 있는 값을 바꿨을 때 아래 계층(메모리)에는 언제 반영할까?
쓸 때마다 아래 계층에도 바로 쓴다. 항상 일치해서 단순하지만 쓰기 트래픽이 많아. 그래서 보통 쓰기 버퍼를 함께 둬.
캐시에만 쓰고 "더러워졌다(dirty)" 표시만 해둔다. 그 라인이 쫓겨날 때 한 번에 내려 써. 같은 변수를 100번 바꿔도 메모리엔 한 번만 쓰니까 효율 최고. 현대 CPU의 데이터 캐시는 대부분 이 방식이야.
쓰려는 주소가 캐시에 없을 때(쓰기 미스)도 선택지가 있어. 라인을 일단 캐시로 가져온 다음 쓰는 Write-allocate, 그냥 아래 계층에 바로 쓰는 No-write-allocate. 보통 write-back과 write-allocate가 짝꿍이야. 참고로 CPU 안에는 스토어 버퍼가 있어서, 쓰기 명령은 일단 버퍼에 넣어두고 CPU는 기다리지 않고 다음 일을 해. 쓰기 지연이 읽기만큼 성능을 망치지 않는 이유야.
🏘️ 10. 계층끼리의 관계: 포함형·배타형·NINE
"L1에 있는 데이터는 L2, L3에도 있을까?" 이건 설계마다 달라.
| 방식 | 의미 | 장점 | 단점 |
|---|---|---|---|
| 포함형 (Inclusive) | 위 계층 데이터가 아래 계층에도 반드시 있음 | L3만 보면 어느 코어가 가졌는지 파악이 쉬워 일관성 관리가 편함 | 같은 데이터 중복으로 실질 용량 손해 |
| 배타형 (Exclusive) | 한 데이터는 한 계층에만 있음 | 전체 캐시 용량을 낭비 없이 활용 | 계층 간 데이터 이동이 잦아 복잡 |
| NINE | 포함도 배타도 강제하지 않음 | 유연한 설계 | 일관성 추적에 별도 장치 필요 |
실제 사례로 보면, 인텔은 오랫동안 L3를 포함형으로 운영하다가 Skylake-SP 서버 계열부터 L2를 크게 키우면서 L3를 비포함형으로 바꿨어. L2가 커지면 포함형 L3에서의 중복 손해가 커지니까 자연스러운 선택이었지. AMD의 Zen 계열 L3는 주로 L2에서 쫓겨난 데이터를 받는 희생 캐시(victim cache) 성격으로 설계됐어. 이렇게 "L1·L2·L3"라는 이름은 같아도 속사정은 회사와 세대마다 꽤 달라.
🤝 11. 멀티코어의 난제: 캐시 일관성(Coherence)
코어가 여러 개면 문제가 생겨. 코어 0과 코어 1이 둘 다 변수 X를 자기 L1에 복사해뒀는데, 코어 0이 X를 바꾸면? 코어 1은 옛날 값을 계속 보게 되겠지. 이걸 막는 규칙이 캐시 일관성 프로토콜이야. 가장 유명한 게 MESI야. 캐시 라인마다 네 가지 상태 중 하나를 붙여.
나만 갖고 있고, 내가 고쳤음. 메모리 값은 옛날 것. 남이 원하면 내가 최신 값을 넘겨줘야 해.
나만 갖고 있고, 메모리와 같음. 쓰고 싶으면 남에게 안 묻고 바로 M으로 바꿀 수 있어.
여러 코어가 같은 깨끗한 사본을 가짐. 쓰려면 다른 사본을 먼저 무효화해야 해.
이 사본은 무효. 쓰려면 다시 가져와야 해.
실제 제품은 여기에 상태를 추가한 변형을 써. 인텔은 MESIF(F: Forward, 공유 사본 중 응답 담당자 지정), AMD는 MOESI(O: Owned, 고친 값을 메모리에 안 쓰고도 다른 코어와 공유)를 쓰는 것으로 알려져 있어. 코어 수가 적을 때는 모든 캐시가 버스를 엿듣는 스누핑 방식으로 충분했지만, 코어가 수십 개로 늘면서 "누가 어떤 라인을 가졌는지" 장부를 따로 관리하는 디렉터리 방식이나 스누프 필터가 중요해졌어.
⚠️ 개발자 함정: 거짓 공유(False Sharing)
일관성은 변수 단위가 아니라 캐시 라인(64바이트) 단위로 관리돼. 그래서 스레드 A는 변수 a만, 스레드 B는 변수 b만 쓰는데, 하필 a와 b가 같은 64바이트 안에 붙어 있으면? 서로 전혀 상관없는 데이터인데도 한쪽이 쓸 때마다 상대 코어의 라인이 무효화되고, 라인이 코어 사이를 탁구공처럼 왔다 갔다 해. 멀티스레드 프로그램이 코어를 늘릴수록 오히려 느려지는 미스터리의 단골 범인이야. 해결책은 변수 사이에 패딩을 넣어 서로 다른 캐시 라인에 두는 것. C++17에는 이걸 위해 std::hardware_destructive_interference_size라는 상수까지 생겼어.
// 거짓 공유가 생기기 쉬운 구조
struct Counters {
    long a;   // 스레드 A가 계속 증가
    long b;   // 스레드 B가 계속 증가 (같은 캐시 라인!)
};

// 캐시 라인 단위로 떨어뜨린 구조
struct alignas(64) PaddedCounter {
    long value;
};
PaddedCounter counters[2]; // 각자 다른 64바이트 라인
🔮 12. 미리 가져오기: 하드웨어 프리페처
캐시가 그냥 기다리기만 하는 건 아니야. 요즘 CPU에는 프리페처(Prefetcher)라는 예언가가 있어. 메모리 접근 패턴을 관찰하다가 "이 녀석 주소를 64바이트씩 순서대로 읽네? 다음 것도 읽겠군!" 하고 요청하기도 전에 미리 가져와.
• 다음 라인 프리페처: 지금 라인 다음 라인을 미리 가져와.
• 스트라이드 프리페처: 일정한 간격(예: 256바이트씩 건너뛰기)을 감지해서 그 간격대로 미리 가져와.
• 스트림 프리페처: 여러 개의 순차 접근 흐름을 동시에 추적해.
그래서 배열을 순서대로 읽는 코드는 강제 미스조차 상당 부분 숨겨져. 반대로 연결 리스트처럼 다음 주소가 현재 노드를 읽어야만 알 수 있는 구조는 프리페처가 예측하기 어려워. 노드들이 메모리 여기저기 흩어져 있으면 노드 하나 넘어갈 때마다 캐시 미스가 날 수 있지. 이론상 같은 O(n)이라도 배열 순회가 연결 리스트 순회보다 실전에서 훨씬 빠른 경우가 많은 이유야.
🗺️ 13. 숨은 조연: TLB와 L1 크기의 비밀(VIPT)
프로그램이 쓰는 주소는 사실 가상 주소야. 운영체제가 각 프로세스에 가짜 주소 공간을 주고, 실제 물리 메모리 위치는 페이지 테이블로 번역해. 그런데 매번 메모리에 있는 페이지 테이블을 뒤지면 캐시 쓰는 의미가 없잖아? 그래서 번역 결과만 담아두는 전용 캐시가 있는데, 그게 TLB(Translation Lookaside Buffer)야. TLB도 L1·L2처럼 계층으로 되어 있어.
자, 여기서 앞에서 약속한 비밀이 나와. L1 데이터 캐시는 보통 VIPT(Virtually Indexed, Physically Tagged) 방식을 써. 주소 번역을 기다리지 않으려고, 번역이 필요 없는 부분(페이지 안 오프셋)만으로 인덱스를 고르고, 동시에 TLB로 번역한 물리 주소로 태그를 비교하는 거야. 번역과 캐시 조회를 동시에 하니까 빨라.
🔑 그런데 조건이 있어: 인덱스+오프셋 비트가 페이지 오프셋 범위 안에 있어야 문제(별칭 문제)가 깔끔하게 사라져. 그러면 공식이 이렇게 돼.
L1 크기 ≤ 페이지 크기 × 웨이 수
• x86의 기본 페이지는 4KB → 8웨이면 32KB, 12웨이면 48KB
→ 인텔 P코어의 L1D가 48KB·12웨이인 게 딱 이 공식에 맞아떨어져!
• 애플 M 시리즈 macOS는 16KB 페이지를 써 → 8웨이만 해도 128KB
→ M1의 L1D 128KB가 가능한 이유 중 하나로 자주 꼽혀.
L1 크기 숫자 하나에도 운영체제 페이지 크기와 하드웨어 설계가 얽혀 있다는 게 진짜 재밌지 않아? 🤯
💻 14. 직접 체감하는 캐시: 코드 한 줄 차이로 몇 배
캐시를 이해하면 코드가 달라져. 가장 유명한 예가 2차원 배열 순회야. C/C++ 배열은 행 우선(row-major)으로 저장돼서 같은 행의 원소들이 메모리에 붙어 있어.
#define N 4096
static double a[N][N];

// ✅ 행 우선: 메모리 순서대로 접근 → 캐시 라인 활용 극대화
double sum_row(void) {
    double s = 0;
    for (int i = 0; i < N; i++)
        for (int j = 0; j < N; j++)
            s += a[i][j];
    return s;
}

// ❌ 열 우선: 한 번에 N*8바이트씩 점프 → 매번 다른 캐시 라인
double sum_col(void) {
    double s = 0;
    for (int j = 0; j < N; j++)
        for (int i = 0; i < N; i++)
            s += a[i][j];
    return s;
}
두 함수는 똑같은 계산을 하고 결과도 같아. 하지만 열 우선 버전은 한 원소를 읽고 다음 원소로 갈 때 32KB(4096×8바이트)를 건너뛰어. 가져온 64바이트 라인 중 8바이트만 쓰고 버리는 셈이지. 게다가 4096처럼 2의 거듭제곱 간격으로 건너뛰면 같은 캐시 세트에 몰려서 충돌 미스까지 심해져. 환경에 따라 다르지만 이런 코드는 몇 배에서 그 이상의 속도 차이가 나는 경우가 흔해. 컴파일러가 루프 순서를 바꿔주기도 하지만 항상 그렇진 않으니 직접 알고 짜는 게 좋아. 참고로 포트란이나 MATLAB, NumPy의 'F' 순서 배열은 열 우선이라 반대로 생각해야 해.
🧱 타일링(블로킹): 행렬 곱셈의 정석
큰 행렬 곱셈은 데이터가 캐시보다 훨씬 커서 용량 미스가 폭발해. 그래서 행렬을 캐시에 들어갈 만한 작은 블록(타일)으로 나눠 블록끼리 곱해. 한 번 캐시에 올린 블록을 최대한 여러 번 재사용하는 거지(시간 지역성 극대화!). BLAS 같은 고성능 수치 라이브러리, 딥러닝 프레임워크의 연산 커널이 모두 이런 캐시 인식 최적화 위에 서 있어. AI 시대에 "연산보다 데이터 이동이 병목"이라는 말이 계속 나오는 것도 같은 맥락이야.
📊 데이터 배치: AoS vs SoA
[x,y,z,hp,name...] 객체 단위로 묶음. 객체 하나의 여러 필드를 같이 쓸 때 유리.
하지만 모든 객체의 x좌표만 훑을 땐 필요 없는 필드까지 캐시 라인에 끌려와 낭비.
[x,x,x...][y,y,y...] 필드별로 묶음. 한 필드만 대량 처리할 때 캐시 라인을 꽉 채워 쓰고 SIMD에도 유리.
게임 엔진의 ECS(엔티티 컴포넌트 시스템)가 이 철학을 많이 따라.
🛠️ 내 코드의 캐시 미스 확인하기
리눅스에서는 perf stat -e cache-misses,cache-references ./프로그램 같은 명령으로 하드웨어 성능 카운터를 볼 수 있어. 사용할 수 있는 이벤트 이름은 CPU마다 달라서 perf list로 먼저 확인하는 게 좋아. 인텔 VTune, AMD uProf 같은 프로파일러도 캐시 미스를 함수 단위로 보여줘. lscpu 명령이면 내 CPU의 L1/L2/L3 용량을 바로 확인할 수 있고! 이런 성능 분석 역량은 실무에서 꽤 귀한 기술이라, 재능넷 같은 재능 공유 플랫폼에서도 성능 최적화나 시스템 프로그래밍 컨설팅을 찾는 수요가 꾸준해.
🛡️ 15. 캐시의 그림자: 보안 문제
캐시는 빠르다는 장점 때문에 오히려 공격 통로가 되기도 했어. "캐시에 있으면 빠르고 없으면 느리다"는 시간 차이 자체가 정보가 되거든. 이를 이용한 공격을 캐시 부채널 공격(Cache Side-Channel Attack)이라고 해.
• Flush+Reload, Prime+Probe: 특정 캐시 라인을 비우거나 채운 뒤, 다른 프로그램이 그 라인을 썼는지 접근 시간으로 알아내는 기법.
• 스펙터(Spectre)와 멜트다운(Meltdown): 2018년 공개된 대형 취약점. CPU가 성능을 위해 명령을 "추측 실행"하다가 취소하더라도 그 흔적이 캐시에 남는다는 점을 악용했어. 원래 접근하면 안 되는 데이터의 흔적을 캐시 타이밍으로 읽어낸 거지.
이 사건 이후 운영체제(커널 페이지 테이블 격리 등), 컴파일러, 브라우저(고정밀 타이머 제한), CPU 하드웨어 설계까지 대대적인 대응이 이루어졌고, 일부 대응책은 성능 저하를 동반하기도 했어. 성능과 보안이 서로 줄다리기한다는 걸 보여준 대표 사례야.
🔭 16. 앞으로의 캐시: 더 크게, 더 높게, 더 똑똑하게
3D V-Cache처럼 캐시 칩을 위로 쌓아 면적 한계를 돌파. 이후 세대에서는 캐시 칩을 코어 아래쪽에 배치하는 방식도 등장했어.
최신 공정에서는 로직 회로에 비해 SRAM 셀 면적이 잘 줄지 않는다는 분석이 나와. 그래서 캐시를 별도의 칩렛으로 떼어내는 설계가 주목받아.
AI 가속기는 HBM 같은 고대역폭 메모리와 거대한 온칩 SRAM으로 "데이터 이동 비용"과 싸우고 있어. 메모리 계층의 원리는 GPU·NPU에서도 똑같이 핵심이야.
결국 메모리 계층은 반세기 넘게 이어진 "빠른 건 작고, 큰 건 느리다"라는 물리적 현실과의 타협이야. 1960년대 IBM System/360 Model 85에서 상용 캐시 개념이 본격 등장한 이후로, 숫자와 기술은 바뀌어도 이 원리는 그대로야. 컴퓨터가 존재하는 한 형태만 바뀔 뿐 계층은 계속될 거라고 봐도 좋아.
📝 한 번에 정리하는 핵심 요약
1️⃣ CPU와 DRAM 사이에는 수백 클럭의 속도 격차(메모리 벽)가 있다.
2️⃣ 캐시는 SRAM으로 만들어지고 코어 바로 옆에 있어 빠르다.
3️⃣ 하지만 크게 만들수록 배선·검색 회로가 길어져 느려지므로 L1→L2→L3 계층으로 나눈다.
4️⃣ 작은 캐시가 통하는 진짜 이유는 프로그램의 시간·공간 지역성 덕분이다.
5️⃣ 데이터는 64바이트 캐시 라인 단위로 움직이고, 주소를 태그·인덱스·오프셋으로 쪼개 찾는다.
6️⃣ 교체 정책, 쓰기 정책, 포함 관계, MESI 일관성, 프리페처, TLB가 함께 협업한다.
7️⃣ 개발자는 접근 순서, 데이터 배치, 거짓 공유만 신경 써도 큰 성능 차이를 만들 수 있다.
오늘 이야기 어땠어? 다음에 CPU 스펙표를 보면 "L3 32MB"라는 숫자 뒤에서 열심히 데이터를 미리 가져오고, 이름표를 비교하고, 오래된 데이터를 내보내고, 코어들끼리 "그거 내가 고쳤어!" 하고 신호를 주고받는 작은 세상이 떠오를 거야 😄
코딩을 하고 있다면 오늘 배운 2차원 배열 순서 하나만 바꿔서 시간을 재봐. 숫자로 캐시를 만나는 순간, 이 모든 이론이 확 살아날 거야. 재능넷의 지식인의 숲에서 또 다른 컴퓨터 구조 이야기로 만나자! 🙌

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.