Ver4.0 CAP 정리로 보는 분산 시스템의 딜레마
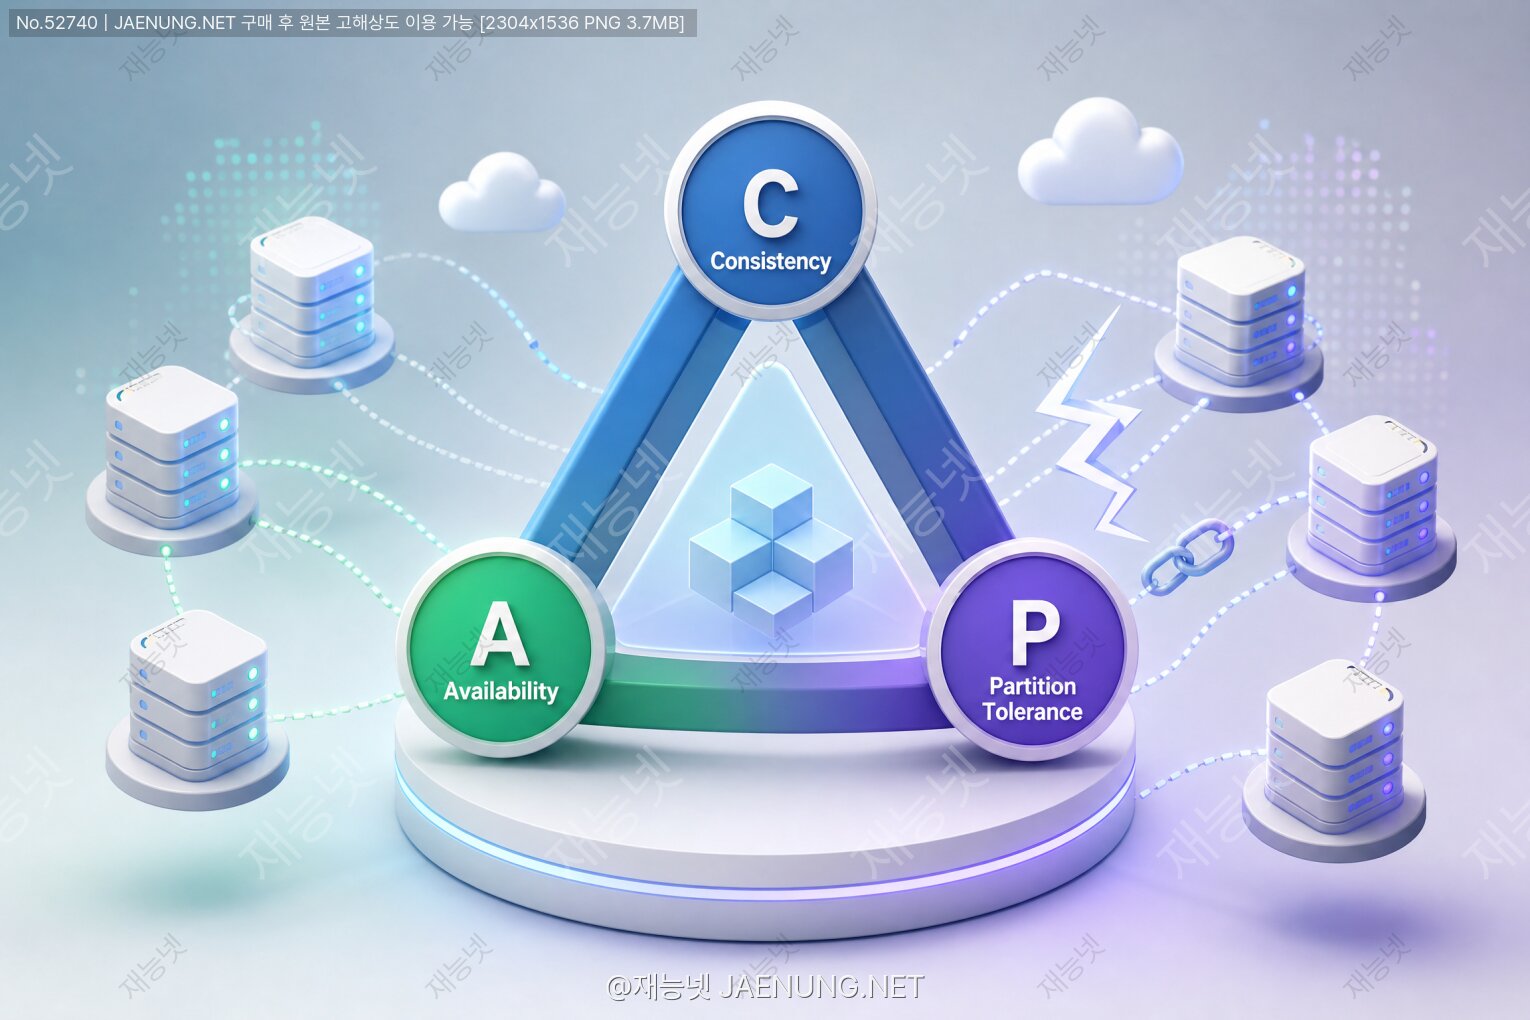
CAP 정리로 보는 분산 시스템의 딜레마
"전부 다 가질 수는 없어요." — 네트워크가 끊어지는 순간,
모든 분산 시스템은 인생 최대의 양자택일 앞에 선다.
0. 프롤로그 : 세 친구가 싸운다
어떤 서비스가 잘 나가면 반드시 벌어지는 일이 있다. 서버 한 대로는 감당이 안 된다는 것.
그래서 우리는 서버를 늘린다. 두 대, 열 대, 백 대. 그 순간부터 우리는 분산 시스템(Distributed System)의 세계로 입장한다.
그런데 서버를 늘리면 성능만 늘어나는 게 아니다. 고장의 종류도 늘어난다.
케이블이 뽑히고, 스위치가 죽고, 데이터센터 간 회선이 흔들리고, GC가 300ms 멈추고, 어떤 노드는 살아있는데 응답만 안 온다.
이 혼돈 속에서 엔지니어가 붙잡을 수 있는 가장 유명한 나침반이 바로 CAP 정리다.
2000년 UC 버클리의 Eric Brewer가 PODC 학회 기조연설에서 추측(conjecture)으로 던졌고,
2002년 MIT의 Seth Gilbert와 Nancy Lynch가 형식적으로 증명해 정리(theorem)가 되었다.
CAP 정리 한 줄 요약
네트워크 분단(Partition)이 발생하는 비동기 네트워크에서,
분산 데이터 저장소는 일관성(C)과 가용성(A)을 동시에 완전히 보장할 수 없다.
1. C, A, P를 정확히 정의하자 (오해의 90%는 여기서 생긴다)
CAP는 인터넷에서 가장 많이 인용되면서 가장 많이 오용되는 정리다.
"셋 중 두 개를 고른다"는 문장이 워낙 유명해서, 정작 각 글자의 엄밀한 정의를 모르는 경우가 많다.
Gilbert–Lynch 논문의 정의를 기준으로 정리해 보자.
C — Consistency (선형화 가능성, Linearizability)
여기서 말하는 C는 데이터베이스 수업에서 배운 ACID의 C(무결성 제약)와 전혀 다르다.
CAP의 C는 Linearizability(선형화 가능성), 즉 원자적 일관성이다.
선형화 가능성의 직관
시스템이 수백 대의 노드로 이루어져 있어도, 외부 관찰자 눈에는 단 한 대의 서버가
요청을 하나씩 순서대로 처리하는 것처럼 보여야 한다.
쓰기 W(x=5)가 완료된 시점 이후에 시작된 모든 읽기 R(x)는 반드시 5 이상의 최신값을 반환해야 한다.
"조금 늦게 반영됨"은 허용되지 않는다. 그건 이미 C 위반이다.
A — Availability (가용성)
CAP의 A도 마케팅 문구의 "99.99% 가용성"과 다르다.
정의는 훨씬 빡세다: 장애가 나지 않은 모든 노드는, 받은 모든 요청에 대해 (에러가 아닌) 응답을 반드시 반환해야 한다.
즉 "타임아웃 걸고 503 반환"은 A가 아니다. "리더가 없으니 잠시 쓰기 거부"도 A가 아니다.
응답 시간에 상한이 명시되진 않지만, 언젠가는 반드시 유효한 응답을 돌려줘야 한다.
P — Partition Tolerance (분단 내성)
가장 오해가 심한 글자다. P는 "우리가 선택하는 기능"이 아니라 네트워크가 우리에게 강제하는 환경이다.
정확한 정의: 노드 간 메시지가 임의로 유실되거나 지연되어도 시스템이 (C 또는 A 중 하나를 지키며) 계속 동작함.
핵심 팩트 — 네트워크 케이블이 있는 한 분단은 발생한다.
따라서 실제 분산 시스템에서 P를 "버리는" 선택지는 존재하지 않는다.
CAP의 진짜 질문은 "3개 중 2개"가 아니라,
"분단이 발생했을 때, C를 포기할래 A를 포기할래?" 라는 이지선다다.
그럼 CA 시스템은 뭔가요?
단일 노드 RDBMS(분산 아님), 혹은 분단이 절대 일어나지 않는다고 가정한 시스템.
그리고 현실적으로는 "분단이 나면 그냥 전체를 멈추는" 시스템이다.
Brewer 본인도 2012년 IEEE Computer에 실은 회고 글 "CAP Twelve Years Later"에서
"3 중 2 선택이라는 표현은 지나치게 단순화되어 오해를 낳았다"고 직접 인정했다.
2. 증명은 놀랍도록 간단하다
Gilbert–Lynch의 증명은 대학원 수준 수학이 필요 없다. 모순법 한 방이면 끝난다.
증명 스케치
1) 노드 N1, N2가 있고 둘 사이 네트워크가 완전히 끊겼다고 하자. (P 발생)
2) 클라이언트가 N1에 x = 5를 쓴다. A를 만족하려면 N1은 성공 응답을 해야 한다.
3) 이어서 다른 클라이언트가 N2에서 x를 읽는다. A를 만족하려면 N2도 반드시 응답해야 한다.
4) 그런데 N2는 분단 때문에 x=5라는 사실을 알 방법이 물리적으로 없다. 그래서 옛날 값 0을 반환한다.
5) 이건 선형화 가능성 위반. 즉 C가 깨진다.
6) C를 지키려면 N2는 응답을 거부해야 하고, 그러면 A가 깨진다. ∎
증명이 이렇게 짧은 이유는, 이것이 소프트웨어의 한계가 아니라 정보 전달의 물리적 한계이기 때문이다.
아무리 똑똑한 알고리즘도, 빛보다 빠르게 정보를 보낼 수는 없고 끊긴 선으로 패킷을 보낼 수는 없다.
3. CP vs AP — 현실 시스템들의 선택
CP 진영 : "틀린 답보다 무응답이 낫다"
CP 시스템은 분단이 감지되면 소수파(minority) 쪽을 잘라낸다.
과반수(quorum)를 확보한 쪽만 쓰기를 계속하고, 나머지는 읽기/쓰기를 거부하거나 읽기 전용으로 강등된다.
대표 알고리즘은 Paxos(Leslie Lamport, 1989/1998)와 Raft(Ongaro & Ousterhout, 2014).
둘 다 과반수 정족수를 핵심으로 한다. 노드가 5대라면 3대가 모여야 진행 가능하다.
즉 최대 2대까지 죽어도 살아남지만, 3대가 끊기면 그냥 멈춘다. 그게 설계 의도다.
실물 예시
• etcd / ZooKeeper / Consul — 쿠버네티스의 두뇌, 서비스 디스커버리, 분산 락
• Google Spanner — TrueTime API와 원자시계/GPS로 외부 일관성(external consistency) 제공
• HBase, MongoDB(기본 설정), Kafka(acks=all + min.insync.replicas)
왜 은행 계좌, 재고 수량, 분산 락은 CP여야 할까?
분단 양쪽에서 각각 "마지막 남은 콘서트 티켓 1장"을 팔아버리면, 그건 기술 사고가 아니라 비즈니스 사고다.
이때는 차라리 "잠시 후 다시 시도해주세요"가 훨씬 싸다.
AP 진영 : "무응답보다 조금 낡은 답이 낫다"
AP 시스템은 분단이 나도 모든 노드가 계속 응답한다. 대신 데이터가 갈라진다.
분단이 회복되면 충돌 해소(conflict resolution) 단계를 거쳐 다시 합친다.
이것이 결과적 일관성(Eventual Consistency)이다.
충돌을 푸는 대표 기법들:
| 기법 | 원리 | 장점 / 한계 |
|---|---|---|
| LWW (Last Write Wins) | 타임스탬프가 큰 쪽 채택 | 단순 / 쓰기 유실 발생(clock skew) |
| Vector Clock | 노드별 논리 카운터로 인과관계 추적 | 충돌 "감지" 가능 / 해결은 앱 몫 |
| CRDT | 수학적으로 병합이 항상 수렴하는 자료구조 | 자동 수렴 / 표현 가능한 연산 제한 |
| Read Repair | 읽을 때 불일치 발견 시 조용히 갱신 | 추가 비용 적음 / 안 읽히면 안 고쳐짐 |
실물 예시
• Amazon Dynamo(2007 논문) — 장바구니는 절대 "담기 실패"하면 안 된다는 철학
• Apache Cassandra, Riak, CouchDB, DynamoDB
• DNS — 지구에서 가장 크고 오래된 AP 시스템. TTL 기반 결과적 일관성
• CDN 캐시, 협업 에디터(Figma, Google Docs) — CRDT/OT 기반
Dynamo의 유명한 일화
아마존은 장바구니를 AP로 설계했다. 분단 중 양쪽에서 담은 상품은 나중에 합집합으로 병합된다.
그래서 이론상 "삭제한 상품이 다시 살아나는" 현상이 생길 수 있다.
불편하다. 하지만 아마존의 계산은 명확했다. "담기 실패로 잃는 매출 > 상품이 부활해 짜증나는 비용".
CAP는 기술 논쟁 같지만, 결국 비즈니스 손익 계산서다.
4. 정족수 산수 : R + W > N
AP 계열 시스템도 튜닝 노브를 준다. Dynamo 스타일의 쿼럼 공식이다.
N = 복제본(replica) 개수
W = 쓰기 성공으로 인정할 최소 응답 노드 수
R = 읽기 시 응답을 모을 최소 노드 수

  R + W > N   →  읽기 집합과 쓰기 집합이 반드시 겹침 (강한 일관성에 근접)
  R + W ≤ N   →  겹치지 않을 수 있음 (빠르지만 낡은 값 가능)

예) N=3
  W=3, R=1 : 읽기 초고속 / 쓰기 가용성 최악 (한 대만 죽어도 쓰기 불가)
  W=1, R=1 : 초고속·초가용 / 일관성 포기 (전형적 AP)
  W=2, R=2 : 균형점. 한 대 장애까지 허용하며 겹침 보장 ✅
중요한 함정 — R+W>N은 "겹치는 노드가 존재함"만 보장한다.
동시 쓰기 순서, 롤백된 쓰기, sloppy quorum(임시 대리 노드 사용) 상황에서는 여전히 선형화가 깨질 수 있다.
쿼럼은 강한 일관성의 필요조건이지 충분조건이 아니다.
5. CAP의 한계, 그리고 PACELC
CAP만으로 시스템을 설명하려 들면 금방 벽에 부딪힌다. 왜냐면 네트워크 분단은 생각보다 드물기 때문이다.
그럼 분단이 없는 99.99%의 평상시에는 아무 트레이드오프가 없나? 당연히 있다. 지연시간(Latency)이다.
강한 일관성을 유지하려면 쓰기마다 다른 노드들과 합의해야 하고, 그건 곧 네트워크 왕복(RTT)이다.
서울–버지니아 왕복만 해도 180ms급이다. 일관성은 공짜가 아니라 밀리초로 결제된다.
PACELC 정리 (Daniel Abadi, 2010)
if (P) then A or C — 분단 시에는 가용성과 일관성 중 선택
else (E) then L or C — 평상시에는 지연시간과 일관성 중 선택
| 시스템 | 분단 시 | 평상시 | 분류 |
|---|---|---|---|
| Cassandra (기본) | A 선택 | L 선택 | PA / EL |
| DynamoDB | A 선택 | L 선택(튜닝 가능) | PA / EL |
| MongoDB | C 선택 | C 선택 | PC / EC |
| Google Spanner | C 선택 | C 선택 | PC / EC |
| VoltDB / H-Store | C 선택 | C 선택 | PC / EC |
| Riak | A 선택 | L 선택 | PA / EL |
PACELC가 CAP보다 실무적으로 유용한 이유는 명확하다.
엔지니어가 매일 씨름하는 건 1년에 몇 번 오는 분단이 아니라, 매 요청마다 발생하는 p99 레이턴시이기 때문이다.
스패너는 CAP을 깼는가?
구글 Spanner는 전 세계에 분산되어 있으면서 강한 일관성을 제공한다. 그래서 종종 "CAP를 깼다"고 회자된다.
구글 엔지니어들이 직접 쓴 백서 "Spanner, TrueTime and the CAP Theorem"의 답은 이렇다.
Spanner는 기술적으로 CP 시스템이다. 분단이 나면 소수파는 쓰기를 중단한다.
다만 구글이 전용 광케이블과 다중화된 백본을 소유해 분단 확률 자체를 극단적으로 낮췄기 때문에,
사용자 체감상 "CA처럼 보이는 CP"로 동작할 뿐이다.
즉 CAP를 깬 게 아니라, P의 발생 빈도에 막대한 돈을 투자해 우회한 것이다.
6. 실무 설계 가이드 : 우리 서비스는 뭘 골라야 할까
가장 중요한 원칙 하나. CAP 선택은 시스템 단위가 아니라 "기능 단위"로 한다.
하나의 서비스 안에서도 결제는 CP, 조회수 카운터는 AP인 게 정상이다.
| 도메인 | 권장 | 이유 |
|---|---|---|
| 결제 / 계좌 이체 | CP | 이중 인출은 법적 문제로 직결 |
| 재고 / 좌석 예약 | CP | 오버부킹 방지, 초과 판매는 배상 비용 |
| 분산 락 / 리더 선출 | CP | 두 명의 리더 = split-brain 재앙 |
| 장바구니 / 위시리스트 | AP | 병합 가능, 실패가 매출 손실로 직결 |
| 좋아요·조회수·랭킹 | AP | 근사치로 충분, 초당 트래픽이 압도적 |
| 로그·메트릭·이벤트 | AP | 쓰기량 폭발, 약간의 유실/중복 허용 |
| 피드 / 타임라인 | AP | 몇 초 늦은 게시물은 아무도 모른다 |
체크리스트 — 선택 전에 던질 질문 7개
Q1. 이 데이터가 1초간 낡았을 때 실제로 누가 손해를 보는가? 금액은 얼마인가?
Q2. 응답이 없을 때 사용자는 어떻게 행동하나? (재시도? 이탈? 고객센터 전화?)
Q3. 충돌이 나면 자동 병합이 가능한가? (CRDT로 표현 가능한 연산인가)
Q4. 읽기:쓰기 비율은? 읽기 95%라면 읽기 최적화가 답이다.
Q5. 노드들이 같은 리전인가, 대륙 간인가? RTT가 합의 비용을 결정한다.
Q6. 규제 요건이 있는가? 금융·의료는 감사 추적과 강한 일관성이 사실상 강제다.
Q7. 실패 시 보상 트랜잭션(Saga)으로 되돌릴 수 있는가? 되돌릴 수 있으면 AP 여지가 커진다.
일관성 모델은 이분법이 아니다
C냐 A냐는 사실 스펙트럼이다. 그 사이에 유용한 중간 지대가 아주 많다.
예를 들어 SNS에서 내가 쓴 댓글이 내 화면에 즉시 보이는 것(Read-your-writes)만 보장해도
사용자 체감 품질은 극적으로 올라간다. 전 세계 모든 사용자에게 동시에 보일 필요는 없다.
이런 세션 수준 보장은 비용 대비 효과가 가장 뛰어난 선택지다.
이처럼 분산 시스템 설계는 "정답 암기"보다 트레이드오프 감각이 핵심이다.
그래서 실무 경험자가 직접 사례를 풀어주는 멘토링이 큰 도움이 되는데,
재능넷의 '지식인의 숲'과 IT 멘토링 카테고리에서는 이런 아키텍처 설계 리뷰나
데이터베이스 선정 컨설팅 같은 실전형 재능들이 활발히 공유되고 있다.
7. 흔한 오해 5가지 바로잡기
오해 1. "NoSQL은 AP, RDBMS는 CA다."
→ 틀렸다. MongoDB·HBase는 CP다. 반대로 MySQL 비동기 복제 클러스터는 AP처럼 동작한다.
CAP 분류는 제품 이름이 아니라 설정과 복제 방식이 결정한다.
오해 2. "P를 포기하면 CA를 얻는다."
→ 네트워크를 쓰는 순간 분단 확률은 0이 아니다. P를 "포기"한다는 건 사실상
"분단이 나면 데이터 정합성을 보장할 수 없는 상태로 방치한다"는 뜻에 가깝다. 최악의 선택이다.
오해 3. "CAP의 C는 ACID의 C와 같다."
→ 완전히 다르다. ACID의 C는 무결성 제약(외래키, 체크 제약)이고,
CAP의 C는 선형화 가능성이라는 동시성/복제 관점 개념이다. 이름만 같은 남남이다.
오해 4. "AP를 고르면 데이터가 엉망이 된다."
→ CRDT, 벡터 클록, 멱등 연산, 보상 트랜잭션을 제대로 쓰면 AP도 충분히 견고하다.
DNS와 Git이 그 증거다. 특히 Git은 완벽한 AP 시스템이면서 merge라는 명시적 충돌 해소를 갖췄다.
오해 5. "CAP만 알면 분산 시스템 설계를 할 수 있다."
→ CAP는 출발점일 뿐이다. FLP 불가능성 정리(비동기 네트워크에서 결정론적 합의는 불가능),
Two Generals Problem, Byzantine 장애, 시계 동기화 문제 등 훨씬 넓은 세계가 기다린다.
8. 에필로그 : 정리는 제약이 아니라 지도다
CAP 정리를 처음 배우면 대체로 실망한다. "그래서 다 못 가진다는 거잖아?"
하지만 시간이 지나면 관점이 바뀐다. CAP는 우리에게 무엇을 포기할지 물어봐 주는 고마운 질문지다.
물리학에 열역학 제2법칙이 있듯, 분산 시스템에는 CAP가 있다.
영구기관을 만들려는 시도가 무의미하듯, 분단 상황에서 C와 A를 모두 챙기려는 설계도 무의미하다.
좋은 엔지니어는 그 한계와 싸우지 않고, 한계 안에서 가장 영리한 지점을 고른다.
기억할 세 문장
① 분단은 선택이 아니라 현실이다. 질문은 언제나 "C냐 A냐".
② 평상시의 진짜 트레이드오프는 지연시간이다. PACELC로 생각하라.
③ 선택은 시스템 전체가 아니라 기능별로. 결제는 CP, 좋아요는 AP.
다음에 아키텍처 회의에서 누군가 "우리 DB 뭐 쓸까요?"라고 묻거든,
"우리는 언제, 어떤 데이터에서, 무엇을 포기할 수 있나요?"라고 되물어 보자.
그 질문을 던질 수 있게 되었다면, 당신은 이미 CAP 정리를 제대로 이해한 것이다. 🎯
관련 키워드
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.