Ver4.0 음성인식 양식일지 작성 기술: 장갑 낀 손으로도 기록되는 스마트 양식장 데이터 관리
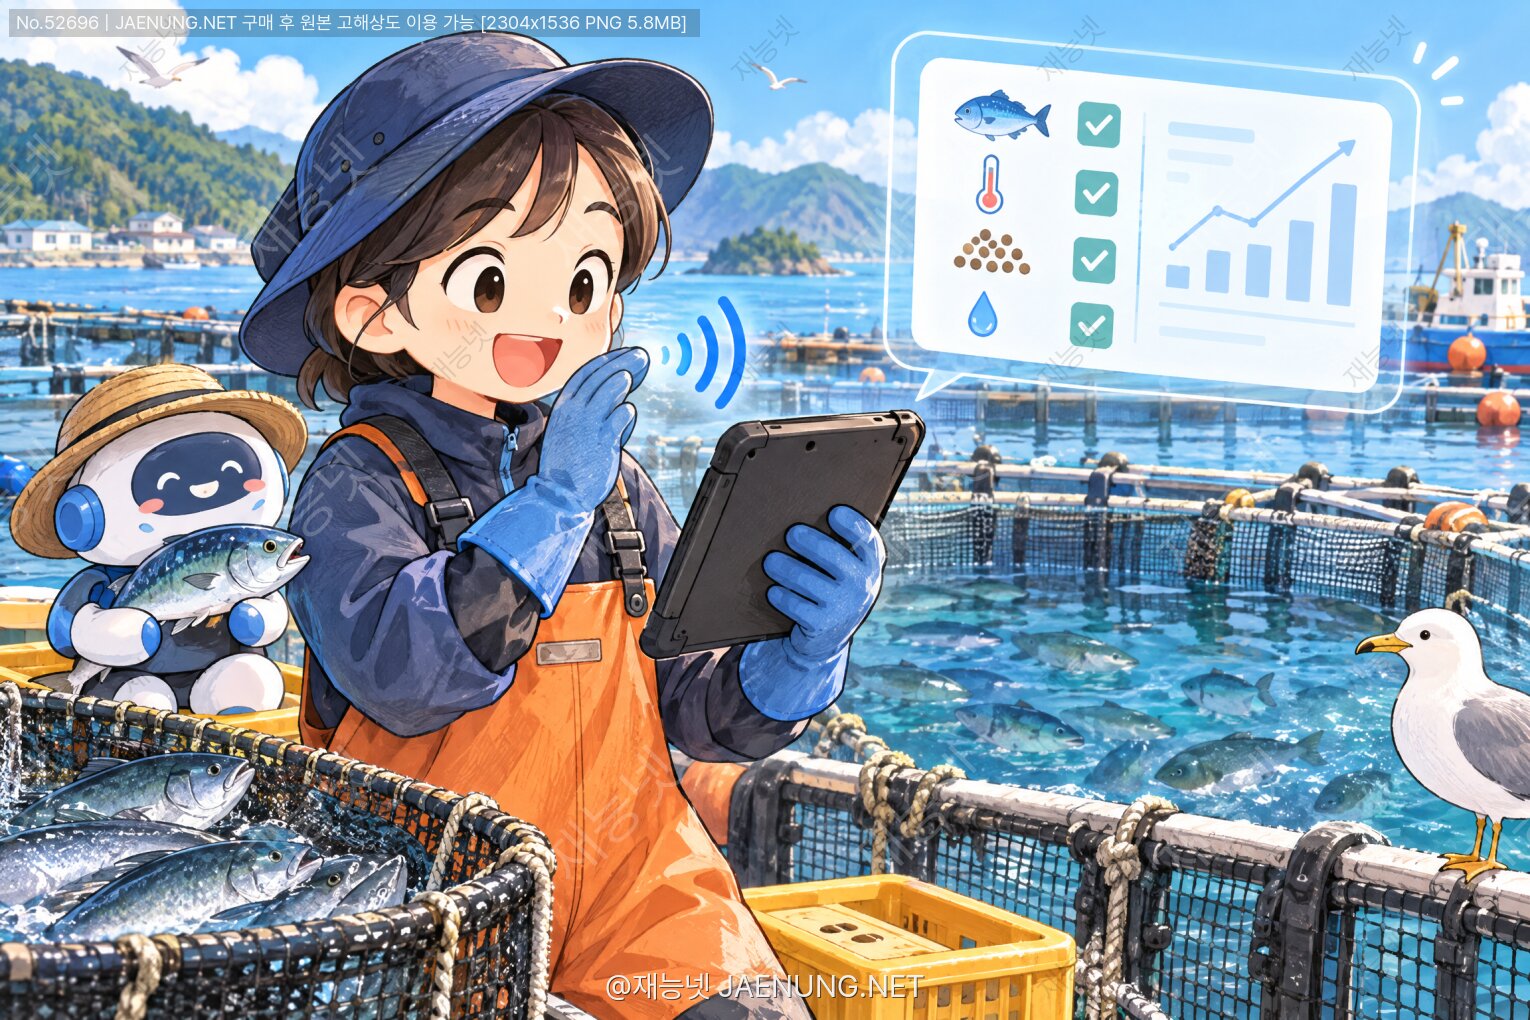
음성인식 양식일지 작성 기술: 장갑 낀 손으로도 기록되는 스마트 양식장 데이터 관리
바다 위에서, 사료 배합실에서, 비 오는 가두리에서
말 한마디로 일지가 저장되는 시대 이야기
1. 자, 상상해보자. 장갑 낀 손에 볼펜 쥐어본 적 있어?
양식장 새벽 5시. 바깥 기온 2도, 바닷바람은 초속 8m.
손에는 방수 고무장갑, 팔에는 사료 냄새, 발밑은 미끄러운 데크.
이 상태에서 클립보드에 볼펜으로 "사료 급이 08:00 / 3호 가두리 / EP사료 40kg / 수온 14.2℃"를 적어야 한다고?
써본 사람은 안다. 종이가 젖는다. 볼펜이 안 나온다. 글씨는 나중에 본인도 못 읽는다.
그래서 현장에서 실제로 벌어지는 일은 이거다.
"일단 머리에 기억했다가 사무실 가서 한 번에 쓰자."
그리고 오후 4시, 사무실 책상 앞에서 이렇게 된다.
"오늘 3호에 몇 kg 줬더라… 40이었나 45였나… 뭐 대충 40으로 쓰자."
이 "대충 40"이 바로 수산 데이터 품질이 무너지는 지점이다.
그리고 이 지점을 정확히 노리고 들어온 기술이 음성인식 기반 양식일지 작성이다.
오늘은 이 주제를 아주 실용적으로, 친구한테 설명하듯 풀어볼 거야.
음성인식이 어떻게 작동하는지, 왜 하필 양식장인지, 실제로 뭘 준비해야 하는지,
그리고 법적으로 의무인 기록들(양식장 사육일지, 수산용 의약품 사용기록, HACCP 기록)이 어떻게 연결되는지까지.
2. 그런데 양식일지, 그거 그냥 써도 되는 거 아냐? (아니야)
2-1. 양식일지는 "선택"이 아니라 "제도"다
우리나라 수산 양식은 양식산업발전법과 수산생물질병 관리법, 그리고 식품 쪽으로는 수산물 HACCP(안전관리인증기준) 체계에 묶여 있다.
여기서 요구하는 기록은 생각보다 촘촘하다.
| 기록 항목 | 왜 필요한가 | 기록 빈도 |
|---|---|---|
| 입식 기록 (종자 출처·수량·크기) | 이력추적, 질병 역학조사 | 입식 시마다 |
| 사료 급이 기록 (종류·량·시간) | 사료계수(FCR) 산출, 원가관리 | 매 급이 |
| 수질 측정 (수온·DO·pH·염분) | 폐사 예방, 환경 규제 대응 | 1일 1~3회 |
| 폐사 기록 (마리수·추정 원인) | 질병 신고 의무, 보험 청구 | 발생 시 즉시 |
| 수산용 의약품 사용기록 | 휴약기간 준수(법적 의무) | 투약 시마다 |
| 출하 기록 (중량·구매처) | 이력제, 정산 | 출하 시마다 |
특히 수산용 의약품 사용기록은 진짜 중요하다.
항생제를 쓰면 어종·약품별로 정해진 휴약기간이 있고, 그 기간이 지나야 출하할 수 있다.
기록이 부정확하면 잔류물질 검출 → 출하 정지 → 브랜드 신뢰도 붕괴로 이어진다.
현실 체크
그런데 이 모든 걸 손으로 쓴다고?
소규모 양식장 기준 하루 기록 항목이 30~80건이다.
가두리 20칸짜리면 급이만 40번, 수질 측정 60번, 관찰 메모 20건.
이걸 종이로 쓰면 하루 40~60분이 순수 기록 노동이다.
2-2. 종이 일지의 4가지 고질병
① 지연 기록(Recall Bias)
현장에서 바로 안 쓰고 나중에 몰아 쓰니까 숫자가 뭉개진다.
연구에서도 사후 회상 기록은 수치 오차가 크게 늘어난다는 건 상식 수준이다.
② 물리적 소실
젖고, 찢어지고, 태풍에 날아간다. 실제로 태풍 이후 일지 분실은 흔한 사고다.
③ 디지털 전환 비용
결국 누군가 엑셀에 다시 타이핑한다. 이중 노동 + 이중 오타.
④ 분석 불가능
종이는 검색이 안 된다. "작년 8월 고수온기에 DO가 4 이하로 떨어진 날이 며칠이었지?"
→ 종이 일지로는 답 못 한다.
3. 음성인식(STT)이 어떻게 돌아가는지, 진짜 쉽게
3-1. 핵심은 "받아쓰기"가 아니라 "양식 채우기"
많은 사람들이 착각하는 게 있다.
음성인식 일지 = 녹음해서 글자로 바꿔주는 것? 아니다.
그건 절반이다. 진짜 핵심은 STT로 나온 텍스트를 "구조화된 데이터"로 바꾸는 단계다.
이걸 전문 용어로 NLU(자연어이해) + 슬롯 필링(Slot Filling)이라고 한다.
예시로 보자.
[사용자 발화]
"삼호 가두리 수온 십사점이도, 용존산소 육점팔,
사료 이피 사십킬로 급이 완료, 폐사 세 마리"

[STT 출력 텍스트]
"3호 가두리 수온 14.2도 용존산소 6.8 사료 EP 40kg 급이 완료 폐사 3마리"

[NLU 구조화 결과]
{
  "site": "3호 가두리",
  "timestamp": "2024-11-05T08:12:33+09:00",
  "gps": [34.7412, 128.3901],
  "water_temp_c": 14.2,
  "dissolved_oxygen_mgL": 6.8,
  "feed": { "type": "EP", "amount_kg": 40, "status": "완료" },
  "mortality_count": 3,
  "recorder": "kim_yj",
  "confidence": 0.94
}
보이지? 사람은 7초 말했고, 시스템은 8개 필드를 채웠다.
게다가 시각과 위치는 자동으로 붙었다. 사람이 거짓말하거나 실수할 여지가 줄어든다.
3-2. ASR 기술, 요즘 어디까지 왔나
과거 음성인식은 HMM-GMM(은닉 마르코프 모델) 구조였다.
음소 하나하나를 확률로 맞추는 방식이라, 잡음에 극도로 약했다.
지금은 End-to-End 딥러닝 ASR이 표준이다.
대표적으로 CTC(Connectionist Temporal Classification), Attention 기반 Seq2Seq, 그리고 요즘 주류인 Transformer / Conformer 계열.
자기지도학습(Self-supervised) 모델인 wav2vec 2.0, 그리고 OpenAI의 Whisper 같은 다국어 모델도 널리 쓰인다.
| 세대 | 기술 | 특징 | 잡음 내성 |
|---|---|---|---|
| 1세대 | HMM-GMM | 음소 단위 통계 모델 | 매우 약함 |
| 2세대 | DNN-HMM | 딥러닝 음향모델 결합 | 보통 |
| 3세대 | CTC / Attention | End-to-End, 발음사전 불필요 | 양호 |
| 4세대 | Conformer / Whisper | 자기지도학습, 다국어, 문맥 이해 | 우수 |
중요한 지표는 WER(Word Error Rate, 단어오류율)이다.
조용한 환경 한국어 표준어는 WER 5% 내외까지 내려간다.
그런데 양식장은 조용한 환경이 아니다. 여기서 이야기가 재밌어진다.
4. 양식장이라는 "음성인식 지옥 난이도" 환경
솔직히 말해서, 음성인식 개발자 입장에서 양식장은 악몽 같은 곳이다.
왜 그런지 하나씩 뜯어보자.
4-1. 소음: 파도, 엔진, 에어레이션, 펌프
가두리 양식장 데크 위 소음은 보통 70~80dB(A),
선외기 가동이나 자동선별기 작동 시엔 90dB를 넘긴다.
육상 순환여과식(RAS) 양식장도 만만치 않다. 블로워와 펌프가 24시간 돌기 때문이다.
음성인식에서 중요한 건 SNR(신호대잡음비)인데,
SNR이 10dB 이하로 떨어지면 인식률이 급격히 무너진다.
그래서 해법은 세 가지다.
① 근접 마이크(Close-talk mic)
입에서 2~5cm 거리. 거리가 2배 멀어지면 음압은 약 6dB 감소한다(역제곱 법칙).
즉 마이크를 입에 가까이 붙이는 것만으로 SNR을 15~20dB 벌 수 있다.
② 빔포밍 마이크 어레이
마이크 2~4개를 배열해서 화자 방향 소리만 강조하고 옆·뒤 소음을 감쇠시킨다.
③ 딥러닝 노이즈 서프레션
RNNoise, DeepFilterNet 같은 모델로 정상 소음(엔진·펌프처럼 규칙적인 소리)을 걷어낸다.
재미있게도 파도 소리나 펌프 소리처럼 "일정한" 소음이 오히려 제거하기 쉽다.
진짜 어려운 건 갑자기 튀는 소리 — 갈매기 울음, 물체 낙하음, 사람 고함이다.
4-2. 방언과 세대: 이게 진짜 관문
수산업 종사자 연령 구조를 보면 60대 이상 비율이 매우 높다.
그리고 양식 주요 지역은 전남·경남·충남·제주 — 전부 방언권이다.
실제로 인식이 꼬이는 사례들
"수온이 시더 도"(14도, 경상 방언 축약) → "시더도"로 오인식
"고기가 맥이 없다" → 문맥상 '먹이'인지 '맥(활력)'인지 모호
"삼마리" vs "서마리" vs "시마리" → 전부 3마리
제주 방언 "하영 죽었수다" → 표준어 '많이 죽었습니다'
그래서 국내 상용 서비스들은 방언 데이터셋 추가 학습(Fine-tuning)을 반드시 거친다.
국립국어원과 AI Hub에는 지역 방언 발화 데이터셋이 공개되어 있고,
여기에 양식 현장 녹음을 더해 도메인 적응(Domain Adaptation)을 시킨다.
4-3. 전문용어: 일반 모델은 절대 못 알아듣는다
이게 은근히 치명적이다. 범용 STT에 수산 용어를 넣으면 이렇게 된다.
| 실제 발화 | 범용 STT 오인식 | 도메인 사전 적용 후 |
|---|---|---|
| 스쿠티카충 | 스쿠터 카충 | 스쿠티카충 ✓ |
| 비브리오 | 비브리 오 | 비브리오 ✓ |
| 이리도바이러스 | 이리 도바 이러스 | 이리도바이러스 ✓ |
| EP사료 | 이피 사료 / 입사료 | EP사료(압출펠릿) ✓ |
| 사료계수 | 사료 개수 | FCR(사료계수) ✓ |
| 넙치 치어 | 넙치 치어 / 업지 치어 | 넙치 치어 ✓ |
| 포르말린 약욕 | 포르말린 약속 | 포르말린 약욕 ✓ |
| 활어차 상차 | 활어차 상차 / 화 여차 | 활어차 상차 ✓ |
해결책은 커스텀 단어 부스팅(Keyword Boosting) 또는 Shallow Fusion 언어모델이다.
쉽게 말해 "이 단어들은 나올 확률이 높으니 가산점을 줘" 하고 모델에게 귀띔하는 것.
수산질병 명칭 300개, 사료 브랜드 150개, 약품명 200개 정도만 등록해도 인식률이 확 올라간다.
5. 숫자와 단위 — 여기가 진짜 승부처
양식일지의 90%는 숫자다. 그런데 한국어 숫자 발화는 악명 높게 복잡하다.
한국어 숫자의 이중 체계
한자어 수사: 일, 이, 삼, 사, 오…
고유어 수사: 하나, 둘, 셋, 넷, 다섯…
그리고 단위에 따라 섞어 쓴다.
"삼십 마리"(O) / "서른 마리"(O) → 같은 뜻
"삼 킬로"(O) / "세 킬로"(O) → 같은 뜻
"십사점이도"(O) / "열네 점 이도"(X, 어색) → 소수는 한자어만
여기에 동음이의 단위까지 겹친다.
| 발화 | 가능한 해석 | 해결 방법 |
|---|---|---|
| "도" | ℃(수온) / 도(방위각) / 정도 | 선행 항목 문맥 판단 |
| "피피엠" | ppm(농도) | 단위 사전 등록 |
| "밀리" | mL / mm / mg | 측정 항목과 매칭 |
| "프로" | % (백분율) | 정규화 규칙 |
| "관" | 3.75kg (전통 중량단위) | 지역 단위 변환표 |
| "채" / "폿" | 양식장 구획 단위 | 업종별 사전 |
5-1. ITN: 텍스트를 숫자로 되돌리는 기술
ITN(Inverse Text Normalization, 역텍스트정규화)는 STT 결과의 한글 숫자 표기를 실제 숫자로 바꾸는 후처리다.
# ITN 변환 예시
"십사점이도"        →  14.2 ℃
"육점팔 피피엠"      →  6.8 ppm
"사십킬로그램"       →  40 kg
"세마리"            →  3 마리
"이천이백마리"       →  2,200 마리
"팔시 십오분"        →  08:15
"삼십오프로"         →  35 %
"한관반"            →  5.625 kg  (1.5 × 3.75)
그리고 여기에 범위 검증(Range Validation)을 반드시 붙여야 한다.
이게 음성인식 일지의 생명줄이다.
물리적으로 불가능한 값은 되묻기
수온:   -2 ~ 35 ℃     → 142℃ 입력 시 "14.2도 맞나요?" 재확인
DO:      0 ~ 20 mg/L  → 68 입력 시 "6.8 맞나요?" 재확인
pH:      5 ~ 10       → 범위 초과 시 경고
염분:    0 ~ 40 psu
급이량:  0 ~ 500 kg   → 수조 규모 기반 동적 상한
폐사:    0 ~ 입식량    → 잔존 마리수 초과 불가
실제로 소수점 누락이 음성 일지 오류의 압도적 1위다.
"십사점이"에서 '점'이 소음에 묻히면 142가 된다.
그래서 범위 검증 + 즉시 음성 확인(TTS 되읽어주기)은 옵션이 아니라 필수 설계다.
6. 실제 시스템은 어떻게 구성될까
6-1. 온디바이스 vs 클라우드, 뭘 골라야 할까
이건 양식장 위치에 따라 답이 갈린다.
| 구분 | 온디바이스(Edge) | 클라우드 |
|---|---|---|
| 네트워크 | 불필요 (해상 유리) | LTE/5G 필수 |
| 응답속도 | 0.2~0.5초 | 0.5~2초 |
| 정확도 | 중~상 (경량모델) | 상 (대형모델) |
| 전문용어 확장 | 제한적 | 자유로움 |
| 비용 | 단말 사양↑ | API 호출당 과금 |
| 프라이버시 | 우수 (외부전송 없음) | 정책 관리 필요 |
실무 추천: 하이브리드
① 현장에서는 온디바이스로 즉시 인식 + 로컬 저장
② 네트워크 잡히는 순간 원본 음성을 클라우드로 재처리
③ 두 결과가 다르면 사용자에게 확인 요청
가두리에서 무선이 끊기는 건 일상이다. 오프라인 우선 설계는 타협 불가.
6-2. 발화 설계: "말하는 양식(Template)"을 정하자
자유 발화를 100% 이해하는 시스템을 만드는 건 어렵고 비싸다.
현장에서 훨씬 잘 먹히는 건 반구조화 발화(Semi-structured utterance)다.
쉽게 말해, 말하는 순서를 정해두는 것.
[급이 기록 템플릿]
"급이, {수조번호}, {사료명}, {수량}{단위}, {섭이상태}"
→ "급이, 3호, EP2호, 40킬로, 양호"

[수질 기록 템플릿]
"수질, {수조번호}, 수온 {값}, 산소 {값}, 피에이치 {값}"
→ "수질, 3호, 수온 14.2, 산소 6.8, 피에이치 7.9"

[폐사 기록 템플릿]
"폐사, {수조번호}, {마리수}마리, {추정원인}"
→ "폐사, 3호, 12마리, 스쿠티카 의심"

[투약 기록 템플릿]
"투약, {수조번호}, {약품명}, {용량}, {투여경로}"
→ "투약, 3호, 옥시테트라사이클린, 리터당 50밀리그램, 경구투여"
앞의 "급이/수질/폐사/투약" 같은 키워드가 인텐트 트리거 역할을 한다.
이거 하나만 정확히 잡아도 뒤쪽 슬롯 매칭 정확도가 극적으로 올라간다.
왜냐하면 "급이"라고 했으면 뒤에 나올 단위는 kg일 확률이 압도적이니까.
이게 바로 문맥 기반 사후 보정(Contextual Biasing)이다.
7. 실제로 얼마나 빨라지나 — 숫자로 보는 효과
물론 이 수치는 조건에 따라 달라진다. 하지만 방향성은 명확하다.
음성 입력은 손 입력 대비 2~4배 빠르다. 이건 타이핑 속도와 말하기 속도의 물리적 차이다.
사람의 평균 발화 속도는 분당 약 150~200음절,
스마트폰 터치 입력은 분당 약 30~40타(한글 기준).
장갑을 끼면? 더 떨어진다. 애초에 정전식 터치가 잘 안 먹는다.
연쇄 효과가 더 크다
① 기록이 빨라짐 → ② 현장에서 즉시 기록함 → ③ 지연 회상 오차 사라짐
→ ④ 데이터 신뢰도 상승 → ⑤ FCR·폐사율 분석이 실제로 맞아떨어짐
→ ⑥ 사료 낭비·질병 대응 개선 → ⑦ 수익 개선
기록은 단순 행정이 아니다. 기록의 질이 곧 양식 경영의 질이다.
8. 수산 데이터의 진짜 가치 — 기록이 만드는 것들
8-1. 사료계수(FCR) 계산이 정확해진다
양식 경영에서 사료비는 생산원가의 50~70%를 차지한다.
그래서 FCR(Feed Conversion Ratio, 사료계수)은 곧 수익성 지표다.
FCR = 총 급이 사료량(kg) ÷ 총 증체량(kg)

예) 사료 1,200kg 투입 → 증체 1,000kg
    FCR = 1.2  (낮을수록 우수)

주요 어종 통상 범위(EP사료 기준)
  넙치   : 1.0 ~ 1.4
  조피볼락: 1.1 ~ 1.5
  참돔   : 1.2 ~ 1.6
  뱀장어  : 1.3 ~ 1.8
그런데 급이 기록이 "대충 40kg"이면?
FCR 계산 자체가 무의미해진다.
하루 5kg씩 어긋나면 6개월이면 900kg 오차다. 사료값으로 200만 원 넘게 벌어진다.
8-2. 질병 조기 경보
양식 어류 질병은 초기 24~48시간 대응이 생존율을 가른다.
그런데 질병의 첫 신호는 대개 폐사가 아니라 섭이율 저하다.
질병 발생 전형적 시퀀스
Day 0: 섭이율 소폭 감소 (기록 안 하면 못 느낌)
Day 1: 유영 이상, 수면 부상
Day 2: 섭이율 30% 이상 급감
Day 3: 폐사 시작
Day 5~7: 폐사 급증 (이 시점엔 이미 늦음)
음성 일지로 매 급이마다 "섭이 양호/보통/불량"만 말해도
시스템이 추세를 잡아서 Day 1에 경보를 울릴 수 있다.
주요 양식 어류 질병도 알아두면 좋다.
스쿠티카증(넙치, 기생충성, 저수온기), 비브리오증(세균성, 고수온기),
연쇄구균증(고수온기), 이리도바이러스 감염증(바이러스성, 25℃ 이상),
활주세균증(치어기 다발) 등이 대표적이다.
이런 질병들은 대부분 수온 조건과 강하게 연관된다.
그래서 수온 기록 + 폐사 기록 + 섭이 기록이 같은 타임라인에 쌓이면
다음 해에 같은 시기 예방적 대응이 가능해진다.
8-3. 휴약기간, 이건 진짜 자동화가 답이다
수산용 의약품에는 어종·수온별 휴약기간이 지정되어 있다.
그리고 어류는 변온동물이라 수온이 낮으면 약물 대사가 느려져서 휴약기간이 길어진다.
이걸 사람이 계산하면 실수한다.
하지만 음성 일지에 투약 기록과 수온 기록이 모두 들어가 있으면?
[자동 계산 로직 개념]
투약일 : 2024-11-01
약품   : 옥시테트라사이클린
어종   : 넙치
휴약기준: 설정된 적산수온(度日) 도달 시까지

매일 수온 누적:
 11/01  14.2℃  → 누적 14.2
 11/02  14.0℃  → 누적 28.2
 11/03  13.8℃  → 누적 42.0
 ...
→ 기준 적산수온 도달일에 "출하 가능" 알림 자동 발송
→ 도달 전 출하 시도 시 시스템에서 경고 차단
주의 — 실제 휴약기간은 약품 허가사항(제품 라벨)과 관련 고시에 따라야 한다.
시스템은 보조 도구일 뿐, 최종 확인은 수산질병관리사 또는 수의사 지도를 따를 것.
어떤 소프트웨어도 법적 책임을 대신해주지 않는다.
8-4. 이력추적과 소비자 신뢰
요즘 소비자는 "이 광어 어디서 왔어?"를 진지하게 묻는다.
수산물 이력추적제도는 생산-가공-유통 단계 정보를 연결하는 체계인데,
그 출발점이 바로 양식장의 생산 기록이다.
음성으로 쌓인 일지는 이미 디지털이고 타임스탬프가 붙어 있으니,
이력 정보로 내보내는 데 추가 작업이 거의 없다.
"기록을 위한 기록"이 "가치를 만드는 기록"으로 바뀌는 지점이다.
9. 도입할 때 진짜 챙겨야 할 체크리스트
9-1. 하드웨어
마이크/헤드셋
· 방수 등급 IPX5 이상 (해수 튐 대응), 가능하면 IPX7
· 골전도 또는 붐 마이크형 (근접 마이크 확보)
· 연속 사용 8시간 이상 배터리
· 장갑 끼고 누를 수 있는 큰 물리 버튼 (PTT: Push-To-Talk)
단말기
· IP67/IP68 러기드 스마트폰 또는 방수 케이스
· 저온에서 배터리 급감 대비 (겨울 해상 필수)
· 화면 확인용이지 입력용이 아니므로 크기보다 내구성 우선
현장에서 실제로 망하는 이유 1위
"음성인식 정확도"가 아니다. 배터리와 방수다.
아무리 좋은 AI도 물에 빠진 폰에선 안 돌아간다.
그리고 겨울 해상에서 영하 5도면 배터리가 3시간 만에 죽는다.
→ 보조배터리 + 방수 파우치는 예산에 반드시 포함시킬 것.
9-2. 소프트웨어 선택 기준
| 체크 항목 | 확인 질문 |
|---|---|
| 오프라인 동작 | 인터넷 없이 녹음·저장·인식이 되는가? |
| 도메인 사전 | 수산 전문용어를 직접 등록할 수 있는가? |
| 방언 대응 | 지역 발화 테스트를 해봤는가? |
| 원본 보관 | 음성 원본을 일정 기간 보관하는가? (분쟁 대비) |
| 수정 이력 | 누가 언제 무엇을 고쳤는지 로그가 남는가? |
| 데이터 내보내기 | CSV/Excel/API로 내 데이터를 가져올 수 있는가? |
| 범위 검증 | 말도 안 되는 값을 자동으로 잡아주는가? |
| 다중 사용자 | 작업자별 계정과 권한이 분리되는가? |
특히 데이터 내보내기는 꼭 확인해야 한다.
내 양식장 데이터가 특정 업체 서버에 갇혀버리는 락인(Lock-in)은 정말 흔한 함정이다.
3년 쌓은 데이터를 못 가져오면, 그건 내 데이터가 아니다.
9-3. 사람 — 가장 중요한 변수
기술 도입 실패의 대부분은 기술 문제가 아니라 수용성 문제다.
현장 정착 3단계 전략
1단계 (1~2주) — 병행 운영
종이 일지를 없애지 말고 음성 입력을 같이 해본다.
"종이 버려라"라고 하면 저항이 생긴다. 신뢰가 먼저다.
2단계 (3~4주) — 항목 축소 시작
음성 인식률이 안정된 항목부터 종이에서 뺀다.
보통 수질 측정값이 가장 먼저 안정된다. 숫자 패턴이 단순하니까.
3단계 (2개월~) — 전환 완료 + 피드백 루프
자주 틀리는 단어를 모아서 사전에 추가한다.
이 과정을 한 달에 한 번만 해도 인식률이 눈에 띄게 올라간다.
그리고 하나 더. 고령 작업자에게는 음성이 오히려 유리하다.
작은 글씨 터치 입력은 노안에 최악이지만, 말하는 건 평생 해온 일이다.
실제로 현장에서 "이게 훨씬 편하다"는 반응이 나오는 층이 60대 이상인 경우가 많다.
10. 한계와 주의점 — 과장 없이 솔직하게
음성인식 일지가 만능은 아니다. 명확한 한계가 있다.
① 극단 소음 환경에서는 여전히 어렵다
90dB 넘는 선별 작업 중에는 근접 마이크를 써도 오류가 난다.
→ 대응: 소음 구간에는 간단 버튼 입력을 병행하는 하이브리드 UI.
② 동음이의어는 영원한 숙제다
"이십사호"가 24호인지 2, 4호 두 개인지 문맥 없이는 모호하다.
→ 대응: 수조 번호 체계를 발화 친화적으로 재설계 (A-1, B-2 식)
③ 프라이버시와 데이터 소유권
음성은 개인식별 가능 정보다.
근로자 음성을 상시 녹음한다면 사전 고지와 동의가 필요하고,
보관 기간·접근 권한·파기 절차를 명문화해야 한다.
PTT(버튼 누를 때만 녹음) 방식이 상시 녹음보다 훨씬 안전하다.
④ 기록의 법적 효력
자동 생성 기록도 사람의 확인·서명 절차가 있어야 공식 기록으로 인정받기 쉽다.
→ 하루 마감 시 일괄 검토 + 전자서명 프로세스를 넣는 게 안전하다.
⑤ 오인식이 조용히 쌓이는 위험
이게 가장 무섭다. 종이는 틀리면 눈에 보이는데,
디지털은 142℃가 그냥 저장되고 아무도 안 본다.
→ 그래서 범위 검증과 주간 이상치 리포트는 필수다.
결국 이런 구조가 정답
음성 입력  →  자동 구조화  →  자동 검증
    ↓              ↓              ↓
 빠르다        정확하다      틀린 걸 잡는다
                                  ↓
                          사람의 최종 확인
                                  ↓
                          신뢰 가능한 기록
AI는 입력을 빠르게 해줄 뿐, 판단은 여전히 사람 몫이다.
11. 앞으로 어떻게 될까
11-1. 센서 자동기록과의 역할 분담
"어차피 수온·DO는 센서가 자동으로 재는데 음성이 왜 필요해?"
좋은 질문이다. 그리고 답은 명확하다.
| 기록 유형 | 최적 수단 | 이유 |
|---|---|---|
| 수온·DO·pH·염분 | 센서 자동 | 연속 측정, 사람 개입 불필요 |
| 급이량 | 자동급이기 or 음성 | 수동 급이면 음성이 유일 |
| 폐사 마리수 | 음성 | 사람이 건져서 세야 함 |
| 어체 상태 관찰 | 음성 | 정성적 판단, 센서 불가 |
| 투약·처치 | 음성 | 사람의 행위 기록 |
| 시설 이상·수리 | 음성 | 돌발 상황 서술 |
즉 센서는 "환경"을 기록하고, 음성은 "사람의 관찰과 행위"를 기록한다.
둘은 경쟁 관계가 아니라 완벽한 보완 관계다.
그리고 양식에서 가장 중요한 정보 — "오늘 고기 상태가 좀 이상한데?" — 는
지금도 앞으로도 숙련자의 눈과 입에서 나온다.
11-2. 멀티모달로 가는 흐름
다음 단계는 음성 + 영상 + 센서가 한 번에 묶이는 형태다.
작업자: (폐사어 촬영하며) "3호, 폐사 8마리, 아가미 창백함"

시스템 처리:
  ├─ 음성 → 텍스트 → 구조화 데이터
  ├─ 사진 → 어종 분류 + 체장 추정 + 병변 탐지
  ├─ 센서 → 해당 시각 수온 14.2℃, DO 5.9 자동 결합
  └─ 통합 레코드 생성 + 유사 과거 사례 3건 자동 제시
여기에 LLM(대규모 언어모델)이 붙으면 자유 발화 이해력이 크게 올라간다.
템플릿 없이 "오늘 삼호 좀 상태가 안 좋아서 사료 좀 줄여서 삼십킬로만 줬어"라고 해도
급이량 30kg, 감량 사유=어체상태 불량으로 정리해준다.
다만 LLM은 없는 값을 그럴듯하게 지어내는(할루시네이션) 위험이 있다.
그래서 숫자 필드는 반드시 원본 발화와 대조 검증하는 설계가 필요하다.
"AI가 알아서 채워주는 것"과 "AI가 상상해서 채우는 것"은 완전히 다른 얘기다.
11-3. 데이터가 쌓이면 생기는 힘
3년치 정확한 양식일지가 쌓이면 이런 게 가능해진다.
· 어종별·계절별 최적 급이 곡선 도출
· 고수온기 폐사 예측 모델 학습
· 출하 시기·체중 시뮬레이션
· 정책자금·재해보험 청구 시 객관적 증빙
· 후계자에게 넘길 수 있는 암묵지의 형식지화
마지막 항목이 특히 크다.
30년 경력 양식업자의 감(感)은 어마어마한 자산인데,
지금까지는 그 사람이 은퇴하면 같이 사라졌다.
기록되면 남는다. 음성인식은 그 기록의 문턱을 극단적으로 낮춘다.
이런 스마트 양식·수산 데이터 기술에 대해 더 깊이 배우고 싶거나,
반대로 본인의 현장 노하우를 나누고 싶다면
재능넷(https://www.jaenung.net)의 '지식인의 숲' 같은 지식 공유 공간을 활용해보는 것도 방법이다.
수산·농식품 분야는 특히 현장 경험이 곧 전문성인 영역이라,
서로의 데이터와 시행착오를 공유하는 것만으로도 배우는 게 많다.
12. 정리 — 오늘 기억할 것들
오늘의 요약 8줄
1. 양식일지는 법적 의무이자 경영의 기초 데이터다.
2. 종이 일지의 최대 적은 "나중에 몰아 쓰기"다.
3. 음성인식의 핵심은 받아쓰기가 아니라 구조화(슬롯 필링)다.
4. 양식장은 소음·방언·전문용어 3중고 환경 → 도메인 튜닝 필수.
5. 숫자 오류(특히 소수점)가 1위 → 범위 검증은 생명줄.
6. 오프라인 우선 설계와 방수·배터리가 실전 성패를 가른다.
7. 센서는 환경을, 음성은 사람의 관찰과 행위를 기록한다.
8. 기록이 쌓이면 감(感)이 데이터가 되고, 데이터는 수익이 된다.
솔직히 말하면, 음성인식 일지는 화려한 기술이 아니다.
AI가 물고기 질병을 스스로 진단하는 것 같은 임팩트도 없다.
그런데 현장에서 가장 먼저, 가장 확실하게 효과를 내는 건 이런 기술이다.
매일 반복되는 작은 불편을 없애는 것.
하루 40분의 기록 노동을 15분으로 줄이는 것.
그리고 그 과정에서 믿을 수 있는 데이터가 자동으로 쌓이게 만드는 것.
스마트 양식이란 결국 거창한 게 아니라,
장갑 낀 손으로도 정확한 기록이 남는 환경을 만드는 일이다.
내일 아침 5시, 그 차가운 데크 위에서
"3호, 수온 14.2도, 급이 40킬로, 섭이 양호" 한마디면 끝나는 세상.
이미 시작됐고, 생각보다 가까이 와 있다. 🐟
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.