Ver4.0 영상 속 인물을 자동으로 가려주는 모자이크 기술, 얼굴 검출부터 추적·렌더링까지 작동 원리 이야기
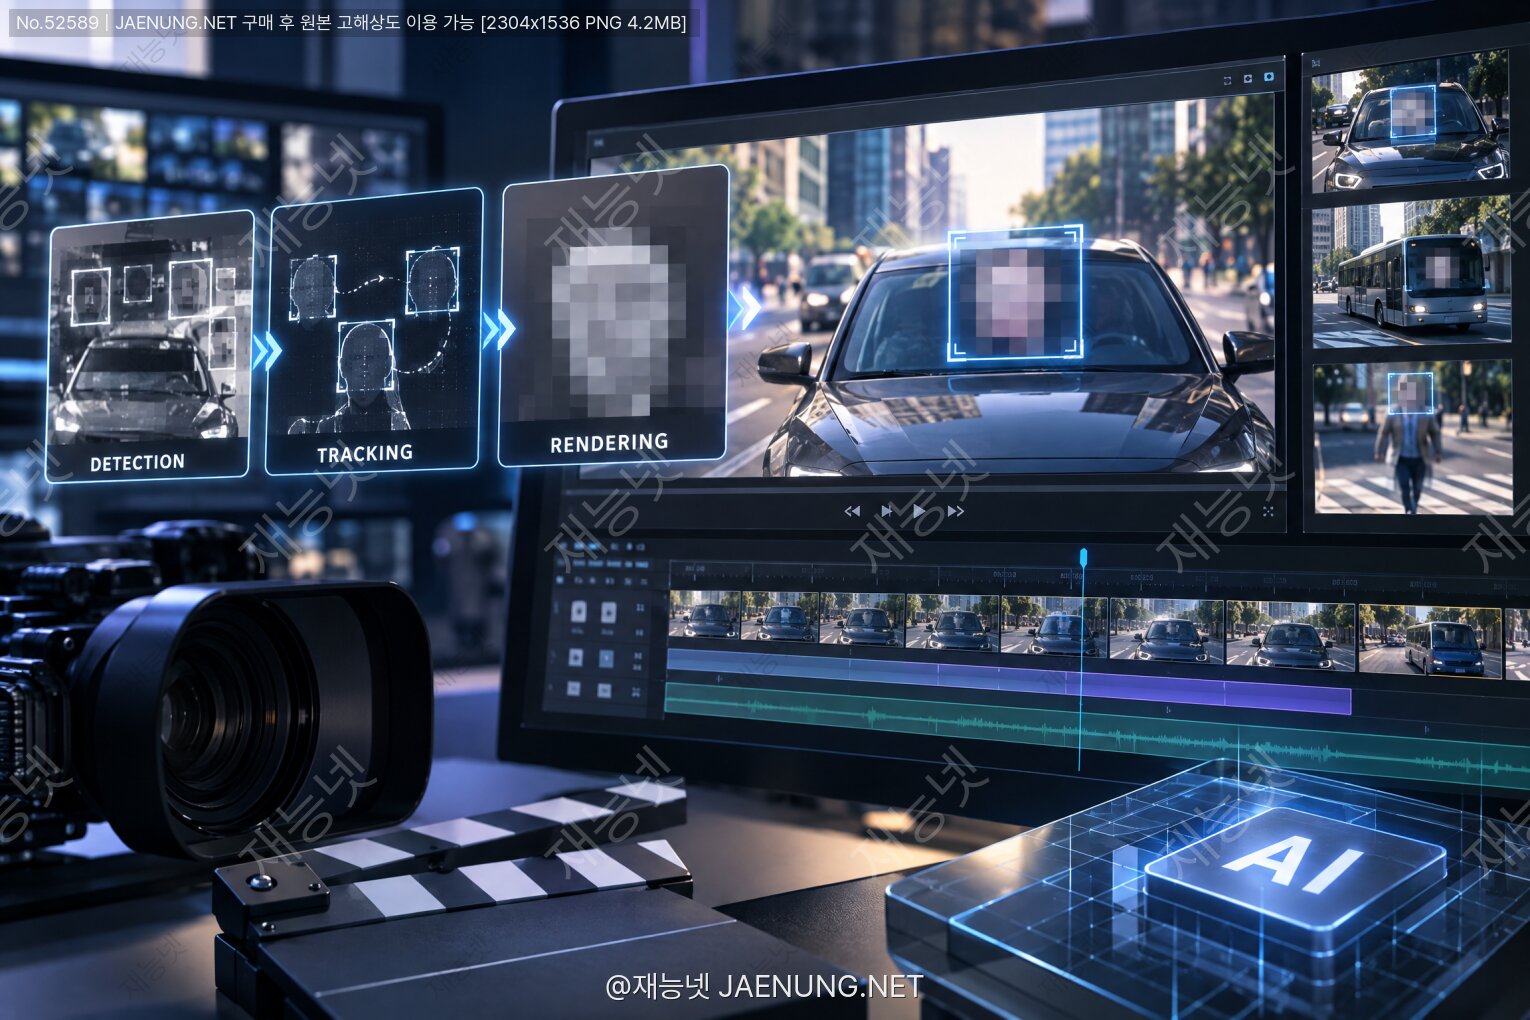
영상 속 인물을 자동으로 가려주는 모자이크 기술, 얼굴 검출부터 추적·렌더링까지 작동 원리 이야기
얼굴 하나하나 손으로 찍어 가리던 시대는 끝났다는 그 이야기, 친구처럼 풀어드립니다
🎬 들어가기 전에: 왜 갑자기 다들 '자동 모자이크'를 찾게 됐을까?
브이로그 하나 찍어서 올리려는데, 배경에 지나가던 사람 얼굴이 12명 찍혔다고 생각해 보자.
게다가 그게 4분 30초 길이의 60fps 영상이라면? 총 프레임 수는 약 16,200장이다.
프레임마다 얼굴 위치를 손으로 찍어서 마스크를 이동시킨다고 상상만 해도 손목이 아프다.
그래서 등장한 게 자동 모자이크(Automatic Face/Person Anonymization) 기술이다.
간단히 말하면 "영상을 읽어서 → 사람(또는 얼굴)을 찾아내고 → 그 자리를 흐리거나 픽셀화해서 → 다시 영상으로 굽는" 파이프라인이다.
그런데 이게 그냥 "AI가 알아서 해줌 ✨"으로 끝나는 마법이 아니다.
검출(Detection), 추적(Tracking), 마스킹(Masking), 인코딩(Encoding)이라는 네 개의 단계가 톱니바퀴처럼 물려 돌아간다.
그리고 각 단계마다 재미있는 실패 사례와 기술적 트레이드오프가 숨어 있다.
이 글에서 다루는 것
① 자동 모자이크 파이프라인의 4단 구조
② 얼굴/사람 검출 모델의 계보 (Haar → HOG → MTCNN → YOLO/RetinaFace)
③ 프레임 사이를 연결하는 추적 알고리즘(IoU, 칼만 필터, ReID)
④ 모자이크·블러·인페인팅·가상얼굴 교체의 차이
⑤ 영상 변환 관점에서의 코덱·비트레이트·키프레임 문제
⑥ 법·윤리 측면과 실무 체크리스트
🧩 1단계 · 디코딩: 영상은 '사진 모음'이 아니다
많은 사람이 오해하는 지점부터 짚고 가자.
영상 파일은 사진을 순서대로 붙여놓은 게 아니다.
H.264, H.265(HEVC), VP9, AV1 같은 코덱은 시간적 중복(temporal redundancy)을 제거해서 용량을 줄인다.
즉, 프레임은 크게 세 종류로 나뉜다.
| 프레임 종류 | 정식 명칭 | 특징 | 모자이크 작업에서의 의미 |
|---|---|---|---|
| I-프레임 | Intra / Key frame | 자기 혼자서 완전한 그림 | 여기서만 정확히 seek 가능 |
| P-프레임 | Predicted | 앞 프레임과의 차이만 저장 | 단독 복원 불가 |
| B-프레임 | Bi-directional | 앞뒤 프레임 모두 참조 | 디코딩 순서 ≠ 표시 순서 |
그래서 자동 모자이크 툴이 "영상을 불러오는 중..." 하면서 시간을 잡아먹는 이유가 여기 있다.
디코더가 GOP(Group of Pictures) 단위로 압축을 풀어서 RGB 또는 YUV 픽셀 배열로 되돌려놔야 검출 모델이 볼 수 있기 때문이다.
YUV vs RGB, 그리고 4:2:0의 함정
대부분의 소비자 영상은 YUV 4:2:0 방식으로 저장된다.
휘도(Y)는 픽셀마다 다 저장하지만, 색차(U, V)는 가로·세로 절반으로 줄여서 저장한다.
사람 눈이 밝기 차이엔 민감하고 색 차이엔 둔하다는 점을 이용한 것이다.
여기서 재미있는 부작용이 생긴다.
모자이크를 아주 작게 적용했는데 저장 후 다시 보니 색이 살짝 번져 나온 경우를 본 적이 있을 것이다.
색차 채널이 절반 해상도라서, 모자이크 경계에서 색이 옆 블록으로 새어나가는 것이다.
실무 팁
아주 정밀한 마스킹이 필요하다면 중간 작업물을 4:4:4 또는 무손실(FFV1, ProRes 4444)로 유지하고,
최종 출력에서만 4:2:0으로 내려주는 게 안전하다.
용량은 커지지만 "모자이크 밖으로 얼굴색이 새는" 사고를 막을 수 있다.
해상도 다운스케일: 속도의 절반은 여기서 나온다
4K(3840×2160) 프레임을 그대로 딥러닝 모델에 넣으면 연산량이 미친다.
그래서 거의 모든 실무 파이프라인은 검출용 축소 프레임과 렌더용 원본 프레임을 분리해서 쓴다.
흐름은 이렇다.
원본 4K 프레임
  ├─(1/4 축소)→ 960×540 → 검출 모델 → 박스 좌표(축소 기준)
  │                                        ↓
  │                              좌표 × 4 (스케일 복원)
  └─────────────────────────────→ 원본 해상도에 마스킹 적용
연산량은 대략 가로·세로 축소 비율의 제곱만큼 줄어든다.
1/4로 줄이면 픽셀 수는 1/16. 계산이 확 가벼워진다.
주의
너무 많이 줄이면 멀리 있는 작은 얼굴이 그냥 사라진다.
얼굴이 축소 후 16×16 픽셀 이하가 되면 대부분의 검출 모델이 놓친다.
군중 장면이라면 축소율을 1/2 정도로 보수적으로 잡거나, 타일 분할(tiling) 방식으로 나눠서 검출해야 한다.
👀 2단계 · 검출: 컴퓨터는 어떻게 '사람'을 알아보는가
이 부분이 자동 모자이크의 심장이다.
그리고 기술의 계보를 따라가 보면 꽤 흥미로운 진화 이야기가 나온다.
① Haar Cascade (2001) — 명암 패턴으로 얼굴 찾기
Viola와 Jones가 발표한 고전이다.
아이디어는 놀라울 정도로 단순하다. "얼굴에는 공통된 명암 패턴이 있다."
예를 들어 눈 영역은 이마·볼보다 어둡다.
콧대는 양옆 뺨보다 밝다.
이런 흑백 직사각형 필터(Haar-like feature) 수천 개를 이미지에 대보고, 통과하면 다음 단계, 실패하면 즉시 탈락시킨다.
이 계단식 탈락(cascade) 구조 덕분에 2001년 당시 CPU로도 실시간 동작이 가능했다.
지금도 OpenCV에 기본 내장되어 있어서, 옛 디지털카메라의 얼굴인식 사각형은 대체로 이 계열이었다.
하지만 단점이 명확하다.
정면 얼굴만 잘 찾는다. 고개를 30도만 돌려도 놓치고, 마스크를 쓰면 무너지고, 역광이면 포기한다.
반대로 커튼 주름이나 나무 껍질을 얼굴로 착각하는 오검출(false positive)도 흔했다.
② HOG + SVM (2005) — 윤곽의 방향을 읽다
HOG(Histogram of Oriented Gradients)는 이미지를 작은 셀로 나눠서, 각 셀 안의 밝기 변화 방향을 히스토그램으로 정리한다.
사람의 실루엣은 어깨-머리-다리로 이어지는 특유의 그라디언트 패턴을 갖는다.
이 특징 벡터를 SVM(서포트 벡터 머신)으로 분류하면 "사람인가 아닌가"를 판단할 수 있다.
보행자 검출 분야에서 오랫동안 표준이었고, dlib 라이브러리의 얼굴 검출기도 이 방식을 채택했다.
Haar보다 조명 변화에 강하지만, 여전히 각도 변화와 가림(occlusion)에는 약했다.
③ MTCNN (2016) — 3단 캐스케이드 신경망
딥러닝이 본격 투입된 시점이다.
MTCNN(Multi-task Cascaded CNN)은 세 개의 네트워크를 순서대로 통과시킨다.
| 단계 | 이름 | 역할 |
|---|---|---|
| 1 | P-Net (Proposal) | 후보 영역을 대량 생성 (빠르고 대충) |
| 2 | R-Net (Refine) | 가짜 후보를 걸러내고 박스 위치 보정 |
| 3 | O-Net (Output) | 최종 확정 + 5개 랜드마크(양눈·코·입양끝) 출력 |
랜드마크가 함께 나오는 게 큰 장점이다.
눈·코·입 좌표를 알면 얼굴의 기울기와 회전 각도를 계산할 수 있고, 모자이크 모양을 얼굴 방향에 맞춰 회전시킬 수도 있다.
④ 단일 패스 검출기: YOLO / SSD / RetinaFace
현재 자동 모자이크 서비스의 주력은 대부분 이 계열이다.
핵심 개념은 "이미지를 한 번만 보고(You Only Look Once) 모든 객체의 위치와 클래스를 동시에 출력한다"는 것.
동작 방식을 아주 단순화하면 이렇다.
① 이미지를 격자(grid)로 나눈다.
② 각 격자 셀마다 "여기에 객체 중심이 있을까?"를 예측한다.
③ 있다면 박스의 중심 좌표(x, y), 너비/높이(w, h), 신뢰도(confidence), 클래스 확률을 뱉는다.
④ 겹치는 박스는 NMS(Non-Maximum Suppression)로 하나만 남긴다.
RetinaFace는 여기에 얼굴 전용 설계를 더했다.
5점 랜드마크 예측과 다중 스케일 특징 피라미드(FPN)를 활용해, 아주 작은 얼굴부터 큰 얼굴까지 동시에 잡아낸다.
실제로 WIDER FACE라는 난이도 높은 벤치마크의 'Hard' 세트에서 90% 이상의 평균 정밀도를 기록했다.
얼굴만 가려도 되는 걸까? — 세그멘테이션의 등장
여기서 중요한 논점이 하나 있다.
얼굴만 가려도 사람이 재식별(re-identification)될 수 있다는 점이다.
독특한 문양의 옷, 체형, 걸음걸이, 머리 스타일, 신분증이나 명찰, 차량 번호판, 심지어 문신 하나로도 신원이 특정될 수 있다.
실제로 방송 심의나 공공기관 영상 공개 기준에서는 얼굴 외 식별 요소도 처리 대상으로 본다.
그래서 최근 도구들은 두 가지 모드를 제공한다.
박스 모드: 얼굴/사람 주변에 사각형을 그리고 그 안을 처리. 빠르지만 배경까지 뭉개진다.
세그멘테이션 모드: 픽셀 단위로 "사람에 속하는 픽셀"만 골라내 처리. 자연스럽지만 연산량이 몇 배로 늘어난다.
세그멘테이션은 Mask R-CNN, YOLO-seg, SAM(Segment Anything Model) 계열이 쓰인다.
특히 SAM 계열은 "여기 한 점 찍어줘" 하면 그 객체의 외곽선을 알아서 따내는 능력이 뛰어나, 반자동 워크플로에서 인기가 높다.
신뢰도 임계값(Confidence Threshold)의 딜레마
검출 모델은 "이건 얼굴일 확률 0.87" 같은 점수를 낸다.
여기서 우리는 기준선을 정해야 한다.
| 임계값 | 결과 | 부작용 |
|---|---|---|
| 0.8 (높게) | 확실한 얼굴만 가림 | 흐릿한 얼굴 누락 → 개인정보 유출 위험 |
| 0.5 (중간) | 일반적인 균형점 | 가끔 오검출, 가끔 누락 |
| 0.2 (낮게) | 의심스러운 것도 다 가림 | 포스터·인형·얼룩까지 모자이크 |
개인정보 보호가 목적이라면 임계값은 낮게 잡는 게 원칙이다.
"괜히 가려진 간판" 몇 개는 편집으로 수습할 수 있지만,
"안 가려진 얼굴" 한 장은 돌이킬 수 없다.
이것을 업계에서는 보수적 마스킹 원칙(fail-safe masking) 이라고 부른다.
🔗 3단계 · 추적: 프레임 사이의 빈틈을 메우는 기술
여기가 자동 모자이크의 진짜 승부처다.
검출 모델이 아무리 좋아도, 프레임마다 독립적으로 검출하면 문제가 생긴다.
왜냐하면 검출은 확률적이기 때문이다.
100프레임 중 97프레임은 잘 찾았는데, 눈을 감거나 고개를 돌린 3프레임에서 놓쳤다면?
그 3프레임 동안 얼굴이 그대로 노출된다. 0.05초짜리 사고지만, 캡처 한 장이면 끝이다.
IoU 기반 매칭: 가장 단순하고 효과적인 방법
IoU(Intersection over Union)는 두 박스가 얼마나 겹치는지를 0~1로 나타낸 값이다.
IoU = (두 박스의 교집합 면적) / (두 박스의 합집합 면적)

IoU = 1.0 → 완전히 같은 위치
IoU = 0.5 → 절반 정도 겹침
IoU = 0.0 → 전혀 겹치지 않음
이전 프레임의 박스 A와 현재 프레임의 박스 B의 IoU가 0.3 이상이면 "같은 사람"으로 간주하고 같은 ID를 부여한다.
빠르고 구현이 쉽지만, 움직임이 빠르면(카메라 패닝, 달리기) 박스가 겹치지 않아 ID가 끊긴다.
칼만 필터: 다음 위치를 예측하다
칼만 필터(Kalman Filter)는 원래 아폴로 우주선 항법에 쓰인 알고리즘이다.
"현재 상태 + 운동 모델"로 다음 상태를 예측하고, 실제 관측값이 들어오면 그 예측을 보정한다.
얼굴 추적에서는 상태 벡터를 이렇게 잡는다.
상태 = [중심x, 중심y, 면적s, 종횡비r, x속도, y속도, 면적변화율]

1) 예측(Predict): 등속 운동을 가정해 다음 프레임 위치 추정
2) 관측(Observe): 검출기가 실제 박스를 제공
3) 갱신(Update): 예측과 관측을 가중 평균해 최적 추정치 확정
이 방식의 아름다움은 검출이 실패한 프레임에서도 위치를 추정할 수 있다는 점이다.
관측값이 없으면 예측값만으로 박스를 유지한다. 그래서 눈 깜빡이는 3프레임도 가려진다.
SORT(Simple Online and Realtime Tracking)가 바로 이 칼만 필터 + 헝가리안 알고리즘 조합이다.
헝가리안 알고리즘은 "여러 예측 박스와 여러 검출 박스를 어떻게 1:1로 최적 매칭할지"를 수학적으로 푸는 방법이다.
외형 특징(ReID): 겹쳐도 헷갈리지 않기
두 사람이 스쳐 지나가면 박스가 겹친다.
위치 정보만으로는 "누가 누구였는지" ID가 뒤바뀌는 ID switch가 일어난다.
DeepSORT는 여기에 외형 임베딩(appearance embedding)을 추가했다.
사람 이미지를 작은 CNN에 통과시켜 128차원 정도의 벡터로 만들고, 이 벡터 간 코사인 거리를 비교한다.
빨간 옷 사람과 파란 옷 사람은 벡터가 확실히 다르니, 겹쳤다가 분리되어도 제대로 되찾아온다.
ByteTrack은 또 다른 영리한 접근을 한다.
보통 낮은 신뢰도 박스는 버리는데, ByteTrack은 그걸 기존 트랙과 매칭해보는 2차 시도에 활용한다.
"신뢰도가 낮지만 기존 트랙 위치와 맞아떨어진다면, 그건 가려진 진짜 사람이다"라는 논리다.
오프라인 처리의 특권: 미래를 볼 수 있다
실시간 스트리밍이라면 과거 프레임만 쓸 수 있다.
하지만 영상 파일을 변환하는 오프라인 처리에서는 반칙급 무기가 있다. 바로 양방향 보간이다.
프레임  100  101  102  103  104  105
검출     O    O    X    X    O    O
                ↑    ↑
        앞뒤 모두 알고 있으므로 선형/스플라인 보간 가능
102, 103 프레임에서 검출이 실패했어도, 101과 104의 박스 좌표를 알고 있으니 중간값을 계산해 채워 넣을 수 있다.
여기에 스무딩(smoothing)까지 적용하면 모자이크가 덜덜 떨리는 현상(jitter)도 사라진다.
떨림의 정체
프레임마다 검출 박스가 2~3픽셀씩 미세하게 흔들린다.
사람 눈은 이 진동을 민감하게 감지해서 "모자이크가 지글거린다"고 느낀다.
해결책은 이동 평균(moving average) 또는 사비츠키-골레이 필터로 좌표 궤적을 매끄럽게 펴주는 것이다.
보통 5~9프레임 윈도우면 충분하다.
🎨 4단계 · 마스킹: 모자이크, 블러, 그리고 그 너머
드디어 가리는 단계다.
그런데 "가린다"는 방법도 종류가 꽤 많고, 각각 복원 가능성과 시각적 인상이 다르다.
① 픽셀화(Pixelate / Mosaic)
가장 익숙한 방식이다.
영역을 N×N 블록으로 나누고, 각 블록 안 픽셀들의 평균 색으로 전체를 칠한다.
블록 크기 8px → 부드럽게 뭉개짐, 형태 어느 정도 유추 가능
블록 크기 16px → 일반 방송 수준
블록 크기 24px 이상 → 거의 색 덩어리, 식별 불가
중요한 팩트: 블록 크기는 영상 해상도에 비례해야 한다.
1080p에서 16px 블록은 충분하지만, 4K에서 같은 16px을 쓰면 상대적으로 너무 작아서 얼굴 윤곽이 남는다.
그래서 잘 만든 도구는 "얼굴 박스 크기의 X%"로 블록 크기를 자동 계산한다.
② 가우시안 블러(Gaussian Blur)
주변 픽셀들을 정규분포 가중치로 섞어 흐리게 만든다.
모자이크보다 부드럽고 영상 톤을 덜 깨뜨려서, 다큐멘터리나 브이로그에서 선호된다.
블러의 강도는 시그마(σ)와 커널 크기로 조절한다.
다만 약한 블러는 위험하다. 디컨볼루션(deconvolution) 기법으로 상당 부분 되돌릴 수 있기 때문이다.
복원 공격(De-anonymization) 주의
약한 모자이크나 블러는 기술적으로 되돌릴 수 있다.
· 블러는 커널이 추정되면 위너 필터(Wiener filter)로 부분 복원 가능
· 픽셀화된 텍스트는 가능한 문자 조합을 전수 렌더링해 비교하면 해독 가능 (실제 연구 사례 다수)
· 딥러닝 초해상도 모델은 흐린 얼굴을 "그럴듯하게" 재구성할 수 있다 (단, 진짜 얼굴은 아님)
그래서 민감한 자료는 블랙박스(완전 검정 채우기) 또는 얼굴 교체 방식을 권장한다.
③ 솔리드 채우기 / 스티커 오버레이
영역을 단색으로 완전히 덮거나, 이모지·도형·캐릭터 이미지를 얹는다.
정보량이 0이 되므로 복원이 원리적으로 불가능하다. 가장 안전하다.
단점은 영상이 투박해 보인다는 것.
그래서 최근 예능·브이로그에서는 귀여운 스티커를 트래킹해 얼굴에 붙이는 연출이 유행했다. 안전성과 재미를 동시에 챙긴 셈이다.
④ 인페인팅(Inpainting) — 사람을 지워버리기
가리는 게 아니라 배경으로 채워서 없애는 방식이다.
주변 픽셀과 앞뒤 프레임 정보를 참조해 "그 사람이 없었다면 보였을 배경"을 생성한다.
영상에서는 특히 유리하다. 카메라가 움직이면 그 사람이 가리고 있던 배경이 다른 프레임에서는 보이기 때문이다.
그 정보를 끌어와 붙이면 놀라울 만큼 자연스럽게 사라진다.
다만 연산 비용이 매우 크고, 사람이 오래 같은 자리에 서 있으면 배경 정보가 없어서 뭉개진 유령 흔적이 남는다.
⑤ 얼굴 교체(Face Swap / Synthetic Anonymization)
가장 진보한 방식이다.
원래 얼굴을 실존하지 않는 생성된 얼굴로 바꿔 끼운다.
표정, 시선, 머리 방향, 조명은 원본을 따라가되 신원 정보만 갈아치우는 것이다.
이 방식이 왜 중요한가?
자율주행 학습 데이터나 의료·교육 영상에서는 사람이 있다는 사실과 표정·행동 정보는 살려야 한다.
모자이크를 씌우면 데이터로서의 가치가 사라진다. 얼굴 교체는 이 딜레마를 해결한다.
물론 딥페이크 기술과 같은 뿌리이므로, 오용 방지를 위한 워터마킹과 사용 기록 관리가 함께 요구된다.
| 방식 | 복원 난이도 | 자연스러움 | 연산 비용 | 추천 용도 |
|---|---|---|---|---|
| 픽셀화 | 중 | 보통 | 매우 낮음 | 일반 브이로그 |
| 가우시안 블러 | 낮~중 | 좋음 | 낮음 | 다큐·인터뷰 |
| 솔리드/스티커 | 불가 | 낮음 | 매우 낮음 | 법적 민감 자료 |
| 인페인팅 | 불가 | 매우 좋음 | 높음 | 배경 정리 |
| 얼굴 교체 | 불가 | 매우 좋음 | 매우 높음 | AI 학습 데이터 |
경계 처리: 페더링과 마진
박스를 딱 맞게 가리면 턱선이나 귀 일부가 삐져나온다.
검출 박스는 보통 얼굴 중심부만 잡기 때문이다.
그래서 실무에서는 박스를 10~25% 확장(padding)한다.
그리고 경계를 부드럽게 만드는 페더링(feathering)을 적용해, 모자이크 영역이 갑자기 튀지 않게 한다.
# 개념 코드 (의사 코드)
x1 = max(0, x1 - w * 0.15)
y1 = max(0, y1 - h * 0.20)   # 이마·머리카락 쪽을 더 넉넉히
x2 = min(W, x2 + w * 0.15)
y2 = min(H, y2 + h * 0.10)

mask = ellipse_mask(x1, y1, x2, y2)
mask = gaussian_blur(mask, sigma=6)      # 경계 페더링
out  = frame * (1 - mask) + mosaic * mask
타원형 마스크를 쓰는 이유도 있다. 얼굴은 사각형이 아니라 타원에 가깝기 때문에,
같은 면적으로도 불필요한 배경 훼손을 줄이면서 얼굴은 확실히 덮을 수 있다.
🧪 영상변환 관점: 재인코딩이라는 피할 수 없는 관문
이 글은 '영상변환' 카테고리에 속한다. 그러니 이 부분을 꼭 짚어야 한다.
모자이크를 넣으면 픽셀이 바뀐다. 픽셀이 바뀌면 반드시 다시 인코딩해야 한다.
즉 원본 → 디코딩 → 편집 → 재인코딩. 이 과정에서 세대 손실(generation loss)이 발생한다.
모자이크는 오히려 용량을 줄인다?
재미있는 사실이 있다.
모자이크와 블러는 고주파 성분(디테일)을 제거하기 때문에, 해당 영역의 압축 효율이 올라간다.
평평한 색 블록은 DCT 변환 후 계수가 거의 0에 몰려서 비트를 거의 안 먹는다.
대신 다른 문제가 생긴다. 모자이크 경계선이 급격한 밝기 변화라서, 그 자리에 링잉(ringing)이나 블록 노이즈가 끼기 쉽다.
페더링이 화질 측면에서도 도움이 되는 이유다.
CRF와 비트레이트: 어떻게 설정할까
| 설정 | H.264 권장값 | 설명 |
|---|---|---|
| CRF (품질 고정) | 17~20 | 재인코딩 손실 최소화. 18이 실무 기본값 |
| preset | medium~slow | 느릴수록 같은 용량에서 화질 상승 |
| pix_fmt | yuv420p | 범용 호환성 확보 |
| 오디오 | copy | 오디오는 건드릴 이유가 없으니 그대로 복사 |
오디오를 copy로 넘기는 건 중요한 디테일이다.
오디오까지 재인코딩하면 음질이 괜히 깎이고, 싱크가 미세하게 어긋날 수도 있다.
# 개념적 커맨드 예시
ffmpeg -i input.mp4 -i mask_overlay.mov \
  -filter_complex "[0:v][1:v]overlay=shortest=1[v]" \
  -map "[v]" -map 0:a \
  -c:v libx264 -crf 18 -preset slow -pix_fmt yuv420p \
  -c:a copy output.mp4
가변 프레임레이트(VFR)의 함정
스마트폰으로 찍은 영상은 종종 가변 프레임레이트다.
어두운 곳에서는 프레임레이트를 떨어뜨려 노출을 확보하기 때문이다.
문제는 대부분의 검출·추적 파이프라인이 "프레임 간격이 일정하다"고 가정한다는 것.
칼만 필터의 속도 추정이 어긋나고, 결과적으로 모자이크 위치가 밀린다.
해결책
처리 전에 고정 프레임레이트(CFR)로 정규화하자.
그리고 타임스탬프(PTS)를 프레임 인덱스와 함께 저장해두면, 마스크 데이터를 나중에 다른 해상도·프레임레이트 버전에 재적용할 때도 편하다.
마스크 데이터를 분리 보관하는 워크플로
고급 파이프라인에서는 검출 결과(좌표 메타데이터)와 렌더링을 분리한다.
{
  "video": "clip_001.mp4",
  "fps": 29.97,
  "resolution": [1920, 1080],
  "tracks": [
    { "id": 1, "class": "face",
      "frames": [
        {"n": 120, "box": [412, 233, 488, 318], "conf": 0.94},
        {"n": 121, "box": [415, 234, 491, 319], "conf": 0.93},
        {"n": 122, "box": [418, 236, 494, 321], "conf": 0.31, "src": "interp"}
      ]
    }
  ]
}
이렇게 JSON으로 빼두면 장점이 많다.
· 모자이크 강도를 바꾸고 싶을 때 검출을 다시 돌리지 않아도 된다 (가장 오래 걸리는 단계 생략)
· 특정 인물(ID)만 골라서 가리거나 풀 수 있다 (출연 동의한 사람은 공개, 나머지는 가림)
· 검수자가 잘못 잡힌 박스를 수동으로 수정할 수 있다
· SNS용 세로 버전, 유튜브 가로 버전에 동일 마스크를 스케일링해 재사용
이런 구조적 사고가 실무 품질을 결정한다. 실제로 재능넷의 '지식인의 숲'에 올라오는 영상 편집·후처리 관련 자료들을 보면, 이렇게 메타데이터 중심으로 파이프라인을 설계하는 접근이 꾸준히 강조된다.
📉 자동 모자이크가 실패하는 대표 상황 10가지
기술이 좋아졌다고 해도 만능은 아니다. 현장에서 실제로 자주 터지는 케이스를 모아봤다.
1. 측면 얼굴 (프로필)
눈 하나만 보이는 90도 측면은 검출률이 급락한다. 전신 검출을 병행해야 한다.
2. 뒤통수
얼굴 검출기는 뒤통수를 얼굴로 보지 않는다. 그런데 머리 스타일로 식별될 수 있다면 문제다.
3. 아주 작은 얼굴
군중 뒤편, 20픽셀 이하의 얼굴은 놓치기 쉽다. 타일 분할 검출이 필요하다.
4. 모션 블러
빠르게 움직이는 얼굴은 흐려져서 특징이 사라진다. 셔터스피드가 느린 영상에서 흔하다.
5. 극단적 역광·저조도
실루엣만 남으면 검출 불가. 사전에 감마 보정·히스토그램 평활화를 거치면 개선된다.
6. 마스크·선글라스·모자
가림이 심하면 신뢰도가 떨어진다. 다만 요즘 모델들은 마스크 착용 데이터로 학습되어 많이 나아졌다.
7. 화면 속 화면
TV 화면, 모니터, 포스터에 나오는 얼굴. 가려야 하는지 애매하고, 검출도 자주 놓친다.
8. 거울·유리 반사
반사된 얼굴은 놓치기 쉬운 대표적 사각지대다. 수동 검수가 필수다.
9. 급격한 컷 전환
씬이 바뀌면 추적 ID가 이어지면서 엉뚱한 곳에 모자이크가 남는다. 샷 경계 검출로 트랙을 끊어줘야 한다.
10. 얼굴이 아닌 식별 정보
명찰, 번호판, 문서, 화면에 뜬 전화번호, 택배 라벨. 얼굴 모델은 전혀 신경 쓰지 않는다.
그래서 결론은 이렇다.
자동 모자이크는 작업량을 90~98% 줄여주는 도구이지 최종 검수자가 아니다.
공개·납품 전에는 반드시 사람이 전수 또는 표본 검수를 해야 한다.
특히 컷 전환 직후 3~5프레임, 인물 등퇴장 순간, 군중 장면을 집중적으로 보면 대부분의 사고를 잡아낼 수 있다.
⚙️ 실시간 vs 오프라인: 두 개의 완전히 다른 세계
실시간 처리 (라이브 방송, CCTV)
제약이 혹독하다. 프레임 하나를 처리할 예산이 30fps면 33ms, 60fps면 16ms뿐이다.
그 안에 디코딩, 검출, 추적, 마스킹, 인코딩을 다 끝내야 한다.
그래서 다음 전략을 쓴다.
· 프레임 스킵 검출: 3~5프레임마다 한 번만 무거운 검출을 돌리고, 나머지는 가벼운 추적으로 위치 갱신
· 경량 모델: MobileNet 백본, nano/tiny 버전 모델 사용
· 양자화: FP32 → FP16 또는 INT8로 정밀도를 낮춰 속도 2~4배 확보
· 지연 버퍼: 2~5초 방송 지연을 의도적으로 걸어 처리 여유 확보
· 배치 추론: 여러 프레임을 묶어 GPU에 한 번에 밀어넣어 처리량 향상
오프라인 처리 (영상 파일 변환)
여기는 시간이 돈이지만, 정확도가 왕이다.
그래서 완전히 반대 전략을 쓴다.
· 모든 프레임 검출 + 고성능 대형 모델 사용
· 다중 모델 앙상블: 얼굴 검출기 + 사람 검출기 + 세그멘테이션 결과를 합집합으로 결합
· 다중 스케일 검출: 원본, 1/2, 2배 확대 등 여러 배율에서 검출해 작은 얼굴까지 포착
· 양방향 추적: 정방향·역방향 모두 돌려서 트랙 시작/끝의 누락 보완
· 2패스 렌더링: 1패스에서 마스크 메타데이터 생성, 검수 후 2패스에서 최종 인코딩
| 항목 | 실시간 | 오프라인 |
|---|---|---|
| 프레임 예산 | 16~33ms | 사실상 무제한 |
| 미래 프레임 참조 | 불가(또는 소량) | 전체 가능 |
| 모델 크기 | 경량 우선 | 정확도 우선 |
| 검수 개입 | 불가 | 가능 |
| 누락 대응 | 추적 관성으로 버팀 | 보간 + 수동 수정 |
⚖️ 법·윤리 이야기: 기술보다 중요한 기준
기술 이야기만 하면 반쪽이다.
자동 모자이크는 근본적으로 개인정보 보호를 위한 기술이기 때문이다.
영상 속 얼굴은 개인정보인가?
그렇다. 대한민국 개인정보 보호법상 살아 있는 개인을 알아볼 수 있는 정보는 개인정보다.
얼굴 영상은 특정 개인을 식별할 수 있으므로 개인정보에 해당하며,
나아가 얼굴 특징을 기계적으로 처리해 식별에 쓰는 정보는 민감정보(생체정보) 범주로 더 엄격하게 다뤄진다.
가명처리와 익명처리의 차이
이 구분은 실무에서 대단히 중요하다.
가명처리: 추가 정보를 결합하면 다시 식별할 수 있는 상태. 여전히 개인정보로 관리해야 한다.
익명처리: 시간·비용·기술을 합리적으로 고려해도 더 이상 개인을 알아볼 수 없는 상태. 개인정보가 아니게 된다.
그렇다면 약한 블러는? 익명처리로 인정받기 어렵다.
앞서 말했듯 복원 가능성이 있기 때문이다.
그래서 "영상에 블러 넣었으니 이제 개인정보 아님"이라는 판단은 위험하다.
익명성 강도를 높이는 실무 원칙
① 블록/블러 강도를 충분히 크게 (얼굴 너비 대비 블록 1/6 이상 권장)
② 마스킹 후 재인코딩해서 원본 픽셀 정보를 물리적으로 제거 (마스크를 별도 트랙으로 얹는 방식은 떼어낼 수 있어 위험)
③ 얼굴 외 식별 요소(명찰, 번호판, 문서, 문신, 특이 의상) 함께 처리
④ 음성 변조 병행 (목소리도 생체정보다)
⑤ 원본 파일의 접근 권한 분리 및 보관 기간 설정
⑥ 메타데이터(GPS, 촬영기기, 타임스탬프) 제거
특히 조심해야 할 세 가지
1. 소프트 서브타이틀처럼 '떼어낼 수 있는' 마스크
자막 트랙이나 오버레이 트랙으로 모자이크를 얹으면, 플레이어 설정으로 끌 수 있다.
반드시 픽셀에 구워 넣어야(hard-burn) 한다.
2. 썸네일과 프리뷰
본편은 잘 가렸는데 썸네일이나 프리뷰 GIF에 원본 얼굴이 남는 경우가 정말 많다.
파생 산출물 전체를 점검 목록에 넣어야 한다.
3. 아동·청소년
법정대리인 동의 요건이 별도로 적용되며, 사회적 민감도도 훨씬 높다.
학교·유치원·놀이터 촬영물은 기본적으로 전원 마스킹을 전제로 접근하는 게 안전하다.
모자이크를 걸어도 문제가 되는 경우
흥미로운 역설도 있다.
모자이크를 씌웠더라도 주변 정황(장소, 시간, 동행자, 옷차림, 나레이션)으로 특정인이 지목되면 명예훼손이나 초상권 침해가 성립할 수 있다.
즉 식별 가능성은 픽셀만의 문제가 아니라 문맥의 문제다.
기술은 픽셀을 처리하지만, 판단은 사람이 해야 한다.
🛠️ 실전 워크플로: 7단계 체크리스트
STEP 1 · 원본 백업과 사본 작업
원본은 절대 덮어쓰지 않는다. 작업은 항상 사본으로.
나중에 마스킹 기준이 바뀌면 원본에서 다시 시작해야 한다.
STEP 2 · 전처리 정규화
가변 프레임레이트 → 고정으로 변환.
회전 메타데이터(스마트폰 세로 촬영)를 실제 픽셀 회전으로 적용.
너무 어두운 영상은 감마·히스토그램 보정으로 검출률 확보.
STEP 3 · 1차 자동 검출 (넉넉한 설정)
신뢰도 임계값을 낮게(0.2~0.3), 박스 패딩을 넉넉히(15~25%).
얼굴 검출 + 사람 검출을 함께 돌려 합집합으로 처리.
STEP 4 · 추적·보간·스무딩
ID를 부여하고 누락 프레임을 보간.
샷 경계에서 트랙을 강제 종료.
좌표 궤적에 5~9프레임 이동평균 적용해 떨림 제거.
STEP 5 · 수동 검수 (여기가 핵심)
저해상도 프리뷰로 전체를 2~4배속 훑는다.
컷 전환 직후, 인물 등퇴장, 군중 장면, 반사면을 집중 확인.
누락 구간은 수동 키프레임으로 박스 추가.
STEP 6 · 최종 렌더링
마스크를 픽셀에 구워 넣기.
CRF 17~20, 오디오 copy, 필요시 음성 변조 적용.
STEP 7 · 파생물 점검
썸네일, 프리뷰, 클립, 쇼츠 버전, 자막 파일까지 전부 확인.
메타데이터 제거 후 배포.
검수 시간을 줄이는 요령
전체를 눈으로 보는 건 비효율적이다. 이렇게 하면 빨라진다.
· 신뢰도 히트맵: 프레임별 최저 신뢰도를 그래프로 그려서, 낮은 구간만 집중 확인
· 트랙 수 변화 탐지: 갑자기 트랙이 생기거나 사라진 지점을 자동 플래그
· 보간 구간 표시: 실제 검출이 아니라 보간으로 채운 프레임은 다른 색으로 마킹
· 모션 기반 우선순위: 움직임이 큰 구간을 먼저 검수
이 정도 자동화만 얹어도 검수 시간이 절반 이하로 떨어진다.
결국 자동 모자이크의 진짜 실력은 "검출 정확도"보다 "검수를 얼마나 쉽게 해주는가"에서 갈린다.
🚀 앞으로의 방향
① 온디바이스 처리의 확산
영상을 클라우드에 올리는 것 자체가 개인정보 이동이다.
그래서 촬영 기기나 로컬 PC에서 바로 처리하는 방향이 강조된다.
모바일 NPU 성능이 올라가면서, 촬영과 동시에 실시간 마스킹이 점점 현실이 되고 있다.
② 의미 기반 마스킹
"모든 얼굴"이 아니라 "동의하지 않은 사람만" 가리는 방향이다.
등록된 출연자의 얼굴 임베딩을 화이트리스트로 두고, 매칭되지 않는 얼굴만 자동 처리한다.
편리하지만 역설이 있다. 이 기능을 쓰려면 얼굴 인식을 해야 한다.
개인정보를 보호하려고 개인정보를 더 정밀하게 처리해야 하는 구조다.
그래서 임베딩 저장 위치, 보관 기간, 삭제 절차 설계가 기술 성능보다 중요해진다.
③ 합성 익명화의 표준화
얼굴 교체 방식이 학술·산업 데이터셋에서 표준이 되어가고 있다.
프라이버시를 지키면서 데이터 효용을 유지하는 유일한 길이기 때문이다.
동시에 생성된 얼굴임을 증명하는 워터마크·출처 표기(콘텐츠 자격 증명) 기술이 함께 발전 중이다.
④ 얼굴을 넘어서
차량 번호판, 문서, 화면 텍스트, 문신, 로고, 심지어 걸음걸이까지.
식별 가능 요소 전체를 자동 탐지하는 통합 익명화 엔진이 목표점이다.
텍스트 검출(OCR) 모델과 객체 검출 모델을 함께 돌려 "민감 정보 후보"를 한 번에 잡아내는 방식이 이미 상용화 단계에 들어섰다.
정리하면
자동 모자이크 기술은 단순한 편집 필터가 아니다.
컴퓨터 비전(검출·추적·세그멘테이션), 영상 코덱 공학(디코딩·재인코딩·색공간),
그리고 법·윤리 판단이 맞물린 복합 파이프라인이다.
영상 변환 작업을 다룬다면, 이 세 축을 함께 이해하는 사람이 결국 가장 좋은 결과물을 만든다.
기술은 도구고, 판단은 사람 몫이라는 사실만 기억하면 충분하다.
❓ 자주 나오는 질문 정리
Q. 모자이크를 걸면 화질이 나빠지나요?
모자이크 영역은 당연히 정보가 사라지지만, 영상 전체 화질은 재인코딩 설정이 결정한다.
CRF 18 정도의 고품질 설정을 쓰면 육안 차이는 거의 없다.
오히려 저비트레이트로 재인코딩하면 가리지 않은 부분까지 손상된다.
Q. 모자이크가 프레임마다 흔들리는데 왜 그런가요?
검출 박스가 프레임마다 미세하게 달라지기 때문이다.
추적 + 좌표 스무딩을 적용하면 해결된다. 5~9프레임 이동평균이 일반적이다.
Q. 자동 처리만 믿어도 되나요?
아니다. 아무리 좋은 모델도 100%가 아니다.
특히 측면 얼굴, 원거리 군중, 반사면, 컷 전환 구간은 취약하다.
배포 전 수동 검수는 필수 단계로 잡아야 한다.
Q. 블러와 픽셀화 중 뭐가 더 안전한가요?
같은 강도라면 큰 차이가 없고, 둘 다 약하면 복원 위험이 있다.
안전성만 따지면 솔리드 채우기 > 강한 픽셀화 > 강한 블러 > 약한 블러 순이다.
민감한 자료는 솔리드나 얼굴 교체를 쓰자.
Q. 처리 속도를 올리려면?
가장 효과가 큰 건 검출 해상도 축소와 프레임 스킵 + 추적 보간이다.
그다음이 GPU 가속, FP16 추론, 배치 처리다.
단, 축소와 스킵을 과하게 하면 작은 얼굴을 놓치니 균형이 필요하다.
Q. 세로 영상(쇼츠)에 같은 마스크를 쓸 수 있나요?
가능하다. 다만 크롭 영역에 맞게 좌표를 변환해야 한다.
마스크 데이터를 정규화 좌표(0~1 비율)로 저장해두면 해상도·비율이 달라져도 재사용이 쉽다.
Q. 오디오도 처리해야 하나요?
목소리도 생체정보로 볼 수 있다. 인터뷰나 제보 영상은 피치·포먼트 변조를 함께 적용하는 것이 일반적이다.
또한 대화 중 언급되는 이름·주소·전화번호는 비프 처리나 삭제가 필요하다.
🎁 마무리
처음엔 그냥 "얼굴 자동으로 가려주는 기능" 같았을 것이다.
그런데 열어보니 안에는 20년치 컴퓨터 비전 연구사, 코덱 공학, 그리고 개인정보 법제가 함께 들어 있었다.
정리하면 딱 세 문장이다.
하나. 검출은 확률이고, 추적은 그 확률의 빈틈을 메우는 보험이다.
둘. 마스킹 강도는 "나중에 복원 가능한가"를 기준으로 정해야 한다.
셋. 자동화는 작업량을 줄여주는 것이지 책임을 줄여주지 않는다.
영상 변환 작업에서 이 원칙만 지켜도, 화질은 지키고 사고는 피할 수 있다.
다음에 브이로그 배경에 지나가는 열두 명의 얼굴을 보면, 이제 뒤에서 돌아가는 톱니바퀴들이 떠오를 것이다. 😊
더 깊은 영상 후처리·변환 노하우나 실무 파이프라인 설계 사례가 궁금하다면,
재능넷의 '지식인의 숲'에 쌓여 있는 시각화 전문지식 콘텐츠들을 함께 살펴보는 것도 좋은 방법이다.

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.