Ver4.0 t검정과 카이제곱 검정, 언제 무엇을 쓸까: 데이터 성격으로 구분하는 통계 검정 선택 가이드
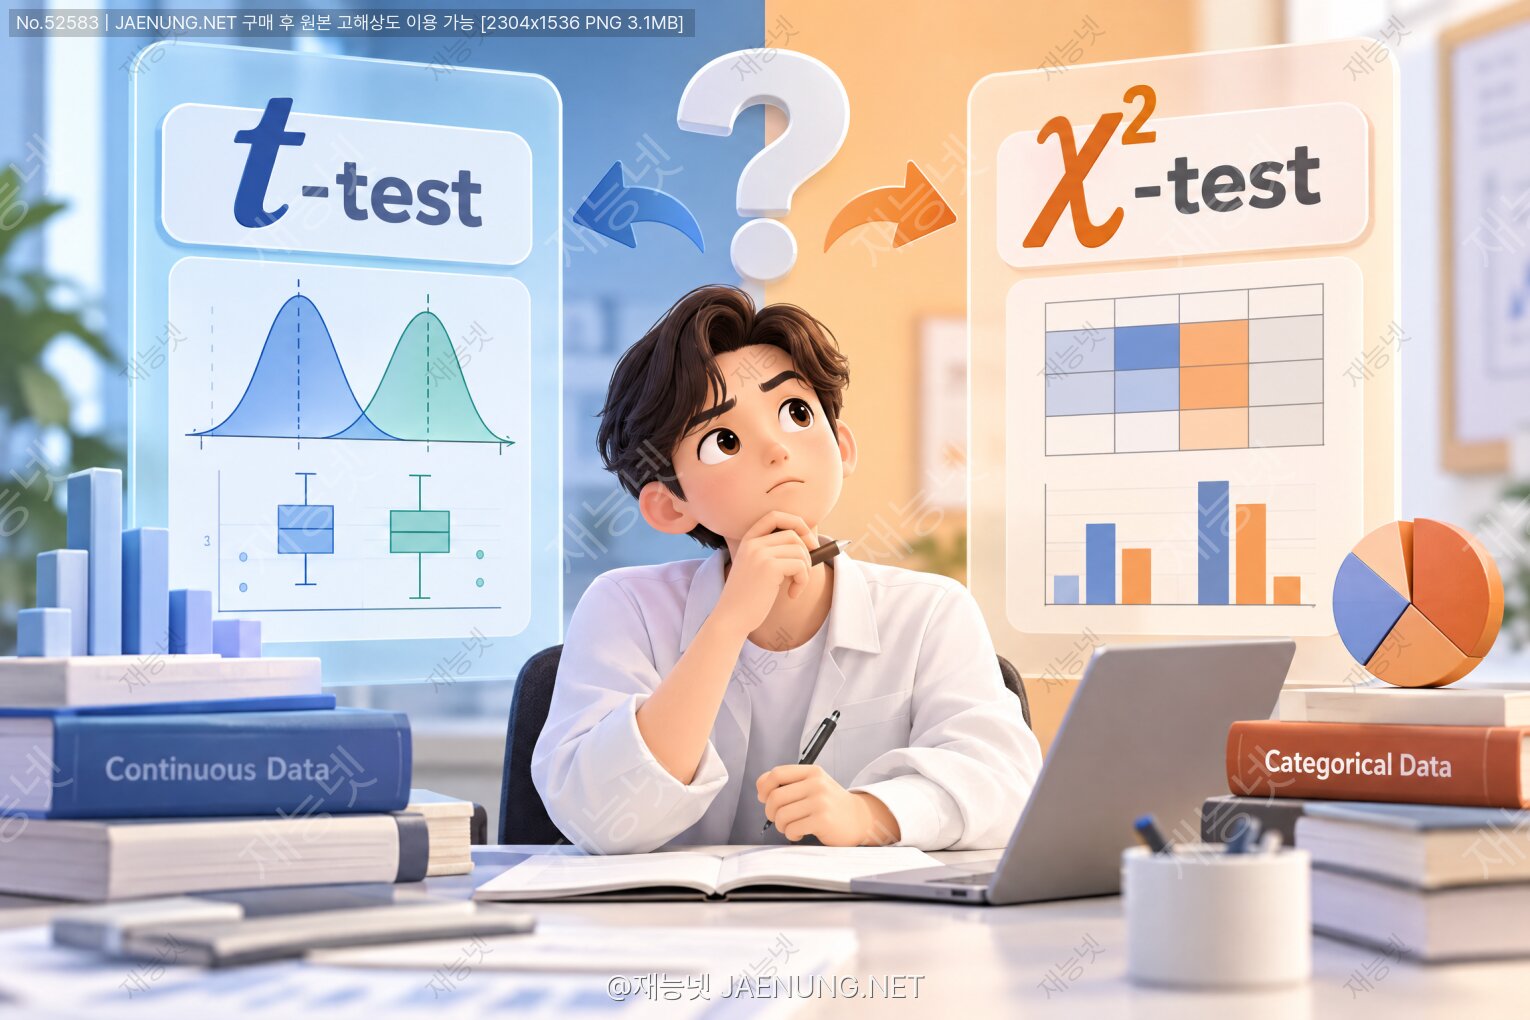
t검정과 카이제곱 검정, 언제 무엇을 쓸까: 데이터 성격으로 구분하는 통계 검정 선택 가이드
평균을 비교할 것인가, 빈도를 비교할 것인가 — 이 한 문장이 모든 것을 가른다
안녕! 혹시 보고서 쓰다가 이런 경험 있어?
"어... 데이터는 다 모았는데, 이걸 t검정으로 돌려야 하나 카이제곱으로 돌려야 하나?"
엑셀 파일 열어놓고 커서만 깜빡깜빡. 나도 그랬어.
그런데 사실 이 둘을 구분하는 건 생각보다 훨씬 단순해.
복잡한 수식 외울 필요도 없고, 통계학 전공자여야 하는 것도 아니야.
딱 하나만 물어보면 돼. "내 데이터가 숫자야, 아니면 칸이야?"
오늘은 이 질문 하나로 시작해서, 두 검정의 구조·전제조건·해석법·실무 함정까지
친구한테 설명하듯 쭉 풀어볼게. 커피 한 잔 들고 와.
1. 30초 요약: 이것만 기억해도 절반은 끝
바쁜 사람을 위한 초압축 버전부터 던질게.
t검정 → 연속형(수치형) 데이터의 평균을 비교할 때
예: A반과 B반의 시험 평균 점수가 다른가?
카이제곱 검정 → 범주형 데이터의 빈도(개수)를 비교할 때
예: 남자와 여자의 구매 여부 비율이 다른가?
즉, 데이터를 봤을 때 "평균을 내면 의미가 있나?"를 물어봐.
시험 점수 평균 78.3점 → 의미 있음 → t검정
성별 평균 1.4 → ...이게 뭐야? → 의미 없음 → 카이제곱
진짜 이게 끝이야. 나머지는 이 원칙을 실무에서 안전하게 쓰기 위한 디테일이고.
그래도 디테일에서 사고가 나니까, 계속 읽어보자.
2. 데이터의 척도부터: 왜 검정이 갈리는가
통계에서 변수는 크게 네 가지 척도로 나뉘어. 학부 첫 주에 배우고 다들 까먹는 그거.
| 척도 | 설명 | 예시 | 평균 가능? |
|---|---|---|---|
| 명목(Nominal) | 이름표일 뿐, 순서 없음 | 혈액형, 지역, 성별 | ❌ |
| 서열(Ordinal) | 순서는 있으나 간격 불명 | 만족도(상중하), 학점 | △ |
| 등간(Interval) | 간격 일정, 절대영점 없음 | 섭씨온도, IQ | ✅ |
| 비율(Ratio) | 간격 일정 + 절대영점 | 매출, 체중, 시간 | ✅ |
명목·서열은 범주형, 등간·비율은 연속형으로 묶어.
왜 이게 중요하냐면, t검정은 '평균과 분산'이라는 개념 위에서 작동하거든.
평균이 성립하지 않는 데이터에 t검정을 돌리면, 계산은 되지만 숫자가 헛소리를 한다.
컴퓨터는 성별을 남자=1, 여자=2로 코딩해놓으면 평균 1.47을 아주 자신 있게 뱉어.
문제는 "우리 회사 평균 성별은 1.47입니다"라는 문장이 인간 세계에서 성립하지 않는다는 거지.
실무 함정 하나. 5점 척도 만족도(서열)를 연속형처럼 취급해도 되나?
엄밀히는 서열척도지만, 실무와 사회과학에서는 리커트 척도 여러 문항을 합산한 경우 연속형에 준하여 t검정을 쓰는 게 관행이야.
다만 단일 문항 5점 척도는 논쟁이 있어서, 보수적으로 가려면 비모수 검정(Mann-Whitney U)을 쓰는 게 안전해.
3. t검정 파헤치기
3-1. t검정이 하는 일
t검정은 한 문장으로 이래.
"두 집단의 평균 차이가, 그냥 운빨로 생길 수 있는 수준인가? 아니면 진짜 차이인가?"
핵심은 차이의 크기를 흩어진 정도(표준오차)로 나눈다는 거야.
t = (평균차이) / (차이의 표준오차)

즉,  t = (X̄₁ - X̄₂) / SE

- 분자: 두 집단 평균이 얼마나 떨어져 있나
- 분모: 데이터가 얼마나 들쭉날쭉한가 (+ 표본이 얼마나 큰가)
그래서 평균 차이가 커도 데이터가 엄청 흩어져 있으면 t값은 작아지고,
평균 차이가 작아도 데이터가 깔끔하게 모여 있으면 t값은 커져.
"차이가 노이즈에 비해 얼마나 큰가" — 이게 t의 본질이야.
3-2. t검정의 세 가지 얼굴
| 종류 | 쓰는 상황 | 예시 |
|---|---|---|
| 일표본 t검정 | 한 집단 평균 vs 기준값 | 우리 매장 객단가가 업계 평균 3만원과 다른가? |
| 독립표본 t검정 | 서로 다른 두 집단 비교 | A매장 vs B매장 일평균 매출 |
| 대응표본 t검정 | 같은 대상의 전·후 비교 | 교육 전 점수 vs 교육 후 점수 |
여기서 제일 많이 틀리는 게 독립 vs 대응 구분이야.
기준은 간단해. "같은 사람(개체)의 데이터가 두 번 등장하는가?"
등장하면 대응표본, 완전히 다른 사람들이면 독립표본.
다이어트 프로그램 전후 체중 → 같은 사람 → 대응표본
1학년과 2학년 키 비교 → 다른 사람 → 독립표본
대응표본인데 독립표본으로 돌리면? 개인차라는 노이즈가 제거되지 않아서
실제로는 효과가 있는데도 "유의하지 않음"이 나오는 참사가 벌어져.
3-3. t검정의 전제조건
① 정규성 — 데이터(또는 표본평균)가 정규분포를 따를 것
→ Shapiro-Wilk 검정으로 확인. 단, 표본이 각 집단 30개 이상이면 중심극한정리 덕에 크게 신경 안 써도 됨.
② 등분산성 — 두 집단의 분산이 비슷할 것
→ Levene 검정으로 확인. 위배되면 Welch's t-test를 쓰면 끝. 요즘은 아예 기본값으로 Welch를 권장하는 흐름이야.
③ 독립성 — 관측치끼리 서로 영향 없을 것
→ 설계 단계에서 지켜야 하는 것. 사후에 고칠 방법이 없음.
3-4. 자유도라는 개념
출력물에 꼭 나오는 df(degree of freedom). 이게 뭐냐면,
"자유롭게 변할 수 있는 값의 개수"야.
독립표본 t검정에서는 대략 n₁ + n₂ - 2.
자유도가 커질수록 t분포는 정규분포에 가까워져. 표본이 많을수록 추정이 정밀해진다는 뜻이지.
4. 카이제곱 검정 파헤치기
4-1. 기본 아이디어
카이제곱(χ²) 검정은 평균을 안 봐. 대신 칸(cell)에 몇 개가 들어있나를 봐.
핵심 논리는 이거야.
"아무 관계가 없다면 이 정도 숫자가 나와야 해(기대빈도).
그런데 실제로는 이렇게 나왔네(관측빈도). 이 차이가 우연으로 설명될까?"
χ² = Σ (관측빈도 - 기대빈도)² / 기대빈도

기대빈도 = (해당 행 합계 × 해당 열 합계) / 전체 합계
차이를 제곱하는 이유는 플러스 마이너스가 상쇄되는 걸 막기 위해서,
기대빈도로 나누는 이유는 규모를 보정하기 위해서야.
기대 10개인데 5개 차이 나는 것과, 기대 1000개인데 5개 차이 나는 건 무게가 다르잖아.
4-2. 실제 계산 한 번 해보기
가상의 데이터. 광고 A/B 테스트라고 치자.
| 구매함 | 구매안함 | 행 합계 | |
|---|---|---|---|
| 광고 A | 60 | 140 | 200 |
| 광고 B | 40 | 160 | 200 |
| 열 합계 | 100 | 300 | 400 |
기대빈도 계산
A-구매함  : 200 × 100 / 400 = 50
A-구매안함: 200 × 300 / 400 = 150
B-구매함  : 200 × 100 / 400 = 50
B-구매안함: 200 × 300 / 400 = 150

χ² = (60-50)²/50 + (140-150)²/150
   + (40-50)²/50 + (160-150)²/150
   = 100/50 + 100/150 + 100/50 + 100/150
   = 2 + 0.667 + 2 + 0.667
   = 5.333

자유도 df = (2-1) × (2-1) = 1
임계값(α=0.05, df=1) = 3.841

5.333 > 3.841  →  귀무가설 기각
→ 광고 종류와 구매 여부는 독립이 아니다 (관련이 있다)
봤지? 곱셈 나눗셈만 할 줄 알면 손으로도 돼.
전환율로 보면 A가 30%, B가 20%. 눈으로 봐도 차이가 있어 보이는데,
그 차이가 통계적으로도 인정되는지를 확인해주는 게 카이제곱의 역할이야.
4-3. 카이제곱의 세 가지 용도
| 종류 | 질문 | 예시 |
|---|---|---|
| 적합도 검정 | 관측 분포가 이론 분포와 맞나? | 주사위가 공정한가? 요일별 방문자가 균등한가? |
| 독립성 검정 | 두 범주형 변수가 관련 있나? | 성별과 선호 브랜드가 관련 있나? |
| 동질성 검정 | 여러 집단의 분포가 같은가? | 지역별 만족도 분포가 동일한가? |
독립성과 동질성은 계산이 거의 똑같아. 차이는 표본을 어떻게 뽑았느냐에 있어.
전체에서 한 번에 뽑아 두 변수를 동시에 측정했으면 독립성,
집단별로 인원을 미리 정해놓고 뽑았으면 동질성. 실무에선 해석만 구분하면 충분해.
4-4. 카이제곱의 전제조건 (여기가 진짜 중요)
① 기대빈도 5 이상
전체 칸의 80% 이상이 기대빈도 5 이상이어야 하고, 모든 칸이 1 이상이어야 해.
위배되면 → Fisher의 정확검정(Fisher's exact test)으로 갈아타.
② 관측치는 빈도(개수)여야 함
비율(%)이나 평균을 그대로 넣으면 안 돼. 반드시 실제 사람 수, 건수를 넣어야 해.
③ 각 관측치는 한 칸에만 속함
한 사람이 여러 칸에 중복 집계되면 검정 자체가 무효야. 다중응답 문항 주의!
다중응답 함정
"좋아하는 과일을 모두 고르세요"처럼 한 사람이 3개를 고른 설문.
이걸 그냥 교차표로 만들면 응답 수 > 응답자 수가 되어 독립성 가정이 깨져.
이럴 땐 다중응답 전용 분석이나, 항목별 이분형(선택/미선택) 개별 검정으로 접근해야 해.
5. 나란히 놓고 비교하기
| 구분 | t 검정 | 카이제곱 검정 |
|---|---|---|
| 종속변수 | 연속형 | 범주형 |
| 비교 대상 | 평균 | 빈도/비율 |
| 모수/비모수 | 모수 검정 | 비모수 검정 |
| 정규성 가정 | 필요 | 불필요 |
| 핵심 전제 | 등분산성, 독립성 | 기대빈도 5 이상 |
| 분포 모양 | 좌우대칭 종형 | 오른쪽 꼬리 비대칭 |
| 검정 방향 | 양측/단측 가능 | 사실상 단측(우측) |
| 효과크기 지표 | Cohen's d | Cramér's V, φ(파이) |
| 대안 검정 | Mann-Whitney U, Welch | Fisher 정확검정 |
재미있는 포인트 하나. 카이제곱은 음수가 안 나와.
차이를 제곱해서 더하니까 항상 0 이상이지. 그래서 분포가 오른쪽으로 긴 꼬리를 가지고,
"값이 클수록 차이가 크다"는 단순한 해석이 성립해.
반면 t값은 음수도 나와. 어느 집단이 더 큰지를 부호가 알려주니까.
그래서 t는 방향성이 있고, 카이제곱은 "관련 있다/없다"만 말해줘.
카이제곱은 관계의 방향이나 강도를 직접 알려주지 않는다는 점, 꼭 기억해.
6. 상황별 선택 시나리오 10선
이제 실전. 실제로 자주 마주치는 상황들을 던져볼게.
① 남녀 직원의 연봉 차이
연봉 = 연속형 → 독립표본 t검정
② 남녀 직원의 승진 여부 차이
승진여부 = 범주형 → 카이제곱 독립성 검정
③ 교육 전후 업무 처리 시간
같은 사람, 연속형 → 대응표본 t검정
④ 요일별 방문자 수가 균등한가
빈도 분포 검증 → 카이제곱 적합도 검정
⑤ 신약 투여군과 위약군의 혈압
혈압 = 연속형, 다른 사람 → 독립표본 t검정
⑥ 신약 투여군과 위약군의 완치 여부
완치여부 = 범주형 → 카이제곱 (표본 작으면 Fisher)
⑦ 세 개 이상 매장의 평균 매출 비교
t검정 아님! → 일원배치 분산분석(ANOVA)
⑧ 지역(4개) × 선호브랜드(3개) 관계
범주 여러 개여도 OK → 카이제곱 (4×3 교차표)
⑨ 표본 15명, 심하게 치우친 만족도 점수
정규성 위배 → Mann-Whitney U 검정
⑩ 광고 클릭률 A/B 테스트
클릭/미클릭 빈도 → 카이제곱 또는 두 비율 z검정
⑦번을 특히 조심해. 세 집단을 t검정으로 세 번 나눠서 돌리는 사람이 진짜 많거든.
A-B, B-C, A-C 이렇게 세 번 돌리면 1종 오류가 누적돼.
각각 5%씩 틀릴 확률이 쌓여서 전체 오류율이 약 14%까지 치솟아.
그래서 세 집단 이상은 ANOVA를 먼저 돌리고, 사후검정(Tukey, Bonferroni)으로 가야 해.
7. p값, 제발 이렇게 읽지 말자
두 검정 모두 결과는 p값으로 나와. 근데 이 p값이 세상에서 가장 자주 오해받는 숫자야.
❌ 오해 1 — "p=0.03이니까 대립가설이 맞을 확률 97%다"
→ 아니야. p값은 귀무가설이 참이라고 가정했을 때, 지금과 같거나 더 극단적인 결과가 나올 확률이야. 가설이 맞을 확률이 아니야.
❌ 오해 2 — "p>0.05니까 차이가 없다"
→ 아니야. "차이를 입증하지 못했다"일 뿐. 표본이 작아서 못 잡았을 수도 있어.
❌ 오해 3 — "p=0.001이니까 차이가 엄청 크다"
→ 아니야. p값은 차이의 크기가 아니라 확실성을 말해. 표본이 10만 개면 아주 미미한 차이도 p<0.001이 나와.
그래서 요즘은 p값만 쓰는 걸 지양하고 효과크기를 같이 보고해.
[t검정의 효과크기 — Cohen's d]
d = (평균차이) / (통합표준편차)

0.2 : 작음
0.5 : 중간
0.8 : 큼

[카이제곱의 효과크기 — Cramér's V]
V = √( χ² / (n × (min(행,열) - 1)) )

0.1 : 작음
0.3 : 중간
0.5 : 큼
"통계적으로 유의하다"와 "실무적으로 의미 있다"는 완전히 다른 말이야.
10만 명 대상 실험에서 전환율이 2.00% → 2.03%로 올랐고 p=0.01이 나왔다고 치자.
통계적으론 유의해. 근데 그걸 위해 개발 리소스 3개월 쓸 가치가 있을까? 그건 다른 질문이지.
이런 부분을 잘 짚어주는 리포트가 결국 좋은 리포트야.
재능넷의 '지식인의 숲'에서도 데이터 분석 관련 콘텐츠를 보면,
숫자 그 자체보다 숫자를 어떻게 해석하고 의사결정으로 연결하느냐를 강조하는 이유가 여기 있어.
8. 보고서에 쓰는 법 (양식 그대로 가져다 써)
문서작성 카테고리 글이니까 이 부분 빼먹으면 안 되지.
분석은 잘 해놓고 보고서에 어떻게 써야 할지 몰라서 헤매는 경우가 많거든.
8-1. t검정 결과 기술 양식
[독립표본 t검정]

A집단(n=45, M=78.32, SD=8.41)과
B집단(n=42, M=72.15, SD=9.03)의 시험 점수를 비교하기 위해
독립표본 t검정을 실시하였다.

Levene의 등분산 검정 결과 등분산 가정이 충족되었다
(F=1.23, p=.271).

분석 결과 두 집단 간 점수 차이는
통계적으로 유의하였다
(t(85)=3.30, p=.001, Cohen's d=0.71).

즉, A집단의 점수가 B집단보다 유의하게 높았으며,
효과크기는 중간 이상 수준이었다.
필수 포함 요소: 표본 수(n), 평균(M), 표준편차(SD), t값, 자유도, p값, 효과크기
8-2. 카이제곱 결과 기술 양식
[카이제곱 독립성 검정]

광고 유형과 구매 여부 간의 관련성을 확인하기 위해
카이제곱 독립성 검정을 실시하였다.

모든 셀의 기대빈도가 5 이상으로
카이제곱 검정의 가정을 충족하였다.

분석 결과 두 변수 간에는
통계적으로 유의한 관련성이 있었다
(χ²(1, N=400)=5.33, p=.021, Cramér's V=.12).

광고 A의 구매율은 30.0%로
광고 B의 20.0%보다 높게 나타났다.
필수 포함 요소: χ²값, 자유도, 전체 표본 수(N), p값, 효과크기, 실제 비율
표기 팁
· p값은 소수점 셋째 자리까지, .001 미만이면 p<.001로 표기
· 소수점 앞 0은 생략하는 게 APA 관행 (0.001 → .001)
· 통계 기호(t, p, F, M, SD)는 이탤릭, χ²는 정자체
· 표와 본문 서술을 중복시키지 말 것. 표에 있으면 본문은 요약만
9. 실무자들이 실제로 저지르는 실수 7가지
① 비율(%)을 카이제곱에 넣기
30%, 20% 이렇게 넣으면 표본 수 정보가 사라져. 반드시 실제 빈도를 넣을 것.
② 대응표본을 독립표본으로 돌리기
전후 비교인데 독립으로 돌려서 효과를 놓치는 경우. 데이터 구조부터 확인하자.
③ 세 집단을 t검정 여러 번
1종 오류 누적. ANOVA 쓰자.
④ 기대빈도 확인 안 하기
소규모 설문에서 특히 위험. SPSS/R은 경고를 띄워주니 경고문을 읽자.
⑤ 유의하지 않으면 다른 검정 찾아 헤매기
이걸 p-hacking이라고 해. 검정 방법은 분석 전에 결정해야 해.
⑥ 인과관계로 해석하기
카이제곱이 유의하다고 "광고 A가 구매를 유발했다"고 쓰면 안 돼. 관련이 있다까지만.
⑦ 이상치 방치
t검정은 평균 기반이라 이상치에 취약해. 박스플롯으로 먼저 눈으로 보자.
10. 검정 선택 최종 체크리스트
STEP 1. 종속변수(결과)가 숫자인가, 범주인가?
        숫자 → STEP 2
        범주 → STEP 4

STEP 2. 비교할 집단이 몇 개인가?
        1개(기준값과 비교) → 일표본 t검정
        2개 → STEP 3
        3개 이상 → ANOVA

STEP 3. 두 집단이 같은 대상인가?
        같은 대상(전후) → 대응표본 t검정
        다른 대상 → 독립표본 t검정
        └ 정규성 위배 + 소표본 → Mann-Whitney U
        └ 등분산 위배 → Welch's t-test

STEP 4. 범주형 변수가 몇 개인가?
        1개(이론분포와 비교) → 카이제곱 적합도 검정
        2개 → 카이제곱 독립성 검정
        └ 기대빈도 5 미만 셀 존재 → Fisher 정확검정
        └ 대응 구조(전후 찬반) → McNemar 검정
이 흐름도만 책상 옆에 붙여놔도 웬만한 상황은 다 커버돼.
11. 마무리: 도구보다 질문이 먼저다
여기까지 오느라 고생했어. 마지막으로 진짜 하고 싶은 말을 할게.
통계 검정을 고르는 일은 드라이버를 고르는 일과 같아.
십자 나사에 일자 드라이버 들이대면 나사만 망가지지.
근데 더 중요한 건, "내가 지금 어떤 나사를 조이려는 건지"를 아는 거야.
"평균이 다른지 궁금한가, 비율이 다른지 궁금한가?"
이 질문에 답할 수 있으면 검정은 자동으로 결정돼.
반대로 이 질문에 답을 못 하면, 아무리 좋은 통계 패키지를 써도
숫자만 쏟아지고 인사이트는 없는 보고서가 나와.
분석은 도구가 아니라 질문에서 시작한다 — 이게 오늘의 진짜 결론이야.
오늘의 핵심 3줄 정리
1. 평균을 비교하면 t검정, 빈도를 비교하면 카이제곱 검정.
2. t검정은 정규성·등분산을, 카이제곱은 기대빈도 5 이상을 확인할 것.
3. p값만 보지 말고 효과크기와 실무적 의미를 함께 보고할 것.
다음에 데이터 파일 열었을 때, 커서만 깜빡이지 말고
"이거 평균이야, 빈도야?"부터 물어보자. 그 순간부터 분석은 훨씬 쉬워질 거야.

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.




아직 댓글이 없습니다.