Ver4.0 🛡️ Python으로 AI 콘텐츠 필터링 시스템 만들기 — 욕설·스팸·유해 이미지까지 걸러내는 실전 파이프라인 🐍
🛡️ Python으로 AI 콘텐츠 필터링 시스템 만들기 — 욕설·스팸·유해 이미지까지 걸러내는 실전 파이프라인 🐍
키워드 금지어 목록 하나로 버티던 시대는 끝났어.
이제는 임베딩, 트랜스포머, 그리고 약간의 정규식 센스가 필요해.
🍜 들어가며: "ㅅ.ㅂ" 은 왜 안 걸러질까?
친구야, 혹시 커뮤니티 운영해본 적 있어? 없다고? 그럼 상상만 해봐.
새벽 3시에 알림이 울려. 누군가 게시판에 도배를 시작했거든.
너는 부랴부랴 노트북을 열고 금지어 목록에 단어 하나를 추가해.
그리고 10분 뒤, 그 사람은 ㅅ ㅂ, ㅅ.ㅂ, 시1발, ㅆㅣ발 이런 식으로 우회해서 다시 올려.
이게 바로 규칙 기반 필터링의 한계야.
사람은 창의적이거든. 특히 욕할 때는 더더욱.
반대로 이런 경우도 있어.
"이 김치찌개 진짜 미친 맛집이다"라는 문장이 금지어 미친 때문에 차단돼.
사장님은 억울하고, 유저는 떠나고, 너는 CS 지옥에 빠지지.
핵심 딜레마 두 가지
① False Negative(놓침) — 나쁜 걸 못 걸러냄 → 커뮤니티 망함
② False Positive(오탐) — 멀쩡한 걸 차단함 → 유저 떠남
AI 콘텐츠 필터링은 이 둘 사이에서 최적의 지점을 찾는 기술이야.
100% 정확한 필터는 세상에 없어. 진짜로. OpenAI도, Google도 못 만들었어.
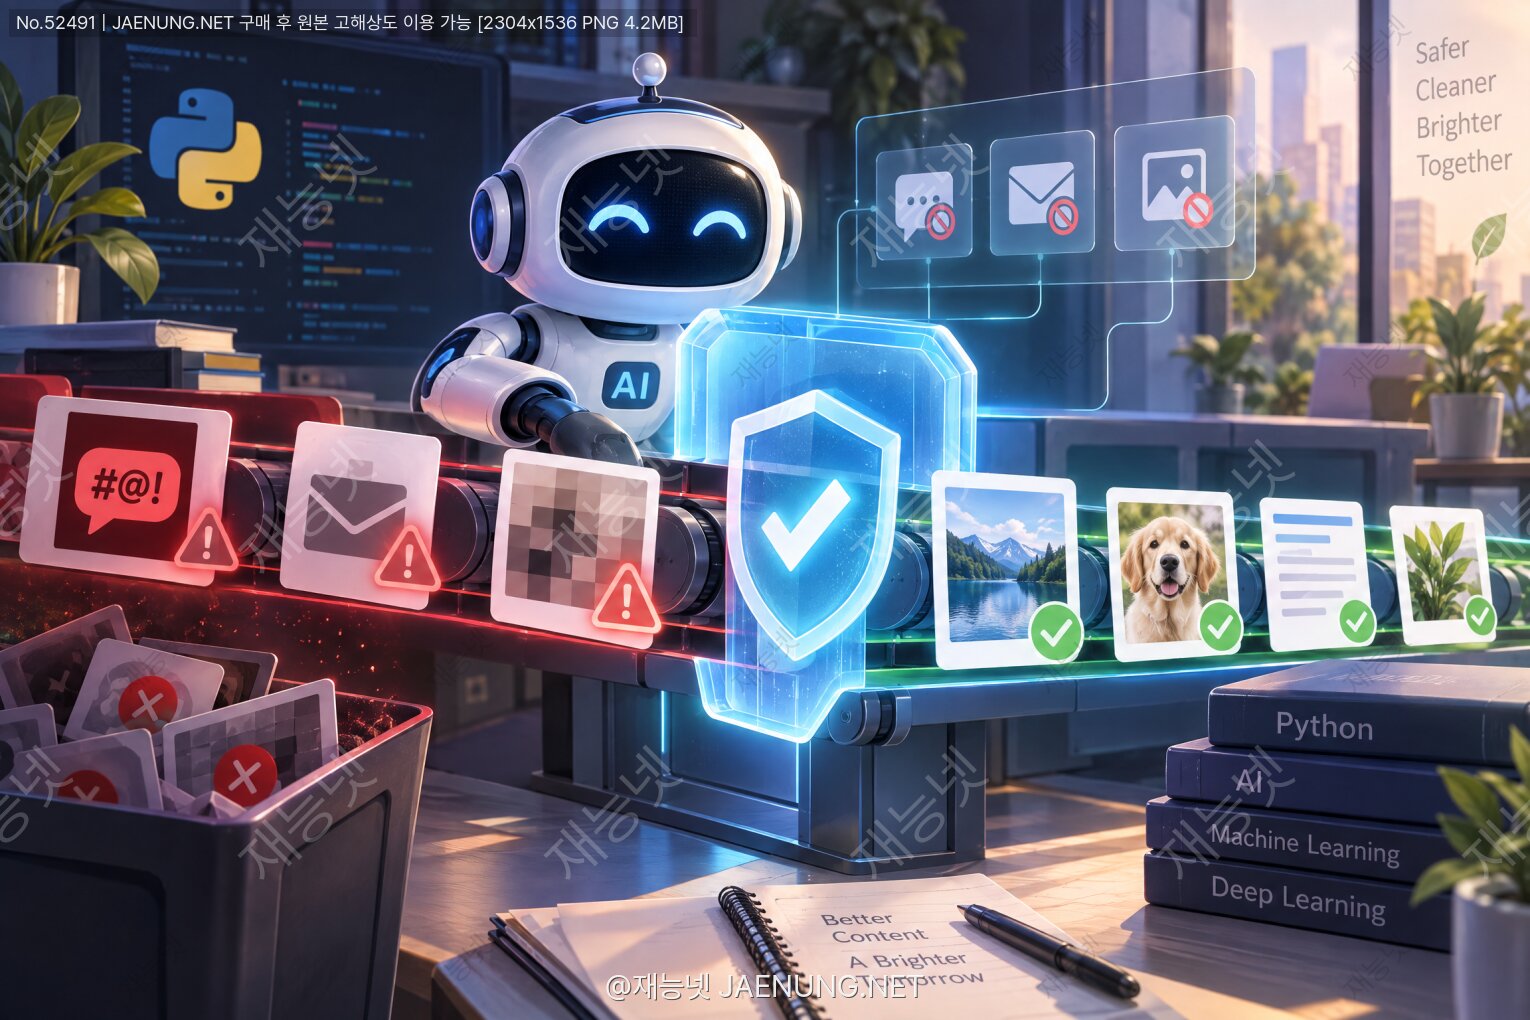
오늘 우리가 만들 건 이거야. 👇
자, 이제 하나씩 부숴보자. 코드는 전부 실제로 돌아가는 파이썬이야.
🧼 STEP 1. 정규화 — 우회 공격을 무력화하는 첫 방어선
필터링의 8할은 전처리야. 진짜야.
모델 아무리 좋아도 입력이 엉망이면 소용없어.
1-1. 유니코드 정규화 (NFKC)
사람들은 이런 식으로 우회해:
fuck ← 전각 문자
𝒇𝒖𝒄𝒌 ← 수학 기울임 유니코드
ⓕⓤⓒⓚ ← 원문자
fuck ← 사이사이 제로폭 공백(U+200B)파이썬 표준 라이브러리 unicodedata 하나면 대부분 정리돼.
import unicodedata
import re

# 제로폭 문자 / 방향 제어 문자 제거용
INVISIBLE = re.compile(
    r'[\u200b-\u200f\u202a-\u202e\u2060-\u206f\ufeff\u00ad]'
)

def normalize_text(text: str) -> str:
    # 1) 보이지 않는 문자 제거
    text = INVISIBLE.sub('', text)
    # 2) 유니코드 호환 정규화 (전각 → 반각, 원문자 → 일반문자)
    text = unicodedata.normalize('NFKC', text)
    # 3) 소문자화
    text = text.lower()
    # 4) 반복 문자 축약: "미ㅣㅣㅣ친" 같은 노이즈 대응
    text = re.sub(r'(.)\1{2,}', r'\1\1', text)
    # 5) 공백 정리
    text = re.sub(r'\s+', ' ', text).strip()
    return text

print(normalize_text("f u c k"))   # -> "f u c k"
print(normalize_text("ⓗⓔⓛⓛⓞ"))        # -> "hello"
💡 NFKC가 뭐야?
NFKC = Normalization Form Kompatibility Composition.
"모양이 비슷하거나 호환되는 문자를 표준형 하나로 합친다"는 뜻이야.
전각 a와 반각 a를 같은 걸로 취급해주지.
단, NFKC는 한글 자모 분리까지는 못 잡아. 그건 다음 단계에서.
1-2. 한글 자모 분해 — 한국어 필터링의 숨은 보스
영어권 라이브러리를 그대로 쓰면 한국어에서 처참하게 깨져.
왜냐면 한글은 초성·중성·종성으로 쪼개지거든.
시발 → ㅅㅣㅂㅏㄹ → ㅅ1발 → ㅆㅣ이발 ...
경우의 수가 폭발해.
그래서 자모 단위로 분해해서 비교하는 게 정석이야.
CHO = list("ㄱㄲㄴㄷㄸㄹㅁㅂㅃㅅㅆㅇㅈㅉㅊㅋㅌㅍㅎ")
JUNG = list("ㅏㅐㅑㅒㅓㅔㅕㅖㅗㅘㅙㅚㅛㅜㅝㅞㅟㅠㅡㅢㅣ")
JONG = list(" ㄱㄲㄳㄴㄵㄶㄷㄹㄺㄻㄼㄽㄾㄿㅀㅁㅂㅄㅅㅆㅇㅈㅊㅋㅌㅍㅎ")

def decompose_hangul(text: str) -> str:
    """한글을 자모 문자열로 분해. '시발' -> 'ㅅㅣㅂㅏㄹ'"""
    out = []
    for ch in text:
        code = ord(ch)
        if 0xAC00 <= code <= 0xD7A3:       # 완성형 한글 영역
            idx = code - 0xAC00
            cho = idx // (21 * 28)
            jung = (idx % (21 * 28)) // 28
            jong = idx % 28
            out.append(CHO[cho])
            out.append(JUNG[jung])
            if jong:
                out.append(JONG[jong])
        else:
            out.append(ch)
    return ''.join(out)

print(decompose_hangul("시발"))   # ㅅㅣㅂㅏㄹ
print(decompose_hangul("씨1발")) # ㅆㅣ1ㅂㅏㄹ
이렇게 분해한 뒤, 숫자·특수문자·공백을 모두 제거하고 비교하면
ㅅ.ㅂ, ㅅ ㅂ, 시1발이 전부 같은 패턴으로 잡혀.
1-3. 시각 유사 문자(Homoglyph) 치환
0과 O, 1과 l과 I, 키릴 문자 а와 라틴 a.
겉보기엔 똑같은데 코드포인트는 완전히 달라.
HOMOGLYPH = {
    '0': 'o', '1': 'i', '3': 'e', '4': 'a', '5': 's',
    '7': 't', '@': 'a', '$': 's', '!': 'i',
    'а': 'a', 'е': 'e', 'о': 'o', 'с': 'c', 'р': 'p',  # 키릴
}

def fold_homoglyph(text: str) -> str:
    return ''.join(HOMOGLYPH.get(c, c) for c in text)

print(fold_homoglyph("h3ll0 w0rld"))  # hello world
⚠️ 주의: 과하면 오탐이 터진다
4를 a로 바꾸면 "4번 게시글"이 "a번 게시글"이 돼.
그래서 실무에서는 원문과 정규화본을 둘 다 유지하고,
정규화본은 금지어 매칭 전용으로만 쓰는 게 안전해.
⚡ STEP 2. 규칙 기반 필터 — 빠르고 싸고 확실한 놈
"AI 시대에 무슨 정규식이야?" 라고 생각했다면 잠깐.
현실 서비스에서는 트래픽의 대부분이 규칙 단계에서 끝나.
GPU 추론은 비싸고 느려. 확실한 건 먼저 쳐내는 게 맞아.
2-1. Aho-Corasick: 금지어 10만 개도 한 방에
금지어가 1만 개인데 for word in banned: 이렇게 돌리면?
O(N × M)이라 문자열 길어지면 죽어.
Aho-Corasick 알고리즘은 여러 패턴을 트라이(trie)로 묶어서
텍스트를 딱 한 번만 훑으면서 전부 찾아내. O(N + 매칭수)야.
# pip install pyahocorasick
import ahocorasick

class BannedWordMatcher:
    def __init__(self, words):
        self.A = ahocorasick.Automaton()
        for idx, w in enumerate(words):
            self.A.add_word(w, (idx, w))
        self.A.make_automaton()

    def find(self, text: str):
        hits = []
        for end_idx, (idx, word) in self.A.iter(text):
            start = end_idx - len(word) + 1
            hits.append({'word': word, 'start': start, 'end': end_idx})
        return hits

matcher = BannedWordMatcher(['도박', '불법', '대출', '카지노'])
print(matcher.find("여기 불법 도박 사이트 추천"))
# [{'word': '불법', ...}, {'word': '도박', ...}]
📊 성능 비교 (금지어 10,000개 / 텍스트 1,000자 기준, 참고치)
| 방식 | 시간 복잡도 | 체감 속도 |
|---|---|---|
단순 반복 in | O(N×M) | 느림 (수십 ms) |
정규식 | 결합 | 백트래킹 위험 | 불안정 |
| Aho-Corasick | O(N + 매칭수) | 매우 빠름 (0.1ms 수준) |
2-2. 화이트리스트 — 오탐 방지 장치
이게 진짜 중요해. 규칙 필터의 생명은 예외 처리야.
WHITELIST_CONTEXT = [
    "대출 규제", "도박 중독 상담", "불법 신고",
    "미친 맛집", "미친 퀄리티",
]

def is_whitelisted(text: str, hit_word: str, window: int = 12) -> bool:
    """매칭된 단어 주변 문맥이 화이트리스트에 걸리는지 확인"""
    for safe in WHITELIST_CONTEXT:
        if safe in text:
            return True
    return False
실무에서는 이 화이트리스트가 계속 늘어나.
CS팀에서 "이거 왜 막혔어요?" 문의가 올 때마다 하나씩 쌓이거든. 😅
2-3. 스팸 시그널: 텍스트 말고 '행동'을 봐라
내용만 보면 멀쩡한데 스팸인 경우가 많아.
그럴 땐 메타 특징(meta feature)이 답이야.
import re
from urllib.parse import urlparse

URL_RE = re.compile(r'https?://\S+|www\.\S+')
PHONE_RE = re.compile(r'01[016789][-.\s]?\d{3,4}[-.\s]?\d{4}')

def extract_spam_signals(text: str) -> dict:
    urls = URL_RE.findall(text)
    length = max(len(text), 1)

    # 대문자 비율 (영문 도배 탐지)
    alpha = [c for c in text if c.isalpha() and c.isascii()]
    upper_ratio = sum(c.isupper() for c in alpha) / max(len(alpha), 1)

    # 특수문자 비율
    special_ratio = sum(not c.isalnum() and not c.isspace()
                        for c in text) / length

    # 동일 문자 최대 반복
    max_repeat = max((len(m.group())
                      for m in re.finditer(r'(.)\1*', text)), default=0)

    return {
        'url_count': len(urls),
        'has_phone': bool(PHONE_RE.search(text)),
        'upper_ratio': round(upper_ratio, 3),
        'special_ratio': round(special_ratio, 3),
        'max_repeat': max_repeat,
        'length': length,
    }

print(extract_spam_signals("긴급!!! 010-1234-5678 로 연락 http://spam.kr"))
이 특징들을 그대로 LightGBM이나 XGBoost에 넣으면
딥러닝 없이도 스팸 탐지 정확도가 꽤 잘 나와. 진짜로.
🧠 STEP 3. ML 분류기 — 문맥을 이해하는 필터
드디어 메인 요리다. 여기서부터는 "단어"가 아니라 "의미"를 본다.
3-1. 워밍업: TF-IDF + 로지스틱 회귀
딥러닝 가기 전에 꼭 이걸 먼저 해봐.
왜냐고? 베이스라인이 없으면 개선했는지 알 수가 없거든.
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split

texts  = [...]   # 문장 리스트
labels = [...]   # 0=정상, 1=유해

X_tr, X_te, y_tr, y_te = train_test_split(
    texts, labels, test_size=0.2, stratify=labels, random_state=42
)

pipe = Pipeline([
    # 한국어는 형태소 분석이 까다로우니 문자 n-gram이 의외로 강력하다
    ('tfidf', TfidfVectorizer(
        analyzer='char_wb',
        ngram_range=(2, 4),
        min_df=2,
        sublinear_tf=True,
        max_features=200_000,
    )),
    ('clf', LogisticRegression(
        C=4.0, max_iter=2000, class_weight='balanced'
    )),
])

pipe.fit(X_tr, y_tr)
pred = pipe.predict(X_te)
print(classification_report(y_te, pred, digits=4))
💡 왜 char_wb n-gram이야?
한국어는 교착어라 어미 변화가 심해. "먹었다 / 먹는다 / 먹어라"...
단어 단위로 자르면 전부 다른 토큰이 되는데,
문자 2~4글자 단위로 자르면 "먹" 이라는 공통 패턴이 살아남아.
게다가 오타와 우회 표기에도 훨씬 강해. 가성비 최고.
3-2. 본격: 한국어 트랜스포머 파인튜닝
이제 진짜다. 사전학습 언어모델을 데려와서 우리 데이터로 길들인다.
한국어라면 이 중 하나를 고르면 돼:
| 모델 | 특징 | 추천 상황 |
|---|---|---|
klue/roberta-base | KLUE 벤치마크 기준 한국어 범용 성능 우수 | 일반적인 분류 작업 |
beomi/KcELECTRA-base | 댓글·구어체 데이터로 학습, 신조어에 강함 | 댓글/커뮤니티 필터링 |
monologg/koelectra-base-v3 | ELECTRA 구조, 경량 대비 성능 양호 | 추론 속도 중요할 때 |
xlm-roberta-base | 100개 언어 지원 | 다국어 서비스 |
댓글 필터링이면 KcELECTRA가 체감상 제일 잘 맞아.
학습 데이터 자체가 인터넷 댓글이라 "ㅇㅈ", "ㄹㅇ", "개꿀" 같은 말을 이미 알거든.
import torch
from torch.utils.data import Dataset
from transformers import (
    AutoTokenizer, AutoModelForSequenceClassification,
    TrainingArguments, Trainer
)
import numpy as np
from sklearn.metrics import f1_score, precision_recall_fscore_support

MODEL_NAME = "beomi/KcELECTRA-base"
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

class ToxicDataset(Dataset):
    def __init__(self, texts, labels, max_len=128):
        self.enc = tokenizer(
            texts, truncation=True, padding='max_length',
            max_length=max_len
        )
        self.labels = labels

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, i):
        item = {k: torch.tensor(v[i]) for k, v in self.enc.items()}
        item['labels'] = torch.tensor(self.labels[i])
        return item

model = AutoModelForSequenceClassification.from_pretrained(
    MODEL_NAME, num_labels=2
)

def compute_metrics(p):
    preds = np.argmax(p.predictions, axis=1)
    pr, rc, f1, _ = precision_recall_fscore_support(
        p.label_ids, preds, average='binary', zero_division=0
    )
    return {'precision': pr, 'recall': rc, 'f1': f1}

args = TrainingArguments(
    output_dir='./toxic-filter',
    num_train_epochs=3,
    per_device_train_batch_size=32,
    per_device_eval_batch_size=64,
    learning_rate=2e-5,
    warmup_ratio=0.1,
    weight_decay=0.01,
    eval_strategy='epoch',
    save_strategy='epoch',
    load_best_model_at_end=True,
    metric_for_best_model='f1',
    fp16=torch.cuda.is_available(),
    logging_steps=50,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=ToxicDataset(X_tr, y_tr),
    eval_dataset=ToxicDataset(X_te, y_te),
    compute_metrics=compute_metrics,
)

trainer.train()
trainer.save_model('./toxic-filter/best')
tokenizer.save_pretrained('./toxic-filter/best')
🔧 하이퍼파라미터 감 잡기
learning_rate: 2e-5 ~ 5e-5 사이. 이보다 크면 사전학습 지식이 날아가.
epochs: 2~4. 그 이상은 거의 항상 과적합.
max_length: 댓글이면 128, 게시글 본문이면 256~512.
fp16: GPU 있으면 무조건 켜. 메모리 절반, 속도 1.5~2배.
3-3. 이진 분류를 넘어서: 멀티라벨 카테고리 분류
"유해함 / 안 유해함"만으로는 부족해.
욕설이랑 성적 콘텐츠랑 자해 조장은 대응 방식이 완전히 달라야 하잖아.
그래서 실무 필터는 대부분 멀티라벨로 간다.
CATEGORIES = [
    'harassment',      # 괴롭힘/모욕
    'hate',            # 혐오 표현
    'sexual',          # 성적 콘텐츠
    'violence',        # 폭력
    'self_harm',       # 자해/자살
    'spam',            # 스팸/광고
    'personal_info',   # 개인정보 노출
]

model = AutoModelForSequenceClassification.from_pretrained(
    MODEL_NAME,
    num_labels=len(CATEGORIES),
    problem_type="multi_label_classification",  # ← 핵심!
)
# 라벨은 [1,0,0,0,0,1,0] 같은 멀티핫 float 벡터로 제공
# 내부적으로 BCEWithLogitsLoss 사용 → 시그모이드 독립 판정
포인트: problem_type="multi_label_classification" 한 줄이면
손실 함수가 Softmax CrossEntropy에서 BCEWithLogits로 바뀌어.
즉, 각 카테고리를 독립적으로 판단하게 되는 거지.
🎚️ STEP 4. 정책 엔진 — 임계값이 서비스의 성격을 결정한다
모델이 0.63이라는 점수를 뱉었어. 그래서 차단할 거야, 말 거야?
이 질문에 답하는 게 정책 엔진이야.
그리고 여기가 엔지니어링이 아니라 '서비스 철학'의 영역이지.
4-1. 정책 엔진 구현
from dataclasses import dataclass, field
from enum import Enum

class Action(Enum):
    ALLOW  = "allow"
    REVIEW = "review"
    BLOCK  = "block"

# 카테고리별 임계값 — 위험도가 높을수록 낮게 설정
THRESHOLDS = {
    'self_harm':     {'review': 0.30, 'block': 0.60},
    'sexual':        {'review': 0.45, 'block': 0.75},
    'hate':          {'review': 0.45, 'block': 0.78},
    'violence':      {'review': 0.50, 'block': 0.82},
    'harassment':    {'review': 0.55, 'block': 0.85},
    'spam':          {'review': 0.60, 'block': 0.90},
    'personal_info': {'review': 0.40, 'block': 0.70},
}

@dataclass
class ModerationResult:
    action: Action
    scores: dict
    triggered: list = field(default_factory=list)
    reason: str = ""

def decide(scores: dict) -> ModerationResult:
    triggered, worst = [], Action.ALLOW

    for cat, score in scores.items():
        th = THRESHOLDS.get(cat)
        if not th:
            continue
        if score >= th['block']:
            triggered.append((cat, score, Action.BLOCK))
            worst = Action.BLOCK
        elif score >= th['review']:
            triggered.append((cat, score, Action.REVIEW))
            if worst != Action.BLOCK:
                worst = Action.REVIEW

    reason = ", ".join(f"{c}={s:.2f}" for c, s, _ in triggered) or "clean"
    return ModerationResult(worst, scores, triggered, reason)
4-2. 임계값은 어떻게 정해? → PR 커브를 봐
감으로 0.5 찍지 말고, 데이터로 정하자.
from sklearn.metrics import precision_recall_curve
import numpy as np

def find_threshold_for_precision(y_true, y_prob, target_precision=0.95):
    """정밀도 목표를 만족하면서 재현율이 최대인 임계값 찾기"""
    precision, recall, thresholds = precision_recall_curve(y_true, y_prob)
    # 마지막 원소는 threshold 대응이 없으므로 제외
    precision, recall = precision[:-1], recall[:-1]

    ok = precision >= target_precision
    if not ok.any():
        return 1.0, 0.0, 0.0

    best = np.argmax(np.where(ok, recall, -1))
    return thresholds[best], precision[best], recall[best]

th, p, r = find_threshold_for_precision(y_te, probs, 0.95)
print(f"차단 임계값={th:.3f}  정밀도={p:.3f}  재현율={r:.3f}")
⚠️ 자동 차단에는 "정밀도"를 우선하라
자동 차단 구간에서 오탐 1건은 유저 이탈과 브랜드 신뢰 손상으로 이어져.
그래서 BLOCK 임계값은 정밀도 0.95 이상을 목표로 잡고,
놓치는 건(재현율 손실) REVIEW 큐에서 사람이 잡는 구조로 설계해.
즉, 기계는 확실한 것만, 애매한 건 사람에게.
🖼️ 보너스: 이미지 필터링은 CLIP으로 시작하자
텍스트만 필터링하면 반쪽이야. 요즘은 이미지가 더 문제거든.
근데 이미지 분류 모델을 처음부터 학습시키려면 데이터가 어마어마하게 필요해.
그래서 CLIP(Contrastive Language-Image Pre-training)을 쓴다.
CLIP의 마법은 이거야:
이미지와 텍스트를 같은 벡터 공간에 넣어버린다.
그래서 학습 없이(Zero-shot) "이 이미지가 '폭력적인 장면'과 얼마나 가까운가?"를 계산할 수 있어.
import torch
from PIL import Image
from transformers import CLIPProcessor, CLIPModel

model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")

# 판별 기준을 '문장'으로 정의한다 (프롬프트 엔지니어링!)
PROMPTS = [
    "a normal safe everyday photo",
    "a photo containing graphic violence or blood",
    "a sexually explicit photo",
    "an image of a weapon such as a gun or knife",
    "a screenshot of an advertisement or spam banner",
]

@torch.no_grad()
def classify_image(path: str):
    image = Image.open(path).convert("RGB")
    inputs = processor(
        text=PROMPTS, images=image,
        return_tensors="pt", padding=True
    )
    outputs = model(**inputs)
    probs = outputs.logits_per_image.softmax(dim=1)[0]
    return {p: round(float(s), 4) for p, s in zip(PROMPTS, probs)}

print(classify_image("sample.jpg"))
💡 CLIP 실전 팁
① "안전" 프롬프트를 반드시 포함해. 없으면 모든 이미지가 뭔가에 걸려.
② 프롬프트는 구체적일수록 정확해. "bad image"보다 "a photo containing blood"가 훨씬 낫다.
③ Zero-shot으로 대략 걸러낸 뒤, 모인 데이터로 전용 분류기를 파인튜닝하는 게 최종 코스.
④ 애니메이션·일러스트 도메인은 CLIP이 약해. 별도 데이터 보강 필수.
참고로 재능넷 같은 재능 공유 플랫폼처럼
포트폴리오 이미지와 설명 텍스트가 동시에 올라오는 서비스에서는
이미지와 텍스트를 함께 판단하는 멀티모달 필터가 특히 효과적이야.
텍스트는 멀쩡한데 이미지가 이상하거나, 그 반대인 케이스가 실제로 꽤 많거든.
🔗 전체 조립: 프로덕션 파이프라인
이제 지금까지 만든 걸 하나로 합쳐보자.
import time
import torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification

class ContentModerator:
    def __init__(self, model_path, banned_words, device=None):
        self.device = device or ('cuda' if torch.cuda.is_available() else 'cpu')
        self.tokenizer = AutoTokenizer.from_pretrained(model_path)
        self.model = AutoModelForSequenceClassification.from_pretrained(
            model_path
        ).to(self.device).eval()
        self.matcher = BannedWordMatcher(banned_words)

    def _ml_scores(self, text: str) -> dict:
        enc = self.tokenizer(
            text, truncation=True, max_length=128, return_tensors='pt'
        ).to(self.device)
        with torch.no_grad():
            logits = self.model(**enc).logits[0]
        probs = torch.sigmoid(logits).cpu().tolist()   # 멀티라벨
        return dict(zip(CATEGORIES, probs))

    def moderate(self, text: str) -> dict:
        t0 = time.perf_counter()

        # --- STEP 1: 정규화 ---
        norm = normalize_text(text)
        jamo = decompose_hangul(fold_homoglyph(norm))
        jamo_clean = re.sub(r'[^가-힣ㄱ-ㅎㅏ-ㅣa-z]', '', jamo)

        # --- STEP 2: 규칙 필터 (Early Exit) ---
        hits = self.matcher.find(jamo_clean)
        if hits and not is_whitelisted(text, hits[0]['word']):
            return {
                'action': Action.BLOCK.value,
                'stage': 'rule',
                'reason': f"금지어 매칭: {hits[0]['word']}",
                'latency_ms': round((time.perf_counter() - t0) * 1000, 2),
            }

        # --- STEP 3: ML 추론 ---
        scores = self._ml_scores(norm)

        # --- STEP 4: 정책 결정 ---
        result = decide(scores)

        return {
            'action': result.action.value,
            'stage': 'ml',
            'scores': {k: round(v, 4) for k, v in scores.items()},
            'reason': result.reason,
            'latency_ms': round((time.perf_counter() - t0) * 1000, 2),
        }
FastAPI로 서빙하기
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="Content Moderation API")
moderator = ContentModerator('./toxic-filter/best', BANNED_WORDS)

class Req(BaseModel):
    text: str
    user_id: str | None = None

@app.post("/moderate")
def moderate(req: Req):
    return moderator.moderate(req.text)

@app.get("/health")
def health():
    return {"status": "ok"}
🚀 처리량 올리는 3가지 실전 기법
① 동적 배칭 — 들어오는 요청을 20~50ms 모아서 한 번에 GPU로. 처리량이 5~10배 뛴다.
② ONNX Runtime 변환 — CPU 추론 속도가 2~3배 개선되는 경우가 흔하다.
③ 결과 캐싱 — 텍스트 해시를 키로 Redis에 저장. 도배 공격 시 캐시 히트율이 폭발적으로 올라간다.
# ONNX 변환 예시
# pip install optimum[onnxruntime]
from optimum.onnxruntime import ORTModelForSequenceClassification

ort_model = ORTModelForSequenceClassification.from_pretrained(
    './toxic-filter/best', export=True
)
ort_model.save_pretrained('./toxic-filter/onnx')
📈 평가: 정확도(Accuracy)를 믿지 마라
진짜 중요한 얘기 하나만 할게.
유해 콘텐츠는 보통 전체의 2~5%야. 극심한 불균형 데이터지.
그러면 "전부 정상입니다"라고만 답하는 모델도 정확도 96%가 나와.
말도 안 되지? 그래서 다른 지표를 봐야 해.
| 지표 | 의미 | 언제 중요한가 |
|---|---|---|
| Precision | 차단한 것 중 진짜 유해한 비율 | 오탐(억울한 차단)을 줄이고 싶을 때 |
| Recall | 실제 유해물 중 잡아낸 비율 | 놓침을 줄이고 싶을 때 |
| F1 | 둘의 조화평균 | 균형 잡힌 단일 지표가 필요할 때 |
| PR-AUC | PR 커브 아래 면적 | 불균형 데이터의 표준 지표 |
| FPR@95TPR | 재현율 95% 지점의 오탐률 | 운영 목표 기준 성능 확인 |
오류 분석: 진짜 개선은 여기서 나온다
모델 성능이 안 나올 때 하이퍼파라미터부터 만지지 마.
틀린 케이스를 눈으로 직접 봐. 이게 훨씬 빨라.
import pandas as pd

df = pd.DataFrame({'text': X_te, 'true': y_te, 'prob': probs})
df['pred'] = (df['prob'] >= 0.5).astype(int)

# 확신에 차서 틀린 것들 = 가장 배울 게 많은 샘플
fp = df[(df.true == 0) & (df.pred == 1)].nlargest(20, 'prob')
fn = df[(df.true == 1) & (df.pred == 0)].nsmallest(20, 'prob')

print("=== 억울하게 차단된 것들 (FP) ===")
print(fp[['text', 'prob']].to_string())
print("\n=== 놓친 것들 (FN) ===")
print(fn[['text', 'prob']].to_string())
이걸 해보면 보통 이런 패턴이 나와:
👉 특정 단어(예: 지역명, 특정 집단명)만 나오면 무조건 유해로 찍는다 → 데이터 편향
👉 반어법·풍자를 전혀 이해 못 한다 → 문맥 데이터 부족
👉 인용문("그 사람이 나한테 ~라고 했어")을 발화로 오인한다 → 라벨링 가이드 문제
🕳️ 실무에서 반드시 마주치는 함정들
함정 1. 데이터 편향 (Bias)
유명한 연구 결과가 있어. 영어권 유해성 탐지 모델들이
아프리카계 미국인 영어(AAE) 텍스트를 유의미하게 더 높은 확률로 유해하다고 판정한다는 거야.
(Sap et al., 2019, ACL — "The Risk of Racial Bias in Hate Speech Detection")
한국어에서도 똑같은 일이 생겨.
특정 커뮤니티 말투, 특정 지역 방언, 특정 연령대 표현이 과잉 차단될 수 있어.
대응 방법
① 그룹별 성능 분리 측정 — 전체 F1 말고, 하위 집단별 FPR을 따로 봐라.
② Counterfactual 테스트 — 문장에서 집단 명칭만 바꿔가며 점수 변화를 관찰. 점수가 크게 튀면 편향 신호.
③ 라벨러 다양성 확보 — 라벨링하는 사람이 편향되면 모델도 그대로 편향된다.
# Counterfactual 편향 테스트 예시
TEMPLATE = "나는 {} 사람들이랑 같이 일하는 게 좋아"
GROUPS = ["서울", "부산", "중국", "일본", "여성", "남성", "노인", "청년"]

for g in GROUPS:
    s = moderator.moderate(TEMPLATE.format(g))
    print(f"{g:6s} → hate={s['scores']['hate']:.4f}")
# 점수 편차가 크다면 → 학습 데이터에 편향이 있다는 강력한 신호
함정 2. 적대적 회피 (Adversarial Evasion)
필터를 만들면, 사람들은 반드시 뚫으려고 해. 그것도 아주 창의적으로.
그래서 학습 단계에서 미리 우회 패턴을 만들어 넣는 데이터 증강이 필수야.
import random

def augment_evasion(text: str) -> list:
    """학습 데이터에 우회 변형을 인위적으로 추가"""
    variants = [text]

    # 1) 글자 사이 특수문자 삽입
    variants.append('.'.join(text))

    # 2) 초성만 남기기
    variants.append(''.join(
        decompose_hangul(c)[0] if '가' <= c <= '힣' else c
        for c in text
    ))

    # 3) 무작위 공백 삽입
    chars = list(text)
    for _ in range(max(1, len(chars) // 5)):
        if len(chars) > 1:
            chars.insert(random.randint(1, len(chars) - 1), ' ')
    variants.append(''.join(chars))

    # 4) 숫자 치환
    table = str.maketrans({'ㅇ': '0', 'ㅣ': '1', 'ㅗ': 'ㅗ'})
    variants.append(decompose_hangul(text).translate(table))

    return list(set(variants))
이걸 학습 데이터에 섞어주면 우회 저항성이 눈에 띄게 올라가.
함정 3. 개념 표류 (Concept Drift)
3개월 전에 만든 모델이 오늘은 안 먹혀.
왜? 인터넷 언어가 미친 속도로 변하거든.
어제까지 없던 신조어, 어제까지 평범했는데 오늘 밈이 되어 모욕어가 된 단어...
필터링은 한 번 만들고 끝나는 프로젝트가 아니라 계속 돌리는 운영이야.
🔄 지속 운영 루프
1. 유저 신고 + 모더레이터 판정 결과를 매일 수집
2. 모델 점수가 0.4~0.6인 애매한 샘플을 우선 라벨링 (Active Learning)
3. 주 1회 또는 월 1회 재학습
4. 고정된 골든 테스트셋으로 성능 회귀 여부 검증
5. 카나리 배포 → 문제없으면 전체 롤아웃
함정 4. 법적 의무와 투명성
기술만 잘한다고 끝이 아니야. 법이 따라와.
한국의 정보통신망법은 명예훼손 등 권리침해 정보에 대한 임시조치 제도를 두고 있어.
EU의 디지털서비스법(DSA)은 콘텐츠 조치 시 이유를 명시적으로 고지하고
이의제기 절차를 제공하도록 요구하지.
즉, 코드 레벨에서도 이런 게 필요해:
@dataclass
class AuditLog:
    content_id: str
    action: str
    model_version: str      # 어떤 모델이 판단했는가
    scores: dict            # 점수 근거
    policy_version: str     # 어떤 정책 기준이었나
    timestamp: float
    appealable: bool = True # 이의제기 가능 여부
    reviewer_id: str = ""   # 사람이 검토했다면 누가
"왜 차단됐는지 설명할 수 없는 시스템"은 기술적으로도, 법적으로도 위험해.
💰 비용 최적화: 현실적인 이야기
모든 요청을 GPU 트랜스포머에 태우면? 통장이 녹아.
그래서 계층형(Cascade) 구조가 답이야.
| 계층 | 처리 비중 | 비용 | 담당 |
|---|---|---|---|
| L1 정규화 + 캐시 | ~30% | 거의 0 | 중복/도배 즉시 차단 |
| L2 규칙 + 경량 ML | ~55% | 매우 낮음 | 명백한 케이스 판정 |
| L3 트랜스포머 | ~14% | 중간 | 애매한 케이스 정밀 판정 |
| L4 사람 검토 | ~1% | 높음 | 최종 판단 + 라벨 확보 |
import hashlib

class CascadeModerator:
    def __init__(self, moderator, cache):
        self.m = moderator
        self.cache = cache   # Redis 등

    def moderate(self, text: str):
        # L1: 캐시 확인
        key = "mod:" + hashlib.sha256(text.encode()).hexdigest()[:32]
        cached = self.cache.get(key)
        if cached:
            return {'cached': True, **json.loads(cached)}

        result = self.m.moderate(text)
        # 확정 결과만 캐싱 (review는 정책 변경 여지가 있으니 제외)
        if result['action'] in ('allow', 'block'):
            self.cache.setex(key, 86400, json.dumps(result))
        return result
💡 경량화 옵션 정리
지식 증류(Distillation) — 큰 모델의 출력을 작은 모델에게 가르친다. 크기 1/3, 성능 손실 최소.
양자화(Quantization) — FP32 → INT8. 모델 크기 약 1/4, CPU 추론 대폭 가속.
DistilBERT 계열 — 처음부터 경량 아키텍처 선택.
🧭 마무리: 필터는 기술이 아니라 '태도'다
여기까지 왔으면 너는 이제 이런 걸 만들 수 있어:
✅ 유니코드·자모 우회를 무력화하는 정규화 파이프라인
✅ Aho-Corasick 기반의 초고속 금지어 매칭
✅ 한국어 트랜스포머 멀티라벨 유해성 분류기
✅ 카테고리별 임계값 정책 엔진
✅ CLIP 기반 제로샷 이미지 필터
✅ 캐시와 계층 구조로 비용을 통제하는 서빙 설계
근데 마지막으로 이 얘기는 꼭 하고 싶어.
완벽한 필터는 존재하지 않는다.
같은 문장도 누가 누구에게 어떤 맥락에서 말했느냐에 따라
농담이 되기도 하고 폭력이 되기도 해.
사람도 헷갈리는 걸 모델이 완벽하게 맞출 리 없지.
그래서 좋은 필터링 시스템의 조건은 '절대 안 틀리는 것'이 아니라
'틀렸을 때 빠르게 되돌릴 수 있는 것'이야.
이의제기 창구, 감사 로그, 사람 검토 큐, 재학습 루프.
이 네 가지가 모델 정확도보다 훨씬 중요해.
기술적으로는 임계값 하나 조정하는 일이지만,
그 숫자 하나가 누군가의 발언을 지우기도 하고, 누군가를 지켜주기도 해.
그래서 콘텐츠 필터링 개발은 엔지니어링인 동시에 윤리적 설계야.
혹시 이런 시스템을 직접 구축해야 하는데 막막하다면,
재능넷 같은 플랫폼에서 머신러닝 엔지니어와 협업해보는 것도 방법이야.
특히 라벨링 데이터 구축이나 도메인별 임계값 튜닝처럼
경험치가 결정적인 영역은 혼자보다 같이 하는 게 훨씬 빠르거든.
자, 이제 pip install transformers 치고 시작해보자. 🚀
첫 모델은 분명 엉망일 거야. 근데 괜찮아. 다들 그랬어.
중요한 건 첫 버전을 배포하고, 로그를 보고, 다시 고치는 그 루프를 도는 거야.
관련 키워드

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.