Ver4.0 상관관계는 인과관계가 아니다!아이스크림과 익사 사고의 진실
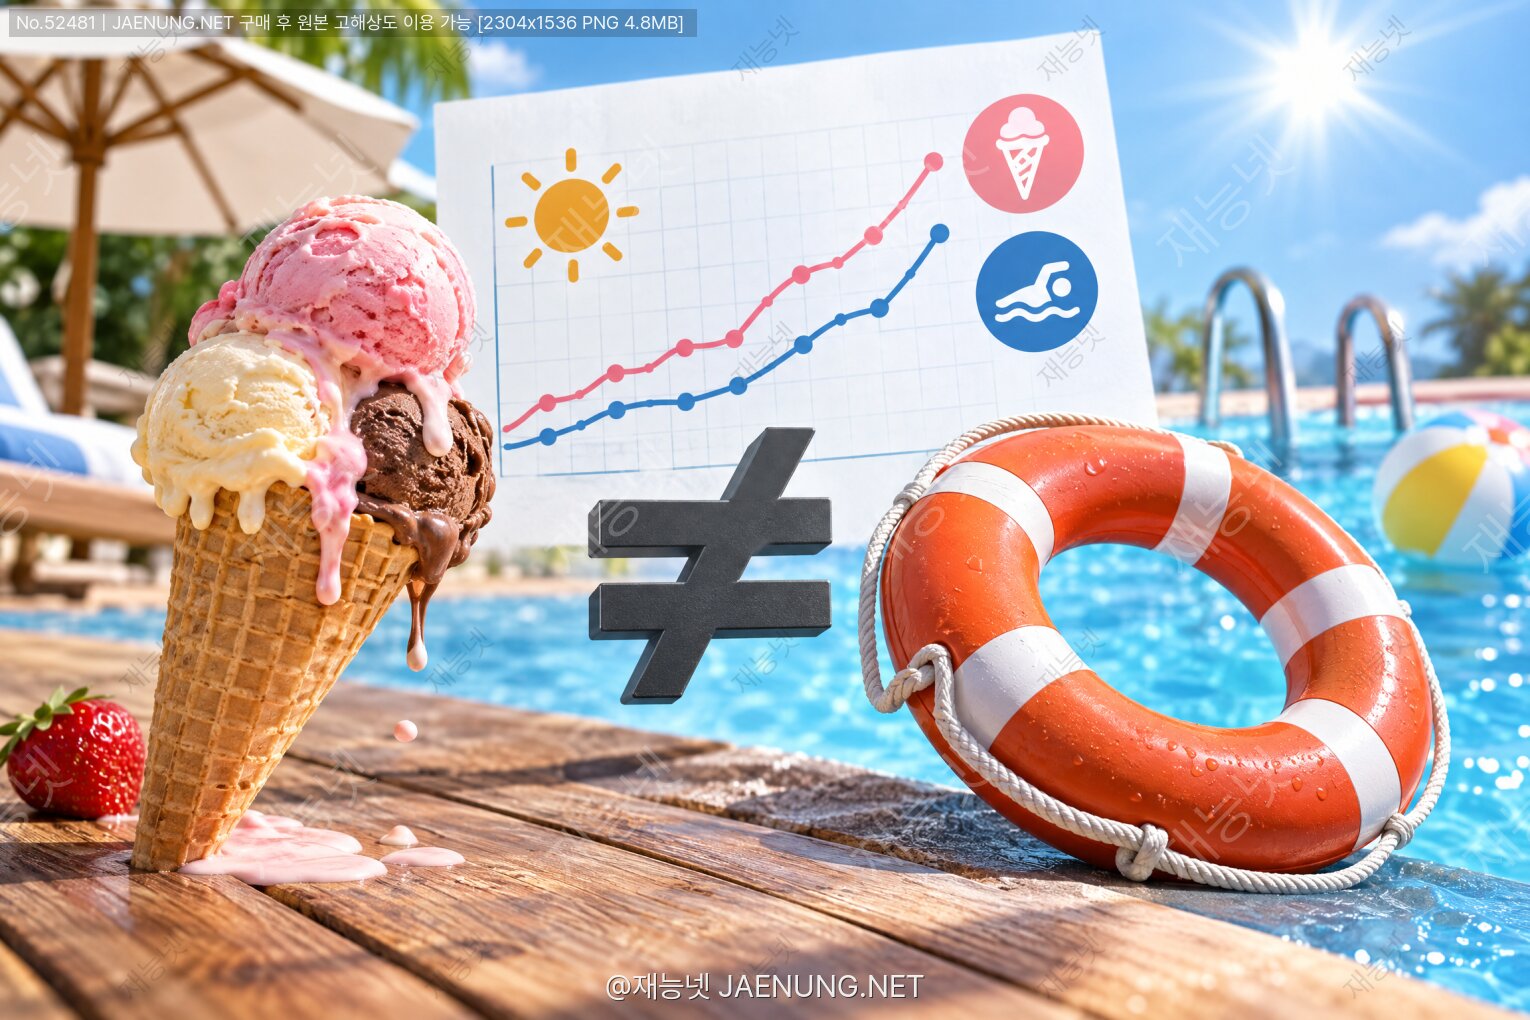
상관관계는 인과관계가 아니다!
아이스크림과 익사 사고의 진실
여름이 오면 아이스크림이 팔린다. 그리고 사람이 물에 빠진다.
이 둘은 정말 '관련'이 있을까? 아니면 우리가 속고 있는 걸까?
🍦 프롤로그 : 아이스크림 회사가 살인범이라고요?
여기 하나의 데이터가 있습니다.
어느 나라의 월별 아이스크림 판매량과 익사 사고 건수를 나란히 놓고 그래프를 그려봤더니, 두 선이 거의 쌍둥이처럼 붙어서 움직입니다.
아이스크림이 많이 팔린 달에는 익사 사고도 많았고,
아이스크림이 덜 팔린 달에는 익사 사고도 적었습니다.
상관계수를 계산해보니 r ≈ 0.9. 통계학에서 이 정도면 "거의 한 몸"이라고 표현할 만큼 강력한 수치입니다.
그렇다면 결론은?
"아이스크림을 금지하면 익사 사고가 줄어든다!"
…라고 말하는 순간, 당신은 통계학 역사상 가장 유명한 함정에 빠진 것입니다.
이 글은 데이터 리터러시의 제1계명이자, 동시에 가장 많이 깨지는 계명인
"Correlation does not imply causation(상관관계는 인과관계를 함의하지 않는다)"에 대한 이야기입니다.
단순히 "속지 마세요"라는 훈계로 끝내지 않겠습니다.
왜 그런 착각이 생기는지, 어떻게 구조적으로 판별하는지,
그리고 실무에서 어떤 통계 도구로 인과를 추정하는지까지 파고들어 봅니다.
📐 1장. 상관관계란 정확히 무엇인가
1-1. 상관계수의 수학적 정의
가장 널리 쓰이는 피어슨 상관계수(Pearson correlation coefficient)는 두 변수의 공분산을 각각의 표준편차로 나눈 값입니다.
r = Cov(X, Y) / (σx · σy)

Cov(X, Y) = Σ (xi - x̄)(yi - ȳ) / (n - 1)

-1 ≤ r ≤ +1
이 식이 말하는 바는 의외로 단순합니다.
"X가 평균보다 클 때 Y도 평균보다 큰가?"를 곱셈으로 누적한 뒤, 단위를 지워서(표준화) -1과 +1 사이로 눌러 담은 것입니다.
r 값 해석 가이드 (사회과학 관례)
· |r| 0.0 ~ 0.2 : 거의 없음
· |r| 0.2 ~ 0.4 : 약한 상관
· |r| 0.4 ~ 0.6 : 중간 상관
· |r| 0.6 ~ 0.8 : 강한 상관
· |r| 0.8 ~ 1.0 : 매우 강한 상관
※ 분야마다 기준이 다릅니다. 물리학에서 r=0.8은 실망스러운 수치지만, 심리학에서 r=0.4는 대성공입니다.
1-2. 상관계수가 '못 보는' 것들
피어슨 r은 직선 관계만 측정합니다. 이 한계는 생각보다 치명적입니다.
① 비선형 관계를 놓친다
Y = X²의 관계에서 X가 -5부터 +5까지 대칭으로 분포하면, 완벽한 수학적 관계가 있음에도 r ≈ 0이 나옵니다.
② 이상치(outlier) 한 개에 무너진다
아무 관계 없는 100개의 점에 극단적인 점 하나만 추가해도 r이 0.8까지 치솟을 수 있습니다.
③ 분포 모양을 못 본다
1973년 통계학자 프랜시스 앤스컴(Francis Anscombe)이 만든 앤스컴 콰르텟(Anscombe's Quartet)은 이 문제를 극적으로 보여줍니다.
네 개의 전혀 다른 데이터셋이 평균, 분산, 상관계수, 회귀직선까지 전부 동일합니다. 그런데 그림을 그려보면 완전히 다른 모양입니다.
📌 실무 교훈
상관계수를 보고하기 전에 반드시 산점도를 먼저 그려라.
숫자 하나에 담긴 정보는 생각보다 빈약하며, 그림은 생각보다 많은 것을 말해준다.
🌡️ 2장. 아이스크림 사건의 진범 : 교란변수
2-1. 숨어 있던 제3의 변수
이제 진범을 공개합니다. 범인은 기온(여름)입니다.
기온이 올라가면 두 가지 일이 동시에, 그러나 서로 독립적으로 일어납니다.
1 더우니까 사람들이 아이스크림을 사 먹는다 → 아이스크림 판매량 ↑
2 더우니까 사람들이 바다·계곡·수영장으로 간다 → 물에 노출되는 시간 ↑ → 익사 사고 ↑
즉 아이스크림과 익사 사고 사이에는 직접적인 화살표가 존재하지 않습니다.
두 변수는 각각 기온이라는 공통 원인(common cause)에서 갈라져 나온 형제일 뿐입니다.
이렇게 두 변수 모두에 영향을 주면서 가짜 상관을 만들어내는 제3의 변수를
통계학에서는 교란변수(confounding variable, 혼란변수)라고 부릅니다.
이때 나타나는 관계를 허위 상관(spurious correlation)이라고 합니다.
2-2. 통계로 증명하기 : 편상관(partial correlation)
"기온 때문이다"라는 주장을 감(感)이 아니라 수치로 보이려면 어떻게 할까요?
기온을 고정한 상태에서 아이스크림과 익사의 관계를 다시 측정하면 됩니다. 이것이 편상관계수입니다.
r(XY·Z) = [ r(XY) - r(XZ)·r(YZ) ] / √[(1 - r(XZ)²)(1 - r(YZ)²)]

예시 수치 대입:
r(XY) = 0.90   (아이스크림 ↔ 익사)
r(XZ) = 0.95   (아이스크림 ↔ 기온)
r(YZ) = 0.93   (익사 ↔ 기온)

분자 = 0.90 - (0.95 × 0.93) = 0.90 - 0.8835 = 0.0165
분모 = √[(1-0.9025)(1-0.8649)] = √(0.0975 × 0.1351) ≈ 0.1148

r(XY·Z) ≈ 0.14  →  거의 0
기온을 통제하는 순간 0.90이던 상관이 0.14로 증발합니다.
이것이 바로 "아이스크림과 익사 사이에 직접적 관계가 없다"는 통계적 증거입니다.
같은 원리의 다른 표현 : 층화 분석(stratification)
데이터를 "기온 20℃ 미만 / 20~28℃ / 28℃ 초과" 같은 층으로 쪼갠 뒤,
각 층 안에서 아이스크림과 익사의 상관을 다시 계산합니다.
모든 층에서 상관이 사라진다면, 원래 상관은 기온이 만든 착시였다는 뜻입니다.
🧩 3장. 상관이 인과가 아닌 6가지 시나리오
"X와 Y가 상관 있다"는 사실이 관찰되었을 때, 가능한 설명은 최소 여섯 가지입니다.
그중 단 하나만이 우리가 흔히 믿는 "X가 Y를 일으켰다"입니다.
| 유형 | 구조 | 예시 |
|---|---|---|
| ① 직접 인과 | X → Y | 흡연 → 폐암 |
| ② 역인과 | Y → X | "운동하면 건강해진다"가 아니라 건강한 사람이 운동을 한다 |
| ③ 공통 원인(교란) | X ← Z → Y | 아이스크림 ← 기온 → 익사 |
| ④ 선택 편향 | X → S ← Y | 병원 환자만 조사해서 생기는 왜곡(버크슨의 역설) |
| ⑤ 우연(무작위) | 없음 | 변수 수천 개를 돌려서 우연히 걸린 관계 |
| ⑥ 양방향 순환 | X ⇄ Y | 스트레스 ⇄ 불면증 |
3-1. 역인과의 함정 : "병원에 가면 죽는다?"
병원 입원 여부와 사망률의 상관관계를 조사하면, 입원한 사람의 사망률이 훨씬 높습니다.
그렇다고 "병원이 사람을 죽인다"고 결론 내리면 안 됩니다.
화살표의 방향은 반대입니다. 아프기 때문에 병원에 간 것이고, 아프기 때문에 사망 위험이 높은 것입니다.
여기서도 '질병의 중증도'라는 교란변수가 함께 작동합니다.
3-2. 선택 편향과 버크슨의 역설
1946년 조셉 버크슨(Joseph Berkson)이 지적한 현상입니다.
병원 입원 환자만을 표본으로 삼으면, 실제로는 독립적인 두 질병 사이에 음(-)의 상관이 나타납니다.
이유는 간단합니다. 병원에 입원하려면 "질병 A가 심하거나, 질병 B가 심하거나" 둘 중 하나여야 합니다.
그러므로 입원 환자 중 A가 없는 사람은 B가 심할 확률이 높아집니다.
표본을 고르는 행위 자체가 가짜 관계를 만들어낸 것입니다.
⚠️ 콜라이더(collider)에 조건 걸지 마라
X와 Y가 함께 영향을 주는 변수 S(콜라이더)를 통제하거나 필터링하면,
없던 상관이 생겨납니다. 교란변수는 통제해야 하지만, 콜라이더는 절대 통제하면 안 됩니다.
많은 분석가가 "변수를 많이 넣을수록 정확하다"고 착각하는데, 이것은 명백한 오류입니다.
3-3. 우연의 상관 : 데이터 준설(data dredging)
타일러 비겐(Tyler Vigen)의 Spurious Correlations 프로젝트는 이 문제를 유머로 폭로했습니다.
메인주의 이혼율과 1인당 마가린 소비량의 상관계수는 약 0.99였다.
왜 이런 일이 생길까요? 다중비교 문제(multiple comparisons problem) 때문입니다.
유의수준 5%로 검정한다는 것은 "관계가 없어도 20번에 1번은 있다고 잘못 판정한다"는 뜻입니다.
변수 100개를 서로 짝지으면 4,950쌍이 나오고, 그중 약 247쌍이 아무 관계 없이도 "유의미"하게 나옵니다.
# 관계가 전혀 없는 변수 100개로 상관을 다 돌려보면?
쌍의 개수 = C(100, 2) = 100 × 99 / 2 = 4,950
기대 오탐 수 = 4,950 × 0.05 ≈ 247.5

→ 247개의 "놀라운 발견"이 저절로 생산된다.
여기에 시계열 트렌드가 겹치면 상황은 더 나빠집니다.
둘 다 그냥 시간에 따라 증가하는 변수라면(GDP, 인구, 인터넷 사용률 등) 서로 무관해도 r이 0.9를 넘습니다.
그래서 시계열 분석에서는 차분(differencing)이나 추세 제거(detrending)를 먼저 수행해야 합니다.
🔬 4장. 그렇다면 인과는 어떻게 증명하는가
4-1. 황금 표준 : 무작위 대조 시험(RCT)
인과 추론의 가장 강력한 도구는 무작위 배정입니다.
대상자를 동전 던지기로 처치군과 대조군에 나누면,
알려진 교란변수든 알려지지 않은 교란변수든 두 집단에 확률적으로 균등하게 분배됩니다.
따라서 두 집단의 결과 차이는 오직 처치 때문이라고 말할 수 있습니다.
이것이 신약 임상시험, A/B 테스트, 정책 실험이 모두 무작위 배정을 고집하는 이유입니다.
하지만 RCT가 불가능할 때
· 윤리적으로 불가 : "담배를 20년간 피우세요" 실험은 할 수 없다
· 물리적으로 불가 : 국가의 금리를 무작위로 정할 수 없다
· 비용·시간 제약 : 수십 년이 걸리는 효과
→ 이때 등장하는 것이 준실험 설계(quasi-experiment)와 인과추론 기법이다.
4-2. 관찰 데이터로 인과를 캐내는 방법들
| 기법 | 핵심 아이디어 | 대표 활용 |
|---|---|---|
| 회귀분석 · 공변량 통제 | 교란변수를 모형에 함께 넣어 효과를 분리 | 가장 기본적인 접근 |
| 성향점수 매칭(PSM) | 처치 확률이 비슷한 사람끼리 짝지어 비교 | 의료·교육 정책 평가 |
| 이중차분법(DiD) | 처치 전후 변화량을, 대조군의 변화량과 비교 | 최저임금 인상 효과 분석 |
| 도구변수(IV) | X에만 영향 주고 Y엔 직접 영향 없는 변수를 지렛대로 사용 | 교육연수가 임금에 미치는 효과 |
| 회귀불연속(RDD) | 기준선 바로 위/아래를 준-무작위로 간주 | 장학금 커트라인 효과 |
| 그레인저 인과성 | 과거 X가 미래 Y의 예측력을 높이는가 | 거시경제 시계열 |
※ 그레인저 인과성은 이름과 달리 엄밀한 '인과'가 아니라 예측적 선행성을 뜻합니다. 용어에 속지 마세요.
4-3. 브래드퍼드 힐의 9가지 기준
1965년 영국 역학자 오스틴 브래드퍼드 힐(Austin Bradford Hill)은 흡연-폐암 논쟁 속에서
"관찰된 상관이 인과일 가능성"을 판단하는 아홉 가지 관점을 제시했습니다.
이 체크리스트는 오늘날에도 역학·공중보건의 표준 사고틀로 쓰입니다.
1 강도(Strength) : 연관이 강할수록 우연·교란으로 설명하기 어렵다
2 일관성(Consistency) : 다른 집단·시대·연구에서 반복 관찰되는가
3 특이성(Specificity) : 특정 원인이 특정 결과와 연결되는가
4 시간성(Temporality) : 원인이 결과보다 반드시 먼저 발생했는가 — 유일한 필수 조건
5 용량-반응(Biological gradient) : 노출이 늘수록 결과도 늘어나는가
6 개연성(Plausibility) : 설명 가능한 메커니즘이 있는가
7 정합성(Coherence) : 기존 지식과 충돌하지 않는가
8 실험(Experiment) : 노출을 제거하면 결과가 줄어드는가
9 유추(Analogy) : 비슷한 사례가 이미 알려져 있는가
아이스크림 가설을 힐의 기준으로 채점해보면?
· 시간성 : 아이스크림을 먹은 직후 익사한다는 증거 없음 → 탈락
· 용량-반응 : 아이스크림을 두 배 먹으면 익사 위험이 두 배? → 근거 없음
· 개연성 : 생리학적 메커니즘 부재 → 탈락
· 실험 : 아이스크림 판매 금지 실험에서 익사 감소 관찰 안 됨 → 탈락
결론 : 상관만 강했을 뿐, 인과의 조건은 하나도 충족하지 못한다.
📰 5장. 현실에서 벌어지는 오해의 현장
사례 A. "아침을 먹는 아이가 성적이 높다"
수많은 기사가 이 데이터를 근거로 "아침을 먹이세요"라고 말합니다.
그런데 아침을 챙겨 먹이는 가정은 대체로 규칙적인 생활, 안정적 소득, 부모의 교육 관심을 함께 가지고 있습니다.
즉 가정환경이 교란변수입니다.
아침 식사 자체의 순수 효과를 알려면, 동일한 가정환경 내에서 무작위로 아침 제공 여부를 나눠야 합니다.
실제로 학교 조식 프로그램을 무작위 도입한 연구들에서는 효과가 있긴 하지만 훨씬 작게 나타납니다.
사례 B. "커피를 많이 마시면 폐암 위험이 높아진다"
1970년대 실제로 보고된 연관입니다. 범인은 흡연이었습니다.
당시 커피를 많이 마시는 사람은 담배도 많이 피웠습니다.
흡연량을 통제하자 커피-폐암 연관은 대부분 사라졌습니다.
사례 C. "황새가 많은 지역에 신생아가 많다"
1994년 실제 논문(Teaching Statistics)으로 발표된 유명한 예시입니다.
유럽 여러 국가에서 황새 개체 수와 출생률의 상관계수는 유의미했습니다.
진범은 국토 면적과 농촌성이었습니다.
큰 나라일수록 황새 서식지도 넓고, 인구도 많아 출생아 수도 많습니다.
'국가 규모'라는 교란변수가 만든 전형적 허위 상관입니다.
사례 D. 초콜릿 소비와 노벨상 수상자 수
2012년 New England Journal of Medicine에 실린 화제의 분석입니다.
국가별 1인당 초콜릿 소비량과 인구당 노벨상 수상자 수의 상관계수는 약 0.79였습니다.
저자 본인도 반쯤은 농담이었습니다. 실제 교란변수는 국가의 경제력·연구 인프라·교육 수준입니다.
잘 사는 나라가 초콜릿도 많이 먹고 연구비도 많이 씁니다.
🚨 생태학적 오류(ecological fallacy)
위 사례들은 모두 국가 단위 집계 데이터를 사용했습니다.
집단 수준의 상관을 개인 수준의 인과로 해석하는 것을 생태학적 오류라 합니다.
"초콜릿 많이 먹는 나라에 노벨상 수상자가 많다"는 사실이,
"당신이 초콜릿을 먹으면 노벨상에 가까워진다"를 전혀 의미하지 않습니다.
사례 E. 심슨의 역설 — 전체와 부분이 반대로 말할 때
1973년 UC 버클리 대학원 입학 데이터는 통계학 교과서의 고전입니다.
전체로 보면 남성 합격률이 여성보다 높아서 성차별 의혹이 제기되었습니다.
그런데 학과별로 쪼개어 보니 대부분의 학과에서 오히려 여성 합격률이 더 높았습니다.
이유는 지원 패턴이었습니다. 여성은 경쟁률이 극도로 높은 학과에 더 많이 지원했고,
남성은 상대적으로 합격률이 높은 학과에 몰렸습니다.
집계 방식 하나로 결론이 정반대가 되는 현상, 이것이 심슨의 역설(Simpson's Paradox)입니다.
심슨의 역설이 무서운 이유는, "어느 쪽이 맞느냐"에 정답이 하나로 정해지지 않는다는 점입니다.
데이터만으로는 판단할 수 없고, 인과 구조에 대한 지식이 있어야 합니다.
학과를 통제해야 하는지(교란변수인 경우) 통제하면 안 되는지(매개변수인 경우)는
숫자가 아니라 도메인 이해가 결정합니다.
🛠️ 6장. 실무자를 위한 인과 점검 툴킷
6-1. 인과 다이어그램(DAG)을 먼저 그려라
주디아 펄(Judea Pearl)이 체계화한 인과 다이어그램(Directed Acyclic Graph)은
"어떤 변수를 통제하고, 어떤 변수를 놔둘 것인가"를 판단하는 지도입니다.
세 가지 기본 구조만 기억하면 대부분의 상황을 다룰 수 있습니다.
| 구조 | 형태 | 통제 여부 |
|---|---|---|
| 체인(Chain) | X → M → Y | M은 매개변수. 통제하면 총효과가 사라짐 |
| 포크(Fork) | X ← Z → Y | Z는 교란변수. 반드시 통제 |
| 콜라이더(Collider) | X → C ← Y | C는 충돌부. 통제하면 안 됨 |
6-2. 분석 코드로 확인해보기
실제로 아이스크림-익사 데이터를 가상으로 생성해, 교란을 통제했을 때 계수가 어떻게 변하는지 확인해봅시다.
import numpy as np, pandas as pd
import statsmodels.api as sm

np.random.seed(42)
n = 365

# 기온: 계절성을 가진 실제 원인
temp = 15 + 12*np.sin(np.linspace(0, 2*np.pi, n)) + np.random.normal(0, 2, n)

# 아이스크림: 기온에만 의존
icecream = 50 + 8*temp + np.random.normal(0, 25, n)

# 익사: 기온에만 의존 (아이스크림과 직접 연결 없음!)
drowning = 1 + 0.35*temp + np.random.normal(0, 2.5, n)

df = pd.DataFrame({'temp': temp, 'ice': icecream, 'drown': drowning})

print("단순 상관 r =", round(df['ice'].corr(df['drown']), 3))
# → 약 0.85 : "아이스크림이 익사를 부른다!"는 착시

# 모델 1 : 기온을 무시한 순진한 회귀
m1 = sm.OLS(df['drown'], sm.add_constant(df[['ice']])).fit()
print("ice 계수(통제 X):", round(m1.params['ice'], 5))   # 유의미하게 나옴

# 모델 2 : 기온을 통제한 회귀
m2 = sm.OLS(df['drown'], sm.add_constant(df[['ice','temp']])).fit()
print("ice 계수(통제 O):", round(m2.params['ice'], 5))   # 0에 수렴, p값 급상승
결과는 명확합니다.
기온을 모형에 넣는 순간, 아이스크림의 계수는 통계적으로 0과 구분되지 않게 됩니다.
데이터 생성 과정에 아이스크림 → 익사 경로를 넣지 않았기 때문입니다.
💡 시뮬레이션 학습법
인과 구조를 직접 코드로 '만들어서' 분석해보면,
"어떤 통제가 정답을 복원하고 어떤 통제가 정답을 망치는지"를 몸으로 익힐 수 있습니다.
정답을 아는 상태에서 방법론을 검증하는 것, 이것이 인과추론 학습의 지름길입니다.
6-3. 보고서·기획서에 쓸 때의 표현 규칙
문서작성 관점에서도 이 구분은 대단히 중요합니다.
같은 데이터를 두고도 동사 선택 하나가 문서의 신뢰도를 좌우합니다.
| ❌ 과잉 표현 | ✅ 정확한 표현 |
|---|---|
| A가 B를 증가시켰다 | A와 B 사이에 정적 상관이 관찰되었다 |
| A 때문에 B가 발생했다 | A는 B와 함께 나타나는 경향이 있다 |
| A를 늘리면 B가 개선된다 | A가 높은 집단에서 B가 높게 나타났다 |
| A가 B의 원인이다 | 교란요인 통제 후에도 연관이 유지되었다 |
특히 기업 보고서에서 "이 광고 캠페인이 매출을 20% 올렸습니다"라는 문장은
대조군 없이는 성립할 수 없는 주장입니다.
시즌 효과, 경쟁사 상황, 전반적 시장 성장 등이 모두 교란변수로 작동하기 때문입니다.
이런 이유로 실무 데이터 분석 문서는 반드시 "한계 및 해석 주의사항" 절을 포함해야 합니다.
재능넷의 지식인의 숲에서 다루는 통계·분석 콘텐츠들 역시,
숫자를 화려하게 보여주는 것보다 숫자가 말할 수 있는 범위를 정직하게 표기하는 것을 더 중요한 역량으로 봅니다.
🧠 7장. 왜 우리는 자꾸 인과로 착각하는가
이 오류는 통계 지식의 부족만으로 설명되지 않습니다.
인간의 인지 구조 자체가 이야기(narrative)를 만들도록 설계되어 있기 때문입니다.
7-1. 패턴 인식 본능
진화적으로 인간은 "풀숲이 흔들렸다 → 포식자다"라는 빠른 인과 추론으로 생존했습니다.
틀려도 손해가 적고, 맞으면 목숨을 건집니다.
그래서 우리 뇌는 과도한 인과 부여 쪽으로 편향되어 있습니다.
7-2. 확증 편향과 서사 욕구
대니얼 카너먼은 이를 WYSIATI(What You See Is All There Is)라고 불렀습니다.
눈앞에 보이는 정보만으로 완결된 이야기를 만들고, 보이지 않는 변수는 아예 고려하지 않는 성향입니다.
"아이스크림 → 익사"는 이상하지만, "아침식사 → 성적"은 그럴듯해 보입니다.
그럴듯함은 인과의 증거가 아닙니다. 오히려 검증을 건너뛰게 만드는 가장 위험한 요소입니다.
7-3. 미디어와 인센티브
"상관관계가 관찰되었으나 인과는 불명확"이라는 제목은 클릭되지 않습니다.
"매일 커피 3잔, 수명 5년 연장!"이 훨씬 잘 팔립니다.
연구자 역시 예산과 게재 압박 속에서 결과를 강하게 표현할 유인을 갖습니다.
이런 구조적 압력을 이해하는 것도 데이터 리터러시의 일부입니다.
기사를 읽을 때의 3초 체크
· 관찰연구인가, 무작위 실험인가?
· 표본 크기와 대상은 누구인가?
· "연관", "관련", "~인 경향"이라는 단어가 쓰였는가?
· 절대위험인가, 상대위험인가? (위험이 2배라도 0.001%→0.002%일 수 있다)
✅ 8장. 그럼에도 상관관계는 쓸모 있다
여기서 중요한 균형을 잡아야 합니다.
"상관은 인과가 아니다"라는 말이 "상관은 쓸모없다"로 오해되어서는 안 됩니다.
8-1. 예측에는 상관이면 충분하다
아이스크림 판매량을 보고 오늘 해수욕장에 안전요원을 더 배치할지 결정하는 것은 합리적입니다.
왜냐하면 예측에는 인과가 필요 없기 때문입니다. 안정적인 상관이면 충분합니다.
머신러닝 모델의 대부분은 인과가 아니라 상관을 학습합니다.
그리고 그 상태로도 훌륭하게 작동합니다 — 환경이 변하지 않는 한.
8-2. 개입에는 반드시 인과가 필요하다
하지만 "아이스크림 판매를 금지한다"처럼 세상에 개입(intervention)하려는 순간,
상관만으로는 100% 실패합니다.
주디아 펄의 표현을 빌리면 이렇습니다.
전자는 '관찰'이고, 후자는 '개입'이다.
예측 모델은 전자로 충분하지만, 정책·전략·제품 개선은 반드시 후자를 요구합니다.
| 목적 | 필요한 것 | 예시 |
|---|---|---|
| 예측 (Prediction) | 안정적 상관 | 수요예측, 이탈 가능성 스코어링 |
| 설명 (Explanation) | 인과 구조 | 왜 고객이 이탈했는가 |
| 개입 (Intervention) | 인과 효과 추정 | 할인쿠폰을 주면 이탈이 줄까 |
8-3. 상관은 좋은 '출발점'이다
흡연과 폐암의 인과관계도 처음엔 단지 상관에서 출발했습니다.
거기서 용량-반응 관계를 확인하고, 동물실험으로 메커니즘을 규명하고,
여러 국가와 시대에서 일관성을 검증한 끝에 인과로 인정받았습니다.
상관은 가설 생성기이고, 인과는 검증의 결과물입니다.
문제는 상관이 아니라, 상관에서 검증 없이 곧바로 결론으로 점프하는 태도입니다.
🎬 에필로그 : 아이스크림은 무죄입니다
다시 처음의 그래프로 돌아가 봅시다.
두 선은 여전히 나란히 움직입니다. 상관계수도 여전히 0.9입니다.
데이터는 거짓말을 하지 않았습니다. 거짓말을 한 것은 우리의 해석이었습니다.
아이스크림은 사람을 물에 빠뜨리지 않습니다.
그저 여름이라는 거대한 배경 위에서, 익사 사고와 같은 시간을 살았을 뿐입니다.
🎯 오늘의 핵심 정리
· 상관계수는 직선 관계의 세기만 말할 뿐, 방향도 원인도 말하지 않는다
· 상관이 관찰되면 최소 6가지 설명 가능성을 떠올려라
· 교란변수(포크)는 통제하고, 콜라이더는 통제하지 마라
· 시간성은 인과의 유일한 필수 조건이다
· 예측에는 상관이면 되지만, 개입에는 인과가 필요하다
· 산점도를 먼저 그려라. 앤스컴을 기억하라
· 보고서에서는 "증가시켰다" 대신 "연관이 관찰되었다"를 쓰라
데이터가 넘쳐나는 시대에, 남들보다 앞서는 능력은
'더 많은 숫자를 다루는 것'이 아니라 '숫자가 말하지 않은 것을 알아채는 것'입니다.
다음에 누군가 "이 두 지표가 0.9로 붙어 움직입니다!"라고 흥분하며 말할 때,
당신은 조용히 이렇게 되물을 수 있게 되었습니다.
"그래서, 기온은 통제하셨나요?" 🍦
훌륭한 분석가는 그 패턴이 무엇을 의미하지 않는지까지 말할 수 있는 사람이다.

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.




아직 댓글이 없습니다.