Ver4.0 Swift 함수형 프로그래밍: 불변성과 순수함수 패턴을 실무 코드에 적용하는 방법
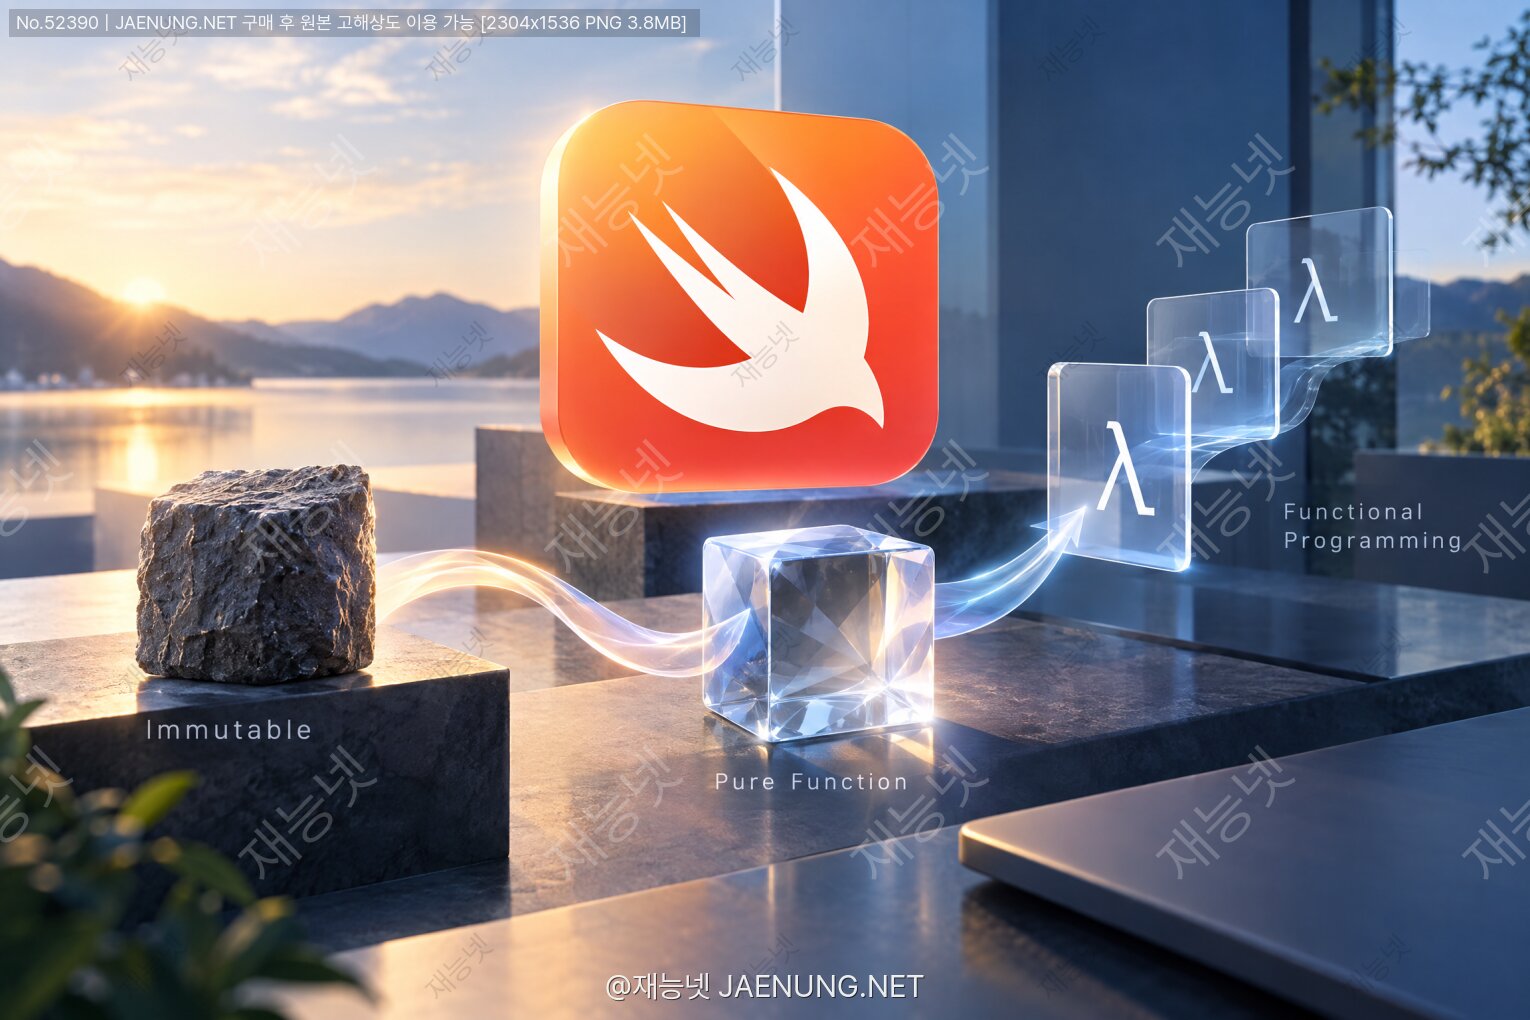
Swift 함수형 프로그래밍: 불변성과 순수함수 패턴을 실무 코드에 적용하는 방법
값 타입, 순수함수, 고차함수, 그리고 부작용 격리까지
C 계열 언어의 명령형 사고에서 출발해 Swift의 함수형 사고로 갈아타는 여정
들어가며: C의 포인터 세계에서 Swift의 값 세계로
C를 처음 배울 때 우리는 메모리 주소를 다루는 법을 배웁니다.
int *p = &x; 한 줄이 의미하는 건 "이 변수의 실제 위치를 알고 있으니, 언제든 값을 바꿀 수 있다"는 선언입니다.
이 방식은 강력합니다. 그리고 동시에 버그의 온상이기도 하죠.
함수에 포인터를 넘기는 순간, 그 함수가 내 데이터를 어떻게 훼손할지 알 수 없습니다.
C 개발자라면 누구나 한 번쯤 "도대체 누가 이 값을 바꿨지?" 하며 디버거를 붙잡고 새벽을 지새운 경험이 있을 겁니다.
Swift는 Apple이 2014년 WWDC에서 공개한 언어로, C와 Objective-C의 계보를 잇습니다.
하지만 설계 철학은 정반대 지점을 향하고 있습니다.
Swift는 "기본값은 안전하게, 변경은 명시적으로"라는 원칙 위에 세워졌습니다.
이 글에서는 Swift가 제공하는 함수형 프로그래밍 도구들을 하나씩 뜯어보며,
불변성(Immutability)과 순수함수(Pure Function)가 어떻게 실무 코드의 품질을 끌어올리는지 살펴봅니다.
1. 순수함수란 무엇인가: 수학적 정의와 코드적 현실
1-1. 두 가지 조건
순수함수는 딱 두 가지 조건을 만족하는 함수입니다.
① 참조 투명성(Referential Transparency)
같은 입력에 대해 항상 같은 출력을 반환합니다.
함수 호출을 그 결과값으로 치환해도 프로그램의 의미가 변하지 않습니다.
② 부작용 없음(No Side Effects)
함수 외부의 상태를 읽거나 변경하지 않습니다.
전역 변수 수정, 파일 I/O, 네트워크 요청, 콘솔 출력, 난수 생성, 현재 시각 조회 등이 모두 부작용입니다.
C 언어로 비교하면 이해가 빠릅니다.
/* C — 순수함수 */
int square(int x) {
    return x * x;
}

/* C — 불순함수: 전역 상태 의존 */
int counter = 0;
int nextId(void) {
    return ++counter;   /* 호출할 때마다 결과가 다르다 */
}

/* C — 불순함수: 인자를 통한 외부 상태 변경 */
void scale(int *arr, int n, int k) {
    for (int i = 0; i < n; i++) arr[i] *= k;  /* 원본 파괴 */
}
Swift에서 같은 개념을 표현하면 이렇습니다.
// Swift — 순수함수
func square(_ x: Int) -> Int {
    x * x
}

// Swift — 순수함수로 재작성한 scale
func scaled(_ array: [Int], by k: Int) -> [Int] {
    array.map { $0 * k }   // 새 배열 반환, 원본 불변
}

let original = [1, 2, 3]
let doubled  = scaled(original, by: 2)
// original은 여전히 [1, 2, 3]
차이는 명확합니다.
C 버전은 호출 이후 원본이 어떻게 되었는지 확인해야 합니다.
Swift 버전은 함수 시그니처만 보면 모든 것을 알 수 있습니다.
1-2. 순수함수가 주는 실질적 이득
| 이점 | 구체적 효과 |
|---|---|
| 테스트 용이성 | Mock, Stub, 셋업 코드 불필요. 입력 넣고 출력 비교로 끝 |
| 병렬 처리 안전 | 공유 상태가 없으므로 락(lock) 없이 동시 실행 가능 |
| 캐싱/메모이제이션 | 같은 입력 = 같은 출력이 보장되므로 결과 저장 가능 |
| 추론 가능성 | 함수 본문만 읽으면 동작 전체를 이해 가능 (지역적 추론) |
| 컴파일러 최적화 | 중복 호출 제거, 재배치 등 공격적 최적화 여지 확대 |
현실적 조언
프로그램 전체를 순수하게 만들 수는 없습니다.
화면을 그리고, DB에 쓰고, 서버와 통신하는 것이 결국 앱의 존재 이유니까요.
목표는 "순수한 핵심(Functional Core)과 얇은 불순한 껍질(Imperative Shell)"입니다.
2. Swift의 불변성 설계: let, var, 그리고 값 타입
2-1. let은 C의 const와 다르다
C의 const는 사실 "컴파일러에게 주는 힌트"에 가깝습니다.
포인터 캐스팅으로 얼마든지 우회할 수 있고, const char *와 char * const의 차이로 개발자를 괴롭히기도 하죠.
/* C — const 우회가 가능하다 */
const int x = 10;
int *p = (int *)&x;
*p = 20;   /* 정의되지 않은 동작(UB)이지만 컴파일은 통과 */
Swift의 let은 훨씬 강력합니다.
값 타입(struct, enum, tuple)에 let을 붙이면 내부 프로퍼티까지 전부 불변이 됩니다.
struct Point {
    var x: Double
    var y: Double
}

let p = Point(x: 1, y: 2)
// p.x = 5        // 컴파일 에러: Cannot assign to property
// p = Point(...) // 컴파일 에러: 'p' is a 'let' constant

var q = Point(x: 1, y: 2)
q.x = 5           // OK
주의: 참조 타입에서는 다르게 동작
let이 붙은 클래스 인스턴스는 참조 자체만 불변입니다.
내부 프로퍼티가 var라면 얼마든지 변경됩니다.
class Box { var value: Int = 0 }
let box = Box()
box.value = 42   // 허용됨!
// box = Box()   // 이것만 금지
2-2. 값 타입과 Copy-on-Write
"모든 걸 복사하면 성능이 죽지 않나요?"
Swift 팀도 같은 고민을 했고, 그 답이 COW(Copy-on-Write)입니다.
Array, Dictionary, Set, String 같은 표준 컬렉션은 내부적으로 힙 버퍼를 참조합니다.
대입만 했을 땐 버퍼를 공유하고, 실제로 쓰기가 발생하는 순간에만 복사가 일어납니다.
var a = [1, 2, 3, 4, 5]
var b = a            // 아직 복사 안 됨 (버퍼 공유, O(1))
b.append(6)          // 이 시점에 실제 복사 발생 (O(n))

// 참조 카운트 확인
print(isKnownUniquelyReferenced(&someRef))
직접 만든 구조체에도 COW를 구현할 수 있습니다.
final class Storage {
    var data: [Int]
    init(_ data: [Int]) { self.data = data }
    func copy() -> Storage { Storage(data) }
}

struct COWBuffer {
    private var storage: Storage

    init(_ data: [Int] = []) {
        storage = Storage(data)
    }

    var elements: [Int] { storage.data }

    mutating func append(_ value: Int) {
        // 공유 중이면 복사 후 수정
        if !isKnownUniquelyReferenced(&storage) {
            storage = storage.copy()
        }
        storage.data.append(value)
    }
}3. 고차함수: map, filter, reduce의 정확한 이해
3-1. C의 for 루프와 무엇이 다른가
C에서 배열 변환은 이렇게 작성합니다.
int src[5] = {1,2,3,4,5};
int dst[5];
int count = 0;
for (int i = 0; i < 5; i++) {
    if (src[i] % 2 == 0) {
        dst[count++] = src[i] * 10;
    }
}
인덱스 변수, 경계 조건, 카운터 관리가 모두 개발자 책임입니다.
off-by-one 에러가 나오기 딱 좋은 구조죠.
Swift에서는 무엇을 할지만 선언합니다.
let src = [1, 2, 3, 4, 5]
let dst = src.filter { $0 % 2 == 0 }
             .map { $0 * 10 }
// [20, 40]
3-2. 세 가지 핵심 연산
map — 각 원소를 변환. 개수 유지.
[A] → (A) -> B → [B]
filter — 조건에 맞는 원소만 선택. 개수 감소 가능.
[A] → (A) -> Bool → [A]
reduce — 전체를 하나의 값으로 접기(fold).
[A] → (초기값 B, (B, A) -> B) → B
struct Order {
    let id: String
    let amount: Int
    let isPaid: Bool
    let category: String
}

let orders = [
    Order(id: "A1", amount: 12000, isPaid: true,  category: "도서"),
    Order(id: "A2", amount: 45000, isPaid: false, category: "가전"),
    Order(id: "A3", amount:  8000, isPaid: true,  category: "도서"),
    Order(id: "A4", amount: 30000, isPaid: true,  category: "의류")
]

// 결제 완료 주문의 총액
let paidTotal = orders
    .filter(\.isPaid)
    .map(\.amount)
    .reduce(0, +)
// 50000

// 카테고리별 합계 — reduce(into:)로 성능 최적화
let byCategory = orders.reduce(into: [String: Int]()) { acc, order in
    acc[order.category, default: 0] += order.amount
}
// ["도서": 20000, "가전": 45000, "의류": 30000]
reduce vs reduce(into:)
일반 reduce는 매 단계마다 누적값을 복사합니다.
Dictionary나 Array처럼 큰 값을 누적할 땐 reduce(into:)가 inout으로 동작해 복사를 피합니다.
결과는 여전히 순수합니다. 외부 상태를 건드리지 않으니까요.
3-3. compactMap과 flatMap
let raw = ["10", "abc", "25", "", "7"]

// compactMap: nil 제거 + 언래핑
let numbers = raw.compactMap { Int($0) }
// [10, 25, 7]

// flatMap: 중첩 배열 평탄화
let nested = [[1, 2], [3, 4], [5]]
let flat = nested.flatMap { $0 }
// [1, 2, 3, 4, 5]

// Optional chaining의 함수형 표현
let userInput: String? = "42"
let doubled: Int? = userInput.flatMap { Int($0) }.map { $0 * 2 }
// Optional(84)
3-4. lazy로 중간 배열 제거
체이닝은 우아하지만, 각 단계마다 중간 배열이 생성됩니다.
데이터가 크다면 lazy로 평가를 지연시키세요.
let bigData = Array(1...1_000_000)

// 즉시 평가: filter 결과 배열 1개 + map 결과 배열 1개 생성
let eager = bigData.filter { $0 % 3 == 0 }.map { $0 * 2 }.prefix(5)

// 지연 평가: 필요한 5개만 계산, 중간 배열 없음
let lazyResult = Array(
    bigData.lazy.filter { $0 % 3 == 0 }.map { $0 * 2 }.prefix(5)
)lazy는 LazySequence 래퍼를 반환하며, 원소 요청 시점에 파이프라인을 통과시킵니다.
단, 짧은 컬렉션에서는 래퍼 오버헤드로 오히려 느려질 수 있으니 측정이 필수입니다.
4. 불변 데이터 모델링 실전 패턴
4-1. with 패턴 (Functional Update)
불변 구조체를 쓰다 보면 "하나만 바꾼 새 인스턴스"가 자주 필요합니다.
매번 전체 이니셜라이저를 호출하는 건 고통스럽죠.
struct UserProfile {
    let id: UUID
    let nickname: String
    let bio: String
    let followerCount: Int
    let isVerified: Bool

    func with(
        nickname: String? = nil,
        bio: String? = nil,
        followerCount: Int? = nil,
        isVerified: Bool? = nil
    ) -> UserProfile {
        UserProfile(
            id: self.id,
            nickname: nickname ?? self.nickname,
            bio: bio ?? self.bio,
            followerCount: followerCount ?? self.followerCount,
            isVerified: isVerified ?? self.isVerified
        )
    }
}

let base = UserProfile(
    id: UUID(), nickname: "swifty", bio: "iOS 개발자",
    followerCount: 120, isVerified: false
)

let promoted = base
    .with(followerCount: 121)
    .with(isVerified: true)
한계
이 패턴은 Optional 프로퍼티를 nil로 바꿀 수 없습니다.
nil이 "변경 없음"과 "nil로 설정"을 구분하지 못하기 때문입니다.
해결책은 별도 enum 래퍼를 만들거나, KeyPath 기반 업데이트를 사용하는 것입니다.
4-2. KeyPath 기반 불변 업데이트
extension UserProfile {
    func setting<V>(_ keyPath: WritableKeyPath<UserProfile, V>,
                    to value: V) -> UserProfile {
        var copy = self
        copy[keyPath: keyPath] = value
        return copy
    }
}
// 단, 프로퍼티를 var로 선언해야 WritableKeyPath 사용 가능
여기서 트레이드오프가 생깁니다.
프로퍼티를 var로 두되 인스턴스를 let으로 보관하면,
외부에서는 불변이지만 내부 복사 수정은 간편해집니다.
Swift 커뮤니티에서 널리 쓰이는 절충안입니다.
4-3. 대수적 데이터 타입으로 상태 표현
함수형 프로그래밍의 강력한 무기는 enum with associated values입니다.
"불가능한 상태를 표현 불가능하게 만드는(Make Impossible States Impossible)" 기법이죠.
// 나쁜 예 — 모순된 상태가 가능
struct BadState {
    var isLoading: Bool
    var data: [String]?
    var error: Error?
    // isLoading=true인데 error도 있다면? 정의되지 않음
}

// 좋은 예 — 상태가 서로 배타적임이 타입으로 보장
enum LoadState<T> {
    case idle
    case loading
    case loaded(T)
    case failed(Error)
}

func render(_ state: LoadState<[String]>) -> String {
    switch state {
    case .idle:            return "대기 중"
    case .loading:         return "불러오는 중…"
    case .loaded(let items): return "\(items.count)건 로드됨"
    case .failed(let e):   return "오류: \(e.localizedDescription)"
    }
}
컴파일러가 switch의 망라성(exhaustiveness)을 검사해줍니다.
새 케이스를 추가하면 처리하지 않은 모든 지점에서 컴파일 에러가 발생하죠.
C의 switch에서 default로 대충 넘기던 것과는 차원이 다른 안전망입니다.
5. Functional Core, Imperative Shell 아키텍처
이 패턴은 Gary Bernhardt가 제안한 구조로,
비즈니스 로직은 순수하게, 외부 세계와의 접점은 얇게 유지하는 설계입니다.
5-1. 리팩터링 전후 비교
주문 할인 계산 로직을 예로 들어보겠습니다.
// ❌ Before — 로직과 부작용이 뒤엉킴
class OrderService {
    var currentUser: User?
    let db: Database
    let logger: Logger

    func applyDiscount(orderId: String) {
        guard let order = db.fetchOrder(orderId) else { return }
        guard let user = currentUser else { return }

        var rate = 0.0
        if user.isVIP { rate += 0.10 }
        if order.amount >= 50_000 { rate += 0.05 }
        if Calendar.current.component(.month, from: Date()) == 12 {
            rate += 0.03   // 연말 프로모션
        }

        let discounted = Int(Double(order.amount) * (1 - rate))
        db.updateOrder(orderId, amount: discounted)
        logger.log("할인 적용: \(rate)")
    }
}
이 코드를 테스트하려면 DB 목업, 로거 목업, 심지어 시스템 시간까지 조작해야 합니다.
12월에만 통과하는 테스트를 만들고 싶진 않겠죠.
// ✅ After — 순수 코어 분리

// 1) 입력을 명시적 값으로 모델링
struct DiscountContext {
    let isVIP: Bool
    let amount: Int
    let month: Int
}

struct DiscountResult {
    let rate: Double
    let finalAmount: Int
    let appliedRules: [String]
}

// 2) 순수함수: 외부 의존 0
func calculateDiscount(_ ctx: DiscountContext) -> DiscountResult {
    var rate = 0.0
    var rules: [String] = []

    if ctx.isVIP {
        rate += 0.10
        rules.append("VIP")
    }
    if ctx.amount >= 50_000 {
        rate += 0.05
        rules.append("고액구매")
    }
    if ctx.month == 12 {
        rate += 0.03
        rules.append("연말프로모션")
    }

    let capped = min(rate, 0.30)   // 최대 30% 제한
    return DiscountResult(
        rate: capped,
        finalAmount: Int(Double(ctx.amount) * (1 - capped)),
        appliedRules: rules
    )
}

// 3) 얇은 껍질: 부작용만 담당
final class OrderService {
    private let db: Database
    private let logger: Logger
    private let clock: () -> Date

    init(db: Database, logger: Logger, clock: @escaping () -> Date = Date.init) {
        self.db = db
        self.logger = logger
        self.clock = clock
    }

    func applyDiscount(orderId: String, user: User) throws {
        guard let order = db.fetchOrder(orderId) else {
            throw OrderError.notFound
        }
        let ctx = DiscountContext(
            isVIP: user.isVIP,
            amount: order.amount,
            month: Calendar.current.component(.month, from: clock())
        )
        let result = calculateDiscount(ctx)      // 순수 호출
        db.updateOrder(orderId, amount: result.finalAmount)
        logger.log("할인 \(result.rate) · 규칙 \(result.appliedRules)")
    }
}
이제 테스트는 이렇게 단순해집니다.
func testVIPDecemberHighAmount() {
    let ctx = DiscountContext(isVIP: true, amount: 100_000, month: 12)
    let r = calculateDiscount(ctx)

    XCTAssertEqual(r.rate, 0.18, accuracy: 0.0001)
    XCTAssertEqual(r.finalAmount, 82_000)
    XCTAssertEqual(r.appliedRules, ["VIP", "고액구매", "연말프로모션"])
}

func testDiscountCap() {
    // 규칙이 아무리 쌓여도 30% 초과 불가
    let ctx = DiscountContext(isVIP: true, amount: 1_000_000, month: 12)
    XCTAssertLessThanOrEqual(calculateDiscount(ctx).rate, 0.30)
}
목업 하나 없이, 셋업 코드 없이, 밀리초 단위로 실행되는 테스트가 완성됩니다.
이것이 순수함수의 실질적 가치입니다.
6. 함수 합성과 커링
6-1. 합성 연산자 정의
Swift는 커스텀 연산자를 지원하므로 함수 합성을 직접 만들 수 있습니다.
infix operator >>>: AdditionPrecedence

func >>> <A, B, C>(
    _ f: @escaping (A) -> B,
    _ g: @escaping (B) -> C
) -> (A) -> C {
    { a in g(f(a)) }
}

let trim: (String) -> String = { $0.trimmingCharacters(in: .whitespaces) }
let lower: (String) -> String = { $0.lowercased() }
let removeSpace: (String) -> String = { $0.replacingOccurrences(of: " ", with: "") }

let normalize = trim >>> lower >>> removeSpace

normalize("  Hello World  ")   // "helloworld"
실무 조언
커스텀 연산자는 팀 컨벤션이 확실할 때만 쓰세요.
가독성을 해칠 수 있으므로, 단순히 compose(f, g) 함수로 두는 편이 안전한 경우도 많습니다.
6-2. 커링(Currying)과 부분 적용
// 일반 함수
func makeTag(_ name: String, _ content: String) -> String {
    "<\(name)>\(content)</\(name)>"
}

// 커링된 버전
func curriedTag(_ name: String) -> (String) -> String {
    { content in "<\(name)>\(content)</\(name)>" }
}

let bold = curriedTag("b")
let italic = curriedTag("i")

bold("중요")      // "<b>중요</b>"
italic("강조")    // "<i>강조</i>"

// 파이프라인에 그대로 투입 가능
let words = ["하나", "둘", "셋"]
let tagged = words.map(bold)
6-3. 검증 로직 조합
커링과 합성을 결합하면 재사용 가능한 검증기를 만들 수 있습니다.
enum ValidationResult {
    case valid
    case invalid([String])

    var errors: [String] {
        if case .invalid(let e) = self { return e }
        return []
    }
}

typealias Validator<T> = (T) -> ValidationResult

func minLength(_ n: Int) -> Validator<String> {
    { s in s.count >= n ? .valid : .invalid(["\(n)자 이상 입력하세요"]) }
}

func contains(_ set: CharacterSet, message: String) -> Validator<String> {
    { s in
        s.rangeOfCharacter(from: set) != nil ? .valid : .invalid([message])
    }
}

func combine<T>(_ validators: Validator<T>...) -> Validator<T> {
    { value in
        let allErrors = validators.flatMap { $0(value).errors }
        return allErrors.isEmpty ? .valid : .invalid(allErrors)
    }
}

let passwordValidator = combine(
    minLength(8),
    contains(.decimalDigits, message: "숫자를 포함하세요"),
    contains(.uppercaseLetters, message: "대문자를 포함하세요")
)

passwordValidator("abc")
// .invalid(["8자 이상 입력하세요", "숫자를 포함하세요", "대문자를 포함하세요"])
각 검증기는 완전한 순수함수이므로 단독 테스트가 가능하고,
조합 방식만 바꿔 다양한 정책을 만들어낼 수 있습니다.
7. 동시성과 불변성: Sendable, actor, Strict Concurrency
7-1. 데이터 경합의 근원
C에서 멀티스레드 프로그램을 짜본 사람은 압니다.
pthread_mutex_lock을 어디에 걸어야 하는지, 데드락은 어떻게 피하는지.
데이터 경합(data race)이 발생하는 조건은 셋입니다.
① 여러 스레드가 같은 메모리에 접근
② 그중 최소 하나가 쓰기 작업
③ 동기화 메커니즘 부재
불변 데이터는 ②를 원천 차단합니다.
아무도 쓰지 않으면, 락도 필요 없습니다.
7-2. Sendable 프로토콜
Swift 5.5부터 도입된 Sendable은 "동시성 도메인 간 안전하게 전달 가능"을 표시하는 마커 프로토콜입니다.
// 값 타입 + 모든 프로퍼티가 Sendable → 자동 준수
struct Coordinate: Sendable {
    let lat: Double
    let lng: Double
}

// 클래스는 기본적으로 non-Sendable
// 불변이고 final이면 명시적으로 표시 가능
final class Configuration: Sendable {
    let apiKey: String
    let timeout: TimeInterval
    init(apiKey: String, timeout: TimeInterval) {
        self.apiKey = apiKey
        self.timeout = timeout
    }
}

// 가변 상태가 있으면 @unchecked Sendable + 직접 동기화
final class Counter: @unchecked Sendable {
    private let lock = NSLock()
    private var value = 0

    func increment() {
        lock.lock(); defer { lock.unlock() }
        value += 1
    }
}
Swift 6 언어 모드에서는 Strict Concurrency Checking이 기본 활성화됩니다.
non-Sendable 타입을 동시성 경계 너머로 넘기면 컴파일 에러가 발생하죠.
컴파일 타임에 데이터 경합을 잡아내는, 주류 언어로서는 드문 시도입니다.
7-3. actor와 불변 값의 조합
actor ImageCache {
    private var storage: [URL: Data] = [:]

    func image(for url: URL) -> Data? {
        storage[url]
    }

    func store(_ data: Data, for url: URL) {
        storage[url] = data
    }

    // 스냅샷 반환 — 값 타입이므로 밖으로 나가도 안전
    func snapshot() -> [URL: Data] {
        storage   // Dictionary는 값 타입, 복사되어 전달
    }
}

// 사용
let cache = ImageCache()
Task {
    await cache.store(imageData, for: url)
    let snap = await cache.snapshot()   // 이 시점의 불변 사본
}
actor 내부는 직렬화되어 안전하지만, 밖으로 내보내는 데이터가 참조 타입이면 다시 위험해집니다.
값 타입 중심 설계가 actor의 안전성을 완성시키는 이유입니다.
8. SwiftUI와 단방향 데이터 흐름
SwiftUI는 선언형 UI의 대표 주자이며, 함수형 사고와 궁합이 좋습니다.
핵심 아이디어는 View = f(State), 즉 뷰는 상태의 순수함수라는 것입니다.
struct TodoState: Equatable {
    var items: [TodoItem]
    var filter: Filter

    enum Filter: Equatable { case all, active, completed }

    // 파생 상태는 계산 프로퍼티로 — 중복 저장 금지
    var visibleItems: [TodoItem] {
        switch filter {
        case .all:       return items
        case .active:    return items.filter { !$0.isDone }
        case .completed: return items.filter { $0.isDone }
        }
    }

    var remainingCount: Int {
        items.lazy.filter { !$0.isDone }.count
    }
}
8-1. Reducer 패턴
Redux에서 유래한 이 패턴은 상태 변경을 순수함수 하나로 집약합니다.
enum TodoAction {
    case add(String)
    case toggle(UUID)
    case delete(UUID)
    case setFilter(TodoState.Filter)
}

// (State, Action) -> State — 완전한 순수함수
func todoReducer(_ state: TodoState, _ action: TodoAction) -> TodoState {
    var next = state
    switch action {
    case .add(let title):
        let trimmed = title.trimmingCharacters(in: .whitespaces)
        guard !trimmed.isEmpty else { return state }
        next.items.append(TodoItem(id: UUID(), title: trimmed, isDone: false))

    case .toggle(let id):
        next.items = state.items.map { item in
            item.id == id ? item.with(isDone: !item.isDone) : item
        }

    case .delete(let id):
        next.items = state.items.filter { $0.id != id }

    case .setFilter(let f):
        next.filter = f
    }
    return next
}
이 리듀서는 어떤 UI 프레임워크에도 의존하지 않습니다.
순수한 로직이므로 커맨드라인에서도, 서버에서도, 테스트에서도 그대로 돌아갑니다.
// 시나리오 테스트가 매우 직관적
func testTodoFlow() {
    var s = TodoState(items: [], filter: .all)

    s = todoReducer(s, .add("우유 사기"))
    s = todoReducer(s, .add("   "))          // 무시되어야 함
    XCTAssertEqual(s.items.count, 1)

    let id = s.items[0].id
    s = todoReducer(s, .toggle(id))
    XCTAssertTrue(s.items[0].isDone)
    XCTAssertEqual(s.remainingCount, 0)

    s = todoReducer(s, .setFilter(.active))
    XCTAssertTrue(s.visibleItems.isEmpty)
}
8-2. 값 타입과 SwiftUI 성능
SwiftUI는 상태가 바뀌면 뷰 트리를 다시 계산합니다.
이때 Equatable을 준수하는 값 타입이라면 구조적 동등성 비교로 불필요한 렌더링을 건너뜁니다.
struct ItemRow: View, Equatable {
    let item: TodoItem

    var body: some View {
        HStack {
            Text(item.title)
            Spacer()
            if item.isDone { Image(systemName: "checkmark") }
        }
    }

    static func == (l: ItemRow, r: ItemRow) -> Bool {
        l.item == r.item
    }
}

// 사용 시
ItemRow(item: item).equatable()
클래스 기반 모델이었다면 참조 비교만 가능해 이런 최적화가 어렵습니다.
불변성이 성능 최적화의 전제 조건이 되는 좋은 사례죠.
9. 성능 고려사항: 언제 함수형이 손해인가
함수형 스타일이 만능은 아닙니다.
실제 측정 없이 "우아하니까"라는 이유로 적용하면 성능 저하를 겪을 수 있습니다.
| 상황 | 문제 | 대응 |
|---|---|---|
| 대용량 배열 다단계 체이닝 | 단계마다 중간 배열 힙 할당 | lazy 사용 또는 단일 reduce(into:)로 통합 |
| 큰 구조체의 잦은 복사 | 스택 복사 비용 증가 | COW 적용 또는 참조 타입 검토 |
| 재귀 기반 알고리즘 | Swift는 꼬리재귀 최적화 미보장 | 반복문으로 변환 |
| 클로저 남용 | @escaping 클로저의 힙 할당·ARC 부하 | 비탈출 클로저 활용, @inlinable 고려 |
| 프로토콜 기반 추상화 과다 | 동적 디스패치, 실존 컨테이너 박싱 | 제네릭으로 정적 디스패치 유도, some/any 구분 |
9-1. 실측이 먼저다
import Foundation

func measure(_ label: String, _ block: () -> Void) {
    let start = DispatchTime.now().uptimeNanoseconds
    block()
    let elapsed = DispatchTime.now().uptimeNanoseconds - start
    print("\(label): \(Double(elapsed) / 1_000_000) ms")
}

let data = Array(1...5_000_000)

measure("chain") {
    _ = data.filter { $0 % 2 == 0 }.map { $0 * 2 }.reduce(0, +)
}

measure("single-pass") {
    _ = data.reduce(0) { acc, x in x % 2 == 0 ? acc + x * 2 : acc }
}

measure("imperative") {
    var sum = 0
    for x in data where x % 2 == 0 { sum += x * 2 }
    _ = sum
}
중요한 전제
반드시 -O(Release) 빌드에서 측정하세요.
Debug 빌드에서는 인라이닝과 특수화(specialization)가 꺼져 있어
함수형 코드가 실제보다 훨씬 느리게 측정됩니다.
릴리스 빌드에서는 상당수 오버헤드가 컴파일러에 의해 제거됩니다.
9-2. 불변성의 숨은 이득
단순 벤치마크에서는 명령형이 빠를 수 있습니다.
하지만 시스템 전체 관점에서는 다른 그림이 나옵니다.
· 락 경합 제거로 멀티코어 확장성 확보
· 방어적 복사(defensive copy) 코드가 불필요해짐
· 캐시 무효화 로직 단순화 — 값이 다르면 새 객체
· Undo/Redo, 시간여행 디버깅이 거의 공짜로 구현됨
· 버그 재현이 쉬워져 디버깅 시간 대폭 단축
재능넷의 '지식인의 숲'에 올라오는 Swift 관련 글들을 보면,
초급 개발자들이 가장 많이 겪는 문제가 "왜 값이 바뀌었는지 모르겠다"는 상황입니다.
불변성은 그 질문 자체를 없애버립니다.
10. C 개발자를 위한 전환 가이드
C의 사고방식에 익숙하다면, 다음 대응표가 도움이 될 것입니다.
| C 관용구 | Swift 함수형 대안 | 핵심 차이 |
|---|---|---|
void f(int *out) | func f() -> Int | 출력 파라미터 대신 반환값 |
errno 전역 | throws / Result<T, E> | 에러가 타입에 명시됨 |
NULL 반환 | Optional<T> | 컴파일러가 nil 처리 강제 |
| 구조체 포인터 전달 | 값 타입 + COW | 의도치 않은 변경 방지 |
| 함수 포인터 | 클로저 / 일급 함수 | 캡처 가능, 타입 안전 |
union + 태그 | enum + associated value | 망라성 검사 지원 |
| 매크로 다형성 | 제네릭 + 프로토콜 | 타입 검사 통과 |
qsort 콜백 | sorted(by:) | 원본 불변, 새 배열 반환 |
10-1. Result 타입으로 에러 다루기
C에서는 반환 코드와 실제 값을 분리해서 다뤄야 했습니다.
/* C */
int parse_config(const char *path, Config *out);
/* 0 = 성공, 음수 = 에러코드 */
Swift에서는 성공과 실패를 하나의 값으로 묶습니다.
enum ParseError: Error {
    case fileNotFound(String)
    case malformed(line: Int)
}

func parseConfig(_ text: String) -> Result<[String: String], ParseError> {
    var dict: [String: String] = [:]
    for (i, line) in text.split(separator: "\n").enumerated() {
        if line.hasPrefix("#") || line.isEmpty { continue }
        let parts = line.split(separator: "=", maxSplits: 1)
        guard parts.count == 2 else {
            return .failure(.malformed(line: i + 1))
        }
        dict[String(parts[0]).trimmingCharacters(in: .whitespaces)]
            = String(parts[1]).trimmingCharacters(in: .whitespaces)
    }
    return .success(dict)
}

// Result도 map/flatMap을 지원 — 체이닝 가능
let port = parseConfig(configText)
    .map { $0["port"] ?? "8080" }
    .flatMap { str -> Result<Int, ParseError> in
        guard let n = Int(str) else { return .failure(.malformed(line: 0)) }
        return .success(n)
    }
이 함수는 완전한 순수함수입니다.
파일 읽기(부작용)는 호출자가 담당하고, 파싱 로직만 순수하게 분리했습니다.
덕분에 문자열만 넣어 모든 엣지 케이스를 테스트할 수 있죠.
10-2. 점진적 도입 로드맵
1단계 — let 우선
모든 var를 let으로 바꿔보고, 컴파일이 실패하는 곳만 되돌립니다.
SwiftLint의 prefer_let 계열 규칙을 CI에 걸어두면 자동화됩니다.
2단계 — 루프를 고차함수로
단순 변환/필터/집계 루프부터 map/filter/reduce로 교체합니다.
복잡한 루프는 억지로 바꾸지 마세요.
3단계 — 계산 로직 추출
클래스 메서드 안의 계산 부분을 자유 함수나 static 함수로 분리합니다.
의존성이 없어지면 자동으로 순수해집니다.
4단계 — 상태 모델을 값 타입으로
도메인 모델을 struct/enum으로 전환하고 Equatable을 준수시킵니다.
5단계 — Reducer / Core-Shell 구조 정착
아키텍처 수준에서 순수 영역과 부작용 영역을 분리합니다.
11. 흔한 실수와 안티패턴
11-1. "순수해 보이지만 순수하지 않은" 함수
// ❌ 겉보기엔 순수하지만 Date()가 숨어있음
func isExpired(_ token: Token) -> Bool {
    token.expiresAt < Date()
}

// ✅ 시간을 명시적 입력으로
func isExpired(_ token: Token, at now: Date) -> Bool {
    token.expiresAt < now
}

// ❌ 난수 — 호출마다 다른 결과
func pickWinner(_ users: [User]) -> User? {
    users.randomElement()
}

// ✅ 난수 생성기를 주입
func pickWinner<G: RandomNumberGenerator>(
    _ users: [User], using gen: inout G
) -> User? {
    users.randomElement(using: &gen)
}
숨은 부작용 체크리스트
Date() · UUID() · random · UserDefaults ·
print · 싱글턴 접근 · Locale.current · FileManager ·
전역 캐시 · 정적 가변 프로퍼티
11-2. 과도한 추상화
// ❌ 읽기 어려운 과잉 함수형
let result = items
    .compactMap(transform >>> validate >>> normalize)
    .reduce(into: [:]) { $0[$1.key, default: []].append($1) }
    .mapValues { $0.sorted(by: comparator) }
    .filter { $0.value.count > threshold }

// ✅ 중간 단계에 이름을 붙여 의도를 드러냄
let processed = items.compactMap(processItem)
let grouped = Dictionary(grouping: processed, by: \.key)
let sorted = grouped.mapValues { $0.sorted(by: comparator) }
let result = sorted.filter { $0.value.count > threshold }
함수형 스타일의 목적은 가독성과 안전성이지, 코드 줄 수 줄이기가 아닙니다.
한 줄에 다섯 단계를 우겨넣는 순간 원래 목적을 잃습니다.
11-3. 불변성의 오해
// ❌ let 배열 안에 클래스를 넣으면 불변이 아님
class Mutable { var n = 0 }
let list = [Mutable(), Mutable()]
list[0].n = 99      // 변경됨!

// ✅ 값 타입으로 구성
struct Immutable { let n: Int }
let safeList = [Immutable(n: 0), Immutable(n: 1)]
// safeList[0].n = 99   // 컴파일 에러
깊은 불변성(deep immutability)은 컨테이너와 원소 모두가 불변일 때만 성립합니다.
C에서 const struct 안에 일반 포인터가 있으면 가리키는 대상은 수정 가능한 것과 같은 원리입니다.
11-4. 성능 맹신
// ❌ O(n²) 함정 — 문자열 연결
let joined = words.reduce("") { $0 + $1 + ", " }

// ✅ 전용 API 사용 — O(n)
let joined = words.joined(separator: ", ")

// ❌ 배열 앞쪽 삽입 반복 — O(n²)
let reversed = items.reduce([Int]()) { [$1] + $0 }

// ✅ 표준 API
let reversed = Array(items.reversed())
12. 종합 예제: 로그 분석 파이프라인
지금까지의 개념을 한 곳에 모아보겠습니다.
서버 로그를 파싱해 통계를 내는 파이프라인입니다.
import Foundation

// ── 도메인 모델 (전부 불변 값 타입) ──────────────────

struct LogEntry: Equatable {
    let timestamp: Date
    let level: Level
    let endpoint: String
    let durationMs: Int
    let statusCode: Int

    enum Level: String, Equatable {
        case debug, info, warning, error
    }

    var isSlow: Bool { durationMs > 1000 }
    var isFailure: Bool { statusCode >= 400 }
}

struct AnalysisReport: Equatable {
    let totalCount: Int
    let errorRate: Double
    let avgDurationMs: Double
    let p95DurationMs: Int
    let slowestEndpoints: [(String, Int)]
    let statusDistribution: [Int: Int]

    static func == (l: AnalysisReport, r: AnalysisReport) -> Bool {
        l.totalCount == r.totalCount && l.errorRate == r.errorRate
    }
}

// ── 순수 파싱 계층 ────────────────────────────────

enum LogParseError: Error, Equatable {
    case fieldCountMismatch(expected: Int, got: Int)
    case invalidTimestamp(String)
    case unknownLevel(String)
}

func parseLine(
    _ line: String,
    formatter: ISO8601DateFormatter
) -> Result<LogEntry, LogParseError> {
    // 형식: 2024-01-15T10:30:00Z|info|/api/users|245|200
    let parts = line.split(separator: "|").map(String.init)

    guard parts.count == 5 else {
        return .failure(.fieldCountMismatch(expected: 5, got: parts.count))
    }
    guard let date = formatter.date(from: parts[0]) else {
        return .failure(.invalidTimestamp(parts[0]))
    }
    guard let level = LogEntry.Level(rawValue: parts[1]) else {
        return .failure(.unknownLevel(parts[1]))
    }

    return .success(LogEntry(
        timestamp: date,
        level: level,
        endpoint: parts[2],
        durationMs: Int(parts[3]) ?? 0,
        statusCode: Int(parts[4]) ?? 0
    ))
}

// ── 순수 분석 계층 ────────────────────────────────

func percentile(_ sorted: [Int], _ p: Double) -> Int {
    guard !sorted.isEmpty else { return 0 }
    let idx = Int((Double(sorted.count - 1) * p).rounded())
    return sorted[idx]
}

func analyze(_ entries: [LogEntry], topN: Int = 3) -> AnalysisReport {
    guard !entries.isEmpty else {
        return AnalysisReport(
            totalCount: 0, errorRate: 0, avgDurationMs: 0,
            p95DurationMs: 0, slowestEndpoints: [], statusDistribution: [:]
        )
    }

    let durations = entries.map(\.durationMs).sorted()
    let failureCount = entries.filter(\.isFailure).count

    // 엔드포인트별 최대 소요 시간
    let maxByEndpoint = entries.reduce(into: [String: Int]()) { acc, e in
        acc[e.endpoint] = max(acc[e.endpoint] ?? 0, e.durationMs)
    }

    let slowest = maxByEndpoint
        .sorted { $0.value > $1.value }
        .prefix(topN)
        .map { ($0.key, $0.value) }

    let statusDist = entries.reduce(into: [Int: Int]()) { acc, e in
        acc[e.statusCode, default: 0] += 1
    }

    return AnalysisReport(
        totalCount: entries.count,
        errorRate: Double(failureCount) / Double(entries.count),
        avgDurationMs: Double(durations.reduce(0, +)) / Double(durations.count),
        p95DurationMs: percentile(durations, 0.95),
        slowestEndpoints: Array(slowest),
        statusDistribution: statusDist
    )
}

// ── 불순한 껍질 ──────────────────────────────────

struct LogAnalyzer {
    let fileURL: URL
    let formatter = ISO8601DateFormatter()

    func run() throws -> (report: AnalysisReport, errors: [LogParseError]) {
        // 부작용: 파일 읽기
        let content = try String(contentsOf: fileURL, encoding: .utf8)

        // 여기서부터는 전부 순수
        let results = content
            .split(separator: "\n")
            .map { parseLine(String($0), formatter: formatter) }

        var entries: [LogEntry] = []
        var errors: [LogParseError] = []

        for r in results {
            switch r {
            case .success(let e): entries.append(e)
            case .failure(let err): errors.append(err)
            }
        }

        return (analyze(entries), errors)
    }
}
구조를 다시 정리하면 이렇습니다.
parseLine — 순수. 문자열 하나를 넣으면 Result가 나옴
analyze — 순수. 엔트리 배열을 넣으면 리포트가 나옴
percentile — 순수. 수학 계산만 수행
LogAnalyzer.run — 불순. 파일 I/O만 담당하고 나머지는 위임
테스트는 파일 없이 가능합니다.
func testAnalyzeErrorRate() {
    let now = Date()
    let entries = [
        LogEntry(timestamp: now, level: .info, endpoint: "/a",
                 durationMs: 100, statusCode: 200),
        LogEntry(timestamp: now, level: .error, endpoint: "/b",
                 durationMs: 2500, statusCode: 500),
        LogEntry(timestamp: now, level: .info, endpoint: "/a",
                 durationMs: 150, statusCode: 404)
    ]
    let r = analyze(entries)

    XCTAssertEqual(r.totalCount, 3)
    XCTAssertEqual(r.errorRate, 2.0/3.0, accuracy: 0.0001)
    XCTAssertEqual(r.slowestEndpoints.first?.0, "/b")
}

func testParseLineMalformed() {
    let f = ISO8601DateFormatter()
    let result = parseLine("bad|data", formatter: f)
    XCTAssertEqual(result, .failure(.fieldCountMismatch(expected: 5, got: 2)))
}
13. 정리: 무엇을 가져갈 것인가
핵심 원칙 정리
1. 기본은 let, 필요할 때만 var
변경 가능성은 비용입니다. 필요한 곳에만 지불하세요.
2. 데이터는 값 타입, 정체성이 필요할 때만 참조 타입
"이것이 무엇인가"는 struct, "이것이 누구인가"는 class.
3. 의사결정은 순수하게, 실행은 껍질에서
계산과 효과를 분리하면 테스트 가능 영역이 폭발적으로 늘어납니다.
4. 불가능한 상태를 표현 불가능하게
enum과 associated value로 모순된 상태를 타입 레벨에서 제거하세요.
5. 숨은 입력을 명시적 파라미터로
시간, 난수, 환경 변수는 인자로 받으면 순수해집니다.
6. 측정하고 최적화하라
Release 빌드에서 벤치마크한 뒤 판단하세요. 추측은 금물입니다.
함수형 프로그래밍은 종교가 아닙니다.
Swift는 멀티 패러다임 언어이고, 객체지향과 명령형도 훌륭하게 지원합니다.
중요한 것은 각 도구의 특성을 이해하고 적절한 곳에 쓰는 판단력입니다.
C에서 포인터를 다룰 때 신중했던 것처럼,
Swift에서 가변 상태를 만들 때도 같은 무게의 고민이 필요합니다.
재능넷 '지식인의 숲'에서 다루는 다른 개발 콘텐츠들과 함께,
이 글이 여러분의 코드베이스를 조금 더 예측 가능한 곳으로 만드는 데 도움이 되기를 바랍니다.
다음 학습 방향
· Swift Evolution 제안서 SE-0302(Sendable), SE-0306(Actors) 원문 읽기
· Point-Free의 Composable Architecture 소스 코드 분석
· Haskell이나 Elm으로 순수 함수형 언어의 사고방식 체험
· Swift 표준 라이브러리의 Sequence/Collection 프로토콜 구현부 탐독
관련 키워드
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.