Ver4.0 파이썬으로 이메일 분류 AI 시스템 만들기: 데이터 수집부터 모델 학습, 서비스 배포까지
파이썬으로 이메일 분류 AI 시스템 만들기: 데이터 수집부터 모델 학습, 서비스 배포까지
스팸이냐 아니냐, 그것이 문제로다. 하루 3,000억 통이 오가는 메일 바다에서
내 받은편지함을 지키는 작은 인공지능을 직접 빚어봅니다.
1. 왜 아직도 '이메일 분류'인가
딥러닝이 그림도 그리고 영상도 만드는 시대에 이메일 분류라니, 조금 촌스럽게 들릴 수 있습니다.
하지만 텍스트 분류(Text Classification)는 여전히 실무 머신러닝에서 가장 많이 배포되는 과제입니다.
이유는 단순합니다. 비용 대비 효과가 압도적이기 때문이죠.
고객센터 문의 메일을 '환불 / 배송 / 기술문의'로 자동 라우팅하면 응답 시간이 절반으로 줄고,
피싱 메일 한 통을 걸러내면 기업 보안 사고 한 건을 막습니다.
게다가 이메일 분류는 머신러닝의 전 과정을 압축해서 배울 수 있는 완벽한 교보재입니다.
전처리, 벡터화, 모델 선택, 불균형 데이터 처리, 평가 지표, 배포, 드리프트 모니터링까지
하나도 빠짐없이 등장하거든요.
이 글의 목표
① 나이브 베이즈부터 트랜스포머까지 단계별 구현
② 정확도(Accuracy)에 속지 않는 평가 설계
③ FastAPI로 실제 서비스화하는 구조까지
2. 전체 파이프라인 한눈에 보기
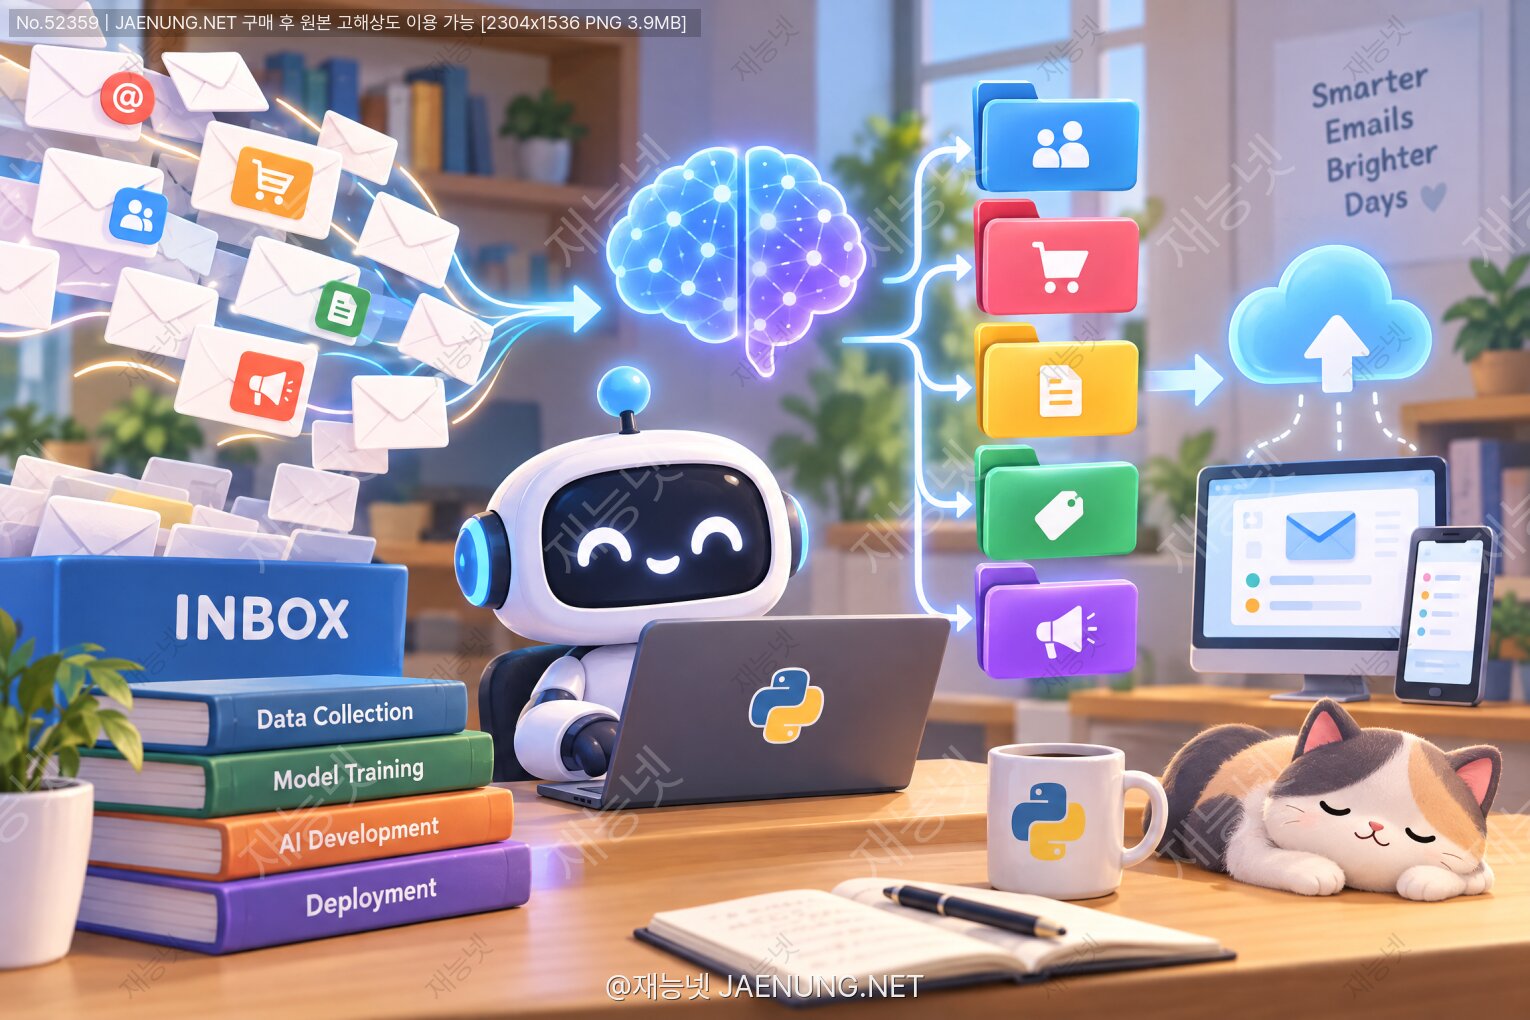
코드를 쓰기 전에 지도를 먼저 그립니다. 머신러닝 프로젝트의 8할은 설계입니다.
이 그림에서 가장 중요한 부분은 오른쪽 아래의 점선입니다.
모델은 한 번 만들고 끝나는 조각상이 아니라, 계속 물을 줘야 하는 화분에 가깝습니다.
3. 데이터: 어디서 구하고, 어떻게 읽을 것인가
3-1. 공개 데이터셋
| 데이터셋 | 규모 | 특징 |
|---|---|---|
| SpamAssassin Public Corpus | 약 6,000통 | 원본 MIME 형식 그대로. 헤더 실습에 최적 |
| Enron-Spam | 약 33,000통 | 실제 기업 메일 기반, 영어 장문 |
| UCI SMS Spam Collection | 5,574건 | 짧은 텍스트, 입문용 벤치마크 |
| 사내 메일 로그 | 가변 | 가장 강력하지만 개인정보 비식별화 필수 |
3-2. 파이썬으로 메일 파싱하기
이메일은 그냥 텍스트가 아니라 MIME(Multipurpose Internet Mail Extensions) 구조체입니다.
헤더, 본문, 첨부가 계층적으로 얽혀 있어 표준 라이브러리 email을 써야 안전합니다.
from email import policy
from email.parser import BytesParser
from bs4 import BeautifulSoup

def parse_email(path):
    with open(path, "rb") as f:
        msg = BytesParser(policy=policy.default).parse(f)

    subject = msg.get("Subject", "")
    sender  = msg.get("From", "")
    body_parts = []

    for part in msg.walk():
        ctype = part.get_content_type()
        if part.get_content_disposition() == "attachment":
            continue
        if ctype == "text/plain":
            body_parts.append(part.get_content())
        elif ctype == "text/html":
            html = part.get_content()
            body_parts.append(BeautifulSoup(html, "html.parser").get_text(" "))

    return {
        "subject": subject,
        "sender": sender,
        "body": "\n".join(body_parts),
        "n_attach": sum(1 for p in msg.walk()
                        if p.get_content_disposition() == "attachment"),
    }
실무 함정 1 — 인코딩 지옥.
한국어 메일은 EUC-KR, CP949, UTF-8이 뒤섞여 들어옵니다.
policy.default를 지정하면 파이썬이 헤더 디코딩을 상당 부분 알아서 처리해 주지만,
깨진 바이트는 errors="replace"로 방어하는 게 안전합니다.
4. 전처리: 한국어라는 난관
영어는 공백으로 자르면 대충 단어가 됩니다. 한국어는 교착어라 그렇지 않죠.
'배송이', '배송을', '배송은'이 전부 다른 토큰이 되어 버리면 학습 효율이 급락합니다.
import re
from konlpy.tag import Okt   # 또는 Mecab (속도 우위)

okt = Okt()
URL = re.compile(r"https?://\S+")
NUM = re.compile(r"\d+")
MAIL = re.compile(r"[\w\.-]+@[\w\.-]+")

def clean(text: str) -> str:
    text = URL.sub(" _URL_ ", text)
    text = MAIL.sub(" _EMAIL_ ", text)
    text = NUM.sub(" _NUM_ ", text)
    text = re.sub(r"[^가-힣a-zA-Z_\s]", " ", text)
    return re.sub(r"\s+", " ", text).strip()

def tokenize(text: str):
    tokens = okt.pos(clean(text), stem=True)
    return [w for w, t in tokens
            if t in ("Noun", "Verb", "Adjective", "Alpha") and len(w) > 1]
여기서 재미있는 포인트.
URL과 숫자를 지우지 않고 _URL_, _NUM_ 같은 플레이스홀더 토큰으로 치환한 이유는,
"링크가 많다"거나 "숫자가 많다"는 사실 자체가 스팸의 강력한 신호이기 때문입니다.
Mecab vs Okt
Okt는 설치가 쉽고 구어체에 강하지만 느립니다.
수만 건 이상을 다룬다면 Mecab(mecab-ko)이 수십 배 빠릅니다.
최근에는 Kiwi(kiwipiepy)가 순수 파이썬 설치 편의성과 속도를 동시에 잡아 인기입니다.
5. 벡터화: 텍스트를 숫자로 번역하기
5-1. TF-IDF, 여전히 강력한 기본기
TF-IDF는 "이 문서에서 자주 나오지만 전체 문서에선 드문 단어"에 높은 가중치를 줍니다.
수식으로는 tf(t,d) × log(N / df(t)). 단순하지만 짧은 텍스트에서 딥러닝을 이기는 경우가 흔합니다.
from sklearn.feature_extraction.text import TfidfVectorizer

vec = TfidfVectorizer(
    tokenizer=tokenize,
    ngram_range=(1, 2),      # 유니그램 + 바이그램
    min_df=3,                # 3번 미만 등장 단어 제거
    max_df=0.85,             # 85% 이상 문서에 나오면 불용어 취급
    sublinear_tf=True,       # 1 + log(tf)
    max_features=50000,
)
X = vec.fit_transform(train_texts)
5-2. 문자 n-gram이라는 비밀 병기
스팸 발송자는 필터를 피하려고 '대ㅊㅜㄹ', 'v1agra', '대_출' 같은 변형을 씁니다.
형태소 분석기는 여기서 무너지지만, char_wb n-gram은 버텨냅니다.
from sklearn.pipeline import FeatureUnion

union = FeatureUnion([
    ("word", TfidfVectorizer(tokenizer=tokenize, ngram_range=(1,2), min_df=3)),
    ("char", TfidfVectorizer(analyzer="char_wb", ngram_range=(2,4), min_df=3)),
])
5-3. 메타 피처 잊지 말기
본문만 보는 건 반쪽짜리입니다. 다음 피처들은 거의 공짜로 성능을 올려줍니다.
| 피처 | 의미 |
|---|---|
| 발신 도메인의 SPF/DKIM 통과 여부 | 위조 발신 탐지의 핵심 |
| 제목 대문자 비율 | "URGENT!!!" 패턴 |
| 링크 개수 / 링크 도메인 다양성 | 피싱 신호 |
| 본문 길이, 첨부 개수 | 악성 첨부 패턴 |
| 발신 시각(새벽 여부) | 봇 발송 패턴 |
6. 모델 선택: 가벼운 것부터 차근차근
6-1. 베이스라인 — 나이브 베이즈
베이즈 정리 P(스팸|단어) ∝ P(단어|스팸)·P(스팸)에 "단어끼리 독립"이라는
현실적으로 틀린 가정을 얹은 모델. 그런데 이 틀린 가정이 텍스트에선 놀랍도록 잘 작동합니다.
from sklearn.naive_bayes import ComplementNB
from sklearn.pipeline import Pipeline

pipe_nb = Pipeline([("vec", union), ("clf", ComplementNB(alpha=0.3))])
pipe_nb.fit(train_texts, y_train)
MultinomialNB가 교과서적이지만, 클래스 불균형이 있을 땐 ComplementNB가 더 안정적입니다.
학습이 수 초 안에 끝나니 "이 문제의 하한선"을 재는 용도로 최고입니다.
6-2. 실전 주력 — 선형 SVM과 로지스틱 회귀
from sklearn.svm import LinearSVC
from sklearn.calibration import CalibratedClassifierCV

svm = CalibratedClassifierCV(
    LinearSVC(C=1.0, class_weight="balanced"),
    method="sigmoid", cv=5
)
LinearSVC는 고차원 희소 행렬에서 거의 무적에 가깝습니다.
다만 확률값을 안 주기 때문에 CalibratedClassifierCV로 감싸
"스팸 확률 0.87" 같은 임계값 조절 가능한 출력을 만들어 줘야 실무에서 쓸모가 있습니다.
6-3. 문맥이 필요할 때 — 트랜스포머
"계좌번호 알려주세요"가 동료의 정당한 요청인지 피싱인지는 문맥이 갈라놓습니다.
이럴 때 KoBERT, KLUE-RoBERTa, KcELECTRA 같은 한국어 사전학습 모델을 파인튜닝합니다.
from transformers import (AutoTokenizer, AutoModelForSequenceClassification,
                          TrainingArguments, Trainer)

MODEL = "klue/roberta-base"
tok = AutoTokenizer.from_pretrained(MODEL)
model = AutoModelForSequenceClassification.from_pretrained(MODEL, num_labels=4)

def encode(batch):
    return tok(batch["text"], truncation=True, max_length=256, padding="max_length")

args = TrainingArguments(
    output_dir="./out", learning_rate=2e-5,
    per_device_train_batch_size=16, num_train_epochs=3,
    eval_strategy="epoch", fp16=True, load_best_model_at_end=True,
    metric_for_best_model="f1",
)
| 모델 | 학습 시간 | 추론 속도 | 권장 상황 |
|---|---|---|---|
| ComplementNB | 수 초 | 수만 건/초 | 베이스라인, 초경량 환경 |
| LinearSVC + TF-IDF | 수십 초 | 수천 건/초 | 대부분의 실무 |
| LightGBM + 메타피처 | 수 분 | 수천 건/초 | 정형 피처가 풍부할 때 |
| RoBERTa 파인튜닝 | GPU 수십 분 | 수십~수백 건/초 | 문맥 판별이 핵심일 때 |
현업 조언 — 처음부터 BERT로 가지 마세요.
TF-IDF + LinearSVC로 F1 0.95를 찍었는데 BERT가 0.96이라면,
0.01을 위해 GPU 비용과 배포 복잡도를 감수할 가치가 있는지 따져봐야 합니다.
가장 좋은 모델은 가장 정확한 모델이 아니라, 유지보수 가능한 모델입니다.
7. 평가: 정확도 99%의 함정
전체 메일의 2%만 스팸이라면, "전부 정상"이라고 답하는 멍청이 모델도 정확도 98%입니다.
그래서 이메일 분류에서는 아래 지표를 봐야 합니다.
이메일 분류의 비대칭성은 명확합니다.
스팸 한 통이 받은편지함에 들어오는 건 짜증이지만,
계약서 메일이 스팸함으로 가는 건 사고입니다.
import numpy as np
from sklearn.metrics import precision_recall_curve

proba = model.predict_proba(X_valid)[:, 1]
prec, rec, thr = precision_recall_curve(y_valid, proba)

# Precision 0.99 이상을 유지하는 최대 Recall 지점 찾기
mask = prec[:-1] >= 0.99
best = thr[mask][np.argmax(rec[:-1][mask])]
print(f"운영 임계값: {best:.3f}")
기본값 0.5는 아무 의미 없는 숫자입니다.
임계값은 비즈니스 요구사항으로부터 역산해야 합니다.
실무 함정 2 — 데이터 누수(Data Leakage).
같은 발신자의 메일이 학습셋과 검증셋에 동시에 들어가면 점수가 부풀려집니다.
GroupKFold(groups=sender_domain) 또는 시간 기준 분할을 사용하세요.
스팸은 시간에 따라 진화하므로, 과거로 학습하고 미래로 검증하는 게 현실적입니다.
8. 다중 분류로 확장하기
스팸/정상 이진 분류를 넘어 실무에서 더 유용한 건 업무 카테고리 라우팅입니다.
LABELS = ["스팸", "결제/청구", "고객문의", "내부공지", "마케팅", "개발알림"]

from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

clf = LogisticRegression(max_iter=2000, class_weight="balanced",
                         C=4.0, solver="saga", n_jobs=-1)
clf.fit(X_train, y_train)
print(classification_report(y_valid, clf.predict(X_valid),
                            target_names=LABELS, digits=3))
다중 분류에서는 macro-F1을 주 지표로 삼습니다.
샘플 수가 적은 클래스도 동등하게 평가해야 소수 카테고리가 방치되지 않기 때문입니다.
라벨이 부족할 때의 현실적 대안
대부분의 프로젝트는 라벨 데이터 부족으로 시작합니다. 세 가지 처방이 있습니다.
① 규칙 기반 약한 라벨링
"제목에 [결제완료]가 있으면 결제/청구"처럼 확실한 규칙으로 초기 라벨을 자동 생성합니다.
② 능동 학습(Active Learning)
모델이 가장 헷갈려하는(확률 0.5 근처) 샘플만 사람에게 물어봅니다.
무작위 라벨링 대비 라벨 비용을 60~80% 절감할 수 있습니다.
③ LLM 보조 라벨링
GPT 계열 모델로 초벌 라벨을 붙이고 사람이 검수하는 방식.
단, 메일 본문을 외부 API로 보내는 건 개인정보 이슈가 있으니 반드시 비식별화를 거쳐야 합니다.
9. 서비스화: FastAPI로 감싸기
import joblib
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="Email Classifier")
MODEL = joblib.load("model_v3.joblib")
THRESHOLD = 0.72
LABELS = ["정상", "스팸"]

class MailIn(BaseModel):
    subject: str = ""
    body: str = ""
    sender: str = ""

@app.post("/predict")
def predict(mail: MailIn):
    text = f"{mail.subject}\n{mail.body}"
    p = float(MODEL.predict_proba([text])[0][1])
    label = LABELS[1] if p >= THRESHOLD else LABELS[0]
    return {
        "label": label,
        "spam_probability": round(p, 4),
        "model_version": "v3",
        "needs_review": 0.45 < p < THRESHOLD,   # 애매 구간은 사람에게
    }
여기서 needs_review 필드가 핵심입니다.
AI가 확신하지 못하는 구간을 사람에게 넘기는 설계(Human-in-the-loop)가
실서비스 신뢰도를 결정합니다. 완전 자동화는 목표가 아니라 선택지 중 하나일 뿐입니다.
모델 저장 시 반드시 기록할 것
| 항목 | 이유 |
|---|---|
| scikit-learn / 파이썬 버전 | 버전 불일치 시 pickle 로드 실패 |
| 학습 데이터 기간·건수 | 드리프트 판단 기준 |
| 운영 임계값 | 모델과 임계값은 한 세트 |
| 검증 성능(클래스별 P/R/F1) | 롤백 판단 근거 |
실무 함정 3 — 커스텀 tokenizer= 함수를 넣은 Vectorizer는
pickle 시 함수 참조를 저장하므로, 배포 환경에 동일 모듈 경로가 없으면 로드에 실패합니다.
전처리 함수를 별도 모듈(preprocess.py)로 분리해 함께 배포하세요.
10. 운영: 모델은 늙는다
스팸 발송자는 필터를 연구합니다. 이것을 적대적 환경(Adversarial Setting)이라 부르며,
이미지 분류와 이메일 분류를 가르는 결정적 차이입니다. 고양이는 자기가 고양이로 분류되는 걸 피하려 하지 않으니까요.
그래서 다음 세 가지를 반드시 모니터링합니다.
① 예측 분포 변화
평소 스팸 비율이 3%였는데 갑자기 12%가 되었다면, 공격이거나 모델 고장입니다.
② 어휘 커버리지(OOV 비율)
학습 시 못 본 단어 비율이 치솟으면 새로운 유형의 메일이 유입된 신호입니다.
③ 사용자 피드백 루프
"스팸 신고", "스팸 아님" 버튼 클릭은 세상에서 가장 값싼 라벨 데이터입니다.
이것을 주기적으로 모아 재학습하는 파이프라인이 시스템의 수명을 결정합니다.
# 간단한 드리프트 감지 (PSI: Population Stability Index)
import numpy as np

def psi(expected, actual, bins=10):
    edges = np.percentile(expected, np.linspace(0, 100, bins + 1))
    edges[0], edges[-1] = -np.inf, np.inf
    e = np.histogram(expected, edges)[0] / len(expected) + 1e-6
    a = np.histogram(actual,   edges)[0] / len(actual)   + 1e-6
    return float(np.sum((a - e) * np.log(a / e)))

# PSI < 0.1 안정 / 0.1~0.25 주의 / > 0.25 재학습 권고
11. 법적·윤리적 체크리스트
기술만 잘한다고 끝이 아닙니다. 이메일은 통신비밀의 영역입니다.
| 항목 | 실행 사항 |
|---|---|
| 개인정보 최소 수집 | 주민번호·카드번호는 정규식으로 마스킹 후 저장 |
| 학습 데이터 보관 기간 | 목적 달성 후 파기 원칙, 기간 명시 |
| 외부 API 전송 | 클라우드 LLM 전송 전 비식별화 및 동의 확인 |
| 설명 가능성 | 차단 사유(근거 단어) 제공으로 이의제기 경로 확보 |
| 편향 점검 | 특정 발신 도메인·언어에 대한 과차단 정기 감사 |
선형 모델의 장점 중 하나가 바로 이 설명 가능성입니다.
계수(coefficient)를 보면 어떤 단어가 판단을 밀어붙였는지 즉시 알 수 있습니다.
import numpy as np
names = np.array(vec.get_feature_names_out())
coef  = clf.coef_[0]
top = np.argsort(coef)[-15:][::-1]
for i in top:
    print(f"{names[i]:20s} {coef[i]:+.3f}")
12. 4주 실행 로드맵
| 기간 | 목표 | 산출물 |
|---|---|---|
| 1주차 | 데이터 수집·파싱·라벨 정의 | 정제된 CSV, 라벨 가이드 문서 |
| 2주차 | TF-IDF + NB/SVM 베이스라인 | 검증 리포트, 오분류 100건 분석 |
| 3주차 | 메타피처 추가, 임계값 튜닝 | 운영 임계값 확정, 모델 카드 |
| 4주차 | FastAPI 배포, 피드백 루프 설계 | API 엔드포인트, 모니터링 대시보드 |
특히 2주차의 오분류 100건 직접 읽기를 생략하지 마세요.
하이퍼파라미터 100번 튜닝보다, 틀린 메일 100통을 눈으로 읽는 게 훨씬 큰 도약을 만듭니다.
대부분의 성능 문제는 모델이 아니라 라벨 정의의 모호함에서 옵니다.
혼자 막히는 구간이 생긴다면 재능넷의 '지식인의 숲'에 축적된
머신러닝·데이터 엔지니어링 콘텐츠를 참고하거나, 현업 개발자에게 코드 리뷰를 요청해 보세요.
파이프라인 설계 단계에서 받는 조언 한 마디가 몇 주의 삽질을 줄여 줍니다.
13. 정리
이메일 분류 AI 시스템은 화려하지 않습니다.
하지만 머신러닝 엔지니어링의 모든 근육을 고르게 단련시켜 줍니다.
기억할 원칙 다섯 가지로 마무리합니다.
1. 베이스라인 없이 딥러닝으로 뛰지 말 것. TF-IDF + LinearSVC는 생각보다 강하다.
2. 정확도가 아니라 Precision/Recall과 임계값으로 말할 것.
3. FP(정상 메일 차단)의 비용을 숫자로 정의하고 시작할 것.
4. 모델은 늙는다. 재학습 파이프라인이 없으면 프로젝트는 반쪽이다.
5. 애매하면 사람에게 넘겨라. 완전 자동화보다 신뢰가 먼저다.
이제 pip install scikit-learn부터 시작해 보세요.
첫 모델은 오늘 오후 안에 돌아갑니다. 진짜 여정은 그다음부터 시작됩니다.
관련 키워드
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.