Ver4.0 소리를 눈으로 보는 기술, 음악 시각화와 오디오-비주얼 싱크
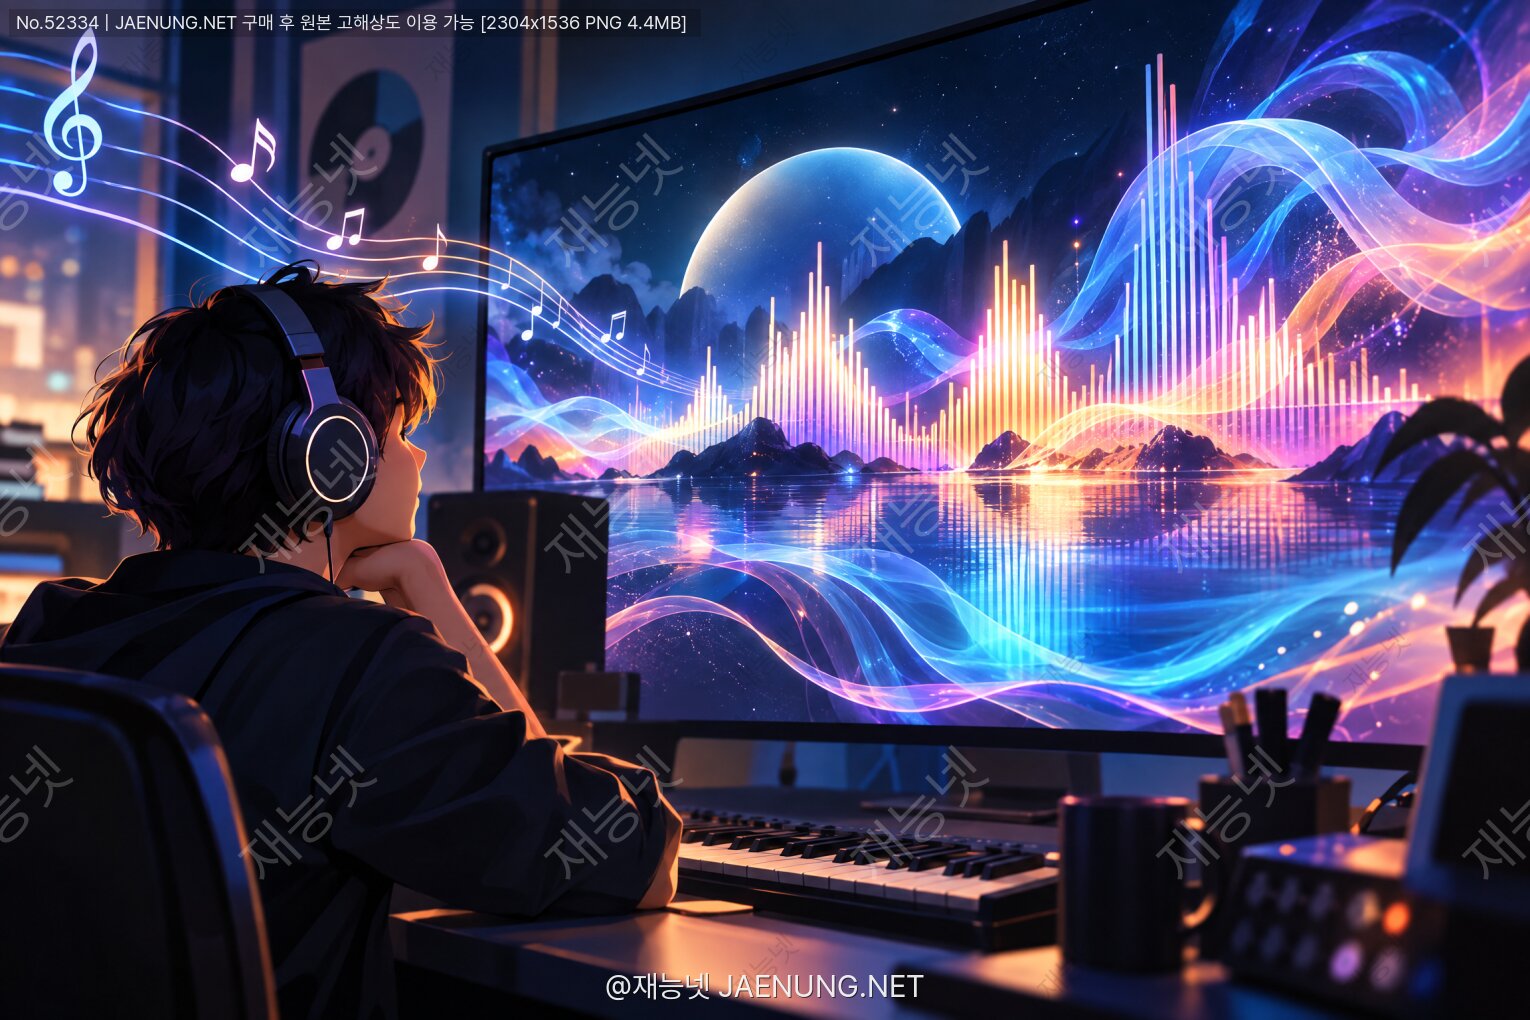
소리를 눈으로 보는 기술, 음악 시각화와 오디오-비주얼 싱크
FFT부터 비트 디텍션, 오디오 레이턴시 보정까지
귀로 듣던 그 곡을, 이제 눈으로 읽어봅니다.
🌊 들어가며 : 왜 사람은 소리를 '보고' 싶어할까
스피커 앞에서 눈을 감아도 음악은 완벽하게 들립니다. 그런데 우리는 굳이 비주얼라이저를 켜고, 클럽에서 LED 월을 세우고, 유튜브에 파형이 춤추는 영상을 올립니다.
이유는 단순합니다. 인간의 뇌는 시각과 청각을 따로 처리하지 않기 때문입니다.
신경과학에서 말하는 다감각 통합(multisensory integration)은 청각 자극과 시각 자극이 일정 시간 창(temporal binding window) 안에 들어오면 이를 하나의 사건으로 묶어 인식하는 현상입니다.
드럼 킥이 '쿵' 할 때 화면의 원이 동시에 커지면, 뇌는 그 원이 소리를 낸 것이라고 착각합니다. 이 착각이 바로 음악 시각화의 쾌감입니다.
재미있는 사실 하나. 실제로 맥거크 효과(McGurk effect)처럼 시각 정보가 청각 인식 자체를 바꿔버리기도 합니다.
잘 만든 비주얼은 '음악을 꾸며주는 장식'이 아니라 음악의 들림 자체를 바꾸는 장치인 셈이죠.
📐 1. 소리를 숫자로 쪼개기 : FFT와 스펙트럼의 정체
1-1. 파형(waveform)과 스펙트럼(spectrum)은 다르다
초보자가 가장 많이 혼동하는 지점입니다.
파형은 시간축 위의 진폭(amplitude) 변화입니다. 오디오 편집 프로그램에서 보는 그 울퉁불퉁한 산맥이죠.
스펙트럼은 특정 순간의 소리를 주파수별 에너지로 분해한 결과입니다. 흔히 보는 '막대 그래프 비주얼라이저'가 바로 이것입니다.
이 변환을 담당하는 수학이 푸리에 변환(Fourier Transform)이고,
컴퓨터가 실제로 쓰는 고속 알고리즘이 FFT(Fast Fourier Transform)입니다. 1965년 쿨리-튜키 알고리즘이 정리되며 연산량이 O(N²)에서 O(N log N)으로 줄었고, 그 덕분에 지금 우리는 브라우저에서도 실시간 스펙트럼을 뽑습니다.
1-2. FFT 사이즈, 그 잔인한 트레이드오프
FFT 사이즈(윈도우 크기)는 2의 거듭제곱으로 설정합니다. 흔히 512, 1024, 2048, 4096.
여기서 피할 수 없는 물리 법칙이 등장합니다. 시간 해상도와 주파수 해상도는 동시에 좋아질 수 없습니다.
| FFT 크기 | 주파수 해상도(48kHz 기준) | 시간 길이 | 성격 |
|---|---|---|---|
| 512 | 약 93.75 Hz | 약 10.7 ms | 반응 빠름 / 저음 뭉개짐 |
| 1024 | 약 46.9 Hz | 약 21.3 ms | 무난한 실시간용 |
| 2048 | 약 23.4 Hz | 약 42.7 ms | 가장 널리 쓰이는 기본값 |
| 4096 | 약 11.7 Hz | 약 85.3 ms | 정밀 / 타격감 둔함 |
계산식은 단순합니다. 주파수 해상도 = 샘플레이트 ÷ FFT 크기.
킥드럼의 '툭' 하는 어택을 눈으로 느끼게 하고 싶다면 작은 FFT를, 신스 패드의 화성 구조를 보여주고 싶다면 큰 FFT를 씁니다.
프로급 작업에서는 두 개의 FFT를 병렬로 돌려 저역은 큰 창, 고역은 작은 창으로 처리하는 멀티 해상도 기법도 씁니다.
1-3. 윈도우 함수를 빼먹으면 생기는 일
FFT는 입력 신호가 무한히 반복된다고 가정합니다. 그런데 잘라낸 구간의 시작과 끝이 뚝 끊기면 가짜 주파수 성분이 사방으로 번지는 스펙트럼 누설(spectral leakage)이 발생합니다.
이를 막기 위해 구간 양 끝을 부드럽게 0으로 줄이는 Hann, Hamming, Blackman-Harris 같은 윈도우 함수를 곱합니다. 실시간 비주얼라이저는 보통 Hann 윈도우가 표준입니다.
1-4. 인간의 귀는 로그로 듣는다
여기서 대부분의 아마추어 비주얼라이저가 실패합니다. FFT 출력 빈(bin)을 그냥 가로로 나열하면, 화면의 80%가 우리가 잘 듣지도 못하는 고역대에 할당됩니다.
실제 음악 에너지의 대부분은 20Hz~2kHz에 몰려 있는데 말이죠.
반드시 기억할 두 가지 로그 변환
① 주파수 축은 로그 스케일 — 옥타브당 동일 폭. 실무에선 1/3 옥타브 밴드(31밴드) 또는 24~64밴드로 묶습니다.
② 진폭 축은 데시벨(dB) — dB = 20·log10(amplitude). 인간의 음량 지각은 선형이 아니라 대수적입니다.
여기에 A-weighting 같은 등청감 곡선 보정까지 적용하면, "실제 들리는 느낌"과 화면이 훨씬 잘 맞아떨어집니다.
🥁 2. 비트를 잡아내는 기술 : 온셋 디텍션과 BPM 추정
스펙트럼이 '소리의 색깔'이라면, 비트 디텍션은 '소리의 심장박동'입니다.
비주얼이 음악에 맞춰 터지는 순간을 만들려면 반드시 필요한 기술이죠.
2-1. 온셋(onset)이란 무엇인가
온셋은 하나의 음이 시작되는 순간입니다. 킥, 스네어, 피아노 타건, 기타 피킹 모두 온셋을 만듭니다.
가장 널리 쓰이는 검출 방식은 스펙트럼 플럭스(Spectral Flux)입니다.
스펙트럼 플럭스의 원리 (3줄 요약)
1) 현재 프레임과 직전 프레임의 스펙트럼을 비교한다.
2) 증가한 성분만 더한다(half-wave rectification). 감소는 무시 — 소리가 커지는 순간만이 '시작'이니까.
3) 그 합이 주변 평균보다 확 튀어오르면 온셋으로 판정한다.
// 스펙트럼 플럭스 의사코드
flux = 0
for k in 0..N/2:
    diff = mag[t][k] - mag[t-1][k]
    if diff > 0: flux += diff

// 적응형 임계값 (이동 중앙값 기반)
threshold = median(flux_history) * 1.5 + delta
if flux > threshold and (now - lastOnset) > 60ms:
    triggerVisualBurst()
60ms 쿨다운은 실무의 생명줄입니다. 이게 없으면 하나의 킥에서 온셋이 3~4번 연달아 터지며 화면이 경련합니다.
2-2. 대역 분리 트리거가 훨씬 예쁘다
전체 신호로 온셋을 잡으면 모든 악기가 같은 이펙트를 유발합니다. 지루하죠.
실전에서는 대역을 쪼개 각각 다른 시각 요소에 연결합니다.
| 대역 | 주요 음원 | 추천 비주얼 매핑 |
|---|---|---|
| 20–120 Hz | 킥, 서브베이스 | 화면 전체 스케일 펄스, 카메라 셰이크 |
| 120–500 Hz | 베이스라인, 저역 신스 | 배경 그라디언트 위치·왜곡 |
| 500–2k Hz | 보컬, 스네어 바디 | 중앙 오브젝트 회전·형태 변형 |
| 2k–8k Hz | 보컬 자음, 클랩 | 파티클 방출량 |
| 8k–16k Hz | 하이햇, 심벌, 에어 | 빛 번짐(bloom), 별 반짝임 |
2-3. BPM 추정과 비트 그리드
실시간 온셋만으로는 '지금 몇 박자째인지'를 알 수 없습니다. 그래서 온셋 함수의 자기상관(autocorrelation) 또는 빗살 필터(comb filter)로 반복 주기를 찾아 BPM을 추정합니다.
전형적인 EDM은 120~130 BPM, 하우스 124, 드럼앤베이스 174, 힙합 80~95 부근에 몰려 있어 탐색 범위를 제한하면 정확도가 크게 올라갑니다.
한 번 BPM과 첫 박(downbeat)을 확정하면, 이후 비주얼은 실시간 검출이 아니라 예측 기반으로 돌아갈 수 있습니다.
이게 결정적인 이유가 있습니다. 온셋 검출은 본질적으로 사후 반응이라 항상 늦습니다. 그러나 비트 그리드가 있으면 다음 비트가 올 시각을 미리 알고 0.2초 전부터 에너지를 모으는 연출이 가능해집니다. 프로와 아마추어의 결정적 차이가 여기서 갈립니다.
🎛️ 3. 매핑의 미학 : 숫자를 움직임으로 번역하기
분석은 절반입니다. 나머지 절반은 "이 숫자를 무엇에 연결할 것인가"라는 디자인 판단입니다.
여기서 작품의 급이 결정됩니다.
3-1. 스무딩 없는 비주얼은 싸구려다
FFT 값을 그대로 화면에 꽂으면 막대가 미친 듯 떨립니다. 그래서 필수적인 게 시간 스무딩입니다.
// 1차 IIR 로우패스 (지수 이동평균)
smoothed = smoothed * a + current * (1 - a);   // a = 0.7~0.9

// 더 좋은 방법: 비대칭 어택/릴리즈
if (current > value) value += (current - value) * attack;   // 0.5 (빠르게)
else                 value += (current - value) * release;  // 0.08 (천천히)
이 비대칭 엔벨로프가 핵심입니다. 올라갈 땐 순식간에, 내려올 땐 미끄러지듯.
컴프레서/리미터의 어택-릴리즈와 완전히 같은 개념이며, 사람의 눈은 이 패턴을 '리듬감 있다'고 느낍니다.
3-2. 정규화와 AGC
조용한 인트로와 폭발적인 드롭의 진폭 차이는 수십 배입니다. 고정 스케일을 쓰면 인트로에선 아무것도 안 보이고 드롭에선 다 잘립니다.
해결책은 자동 게인 제어(AGC) — 최근 수 초간의 최대/최소값을 추적해 표시 범위를 서서히 재조정합니다. 단, 재조정 속도를 너무 빠르게 하면 다이내믹이 사라져 모든 구간이 똑같아 보입니다. 3~5초 시간상수가 무난합니다.
3-3. 매핑 곡선 선택
선형 매핑 — 예측 가능하지만 밋밋함.
지수 매핑 (value^2, value^3) — 큰 값만 극적으로 강조. 드롭 연출에 최적.
로그 매핑 — 작은 신호도 잘 보임. 앰비언트·클래식에 적합.
임계 트리거 — 특정 값을 넘을 때만 발동. 카메라 컷, 색상 반전 등 이산적 이벤트용.
3-4. 대표적인 시각화 유형
| 유형 | 표현 정보 | 어울리는 장르 |
|---|---|---|
| 스펙트럼 바 | 주파수별 에너지 | 범용, 전자음악 |
| 파형/오실로스코프 | 시간축 진폭 | 로파이, 신스웨이브 |
| 원형 스펙트럼 | 주파수 + 대칭미 | 앨범 아트 영상 |
| 스펙트로그램 | 시간×주파수×강도 | 분석, 실험음악 |
| 파티클 시스템 | 온셋 + 에너지 | EDM, 페스티벌 |
| 리사주 / 벡터스코프 | L·R 위상 관계 | 스테레오 아트 |
| 3D 지형 변형 | 스펙트럼 히스토리 | 앰비언트, 시네마틱 |
참고로 재능넷의 '기타 음악영상' 카테고리를 살펴보면, 요즘은 단순 스펙트럼 바보다 앨범 아트 + 원형 웨이브 + 은은한 파티클 조합의 '루프형 뮤직비주얼' 수요가 압도적으로 많습니다. 스트리밍 플랫폼 업로드 규격(1080p/최대 비트레이트)에 맞춘 납품 경험이 실제 경쟁력이 되는 시대죠.
⏱️ 4. 진짜 난관 : 오디오-비주얼 싱크와 레이턴시
여기서부터가 본론입니다. 비주얼이 아무리 예뻐도 0.1초만 밀리면 전부 무너집니다.
4-1. 인간은 얼마나 예민한가
국제 방송 규격인 ITU-R BT.1359는 립싱크 허용 오차를 명시합니다.
감지 가능 한계 : 오디오가 영상보다 앞설 때 -45ms, 뒤처질 때 +125ms
수용 가능 한계 : 앞설 때 -90ms, 뒤처질 때 +185ms
비대칭에 주목하세요. 인간은 소리가 먼저 오는 것에 훨씬 민감합니다.
진화적으로 당연합니다. 자연계에서 빛은 항상 소리보다 먼저 도착하니까요(소리는 초당 약 343m). 20m 떨어진 드러머의 소리는 약 58ms 늦게 들리고, 우리 뇌는 이걸 자연스럽게 보정하도록 학습되어 있습니다.
다만 음악 비주얼라이저는 립싱크보다 훨씬 빡빡합니다. 킥 드럼과 화면 펄스처럼 날카로운 트랜지언트가 짝지어지면 20~30ms 어긋남도 "뭔가 이상하다"는 느낌을 줍니다. 목표는 ±20ms 이내로 잡는 것이 안전합니다.
4-2. 지연은 어디서 생기는가
| 구간 | 전형적 지연 | 대응 |
|---|---|---|
| 오디오 버퍼(512샘플 @48kHz) | 약 10.7 ms | 버퍼 축소 (드롭아웃 위험 증가) |
| FFT 윈도우 지연 | 창 길이의 절반 ~ 전체 | 홉 사이즈 축소, 오버랩 75% |
| 스무딩 필터 | 10–50 ms | 어택 계수 상향 |
| 렌더 프레임(60fps) | 16.7 ms + 파이프라인 | 고주사율 출력 |
| 블루투스 오디오(SBC) | 150–250 ms | aptX LL / 유선 모니터링 |
| 디스플레이 처리 | 10–80 ms | 게임 모드 활성화 |
충격적인 사실 하나. 블루투스 이어폰으로 비주얼라이저를 테스트하면 절대 안 됩니다. SBC 코덱은 200ms 넘게 밀릴 수 있습니다. 반드시 유선 모니터링으로 검수하세요.
4-3. 실시간 vs 오프라인 렌더링
실시간(Live) — DJ 공연, VJ, 스트리밍. 미래를 알 수 없으므로 지연은 필연. 최소화가 목표.
오프라인(Render) — 유튜브 업로드용 뮤직비디오. 전체 파일을 미리 분석하므로 지연이 0일 뿐 아니라 '음수'도 가능합니다.
오프라인 작업의 마법이 바로 이 예측(look-ahead)입니다. 드롭이 오기 1.5초 전부터 화면을 어둡게 조이고, 정확히 드롭 프레임에 폭발시키는 연출.
실시간으로는 물리적으로 불가능하지만, 사전 분석에서는 당연합니다. 유튜브의 "소름 돋는다"는 댓글이 달리는 영상들은 거의 전부 오프라인 렌더링입니다.
4-4. 프레임 기준 타임코드 계산
// 오프라인 렌더: 프레임 번호 → 오디오 샘플 위치
const fps = 60, sr = 48000;
const samplesPerFrame = sr / fps;          // 800 샘플

function analyzeFrame(frameIndex, offsetMs = 0){
  const offsetSamples = offsetMs * sr / 1000;
  const center = frameIndex * samplesPerFrame + offsetSamples;
  const start  = Math.max(0, center - fftSize / 2);   // 창 중심 정렬
  return fft(audio.slice(start, start + fftSize));
}
창 중심 정렬(centered window)이 포인트입니다. FFT 창의 시작점을 프레임에 맞추면 항상 창 길이의 절반만큼 늦게 반응합니다. 창의 중심을 프레임 시각에 맞춰야 체감 싱크가 정확해집니다.
4-5. 오프셋 캘리브레이션
수치 계산이 완벽해도 최종 재생 환경에서 어긋날 수 있습니다. 그래서 프로들은 수동 오프셋 슬라이더를 반드시 둡니다.
검수 팁 : 킥만 남긴 메트로놈 트랙과 흰 사각형 플래시를 만들어, 오프셋을 -60ms~+60ms까지 10ms 단위로 바꿔가며 "가장 하나로 붙어 느껴지는" 값을 찾습니다.
사람은 절대 지연을 못 맞추지만, 상대 비교는 기막히게 잘합니다.
🧰 5. 실무 도구 지형도
5-1. 웹 : Web Audio API
브라우저만으로 가능한 가장 접근성 높은 환경입니다. AnalyserNode가 FFT를 자동 처리해줍니다.
const ctx = new AudioContext();
const analyser = ctx.createAnalyser();
analyser.fftSize = 2048;                 // → frequencyBinCount = 1024
analyser.smoothingTimeConstant = 0.8;    // 내장 스무딩
analyser.minDecibels = -90;
analyser.maxDecibels = -10;

const data = new Uint8Array(analyser.frequencyBinCount);

function loop(){
  analyser.getByteFrequencyData(data);   // 0~255 dB 정규화 값
  draw(data);
  requestAnimationFrame(loop);
}
주의 : getByteFrequencyData는 이미 dB 변환 + 정규화가 끝난 값입니다. 여기에 다시 로그를 씌우면 이중 압축이 되어 밋밋해집니다. 원시 값이 필요하면 getFloatFrequencyData를 쓰세요.
5-2. 크리에이티브 코딩
TouchDesigner — 노드 기반. 라이브 VJ 업계 사실상 표준. Audio Spectrum CHOP, Audio Filter CHOP 내장.
Processing / p5.js — 학습용 최강. Minim, p5.sound 라이브러리.
openFrameworks / Cinder — C++ 기반. 고성능·저지연이 필요한 설치미술용.
Notch, Unreal Engine — 대형 무대·방송 그래픽.
5-3. 영상 편집 환경
After Effects의 Convert Audio to Keyframes는 오디오 진폭을 키프레임으로 변환하는 고전적 방법입니다. 단, 전대역 진폭만 뽑으므로 정밀 제어는 어렵습니다.
Trapcode Sound Keys 플러그인을 쓰면 주파수 범위를 지정해 추출할 수 있어 "킥만 따로", "하이햇만 따로" 연결이 가능합니다.
5-4. 분석 라이브러리
librosa(Python)는 MIR(Music Information Retrieval) 분야의 표준입니다.
librosa.onset.onset_detect(), librosa.beat.beat_track()으로 온셋과 BPM을 몇 줄에 뽑을 수 있고, 결과를 JSON으로 내보내 After Effects나 웹 렌더러에 주입하는 워크플로가 실무에서 널리 쓰입니다.
Essentia, aubio, Meyda(JS)도 훌륭한 대안입니다.
🎬 6. 좋은 비주얼과 나쁜 비주얼을 가르는 7가지
① 모든 걸 움직이지 마라
화면의 모든 요소가 음악에 반응하면 아무것도 강조되지 않습니다. 반응 요소 1~2개 + 고정 요소로 구성하세요.
② 곡 구조를 읽어라
인트로-벌스-코러스-브릿지-드롭. 같은 이펙트를 3분 내내 돌리면 45초 만에 질립니다. 구간별 '모드'를 바꾸세요.
③ 정지도 연출이다
브레이크다운에서 비주얼이 완전히 멈추면, 다음 드롭의 폭발력이 배가됩니다. 대비가 곧 에너지입니다.
④ 색은 3개 이하
무지개 그라디언트는 초보의 표식입니다. 곡의 정서에 맞춘 제한된 팔레트가 훨씬 세련돼 보입니다.
⑤ 광과민성 안전
초당 3회를 넘는 강한 플래시는 광과민성 발작을 유발할 수 있습니다(WCAG 2.3.1). 128 BPM은 초당 약 2.13회라 안전하지만, 8분음표 플래시는 4.27회로 위험합니다. 밝기 변화폭을 줄이거나 대상을 화면 일부로 한정하세요.
⑥ 인코딩을 고려하라
파티클과 노이즈가 격렬하게 움직이면 H.264 압축에서 블록 노이즈가 폭발합니다. 모션 블러를 적절히 넣고 비트레이트를 넉넉히 확보하세요.
⑦ 소리 없이 봐도 리듬이 느껴져야 한다
최고의 테스트입니다. 음소거하고 봤을 때 "여기서 무슨 일이 일어났는지" 보인다면 성공입니다.
🚀 7. 지금, 그리고 다음
최근 흐름은 '스펙트럼 반응'에서 '의미 반응'으로 이동 중입니다.
딥러닝 기반 음원 분리(source separation) 기술 — Demucs, Spleeter 등 — 은 완성된 믹스에서 보컬·드럼·베이스·기타를 개별 스템으로 분리해냅니다.
이 말은, 이제 "보컬이 들어올 때만 인물 실루엣이 나타나는" 수준의 정밀 연출이 원곡 스템 없이도 가능해졌다는 뜻입니다.
또한 코드 인식(chord recognition), 악기 분류, 감정 태깅 모델이 실용화되면서 "마이너 코드 구간은 차가운 청색, 메이저 전환에서 따뜻한 색으로"라는 화성 기반 색채 연출도 자동화되고 있습니다.
19세기 스크리아빈이 꿈꾼 '색채 오르간(clavier à lumières)'이 100년 뒤 알고리즘으로 구현되는 셈이죠.
그럼에도 변하지 않는 것
기술은 '언제' 반응할지를 정확히 알려줄 뿐입니다.
'무엇을 보여줄지'는 여전히 만드는 사람의 감각입니다. FFT는 킥이 쳤다는 사실만 알려주고, 그 순간 화면을 터뜨릴지 오히려 고요하게 비울지는 오로지 당신의 선택입니다.
음악 시각화는 결국 번역 작업입니다. 시간 속에서 흐르는 소리를, 공간 위의 빛으로 옮기는 일.
좋은 번역이 원문을 훼손하지 않고 그 결을 살려내듯, 좋은 비주얼은 음악을 덮지 않고 음악이 이미 품고 있던 이미지를 드러냅니다.
FFT 사이즈를 정하고, 온셋 임계값을 만지고, 오프셋을 10ms 단위로 조정하는 그 지루한 과정의 끝에서,
누군가가 "와, 이거 소름 돋는다"고 말한다면 — 그 순간 당신은 소리를 눈에 보이게 만든 사람이 된 겁니다.
이제 헤드폰을 쓰고(유선으로요!), 좋아하는 트랙을 걸고, 첫 번째 막대를 그려보세요.
모든 비주얼라이저는 그 한 줄에서 시작합니다. 🎵
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.