

Ver4.0 LabVIEW 그래픽 프로그래밍으로 구축하는 데이터 수집·측정·제어 시스템 실전 가이드
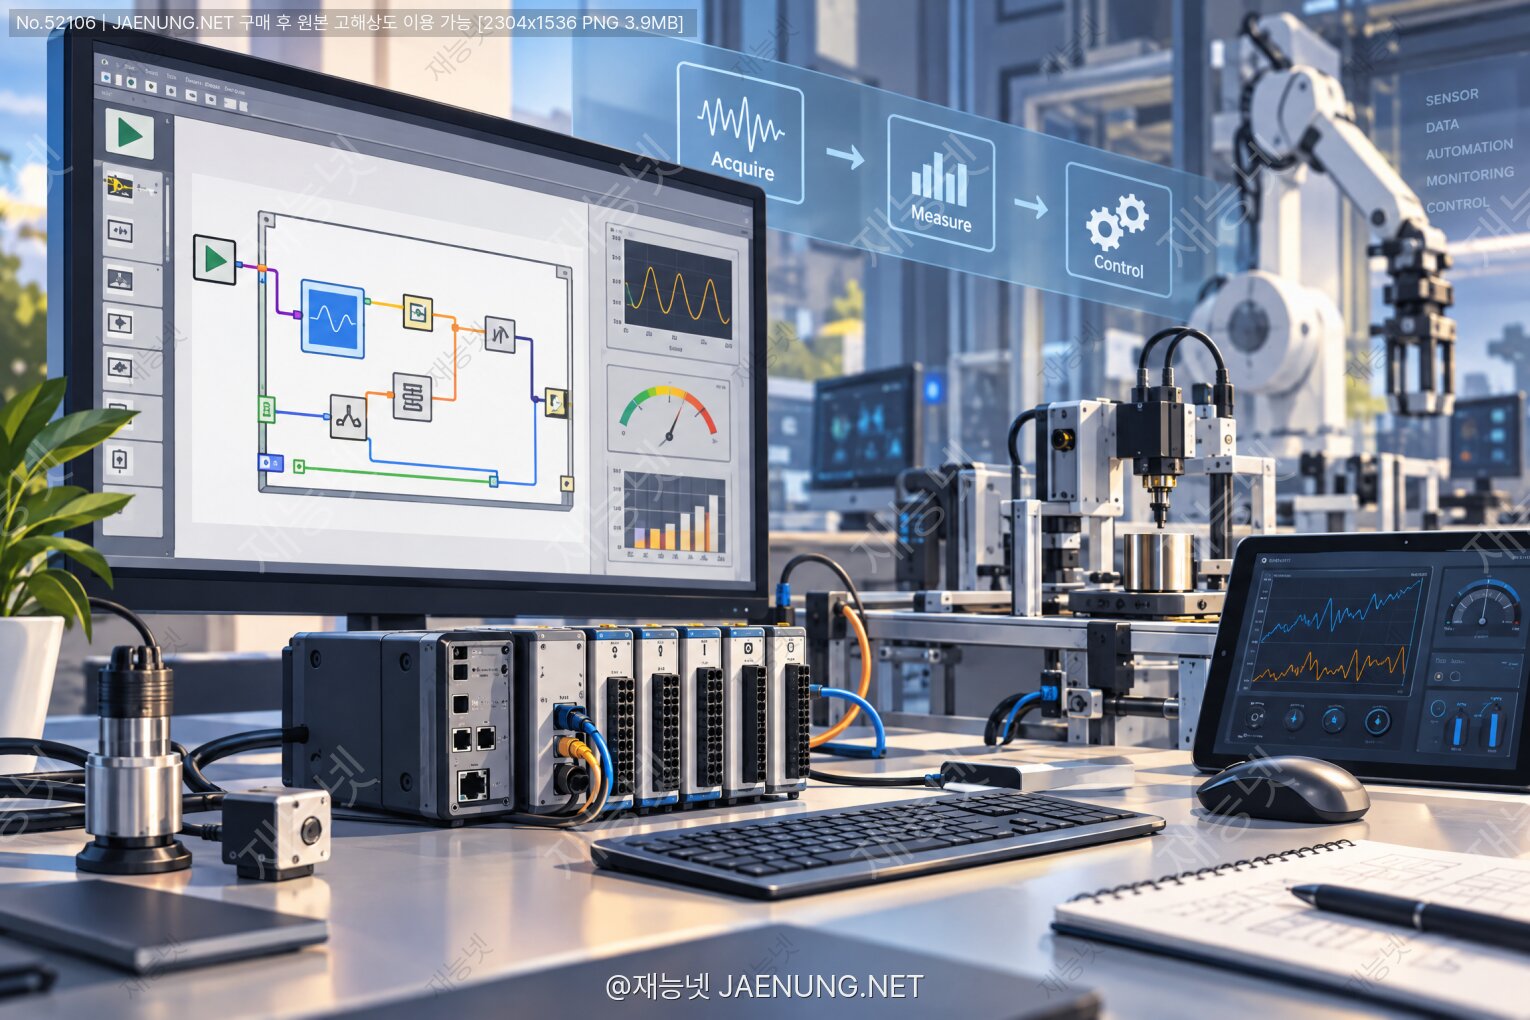
LabVIEW 그래픽 프로그래밍으로 구축하는 데이터 수집·측정·제어 시스템 실전 가이드
선(wire)으로 코딩한다고요? 네, 진짜로 그렇습니다
DAQ데이터플로우계측 자동화실시간 제어1. "코드를 그린다"는 그 말, 진짜였다
처음 LabVIEW 화면을 보면 대부분 반응이 똑같습니다. "이게 코드야 회로도야?" ㅋㅋㅋ
LabVIEW는 NI(National Instruments, 현재 Emerson 산하)가 1986년 Mac용으로 처음 내놓은 그래픽 기반 프로그래밍 환경입니다. 정식 명칭은 Laboratory Virtual Instrument Engineering Workbench. 이름부터 "실험실 가상계측기 엔지니어링 작업대"라는 정체성을 그대로 박아놨죠.
핵심 언어는 G(Graphical) 언어이고, 실행 모델은 데이터플로우(Dataflow)입니다. 텍스트 언어는 위에서 아래로 한 줄씩 흐르지만, LabVIEW는 "입력 데이터가 다 도착한 노드부터 실행"됩니다. 즉 순서가 아니라 의존성이 실행을 결정합니다.
여기서 나오는 개꿀 포인트
데이터 의존성이 없는 두 개의 블록은 자동으로 병렬 실행됩니다. 스레드를 직접 만들 필요가 없어요. 멀티코어 CPU에서 LabVIEW 런타임이 알아서 스케줄링해줍니다. C로 pthread 붙잡고 씨름하던 사람이 보면 살짝 억울해지는 부분 ㅋㅋ
VI: LabVIEW의 기본 단위
LabVIEW의 프로그램 단위는 VI(Virtual Instrument)이고, 세 부분으로 구성됩니다.
① Front Panel — 사용자 인터페이스. 노브, 그래프, 차트, 게이지 같은 계측기 느낌 컨트롤/인디케이터를 올립니다.
② Block Diagram — 실제 로직. 함수 노드와 와이어로 그립니다.
③ Icon / Connector Pane — 이 VI를 다른 VI에서 함수처럼 호출할 때 쓰는 입출력 단자. 이게 있어서 subVI = 함수 개념이 성립합니다.
2. 측정 시스템의 신호 여행 경로
측정 시스템은 결국 물리량 → 전기신호 → 디지털 값 → 화면/파일 이 흐름입니다. 그림으로 보면 바로 이해됩니다.
에일리어싱(Aliasing) 주의
샘플링 주파수가 부족하면 1kHz 신호가 50Hz처럼 보이는 가짜 신호가 생깁니다. 이건 소프트웨어 필터로 절대 못 살립니다. ADC 앞단 아날로그 로우패스 필터가 유일한 해답이에요. "그래프가 이상한데 코드 버그인가?" 싶을 때 90%는 여기 문제 ㅋㅋㅋ
3. NI-DAQmx: 데이터 수집의 중심 축
LabVIEW로 하드웨어에서 값을 읽는 표준 경로는 NI-DAQmx 드라이버입니다. 개념 모델이 상당히 깔끔합니다.
Task(태스크)가 최상위 개념이고, 그 안에 Channel(채널), 그리고 Timing, Trigger 설정이 붙습니다. 이걸 순서대로 호출하는 흐름이 바로 DAQmx 표준 5단계입니다.
| 단계 | 함수 | 하는 일 |
|---|---|---|
| 1 | Create Virtual Channel | 물리 채널(Dev1/ai0)을 측정 타입과 범위로 정의 |
| 2 | Timing (Sample Clock) | 샘플링 레이트, 샘플 수, 유한/연속 모드 지정 |
| 3 | Start Task | 하드웨어 실제 가동 |
| 4 | Read | 버퍼에서 데이터 꺼내기 (루프 안에서 반복) |
| 5 | Clear Task | 자원 해제. 안 하면 다음 실행 때 리소스 점유 에러 |
샘플링 모드 3종
On Demand(소프트웨어 타이밍) — 읽을 때마다 한 점. 온도처럼 느린 신호에만. 타이밍 정확도는 OS 스케줄러 운빨 ㅋㅋ
Finite Samples — "10kS/s로 5만 점" 같이 정해진 양만. 충격시험, 단발 파형 캡처용.
Continuous Samples — 무한 스트리밍. DMA로 순환 버퍼에 계속 쌓고, 코드가 계속 꺼내가는 구조.
연속 수집의 최대 적: 버퍼 오버플로
하드웨어는 계속 채우는데 코드가 못 꺼내가면 -200279 에러("The application is not able to keep up with the hardware acquisition")를 만납니다. 원인은 대개 수집 루프 안에서 파일 저장이나 무거운 분석·UI 업데이트를 같이 하는 것. 해결책은 아래 4장의 프로듀서-컨슈머 구조입니다.
[의사코드로 본 DAQmx 연속 수집 구조]

Create AI Voltage Chan (Dev1/ai0:3, ±10V, RSE)
Cfg Samp Clk Timing (rate=25600, mode=Continuous, buffer=rate*5)
Cfg Digital Edge Start Trigger (PFI0, Rising)   ' 필요 시
Start Task
While (not stop)
    DAQmx Read (N samples x M channels)  ->  Queue.Enqueue
End
Clear Task
접지 방식, 생각보다 중요함
아날로그 입력 결선 모드는 세 가지입니다.
Differential: +/- 두 선을 모두 읽어 공통모드 노이즈를 상쇄. 정확도 1티어.
RSE(Referenced Single-Ended): DAQ 장치 접지 기준. 채널 수 2배로 쓸 수 있음.
NRSE: AI SENSE 단자 기준.
플로팅 소스(배터리, 열전대)는 RSE, 접지된 소스(전원 출력)는 Differential이 정석입니다. 이거 잘못 잡으면 60Hz 험(hum)이 파형에 아주 예쁘게 올라탑니다 ㅋㅋㅋ
4. 아키텍처: 실무는 결국 구조 싸움
LabVIEW 초보 코드의 특징은 While 루프 하나에 모든 걸 다 넣기입니다. 동작은 하는데, 조금만 복잡해지면 바로 무너집니다.
① 상태 머신(State Machine)
While 루프 + Case 구조 + Shift Register 조합. 각 케이스가 하나의 상태를 처리하고, 다음 상태를 시프트 레지스터로 넘깁니다.
Init → Config → Acquire → Analyze → Log → Idle → Shutdown② 프로듀서-컨슈머(Producer-Consumer)
병렬 While 루프 두 개를 Queue로 연결합니다.
프로듀서 루프: DAQmx Read만 미친 속도로 반복 → 큐에 넣기.
컨슈머 루프: 큐에서 꺼내서 TDMS 저장, FFT 분석, 그래프 갱신.
이렇게 분리하면 저장이 잠깐 느려도 수집이 안 끊깁니다. 큐가 탄성 버퍼(elastic buffer) 역할을 하죠. 대용량 측정 시스템의 사실상 표준 구조.
③ QMH (Queued Message Handler)
상태 머신 + 프로듀서-컨슈머의 합체. 큐로 "문자열 메시지 + 데이터"를 주고받아 UI 루프와 처리 루프를 분리합니다. LabVIEW에 템플릿으로 기본 내장돼 있어서 신규 프로젝트는 여기서 시작하는 게 합리적입니다.
그래프 렉 잡는 현실 팁
100만 포인트를 Waveform Graph에 그대로 꽂으면 UI가 그냥 얼어붙습니다. 모니터 픽셀은 1000~2000개인데 100만 점을 그릴 이유가 없죠. 데시메이션(Decimate 1D Array)으로 화면 폭 정도까지 줄여서 그리면 체감 속도가 확 달라집니다. 저장은 원본 풀데이터로, 표시는 축약본으로 ㅇㅋ
5. 데이터 저장: TDMS를 쓰는 이유
측정 데이터를 CSV로 저장하면 편하긴 한데, 초당 수십만 포인트 들어오는 상황에서는 텍스트 변환 비용이 병목이 됩니다.
TDMS(Technical Data Management Streaming)는 NI의 바이너리 스트리밍 포맷으로, 3계층 구조를 가집니다.
File → Group → Channel. 각 레벨에 임의의 속성(Property)을 붙일 수 있어서 데이터와 메타데이터가 한 파일에 들어갑니다. 측정 날짜, 센서 감도, 시험 조건, 작업자 이름까지요. 몇 달 뒤에 파일 열어봤을 때 "이게 뭐였지"가 안 생기는 게 진짜 가치입니다.
| 비교 | CSV | TDMS |
|---|---|---|
| 쓰기 속도 | 느림(텍스트 변환) | 빠름(바이너리 스트리밍) |
| 파일 크기 | 큼 | 작음 |
| 메타데이터 | 헤더 한 줄이 전부 | 계층별 무제한 속성 |
| 범용성 | 어디서나 열림 | Excel 애드인·Python npTDMS 필요 |
중간에 프로그램이 죽어서 파일이 깨진 것 같으면 TDMS Defragment를 돌려보면 인덱스가 정리되는 경우가 많습니다. 알아두면 언젠가 한 번은 구원받습니다 ㅋㅋ
6. 제어와 실시간: 그냥 Windows로는 안 되는 영역
측정만 하면 편하지만, 보통 측정하고 판단해서 출력까지 요구받습니다. 여기서 결정론(determinism) 문제가 튀어나옵니다.
Windows는 범용 OS라 어느 순간 업데이트 검사나 백신이 CPU를 채가면 루프 주기가 밀립니다. 평균 1ms여도 최악에 50ms 튀면, 그건 제어 시스템으로서 실격이죠.
RT와 FPGA
LabVIEW Real-Time: NI Linux Real-Time 기반 타깃(cRIO, PXI)에서 실행. Timed Loop로 주기를 보장하고, 지터(jitter)를 마이크로초 단위로 관리합니다. 수 kHz급 제어 루프에 적합.
LabVIEW FPGA: G 코드를 Xilinx FPGA용 하드웨어 로직으로 컴파일. 클럭 단위(40MHz 기준 25ns) 결정론, 수십~수백 kHz PID, 하드웨어 인터록, 커스텀 통신 프로토콜 구현까지 가능합니다. 대신 컴파일에 수십 분 걸리는 건 감수해야 합니다 ㅋㅋㅋ
3계층 배분 원칙
FPGA는 초고속·안전 인터록, RT는 제어 루프와 상태 관리, Windows(HMI)는 화면·리포트·DB 연동. 이 분업이 산업용 LabVIEW 시스템의 정석 구조입니다. UI를 RT에 올리려는 시도는... 하지 마세요.
제어 출력 채널들
AO(아날로그 출력): 밸브 개도, 히터 파워, 모터 지령 등 연속량.
DO(디지털 출력): 릴레이, 솔레노이드, 알람.
카운터/타이머: 엔코더 읽기, PWM 생성, 주파수 측정.
PID 제어: Control Design & Simulation 모듈 또는 PID Toolkit으로 구현. 제어 주기를 반드시 하드웨어 클럭에 동기시켜야 튜닝 값이 일관됩니다.
7. 계측기 제어와 통신 계층
DAQ 보드 말고 오실로스코프, 파워서플라이, 전자로드 같은 완제품 계측기를 붙일 때는 NI-VISA를 씁니다.
VISA는 GPIB, USB, 시리얼(RS-232/485), Ethernet(TCP/IP), PXI를 동일한 API로 추상화하는 계층입니다. 연결 방식이 바뀌어도 코드 구조는 그대로 두고 리소스 이름만 갈면 됩니다.
명령 체계는 대부분 SCPI 표준 문자열입니다.
*IDN?                     ' 기기 식별 (연결 확인 1번 타자)
MEAS:VOLT:DC? 10,0.001    ' DC 전압 측정, 범위 10V 분해능 1mV
VOLT 5.0 ; OUTP ON        ' 전원공급기 5V 설정 후 출력 ON
SYST:ERR?                 ' 에러 큐 확인 (디버깅 필수)
실무 순서는 VISA Open → Write → Read → Close. 여기에 Termination Character(보통 \n)와 timeout 설정을 정확히 맞추는 게 통신 이슈 대부분의 해법입니다. 응답이 안 온다고 코드를 뒤집기 전에 NI MAX의 VISA Test Panel에서 직접 명령을 쳐보는 게 훨씬 빠릅니다.
산업 현장 연동이라면 Modbus TCP/RTU, OPC UA, EtherCAT, CAN/XNET도 자주 등장합니다. 특히 자동차 시험 분야는 CAN이 거의 기본값이라고 보면 됩니다.
8. 신호 분석: LabVIEW의 숨은 강점
측정만 하고 끝나면 반쪽입니다. LabVIEW는 계측 도메인 분석 함수가 기본 탑재라 이 부분이 강력합니다.
FFT / 파워 스펙트럼: 진동·소음 분석의 기본. 윈도잉(Hanning, Flat Top, Blackman)을 상황에 맞게 골라야 합니다. 진폭 정확도가 중요하면 Flat Top, 주파수 분리가 중요하면 Hanning.
디지털 필터: Butterworth, Chebyshev, Elliptic, FIR. 위상 왜곡이 곤란하면 zero-phase 처리 고려.
커브 피팅·통계: 선형/다항/비선형 회귀, RMS, 표준편차, 히스토그램.
오더 분석·옥타브 분석: Sound & Vibration 툴킷 영역.
스펙트럼 누설(Leakage)
신호 주기와 수집 구간이 정수배로 안 맞으면 FFT 피크가 옆으로 퍼집니다. 윈도우 함수를 적용하지 않으면 진폭이 최대 36% 정도 낮게 나올 수도 있어요. "측정값이 이론보다 계속 작게 나온다" 하면 윈도우 설정부터 확인 ㅇㅇ
9. 실무 함정 모음 (경험치 절약 구간)
와이어 스파게티 — 블록 다이어그램이 화면 3개를 넘어가면 이미 망한 겁니다. subVI로 쪼개세요. 한 화면 안에 들어오는 게 원칙.
Local Variable 남용 — 텍스트 언어의 전역변수처럼 쓰면 레이스 컨디션이 생깁니다. 재현 안 되는 버그의 주범. 데이터는 와이어로, 공유가 필요하면 큐나 FGV(Functional Global Variable)로.
에러 와이어 방치 — LabVIEW 에러 클러스터는 귀찮아도 반드시 연결해야 합니다. 안 하면 DAQ가 실패해도 조용히 0만 뱉습니다. 최악의 시나리오죠.
루프에 Wait 없음 — UI 루프에 Wait(ms) 안 넣으면 CPU 코어 하나가 100%로 돌아갑니다. UI 루프는 50~100ms면 충분합니다.
배열 Build 누적 — 루프 안에서 Build Array로 계속 키우면 메모리 재할당이 반복돼 점점 느려집니다. Initialize Array로 미리 잡고 Replace Subset이 정석.
Express VI 의존 — 빨리 만들기는 좋지만 성능·확장성이 떨어집니다. 프로토타입까지만 쓰고, 실제 제품은 저수준 DAQmx API로 재작성하는 걸 권합니다.
Q. LabVIEW는 이제 안 쓰는 기술 아닌가요?
A. 웹·앱 개발 쪽에선 존재감이 없지만, 반도체 ATE, 자동차 HIL, 항공우주 시험, 배터리 사이클러, 계측 자동화 분야에서는 여전히 강력한 표준입니다. 하드웨어 드라이버 생태계와 계측 도메인 함수 라이브러리가 축적된 자산이라 쉽게 대체되지 않습니다. 최근에는 Python 연동(Python Node), Git 친화적 관리, LabVIEW NXG 종료 후 CG(Current Gen) 집중 전략으로 흐름이 정리됐습니다.
Q. Python으로 다 되지 않나요?
A. 되긴 됩니다(nidaqmx, pyvisa). 다만 멀티 채널 동기 수집, 하드웨어 트리거, RT/FPGA 결정론 제어, 그리고 계측기 느낌 UI를 30분 만에 만드는 속도에서는 LabVIEW가 여전히 우위입니다. 요즘은 수집·제어는 LabVIEW, 후처리·ML은 Python 하이브리드가 가장 현실적인 답입니다.
10. 학습 로드맵과 마무리
순서를 이렇게 잡으면 헤매지 않습니다.
1주차 — 데이터플로우 개념, While/For 루프, Shift Register, 클러스터와 배열 구분.
2~3주차 — 상태 머신 패턴, subVI 분리, 에러 핸들링 습관화.
4~6주차 — DAQmx 저수준 API로 연속 수집 구현, 프로듀서-컨슈머 + 큐, TDMS 저장.
이후 — VISA 계측기 제어, FFT/필터 분석, 그리고 필요에 따라 RT/FPGA.
공인 자격은 CLAD → CLD → CLA 순서인데, CLAD 정도는 개념 정리용으로 충분히 가치 있습니다.
LabVIEW의 본질은 "쉬운 프로그래밍"이 아니라 계측·제어라는 도메인에 최적화된 사고 방식입니다. 신호 체인을 이해하고, 타이밍을 하드웨어에 맡기고, 구조로 병목을 해결하는 감각. 이게 잡히면 그 지식은 다른 언어로 옮겨가도 그대로 쓸 수 있습니다.
혹시 진행 중인 프로젝트에서 DAQ 구성이나 아키텍처 선택이 막혔다면, 재능넷 같은 재능 공유 플랫폼에서 계측 자동화 실무 경험자에게 직접 피드백을 받아보는 것도 시간 절약에 꽤 효과적입니다. 하드웨어가 얽힌 문제는 구글링보다 경험자 한 마디가 빠를 때가 많거든요 ㅋㅋ
와이어 하나 잘못 꽂아서 반나절 날려본 사람들끼리는 이미 동료입니다. 그 삽질이 결국 시스템 보는 눈이 되니까요. 즐거운 계측 되시길 🙂
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.









댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.