
Ver3.5 🧠 TensorFlow로 뚝딱! 텍스트 분류 모델 처음부터 끝까지 만들어보기
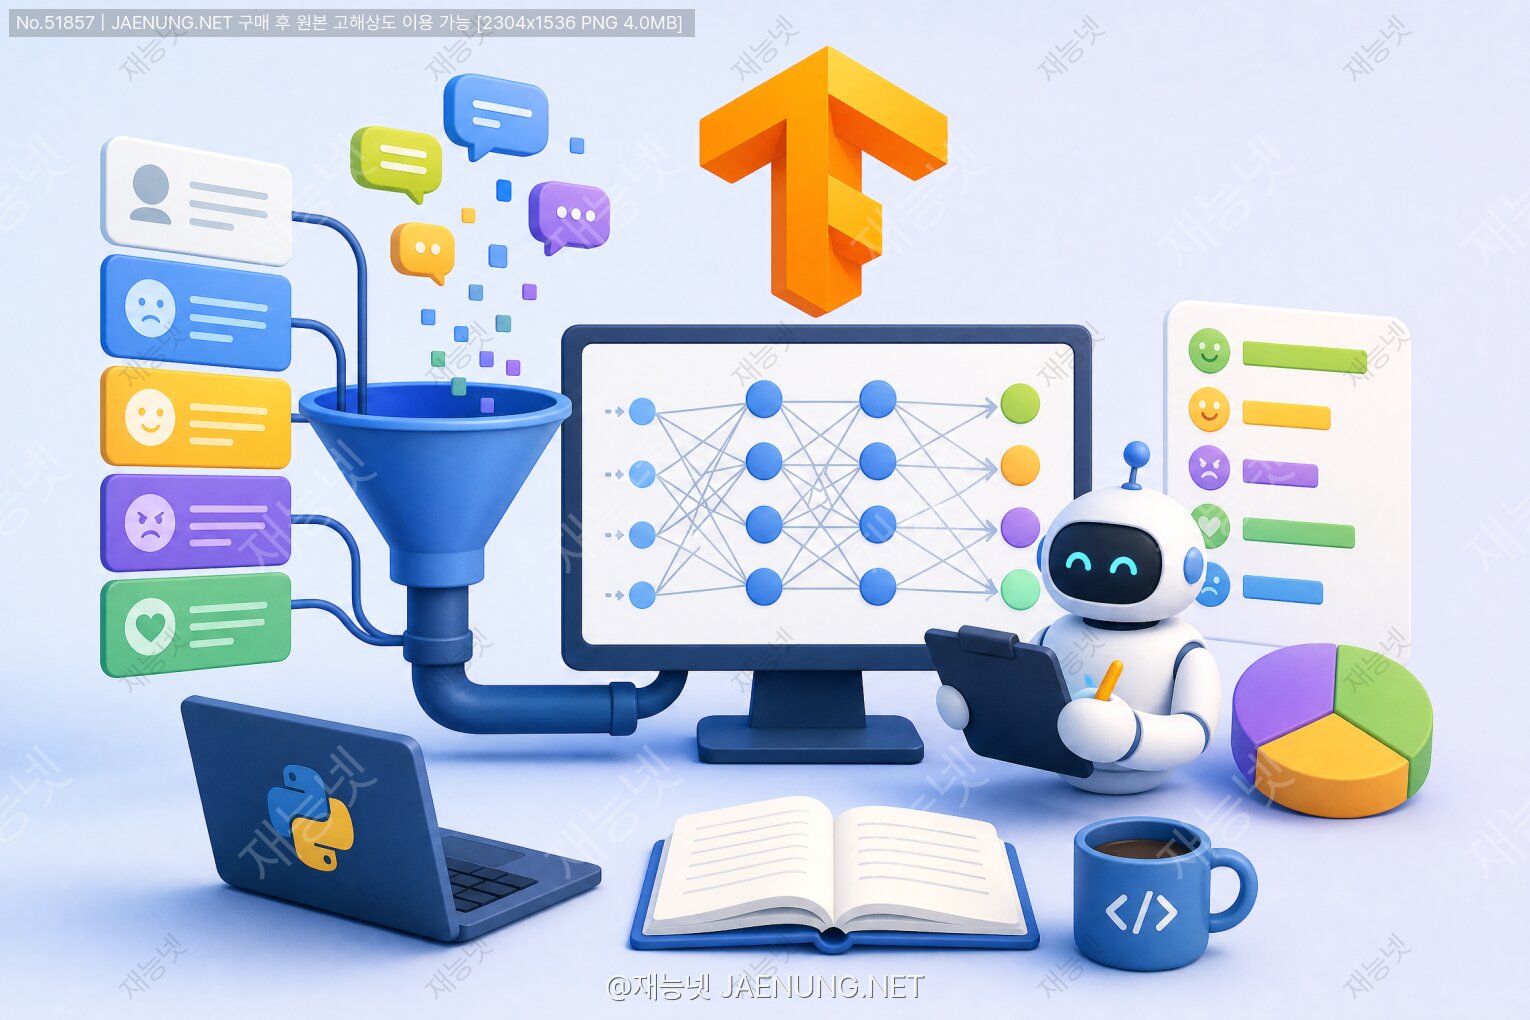
🧠 TensorFlow로 뚝딱! 텍스트 분류 모델 처음부터 끝까지 만들어보기
딥러닝이 처음이어도 괜찮아 — 코드 한 줄씩 같이 따라가 보자 🚀
안녕! 오늘은 TensorFlow를 이용해서 텍스트 분류 모델을 처음부터 끝까지 만들어볼 거야.
"텍스트 분류"라고 하면 뭔가 어렵게 들릴 수 있는데, 사실 우리 일상에서 엄청 많이 쓰이는 기술이야. 🤔
예를 들어볼게:
🎬 영화 리뷰 감성 분석 — "이 리뷰가 긍정적인가, 부정적인가?"
📰 뉴스 카테고리 분류 — "이 기사가 스포츠인가, 정치인가, 경제인가?"
💬 고객 문의 자동 분류 — "이 문의가 환불 요청인가, 배송 문의인가?"
이 모든 게 다 텍스트 분류(Text Classification)야!
텍스트를 입력받아서 미리 정해진 카테고리 중 하나로 분류하는 작업이지.
그리고 이걸 딥러닝으로 구현하면 사람이 일일이 규칙을 짜지 않아도 모델이 알아서 패턴을 학습해서 분류해줘. 완전 신기하지? 😎
코드를 짜기 전에 환경부터 맞춰야겠지? 걱정 마, 엄청 간단해.
요즘은 Google Colab을 쓰면 별도 설치 없이 바로 TensorFlow를 쓸 수 있어서 진짜 편해. 🙌
| 도구 | 버전 | 설명 |
|---|---|---|
| Python | 3.8 이상 | 기본 프로그래밍 언어 |
| TensorFlow | 2.10 이상 | 딥러닝 프레임워크 (Keras 포함) |
| NumPy | 1.21 이상 | 수치 연산 라이브러리 |
| Matplotlib | 3.5 이상 | 학습 결과 시각화 |
로컬 환경에서 작업한다면 터미널에서 이렇게 입력해:
pip install tensorflow numpy matplotlibGoogle Colab을 쓴다면? 이미 다 설치되어 있어! 그냥 바로 import하면 돼. 👍
import tensorflow as tf
import numpy as np
import matplotlib.pyplot as plt

print(f"TensorFlow 버전: {tf.__version__}")
# 출력 예시: TensorFlow 버전: 2.13.0tf.keras로 바로 접근 가능해!
오늘 사용할 데이터셋은 IMDB Movie Reviews Dataset이야.
이건 영화 리뷰 50,000개로 구성된 데이터셋인데, TensorFlow에 기본으로 내장되어 있어서 따로 다운받을 필요가 없어. 완전 편하지? 😄
📚 훈련 데이터: 25,000개 (긍정 12,500개 + 부정 12,500개)
🧪 테스트 데이터: 25,000개 (긍정 12,500개 + 부정 12,500개)
🏷️ 레이블: 0 = 부정(Negative), 1 = 긍정(Positive)
데이터는 이미 숫자로 인코딩되어 있어.
즉, 각 단어가 정수 인덱스로 변환된 상태야. 예를 들어 "the"는 1, "movie"는 17 이런 식으로.
이렇게 하면 컴퓨터가 텍스트를 처리하기 훨씬 쉬워져!
from tensorflow.keras.datasets import imdb

# 상위 10,000개 단어만 사용 (빈도 기준)
vocab_size = 10000

(train_data, train_labels), (test_data, test_labels) = imdb.load_data(
    num_words=vocab_size
)

print(f"훈련 데이터 수: {len(train_data)}")
print(f"테스트 데이터 수: {len(test_data)}")
print(f"첫 번째 리뷰 (숫자 인코딩): {train_data[0][:20]}...")
print(f"첫 번째 리뷰 레이블: {train_labels[0]}")

# 출력:
# 훈련 데이터 수: 25000
# 테스트 데이터 수: 25000
# 첫 번째 리뷰 (숫자 인코딩): [1, 14, 22, 16, 43, 530, 973, ...]
# 첫 번째 리뷰 레이블: 1 (긍정!)숫자로만 보면 뭔지 모르니까, 실제 단어로 복원해서 확인해보자!
# 단어 인덱스 딕셔너리 가져오기
word_index = imdb.get_word_index()

# 인덱스 → 단어 역방향 딕셔너리 만들기
# 실제 인덱스는 3씩 오프셋이 있어 (0=패딩, 1=시작, 2=알수없음)
reverse_word_index = {value + 3: key for key, value in word_index.items()}
reverse_word_index[0] = "<PAD>"
reverse_word_index[1] = "<START>"
reverse_word_index[2] = "<UNK>"

# 첫 번째 리뷰 복원
def decode_review(encoded_review):
    return " ".join([reverse_word_index.get(i, "?") for i in encoded_review])

print(decode_review(train_data[0][:50]))
# 출력: <START> this film was just brilliant casting location scenery...
각 리뷰의 길이가 다 달라. 어떤 건 짧고 어떤 건 엄청 길어.
이걸 확인해야 나중에 패딩 길이를 결정할 수 있어!
lengths = [len(review) for review in train_data]
print(f"평균 리뷰 길이: {np.mean(lengths):.0f} 단어")
print(f"최대 리뷰 길이: {max(lengths)} 단어")
print(f"최소 리뷰 길이: {min(lengths)} 단어")
print(f"중앙값: {np.median(lengths):.0f} 단어")

# 출력:
# 평균 리뷰 길이: 238 단어
# 최대 리뷰 길이: 2494 단어
# 최소 리뷰 길이: 11 단어
# 중앙값: 178 단어
딥러닝 모델은 모든 입력 데이터의 크기가 같아야 해.
근데 리뷰마다 길이가 다르잖아? 어떤 건 20단어, 어떤 건 2000단어.
이걸 해결하는 게 바로 패딩(Padding)이야! 🎯
패딩은 짧은 시퀀스에 0을 채워서 길이를 맞추는 거야.
반대로 너무 긴 시퀀스는 잘라내기도 해. 이걸 트런케이션(Truncation)이라고 해.
from tensorflow.keras.preprocessing.sequence import pad_sequences

# 최대 길이 설정 (평균 길이 근처로 설정하는 게 일반적)
max_length = 256

# 패딩 처리
# padding='post': 뒤에 0을 채움
# truncating='post': 뒤를 잘라냄
train_data_padded = pad_sequences(
    train_data,
    maxlen=max_length,
    padding='post',
    truncating='post'
)

test_data_padded = pad_sequences(
    test_data,
    maxlen=max_length,
    padding='post',
    truncating='post'
)

print(f"패딩 후 훈련 데이터 shape: {train_data_padded.shape}")
print(f"패딩 후 테스트 데이터 shape: {test_data_padded.shape}")

# 출력:
# 패딩 후 훈련 데이터 shape: (25000, 256)
# 패딩 후 테스트 데이터 shape: (25000, 256)pre: 앞에 0을 채움 → [0, 0, 0, 14, 17, 43]-
post: 뒤에 0을 채움 → [14, 17, 43, 0, 0, 0]LSTM 계열 모델은
pre가 더 좋을 때도 있고, 단순 Dense 모델은 어느 쪽이든 크게 차이 없어. 실험해보는 게 최고!
import numpy as np

# 레이블을 numpy 배열로 변환
train_labels = np.array(train_labels)
test_labels = np.array(test_labels)

print(f"훈련 레이블 shape: {train_labels.shape}")
print(f"긍정 리뷰 수: {np.sum(train_labels == 1)}")
print(f"부정 리뷰 수: {np.sum(train_labels == 0)}")

# 출력:
# 훈련 레이블 shape: (25000,)
# 긍정 리뷰 수: 12500
# 부정 리뷰 수: 12500
완벽하게 균형 잡힌 데이터셋이야! 긍정 50%, 부정 50%.
이런 경우엔 클래스 불균형 문제를 걱정 안 해도 돼. 👌
훈련 중에 모델이 잘 학습되고 있는지 확인하려면 검증 데이터(Validation Data)가 필요해.
훈련 데이터의 일부를 떼어서 검증용으로 쓰자!
# 훈련 데이터의 20%를 검증 데이터로 사용
val_size = 5000

x_val = train_data_padded[:val_size]
y_val = train_labels[:val_size]

x_train = train_data_padded[val_size:]
y_train = train_labels[val_size:]

print(f"실제 훈련 데이터: {x_train.shape}")
print(f"검증 데이터: {x_val.shape}")

# 출력:
# 실제 훈련 데이터: (20000, 256)
# 검증 데이터: (5000, 256)
이제 진짜 재밌는 부분이야! 🎉
텍스트 분류에 쓸 수 있는 모델 구조가 여러 가지 있는데, 오늘은 세 가지를 소개할게.
각각 장단점이 있으니까 상황에 맞게 골라 쓰면 돼!
가장 단순한 구조야. Embedding 레이어로 단어를 벡터로 변환하고,
GlobalAveragePooling으로 평균을 내서 Dense 레이어로 분류해.
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import (
    Embedding, GlobalAveragePooling1D, Dense, Dropout
)

embedding_dim = 64  # 각 단어를 64차원 벡터로 표현

model_dense = Sequential([
    # 임베딩 레이어: 단어 인덱스 → 밀집 벡터
    Embedding(
        input_dim=vocab_size,      # 어휘 크기 (10,000)
        output_dim=embedding_dim,  # 임베딩 차원 (64)
        input_length=max_length    # 입력 시퀀스 길이 (256)
    ),

    # 시퀀스 전체를 평균 내서 고정 크기 벡터로 만들기
    GlobalAveragePooling1D(),

    # 완전 연결 레이어
    Dense(64, activation='relu'),
    Dropout(0.3),  # 과적합 방지

    # 출력 레이어 (이진 분류 → sigmoid)
    Dense(1, activation='sigmoid')
])

model_dense.summary()🔹 GlobalAveragePooling1D → 출력: (None, 64)
🔹 Dense(64, relu) → 출력: (None, 64)
🔹 Dropout(0.3) → 출력: (None, 64)
🔹 Dense(1, sigmoid) → 출력: (None, 1)
총 파라미터: 약 650,000개
LSTM(Long Short-Term Memory)은 텍스트의 순서 정보를 활용하는 모델이야.
"나는 영화를 좋아해"와 "나는 영화를 싫어해"는 단어 순서가 중요하잖아?
LSTM은 이런 순서 의존성을 잘 포착해!
from tensorflow.keras.layers import LSTM, Bidirectional

model_lstm = Sequential([
    Embedding(
        input_dim=vocab_size,
        output_dim=embedding_dim,
        input_length=max_length
    ),

    # Bidirectional LSTM: 앞뒤 방향 모두 처리
    Bidirectional(LSTM(64, return_sequences=False)),

    Dense(64, activation='relu'),
    Dropout(0.4),

    Dense(1, activation='sigmoid')
])

model_lstm.summary()
1D 합성곱 신경망(Conv1D)은 이미지 분류에서 쓰는 CNN을 텍스트에 적용한 거야.
특정 패턴(n-gram)을 효율적으로 포착하고, LSTM보다 훈련 속도가 빨라!
from tensorflow.keras.layers import Conv1D, MaxPooling1D, GlobalMaxPooling1D

model_conv = Sequential([
    Embedding(
        input_dim=vocab_size,
        output_dim=embedding_dim,
        input_length=max_length
    ),

    # 1D 합성곱: 3개 단어씩 패턴 포착
    Conv1D(128, 5, activation='relu'),
    MaxPooling1D(pool_size=2),

    Conv1D(64, 3, activation='relu'),
    GlobalMaxPooling1D(),

    Dense(64, activation='relu'),
    Dropout(0.3),

    Dense(1, activation='sigmoid')
])

model_conv.summary()| 모델 | 장점 | 단점 | 추천 상황 |
|---|---|---|---|
| Dense | 빠름, 단순 | 순서 정보 무시 | 빠른 베이스라인 |
| LSTM | 순서 정보 활용 | 느림, 메모리 많이 씀 | 긴 텍스트, 문맥 중요 |
| Conv1D | 빠름, 패턴 포착 우수 | 장거리 의존성 약함 | 짧은 텍스트, 속도 중요 |
모델 구조를 만들었으면 이제 컴파일하고 훈련시켜야 해!
컴파일 단계에서는 손실 함수, 옵티마이저, 평가 지표를 설정해.
# Conv1D 모델로 진행 (속도와 성능 균형이 좋아서!)
model = model_conv

model.compile(
    optimizer='adam',                    # Adam 옵티마이저
    loss='binary_crossentropy',          # 이진 분류 손실 함수
    metrics=['accuracy']                 # 정확도 측정
)

print("모델 컴파일 완료! ✅")Adam(Adaptive Moment Estimation)은 학습률을 자동으로 조절해주는 스마트한 옵티마이저야. 대부분의 경우 Adam이 기본값으로 좋은 성능을 내.
📌 loss='binary_crossentropy'
이진 분류(0 또는 1)에 사용하는 손실 함수야. 모델의 예측이 실제 레이블과 얼마나 다른지 측정해. 값이 낮을수록 좋아!
📌 metrics=['accuracy']
훈련 중에 정확도를 모니터링해. 전체 예측 중 맞은 비율이야.
콜백(Callback)은 훈련 중에 특정 조건에서 자동으로 실행되는 함수야.
두 가지 중요한 콜백을 설정해보자!
from tensorflow.keras.callbacks import EarlyStopping, ModelCheckpoint

callbacks = [
    # 검증 손실이 개선되지 않으면 조기 종료
    EarlyStopping(
        monitor='val_loss',    # 검증 손실 모니터링
        patience=3,            # 3 에포크 동안 개선 없으면 종료
        restore_best_weights=True  # 최고 성능 가중치로 복원
    ),

    # 최고 성능 모델 저장
    ModelCheckpoint(
        filepath='best_model.keras',
        monitor='val_accuracy',
        save_best_only=True,
        verbose=1
    )
]

print("콜백 설정 완료! 🎯")history = model.fit(
x_train, y_train,
epochs=20, # 최대 20 에포크
batch_size=512, # 배치 크기
validation_data=(x_val, y_val),
callbacks=callbacks,
verbose=1
)
# 훈련 출력 예시:
# Epoch 1/20
# 40/40 [==============================] - 8s 180ms/step
# loss: 0.6931 - accuracy: 0.5012 - val_loss: 0.6928 - val_accuracy: 0.5024
# ...
# Epoch 8/20
# 40/40 [==============================] - 6s 150ms/step
# loss: 0.2341 - accuracy: 0.9123 - val_loss: 0.2876 - val_accuracy: 0.8834
# Epoch 11/20 - EarlyStopping 발동!
# 훈련 조기 종료 (val_loss 개선 없음)훈련이 끝나면 학습 곡선을 그려서 모델이 잘 학습됐는지 확인해보자!
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# 정확도 그래프
axes[0].plot(history.history['accuracy'], label='훈련 정확도', color='#7eb8d4')
axes[0].plot(history.history['val_accuracy'], label='검증 정확도', color='#f0a060')
axes[0].set_title('모델 정확도', fontsize=14, fontweight='bold')
axes[0].set_xlabel('에포크')
axes[0].set_ylabel('정확도')
axes[0].legend()
axes[0].grid(True, alpha=0.3)

# 손실 그래프
axes[1].plot(history.history['loss'], label='훈련 손실', color='#7eb8d4')
axes[1].plot(history.history['val_loss'], label='검증 손실', color='#f0a060')
axes[1].set_title('모델 손실', fontsize=14, fontweight='bold')
axes[1].set_xlabel('에포크')
axes[1].set_ylabel('손실')
axes[1].legend()
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.savefig('training_history.png', dpi=150, bbox_inches='tight')
plt.show()
훈련이 끝났으면 테스트 데이터로 최종 성능을 평가해야 해!
테스트 데이터는 훈련 중에 한 번도 본 적 없는 데이터라서 진짜 실력을 알 수 있어. 🎯
test_loss, test_accuracy = model.evaluate(
    test_data_padded, test_labels,
    verbose=1
)

print(f"\n📊 최종 테스트 결과")
print(f"테스트 손실: {test_loss:.4f}")
print(f"테스트 정확도: {test_accuracy:.4f} ({test_accuracy*100:.2f}%)")

# 출력 예시:
# 782/782 [==============================] - 3s 4ms/step
# 테스트 손실: 0.2934
# 테스트 정확도: 0.8876 (88.76%)정확도 하나만 보는 건 부족해. 더 자세한 분석을 해보자!
from sklearn.metrics import classification_report, confusion_matrix
import seaborn as sns

# 예측값 생성
y_pred_prob = model.predict(test_data_padded)
y_pred = (y_pred_prob > 0.5).astype(int).flatten()

# 분류 리포트
print(classification_report(
    test_labels, y_pred,
    target_names=['부정(Negative)', '긍정(Positive)']
))

# 출력 예시:
#                    precision  recall  f1-score  support
# 부정(Negative)       0.89      0.88      0.89     12500
# 긍정(Positive)       0.88      0.89      0.89     12500
# accuracy                               0.89     25000
# macro avg            0.89      0.89      0.89     25000

# 혼동 행렬
cm = confusion_matrix(test_labels, y_pred)
print(f"\n혼동 행렬:")
print(f"진짜 부정 → 부정 예측: {cm[0][0]:,}개 (True Negative)")
print(f"진짜 부정 → 긍정 예측: {cm[0][1]:,}개 (False Positive)")
print(f"진짜 긍정 → 부정 예측: {cm[1][0]:,}개 (False Negative)")
print(f"진짜 긍정 → 긍정 예측: {cm[1][1]:,}개 (True Positive)")→ 높을수록 거짓 긍정(False Positive)이 적어
🎯 Recall (재현율): "실제 긍정 중 긍정이라고 예측한 비율"
→ 높을수록 놓치는 긍정(False Negative)이 적어
🎯 F1-Score: Precision과 Recall의 조화 평균
→ 두 지표를 균형 있게 반영한 종합 점수
이제 진짜 재밌는 부분! 직접 영화 리뷰를 써서 모델이 긍정/부정을 맞추는지 테스트해보자! 🍿
def predict_sentiment(review_text, model, word_index, max_len=256):
    """
    텍스트 리뷰를 입력받아 감성을 예측하는 함수
    """
    # 1. 텍스트 전처리
    review_text = review_text.lower()
    words = review_text.split()

    # 2. 단어 → 정수 인코딩
    # 단어 인덱스에 없는 단어는 2(UNK)로 처리
    encoded = [word_index.get(word, 2) + 3 for word in words]

    # 3. 패딩
    from tensorflow.keras.preprocessing.sequence import pad_sequences
    padded = pad_sequences([encoded], maxlen=max_len, padding='post')

    # 4. 예측
    prediction = model.predict(padded, verbose=0)[0][0]

    # 5. 결과 출력
    sentiment = "😊 긍정 (Positive)" if prediction > 0.5 else "😞 부정 (Negative)"
    confidence = prediction if prediction > 0.5 else 1 - prediction

    print(f"리뷰: {review_text[:80]}...")
    print(f"예측: {sentiment}")
    print(f"확신도: {confidence*100:.1f}%")
    print("-" * 50)

    return prediction

# 테스트해보기!
test_reviews = [
    "This movie was absolutely brilliant! The acting was superb and the story was captivating.",
    "Terrible film. Waste of time and money. The plot made no sense at all.",
    "It was okay, nothing special but not bad either. Average movie experience.",
    "One of the best movies I have ever seen! Highly recommend to everyone!"
]

for review in test_reviews:
    predict_sentiment(review, model, word_index)

# 출력 예시:
# 리뷰: this movie was absolutely brilliant! the acting was superb...
# 예측: 😊 긍정 (Positive)
# 확신도: 97.3%
# --------------------------------------------------
# 리뷰: terrible film. waste of time and money. the plot made no...
# 예측: 😞 부정 (Negative)
# 확신도: 94.8%
# --------------------------------------------------
기본 모델로 88~89% 정확도를 달성했는데, 더 올리고 싶다면?
여러 가지 방법을 시도해볼 수 있어! 🚀
처음부터 임베딩을 학습하는 대신, 이미 수십억 개의 텍스트로 학습된
GloVe나 Word2Vec 임베딩을 사용하면 성능이 크게 올라!
import numpy as np

# GloVe 임베딩 로드 (glove.6B.100d.txt 파일 필요)
def load_glove_embeddings(glove_path, word_index, embedding_dim=100):
    embeddings_index = {}

    with open(glove_path, encoding='utf-8') as f:
        for line in f:
            values = line.split()
            word = values[0]
            coefs = np.asarray(values[1:], dtype='float32')
            embeddings_index[word] = coefs

    print(f"GloVe 단어 수: {len(embeddings_index):,}")

    # 임베딩 행렬 생성
    embedding_matrix = np.zeros((vocab_size, embedding_dim))

    for word, i in word_index.items():
        if i < vocab_size:
            embedding_vector = embeddings_index.get(word)
            if embedding_vector is not None:
                embedding_matrix[i] = embedding_vector

    return embedding_matrix

# 사전 훈련 임베딩을 사용하는 모델
from tensorflow.keras.layers import Embedding

# embedding_matrix = load_glove_embeddings('glove.6B.100d.txt', word_index)

model_pretrained = Sequential([
    Embedding(
        input_dim=vocab_size,
        output_dim=100,
        # weights=[embedding_matrix],  # 사전 훈련 가중치
        # trainable=False,             # 임베딩 고정 (파인튜닝 안 함)
        input_length=max_length
    ),
    Conv1D(128, 5, activation='relu'),
    GlobalMaxPooling1D(),
    Dense(64, activation='relu'),
    Dropout(0.3),
    Dense(1, activation='sigmoid')
])# 시도해볼 수 있는 하이퍼파라미터들
hyperparams_to_try = {
'embedding_dim': [32, 64, 128, 256],
'max_length': [128, 256, 512],
'batch_size': [128, 256, 512],
'learning_rate': [0.001, 0.0005, 0.0001],
'dropout_rate': [0.2, 0.3, 0.4, 0.5],
'dense_units': [32, 64, 128]
}
# Keras Tuner를 사용한 자동 하이퍼파라미터 탐색
# pip install keras-tuner
import keras_tuner as kt
def build_model(hp):
model = Sequential([
Embedding(
vocab_size,
hp.Int('embedding_dim', min_value=32, max_value=256, step=32),
input_length=max_length
),
Conv1D(
hp.Int('conv_filters', min_value=64, max_value=256, step=64),
5, activation='relu'
),
GlobalMaxPooling1D(),
Dense(
hp.Int('dense_units', min_value=32, max_value=128, step=32),
activation='relu'
),
Dropout(hp.Float('dropout', min_value=0.2, max_value=0.5, step=0.1)),
Dense(1, activation='sigmoid')
])
model.compile(
optimizer=tf.keras.optimizers.Adam(
hp.Float('learning_rate', min_value=1e-4, max_value=1e-2, sampling='log')
),
loss='binary_crossentropy',
metrics=['accuracy']
)
return modelimport random
def augment_text(text_tokens, augment_prob=0.1):
"""
간단한 텍스트 증강 기법
- 랜덤 단어 삭제
- 랜덤 단어 교체
"""
augmented = []
for token in text_tokens:
rand = random.random()
if rand < augment_prob:
# 10% 확률로 단어 삭제
continue
augmented.append(token)
return augmented
# 동의어 교체 (nlpaug 라이브러리 활용)
# pip install nlpaug
# import nlpaug.augmenter.word as naw
# aug = naw.SynonymAug(aug_src='wordnet')
# augmented_text = aug.augment("This movie was great!")
최고 성능을 원한다면? BERT(Bidirectional Encoder Representations from Transformers)를 써봐!
TensorFlow Hub에서 사전 훈련된 BERT를 바로 가져다 쓸 수 있어.
import tensorflow_hub as hub
import tensorflow_text as text

# TensorFlow Hub에서 BERT 모델 로드
bert_preprocess_model = hub.KerasLayer(
    "https://tfhub.dev/tensorflow/bert_en_uncased_preprocess/3"
)
bert_encoder = hub.KerasLayer(
    "https://tfhub.dev/tensorflow/bert_en_uncased_L-12_H-768_A-12/4",
    trainable=True  # 파인튜닝
)

# BERT 기반 분류 모델
text_input = tf.keras.layers.Input(shape=(), dtype=tf.string, name='text')
preprocessed_text = bert_preprocess_model(text_input)
outputs = bert_encoder(preprocessed_text)

# 풀링된 출력 사용
net = outputs['pooled_output']
net = tf.keras.layers.Dropout(0.1)(net)
net = tf.keras.layers.Dense(1, activation='sigmoid', name='classifier')(net)

model_bert = tf.keras.Model(text_input, net)

# BERT는 보통 90% 이상의 정확도를 달성해!
열심히 만든 모델, 저장해두고 나중에 또 쓰거나 서비스에 배포해야겠지?
TensorFlow는 여러 가지 저장 방식을 지원해!
# 방법 1: SavedModel 형식 (권장)
model.save('text_classifier_model')
# 폴더 구조로 저장됨

# 방법 2: HDF5 형식 (.h5)
model.save('text_classifier_model.h5')

# 방법 3: 가중치만 저장
model.save_weights('model_weights.h5')

# 모델 불러오기
loaded_model = tf.keras.models.load_model('text_classifier_model')
print("모델 로드 완료! ✅")
모델을 웹 API로 배포하면 다른 서비스에서도 사용할 수 있어!
Flask로 간단한 REST API를 만들어보자.
from flask import Flask, request, jsonify
import tensorflow as tf
import numpy as np
from tensorflow.keras.preprocessing.sequence import pad_sequences
from tensorflow.keras.datasets import imdb

app = Flask(__name__)

# 모델 및 설정 로드
model = tf.keras.models.load_model('text_classifier_model')
word_index = imdb.get_word_index()
MAX_LENGTH = 256

@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json()
    review_text = data.get('text', '')

    if not review_text:
        return jsonify({'error': '텍스트를 입력해주세요!'}), 400

    # 전처리
    words = review_text.lower().split()
    encoded = [word_index.get(word, 2) + 3 for word in words]
    padded = pad_sequences([encoded], maxlen=MAX_LENGTH, padding='post')

    # 예측
    prediction = float(model.predict(padded, verbose=0)[0][0])
    sentiment = 'positive' if prediction > 0.5 else 'negative'
    confidence = prediction if prediction > 0.5 else 1 - prediction

    return jsonify({
        'text': review_text,
        'sentiment': sentiment,
        'confidence': round(confidence * 100, 2),
        'raw_score': round(prediction, 4)
    })

if __name__ == '__main__':
    app.run(debug=True, port=5000)

# 사용 예시:
# curl -X POST http://localhost:5000/predict \
#   -H "Content-Type: application/json" \
#   -d '{"text": "This movie was absolutely amazing!"}'
#
# 응답:
# {
#   "text": "This movie was absolutely amazing!",
#   "sentiment": "positive",
#   "confidence": 97.3,
#   "raw_score": 0.9730
# }클라우드 배포는 Google Cloud Run, AWS Lambda, Heroku 등을 활용해봐!
모델이 크다면 TensorFlow Serving이나 TensorFlow Lite로 최적화하는 것도 고려해봐.
지금까지 배운 내용을 하나의 완성된 코드로 정리해볼게!
이걸 그대로 복사해서 Google Colab에 붙여넣으면 바로 실행돼. 🎉
"""
TensorFlow 텍스트 분류 모델 - 완성 코드
IMDB 영화 리뷰 감성 분석 (긍정/부정)
"""

import tensorflow as tf
import numpy as np
import matplotlib.pyplot as plt
from tensorflow.keras.datasets import imdb
from tensorflow.keras.preprocessing.sequence import pad_sequences
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import (
    Embedding, Conv1D, GlobalMaxPooling1D,
    Dense, Dropout
)
from tensorflow.keras.callbacks import EarlyStopping, ModelCheckpoint

# ============================================
# 1. 설정값
# ============================================
VOCAB_SIZE = 10000    # 어휘 크기
MAX_LENGTH = 256      # 최대 시퀀스 길이
EMBEDDING_DIM = 64    # 임베딩 차원
BATCH_SIZE = 512      # 배치 크기
EPOCHS = 20           # 최대 에포크
VAL_SIZE = 5000       # 검증 데이터 크기

print(f"TensorFlow 버전: {tf.__version__}")

# ============================================
# 2. 데이터 로드 및 전처리
# ============================================
(train_data, train_labels), (test_data, test_labels) = imdb.load_data(
    num_words=VOCAB_SIZE
)

# 패딩
train_data_padded = pad_sequences(train_data, maxlen=MAX_LENGTH, padding='post')
test_data_padded = pad_sequences(test_data, maxlen=MAX_LENGTH, padding='post')

# 레이블 변환
train_labels = np.array(train_labels)
test_labels = np.array(test_labels)

# 검증 데이터 분리
x_val = train_data_padded[:VAL_SIZE]
y_val = train_labels[:VAL_SIZE]
x_train = train_data_padded[VAL_SIZE:]
y_train = train_labels[VAL_SIZE:]

print(f"훈련: {x_train.shape}, 검증: {x_val.shape}, 테스트: {test_data_padded.shape}")

# ============================================
# 3. 모델 구성
# ============================================
model = Sequential([
    Embedding(VOCAB_SIZE, EMBEDDING_DIM, input_length=MAX_LENGTH),
    Conv1D(128, 5, activation='relu'),
    GlobalMaxPooling1D(),
    Dense(64, activation='relu'),
    Dropout(0.3),
    Dense(1, activation='sigmoid')
])

model.compile(
    optimizer='adam',
    loss='binary_crossentropy',
    metrics=['accuracy']
)

model.summary()

# ============================================
# 4. 콜백 설정
# ============================================
callbacks = [
    EarlyStopping(monitor='val_loss', patience=3, restore_best_weights=True),
    ModelCheckpoint('best_model.keras', monitor='val_accuracy', save_best_only=True)
]

# ============================================
# 5. 모델 훈련
# ============================================
history = model.fit(
    x_train, y_train,
    epochs=EPOCHS,
    batch_size=BATCH_SIZE,
    validation_data=(x_val, y_val),
    callbacks=callbacks,
    verbose=1
)

# ============================================
# 6. 모델 평가
# ============================================
test_loss, test_accuracy = model.evaluate(test_data_padded, test_labels)
print(f"\n✅ 테스트 정확도: {test_accuracy*100:.2f}%")

# ============================================
# 7. 학습 곡선 시각화
# ============================================
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

axes[0].plot(history.history['accuracy'], label='훈련', color='#7eb8d4')
axes[0].plot(history.history['val_accuracy'], label='검증', color='#f0a060')
axes[0].set_title('정확도')
axes[0].legend()

axes[1].plot(history.history['loss'], label='훈련', color='#7eb8d4')
axes[1].plot(history.history['val_loss'], label='검증', color='#f0a060')
axes[1].set_title('손실')
axes[1].legend()

plt.tight_layout()
plt.show()

# ============================================
# 8. 실제 예측
# ============================================
word_index = imdb.get_word_index()

def predict_sentiment(text):
    words = text.lower().split()
    encoded = [word_index.get(w, 2) + 3 for w in words]
    padded = pad_sequences([encoded], maxlen=MAX_LENGTH, padding='post')
    score = model.predict(padded, verbose=0)[0][0]
    label = "😊 긍정" if score > 0.5 else "😞 부정"
    conf = score if score > 0.5 else 1 - score
    print(f"[{label}] 확신도: {conf*100:.1f}% | {text[:60]}")

predict_sentiment("This movie was absolutely brilliant and amazing!")
predict_sentiment("Terrible film, complete waste of time and money.")
와, 여기까지 따라왔다면 진짜 대단해! 👏
오늘 우리가 배운 걸 정리해보자.
🔹 IMDB 데이터셋 로드 및 탐색
🔹 텍스트 전처리 (토큰화, 패딩)
🔹 세 가지 모델 구조 (Dense, LSTM, Conv1D)
🔹 모델 컴파일, 훈련, 콜백 설정
🔹 모델 평가 및 성능 지표 해석
🔹 실제 텍스트로 예측하기
🔹 성능 개선 방법 (GloVe, BERT 등)
🔹 모델 저장 및 API 배포
감성 분석
분류
Transformers
모바일 배포
텍스트 분류는 NLP(자연어 처리)의 가장 기본적인 태스크야.
이걸 마스터하면 감성 분석, 스팸 필터, 뉴스 분류, 챗봇 의도 분류 등
다양한 실제 프로젝트에 바로 적용할 수 있어! 💪
| 주제 | 추천 리소스 |
|---|---|
| TensorFlow 공식 튜토리얼 | tensorflow.org/tutorials |
| Keras 문서 | keras.io |
| HuggingFace 트랜스포머 | huggingface.co/docs |
| 한국어 NLP (KoNLPy) | konlpy.org |
| 딥러닝 논문 읽기 | arxiv.org/cs.CL |
딥러닝은 처음엔 어렵게 느껴지지만, 직접 코드를 짜고 실험해보면서 배우는 게 제일 빨라!
오늘 배운 코드를 직접 돌려보고, 파라미터도 바꿔보고, 다른 데이터셋에도 적용해봐.
그러다 보면 어느새 AI 개발자가 되어있을 거야! 🌟

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.