
Ver3.5 LangChain으로 AutoGPT형 AI 만들기
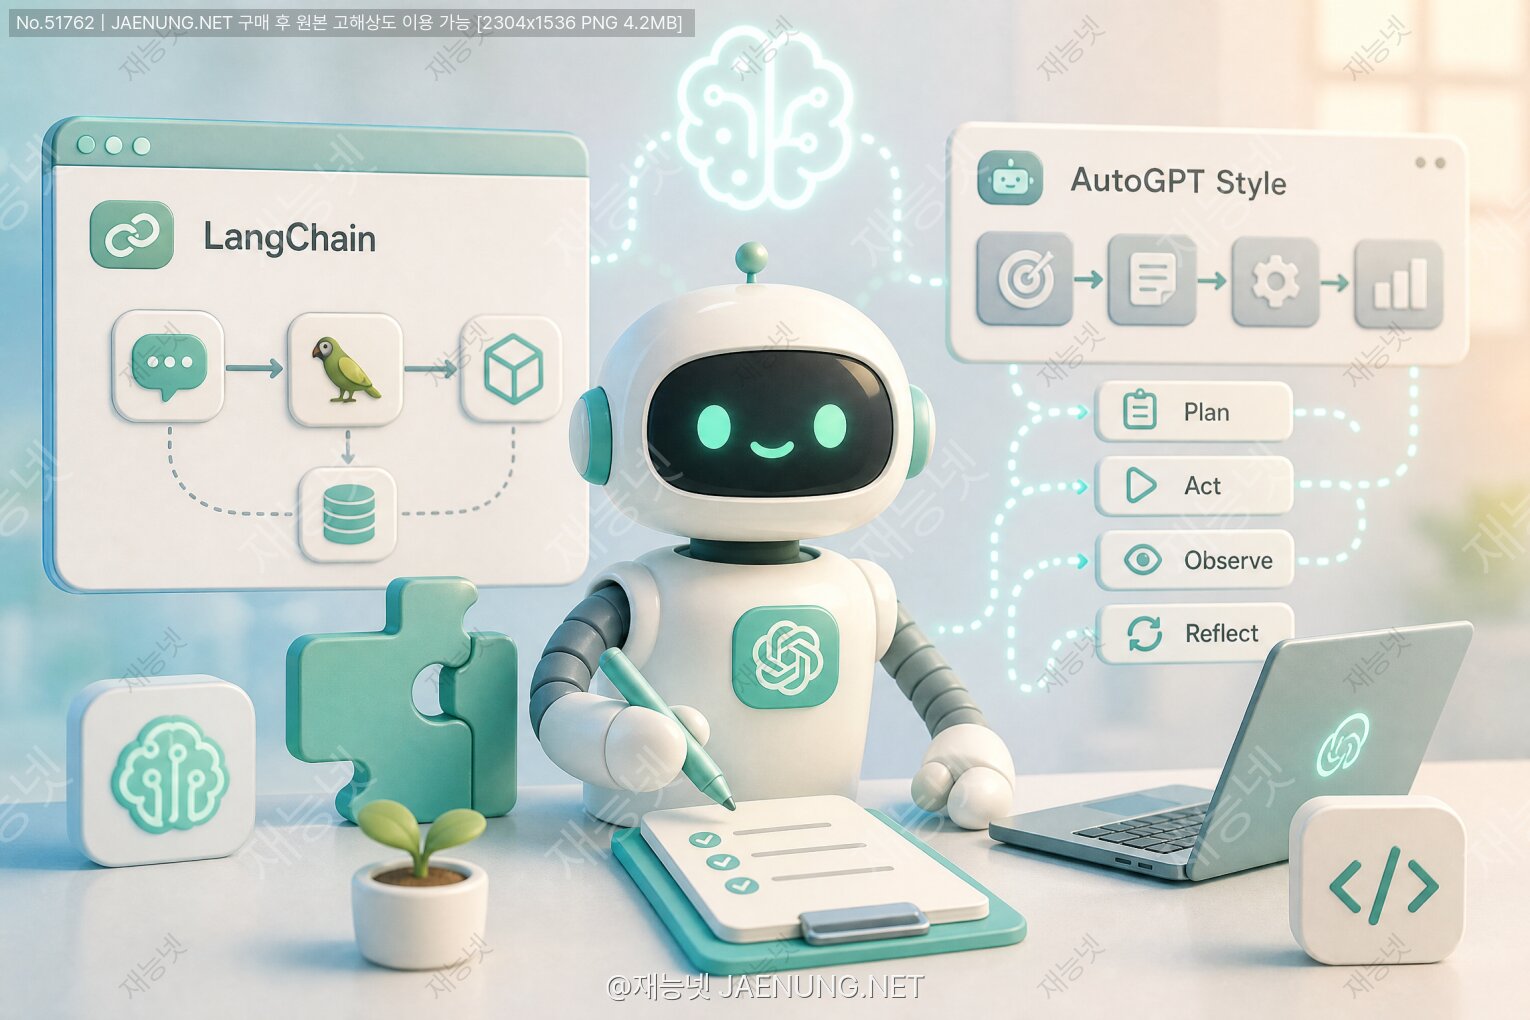
LangChain으로 AutoGPT형 AI 만들기
스스로 생각하고, 스스로 행동하는 AI 에이전트 — 직접 만들어보자!
LangChain AutoGPT AI Agent Python GPT-4
🚀AutoGPT가 뭔데 이렇게 난리야?
2023년 초, 깃허브에 AutoGPT라는 프로젝트가 올라오자마자 전 세계 개발자들이 완전 난리났었잖아ㅋㅋㅋ
별(Star) 수가 며칠 만에 수만 개 찍히고, "이게 진짜 AGI의 시작 아니냐"는 말까지 나왔을 정도였음.
근데 AutoGPT가 왜 그렇게 핫했냐면, 기존 ChatGPT는 사람이 질문하면 AI가 답하는 1:1 대화형이었는데,
AutoGPT는 "목표 하나만 줘봐, 내가 알아서 다 할게" 하는 방식이었거든.
사람이 개입 없이도 스스로 계획 세우고 → 도구 쓰고 → 결과 확인하고 → 다시 계획 수정하는 루프!
그리고 이걸 직접 만들 수 있게 해주는 프레임워크가 바로 LangChain이야.
LangChain은 LLM(대형 언어 모델)을 활용한 애플리케이션을 쉽게 만들 수 있도록 도와주는 Python/JavaScript 라이브러리인데,
에이전트(Agent), 툴(Tool), 메모리(Memory), 체인(Chain) 같은 개념들을 깔끔하게 추상화해놨어.
오늘은 이 LangChain으로 AutoGPT 스타일의 자율 AI 에이전트를 직접 만드는 방법을 낱낱이 파헤쳐볼 거야! 🔥
🧩핵심 개념 먼저 정리하고 가자
코드 들어가기 전에 개념 정리 필수임. 이거 모르면 코드 봐도 뭔 소린지 모름ㅋㅋ
🔗 LangChain이란?
LangChain은 2022년 Harrison Chase가 만든 오픈소스 프레임워크야.
GPT-4, Claude, Gemini 같은 LLM을 단순 텍스트 생성 이상으로 활용할 수 있게 해줌.
핵심 컴포넌트는 이렇게 구성돼:
| 컴포넌트 | 역할 | 비유 |
|---|---|---|
| LLM / ChatModel | 언어 모델 연결 (GPT-4 등) | AI의 두뇌 🧠 |
| Prompt Template | AI에게 보낼 프롬프트 구조화 | 업무 지시서 📋 |
| Chain | 여러 단계를 연결하는 파이프라인 | 조립 라인 🏭 |
| Tool | AI가 사용할 수 있는 외부 기능 | 도구 상자 🧰 |
| Agent | 목표 달성을 위해 Tool을 선택·실행 | 자율 직원 🤖 |
| Memory | 대화 맥락·정보 저장 | 메모장 📝 |
| Vector Store | 임베딩 기반 장기 기억 저장소 | 도서관 📚 |
🤖 AutoGPT형 에이전트의 동작 원리
AutoGPT 스타일 에이전트의 핵심은 ReAct(Reasoning + Acting) 패턴이야.
이게 뭐냐면, AI가 이런 루프를 반복하는 거야:
이 루프가 바로 AutoGPT가 "자율적으로 동작한다"고 느껴지는 이유야.
LangChain의 AgentExecutor가 이 루프를 자동으로 관리해줌. 개발자가 직접 루프 짤 필요 없음!
⚙️환경 세팅부터 차근차근
자 이제 진짜 만들어볼 시간! 먼저 환경 세팅부터 해야지ㅋㅋ
Python 3.9 이상 환경 기준으로 설명할게.
📦 필요한 패키지 설치
# 기본 LangChain 패키지
pip install langchain langchain-openai langchain-community

# 도구(Tool) 관련
pip install duckduckgo-search  # 웹 검색
pip install wikipedia           # 위키피디아 검색
pip install python-dotenv       # 환경변수 관리

# 벡터 스토어 (장기 메모리용)
pip install faiss-cpu chromadb

# 기타 유틸
pip install requests beautifulsoup4langchain>=0.2.0 버전을 권장해. 예전 버전이랑 API가 많이 달라졌으니 버전 꼭 확인!
🔑 API 키 설정
# .env 파일 생성
OPENAI_API_KEY=sk-xxxxxxxxxxxxxxxxxxxxxxxx

# Python 코드에서 로드
from dotenv import load_dotenv
import os

load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")🛠️도구(Tool) 만들기 — AI의 손발
AutoGPT형 에이전트의 핵심은 도구(Tool)야.
AI가 혼자 생각만 하는 게 아니라, 실제로 뭔가를 실행할 수 있어야 자율 에이전트가 되거든.
LangChain에서 Tool은 크게 두 가지 방식으로 만들 수 있어.
방법 1: @tool 데코레이터 사용 (가장 간단!)
from langchain.tools import tool
import requests
from datetime import datetime

@tool
def get_current_time(dummy: str = "") -> str:
    """현재 날짜와 시간을 반환합니다. 시간 관련 질문에 사용하세요."""
    now = datetime.now()
    return f"현재 시각: {now.strftime('%Y년 %m월 %d일 %H시 %M분')}"

@tool
def calculate(expression: str) -> str:
    """수학 계산을 수행합니다. 예: '2 + 3 * 4'"""
    try:
        result = eval(expression)
        return f"계산 결과: {expression} = {result}"
    except Exception as e:
        return f"계산 오류: {str(e)}"

@tool
def search_web(query: str) -> str:
    """인터넷에서 최신 정보를 검색합니다."""
    from duckduckgo_search import DDGS
    with DDGS() as ddgs:
        results = list(ddgs.text(query, max_results=3))
    if not results:
        return "검색 결과가 없습니다."
    output = ""
    for r in results:
        output += f"제목: {r['title']}\n내용: {r['body']}\n\n"
return outputAI가 이 설명을 읽고 "어떤 상황에서 이 도구를 써야 하는지" 판단하거든.
설명이 불명확하면 AI가 엉뚱한 도구를 쓰거나 아예 안 씀ㅋㅋ
방법 2: BaseTool 클래스 상속 (복잡한 도구)
from langchain.tools import BaseTool
from typing import Optional, Type
from pydantic import BaseModel, Field

class FileWriteInput(BaseModel):
    filename: str = Field(description="저장할 파일 이름")
    content: str = Field(description="파일에 저장할 내용")

class FileWriteTool(BaseTool):
    name: str = "file_writer"
    description: str = "텍스트 내용을 파일로 저장합니다. 결과물을 파일로 남길 때 사용하세요."
    args_schema: Type[BaseModel] = FileWriteInput

    def _run(self, filename: str, content: str) -> str:
        try:
            with open(filename, 'w', encoding='utf-8') as f:
                f.write(content)
            return f"✅ '{filename}' 파일 저장 완료! ({len(content)}자)"
        except Exception as e:
            return f"❌ 파일 저장 실패: {str(e)}"

    async def _arun(self, filename: str, content: str) -> str:
        # 비동기 버전 (필요시 구현)
        return self._run(filename, content)
🌐 LangChain 내장 도구 활용
직접 만들 필요 없이 LangChain이 이미 만들어놓은 도구들도 엄청 많아:
| 도구 이름 | 기능 | 임포트 경로 |
|---|---|---|
| DuckDuckGoSearchRun | 웹 검색 | langchain_community.tools |
| WikipediaQueryRun | 위키피디아 검색 | langchain_community.tools |
| PythonREPLTool | Python 코드 실행 | langchain_experimental.tools |
| ShellTool | 터미널 명령 실행 | langchain_community.tools |
| ReadFileTool / WriteFileTool | 파일 읽기/쓰기 | langchain_community.tools |
| RequestsGetTool | HTTP GET 요청 | langchain_community.tools |
from langchain_community.tools import DuckDuckGoSearchRun, WikipediaQueryRun
from langchain_community.utilities import WikipediaAPIWrapper

# 내장 도구 초기화
search_tool = DuckDuckGoSearchRun()
wiki_tool = WikipediaQueryRun(api_wrapper=WikipediaAPIWrapper(lang="ko"))🧠메모리 시스템 구축 — AI가 기억하게 하기
AutoGPT형 에이전트가 진짜 강력해지려면 메모리가 필요해.
단순히 대화 기록을 저장하는 것 이상으로, 장기 기억까지 구현해보자.
단기 메모리: ConversationBufferMemory
from langchain.memory import ConversationBufferMemory, ConversationSummaryMemory
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o", temperature=0)

# 방법 1: 전체 대화 버퍼 저장 (짧은 대화에 적합)
buffer_memory = ConversationBufferMemory(
    memory_key="chat_history",
    return_messages=True
)

# 방법 2: 대화 요약 저장 (긴 대화에 적합, 토큰 절약!)
summary_memory = ConversationSummaryMemory(
    llm=llm,
    memory_key="chat_history",
    return_messages=True
)
장기 메모리: Vector Store 기반
진짜 AutoGPT처럼 장기 기억을 구현하려면 벡터 DB를 써야 해.
이전에 처리한 정보를 임베딩으로 저장해두고, 필요할 때 유사도 검색으로 꺼내오는 방식이야.
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS
from langchain.memory import VectorStoreRetrieverMemory

# 임베딩 모델 초기화
embeddings = OpenAIEmbeddings()

# FAISS 벡터 스토어 생성
vectorstore = FAISS.from_texts(
    ["초기 메모리 데이터"],
    embedding=embeddings
)

# 벡터 스토어 기반 메모리 (상위 3개 관련 기억 검색)
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})
vector_memory = VectorStoreRetrieverMemory(retriever=retriever)

# 정보 저장
vector_memory.save_context(
    {"input": "파이썬 프로젝트 시작"},
    {"output": "requirements.txt 생성 완료, FastAPI 설치함"}
)

# 관련 기억 검색
relevant = vector_memory.load_memory_variables({"prompt": "FastAPI 관련 작업"})
print(relevant)FAISS는 인메모리라 프로그램 종료 시 날아가지만, ChromaDB는 로컬 파일로 영구 저장 가능!
🤖드디어 에이전트 조립! — 핵심 코드
자 이제 진짜 핵심이야! 도구, 메모리, LLM을 다 합쳐서 AutoGPT형 에이전트를 만들어보자.
LangChain에서 에이전트를 만드는 방법은 크게 두 가지야.
방법 1: create_openai_tools_agent (최신 권장 방식)
from langchain_openai import ChatOpenAI
from langchain.agents import create_openai_tools_agent, AgentExecutor
from langchain.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain.memory import ConversationBufferMemory
from langchain_community.tools import DuckDuckGoSearchRun
from langchain.tools import tool
from datetime import datetime

# 1. LLM 설정
llm = ChatOpenAI(model="gpt-4o", temperature=0, streaming=True)

# 2. 도구 목록 정의
@tool
def get_datetime(dummy: str = "") -> str:
    """현재 날짜와 시간을 반환합니다."""
    return datetime.now().strftime("%Y년 %m월 %d일 %H:%M")

@tool
def calculate(expr: str) -> str:
    """수학 계산을 수행합니다. 예: '100 * 0.15'"""
    try:
        return f"결과: {eval(expr)}"
    except:
        return "계산 오류"

search = DuckDuckGoSearchRun()
tools = [get_datetime, calculate, search]

# 3. 프롬프트 템플릿 (에이전트의 성격/역할 정의)
prompt = ChatPromptTemplate.from_messages([
    ("system", """당신은 유능한 AI 어시스턴트입니다.
주어진 목표를 달성하기 위해 사용 가능한 도구를 적극 활용하세요.
단계적으로 생각하고, 필요한 경우 여러 도구를 조합해서 사용하세요.
한국어로 답변하세요."""),
    MessagesPlaceholder(variable_name="chat_history"),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad"),
])

# 4. 메모리 설정
memory = ConversationBufferMemory(
    memory_key="chat_history",
    return_messages=True
)

# 5. 에이전트 생성
agent = create_openai_tools_agent(llm, tools, prompt)

# 6. AgentExecutor로 감싸기 (실제 실행 엔진)
agent_executor = AgentExecutor(
    agent=agent,
    tools=tools,
    memory=memory,
    verbose=True,          # 중간 과정 출력 (디버깅용)
    max_iterations=10,     # 최대 반복 횟수 (무한루프 방지!)
    handle_parsing_errors=True,
    return_intermediate_steps=True
)

# 7. 실행!
result = agent_executor.invoke({
    "input": "오늘 날짜를 알려주고, 2024년부터 지금까지 몇 년이 지났는지 계산해줘"
})
print(result["output"])처음 개발할 때는 꼭 켜놓고 디버깅해야 함. 나중에 배포할 때 False로 바꾸면 됨!
방법 2: LangGraph 기반 (2024년 최신 트렌드)
LangChain 팀이 2024년에 밀고 있는 건 사실 LangGraph야.
기존 AgentExecutor보다 훨씬 유연하게 에이전트 흐름을 제어할 수 있어.
복잡한 멀티 에이전트 시스템 만들 때 특히 강력함!
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import ToolNode, tools_condition
from langchain_openai import ChatOpenAI
from langchain_community.tools import DuckDuckGoSearchRun
from typing import TypedDict, Annotated
import operator

# 상태 정의
class AgentState(TypedDict):
    messages: Annotated[list, operator.add]

# LLM + 도구 바인딩
llm = ChatOpenAI(model="gpt-4o", temperature=0)
tools = [DuckDuckGoSearchRun()]
llm_with_tools = llm.bind_tools(tools)

# 에이전트 노드 함수
def agent_node(state: AgentState):
    response = llm_with_tools.invoke(state["messages"])
    return {"messages": [response]}

# 그래프 구성
workflow = StateGraph(AgentState)
workflow.add_node("agent", agent_node)
workflow.add_node("tools", ToolNode(tools))

workflow.set_entry_point("agent")
workflow.add_conditional_edges("agent", tools_condition)
workflow.add_edge("tools", "agent")

# 컴파일
app = workflow.compile()

# 실행
from langchain_core.messages import HumanMessage
result = app.invoke({
    "messages": [HumanMessage(content="2024년 파리 올림픽 금메달 1위 국가 알려줘")]
})
print(result["messages"][-1].content)🏗️실전 프로젝트: 리서치 자동화 에이전트
이론은 충분히 했으니까 이제 실제로 쓸 수 있는 에이전트를 만들어보자!
"특정 주제를 리서치해서 보고서를 자동으로 작성해주는 에이전트"야.
재능넷 같은 플랫폼에서 프리랜서들이 리서치 업무 자동화에 쓸 수 있는 실용적인 예제임ㅋㅋ
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain.agents import create_openai_tools_agent, AgentExecutor
from langchain.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain.memory import ConversationSummaryBufferMemory
from langchain.tools import tool
from langchain_community.tools import DuckDuckGoSearchRun, WikipediaQueryRun
from langchain_community.utilities import WikipediaAPIWrapper
from langchain_community.vectorstores import FAISS
import json
from datetime import datetime

# ===== 도구 정의 =====

search_tool = DuckDuckGoSearchRun(max_results=5)
wiki_tool = WikipediaQueryRun(
    api_wrapper=WikipediaAPIWrapper(lang="ko", top_k_results=2)
)

@tool
def save_research_note(content: str) -> str:
    """리서치 중 중요한 내용을 메모로 저장합니다."""
    timestamp = datetime.now().strftime("%H%M%S")
    filename = f"research_note_{timestamp}.txt"
    with open(filename, 'w', encoding='utf-8') as f:
        f.write(content)
    return f"✅ 메모 저장 완료: {filename}"

@tool
def create_report(title: str, content: str) -> str:
    """최종 리서치 보고서를 마크다운 파일로 생성합니다."""
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    filename = f"report_{timestamp}.md"
    report = f"# {title}\n\n*작성일: {datetime.now().strftime('%Y년 %m월 %d일')}*\n\n{content}"
    with open(filename, 'w', encoding='utf-8') as f:
        f.write(report)
    return f"✅ 보고서 생성 완료: {filename}\n미리보기:\n{report[:300]}..."

@tool
def analyze_data(data: str) -> str:
    """수집된 데이터를 분석하고 핵심 인사이트를 추출합니다."""
    # 실제로는 더 복잡한 분석 로직이 들어갈 수 있음
    return f"데이터 분석 완료. 입력 데이터 길이: {len(data)}자. 분석 준비됨."

# ===== 에이전트 구성 =====

llm = ChatOpenAI(model="gpt-4o", temperature=0.1)

tools = [search_tool, wiki_tool, save_research_note, create_report, analyze_data]

system_prompt = """당신은 전문 리서치 AI 에이전트입니다.

## 역할
- 주어진 주제에 대해 체계적으로 정보를 수집하고 분석합니다
- 신뢰할 수 있는 정보를 여러 소스에서 교차 검증합니다
- 수집한 정보를 바탕으로 구조화된 보고서를 작성합니다

## 작업 순서
1. 주제 파악 및 리서치 계획 수립
2. 웹 검색 및 위키피디아로 기본 정보 수집
3. 중요 내용 메모 저장
4. 추가 심화 검색 (필요시)
5. 최종 보고서 작성 및 저장

## 주의사항
- 항상 출처를 명시하세요
- 불확실한 정보는 "확인 필요"로 표시하세요
- 한국어로 작성하세요"""

prompt = ChatPromptTemplate.from_messages([
    ("system", system_prompt),
    MessagesPlaceholder(variable_name="chat_history"),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad"),
])

memory = ConversationSummaryBufferMemory(
    llm=llm,
    memory_key="chat_history",
    return_messages=True,
    max_token_limit=2000
)

agent = create_openai_tools_agent(llm, tools, prompt)
research_agent = AgentExecutor(
    agent=agent,
    tools=tools,
    memory=memory,
    verbose=True,
    max_iterations=15,
    handle_parsing_errors=True
)

# ===== 실행 =====
if __name__ == "__main__":
    topic = "2024년 AI 반도체 시장 동향"
    print(f"🔍 리서치 시작: {topic}\n{'='*50}")

    result = research_agent.invoke({
        "input": f"'{topic}'에 대해 심층 리서치를 수행하고 보고서를 작성해주세요."
    })

    print("\n" + "="*50)
    print("📊 최종 결과:")
print(result["output"])Thought: 먼저 웹 검색으로 기본 정보를 수집해야겠다Action: duckduckgo_searchAction Input: "2024년 AI 반도체 시장 동향"Observation: [검색 결과...]이 과정이 반복되다가 충분한 정보가 모이면 최종 보고서를 작성함!
⚡성능 최적화 & 실전 팁
기본 에이전트는 만들었는데, 실제로 쓰다 보면 느리거나 비용이 많이 들거나 오류가 나는 경우가 있어.
실전에서 꼭 알아야 할 최적화 팁들 정리해줄게!
💰 토큰 비용 절약 전략
# 1. 모델 선택 전략 (비용 vs 성능 트레이드오프)
# 복잡한 추론: gpt-4o
# 단순 작업: gpt-4o-mini (훨씬 저렴!)
# 도구 선택만: gpt-3.5-turbo

from langchain_openai import ChatOpenAI

# 라우터 패턴: 작업 복잡도에 따라 모델 선택
cheap_llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
powerful_llm = ChatOpenAI(model="gpt-4o", temperature=0)

# 2. 캐싱으로 중복 API 호출 방지
from langchain.globals import set_llm_cache
from langchain_community.cache import InMemoryCache, SQLiteCache

# 인메모리 캐시 (빠르지만 재시작 시 초기화)
set_llm_cache(InMemoryCache())

# SQLite 캐시 (영구 저장, 재시작해도 유지!)
set_llm_cache(SQLiteCache(database_path=".langchain_cache.db"))
🔄 비동기 처리로 속도 향상
import asyncio
from langchain.agents import AgentExecutor

# 비동기 실행 (여러 에이전트 동시 실행 가능!)
async def run_multiple_agents(queries: list):
    tasks = [
        research_agent.ainvoke({"input": q})
        for q in queries
    ]
    results = await asyncio.gather(*tasks)
    return results

# 실행
queries = [
    "AI 반도체 시장 동향",
    "전기차 배터리 기술 현황",
    "양자컴퓨터 상용화 전망"
]
results = asyncio.run(run_multiple_agents(queries))
🛡️ 에러 핸들링 & 안전장치
from langchain.agents import AgentExecutor
from langchain_core.exceptions import OutputParserException

# 강건한 에이전트 설정
robust_agent = AgentExecutor(
    agent=agent,
    tools=tools,
    verbose=True,
    max_iterations=10,          # 무한루프 방지
    max_execution_time=60,      # 최대 실행 시간 60초
    handle_parsing_errors=True, # 파싱 오류 자동 처리
    return_intermediate_steps=True,
    early_stopping_method="generate"  # 한계 도달 시 현재까지 결과 반환
)

# 타임아웃 + 재시도 로직
import time
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=4, max=10)
)
def safe_agent_run(query: str):
    try:
        return robust_agent.invoke({"input": query})
    except Exception as e:
        print(f"에러 발생: {e}")
raisemax_iterations는 반드시 설정해야 해.설정 안 하면 에이전트가 목표를 못 달성할 때 무한루프에 빠질 수 있고,
그러면 API 비용이 폭발적으로 나올 수 있음ㅋㅋㅋ 진짜 조심해야 함.
🌐멀티 에이전트 시스템으로 확장하기
진짜 AutoGPT처럼 강력한 시스템을 만들려면 여러 에이전트가 협력하는 구조가 필요해.
각 에이전트가 전문 분야를 맡고, 오케스트레이터(Orchestrator)가 전체를 조율하는 방식이야.
from langchain.agents import create_openai_tools_agent, AgentExecutor
from langchain_openai import ChatOpenAI
from langchain.tools import tool

# 각 전문 에이전트를 도구로 감싸기
def create_research_agent():
    """리서치 전담 에이전트"""
    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
    tools = [DuckDuckGoSearchRun(), wiki_tool]
    prompt = ChatPromptTemplate.from_messages([
        ("system", "당신은 정보 수집 전문가입니다. 주어진 주제에 대해 최대한 많은 정보를 수집하세요."),
        ("human", "{input}"),
        MessagesPlaceholder(variable_name="agent_scratchpad"),
    ])
    agent = create_openai_tools_agent(llm, tools, prompt)
    return AgentExecutor(agent=agent, tools=tools, max_iterations=5)

research_executor = create_research_agent()

# 서브 에이전트를 도구로 등록
@tool
def research_agent_tool(query: str) -> str:
    """전문 리서치 에이전트에게 정보 수집을 위임합니다."""
    result = research_executor.invoke({"input": query})
    return result["output"]

# 오케스트레이터 에이전트
orchestrator_tools = [research_agent_tool, create_report, analyze_data]
orchestrator_llm = ChatOpenAI(model="gpt-4o", temperature=0)

orchestrator_prompt = ChatPromptTemplate.from_messages([
    ("system", """당신은 AI 프로젝트 매니저입니다.
복잡한 목표를 받으면 서브 에이전트들에게 작업을 분배하고 결과를 통합합니다.
리서치가 필요하면 research_agent_tool을 사용하고,
분석이 완료되면 create_report로 최종 보고서를 작성하세요."""),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad"),
])

orchestrator_agent = create_openai_tools_agent(
    orchestrator_llm, orchestrator_tools, orchestrator_prompt
)
orchestrator = AgentExecutor(
    agent=orchestrator_agent,
    tools=orchestrator_tools,
    verbose=True,
    max_iterations=8
)

# 실행
result = orchestrator.invoke({
    "input": "AI 스타트업 투자 트렌드를 분석하고 투자자를 위한 보고서를 작성해줘"
})📊LangSmith로 에이전트 모니터링하기
에이전트를 실제 서비스에 올리면 모니터링이 필수야.
LangChain 팀이 만든 LangSmith를 쓰면 에이전트의 모든 실행 과정을 시각적으로 추적할 수 있어.
# LangSmith 설정 (.env에 추가)
# LANGCHAIN_TRACING_V2=true
# LANGCHAIN_API_KEY=ls__xxxxxxxxxxxxxxxx
# LANGCHAIN_PROJECT=my-autogpt-project

import os
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = "ls__your_key_here"
os.environ["LANGCHAIN_PROJECT"] = "AutoGPT-Demo"

# 이후 에이전트 실행 시 자동으로 LangSmith에 로그 전송됨!
# https://smith.langchain.com 에서 실시간 확인 가능각 실행의 토큰 사용량, 레이턴시, 에러 로그를 한눈에 볼 수 있어서 최적화할 때 엄청 유용함!
🎯실전 활용 아이디어 & 마무리
LangChain으로 AutoGPT형 에이전트를 만들 수 있게 됐으니, 이걸로 뭘 만들 수 있는지 아이디어 폭발시켜보자ㅋㅋ
| 활용 분야 | 에이전트 역할 | 필요 도구 |
|---|---|---|
| 📈 주식/투자 분석 | 시장 데이터 수집 → 분석 → 리포트 | 금융 API, 웹 검색, 계산기 |
| 📝 콘텐츠 마케팅 | 트렌드 파악 → 글 초안 → SEO 최적화 | 검색, 파일 저장, 분석 |
| 💻 코드 리뷰 자동화 | 코드 분석 → 버그 탐지 → 개선안 제시 | Python REPL, 파일 읽기 |
| 🛒 가격 비교 봇 | 여러 사이트 크롤링 → 최저가 탐색 | HTTP 요청, 파싱, DB 저장 |
| 📧 이메일 자동화 | 수신 메일 분류 → 자동 답장 초안 | 이메일 API, 분류기 |
| 🎓 학습 도우미 | 개념 설명 → 퀴즈 생성 → 피드백 | 위키피디아, 파일 저장 |
LangChain 기반 에이전트 개발, 자동화 봇 제작, AI 워크플로우 구축 같은 재능들이 핫하게 거래되고 있으니
이 기술 익혀두면 프리랜서로도 충분히 활용 가능함 💪
오늘 배운 내용을 정리해보면:
LangChain은 업데이트 속도가 엄청 빠르니까 공식 문서(python.langchain.com)를 자주 확인하는 게 중요해.
특히 LangGraph는 2024-2025년 기준으로 LangChain 팀이 가장 밀고 있는 방향이니까 꼭 공부해봐!
이제 직접 만들어보면서 실력 키워나가면 됨. 화이팅! 🚀

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.