

Ver3.5 Swift 컴파일러와 LLVM을 통한코드 최적화 원리와 실전 이해
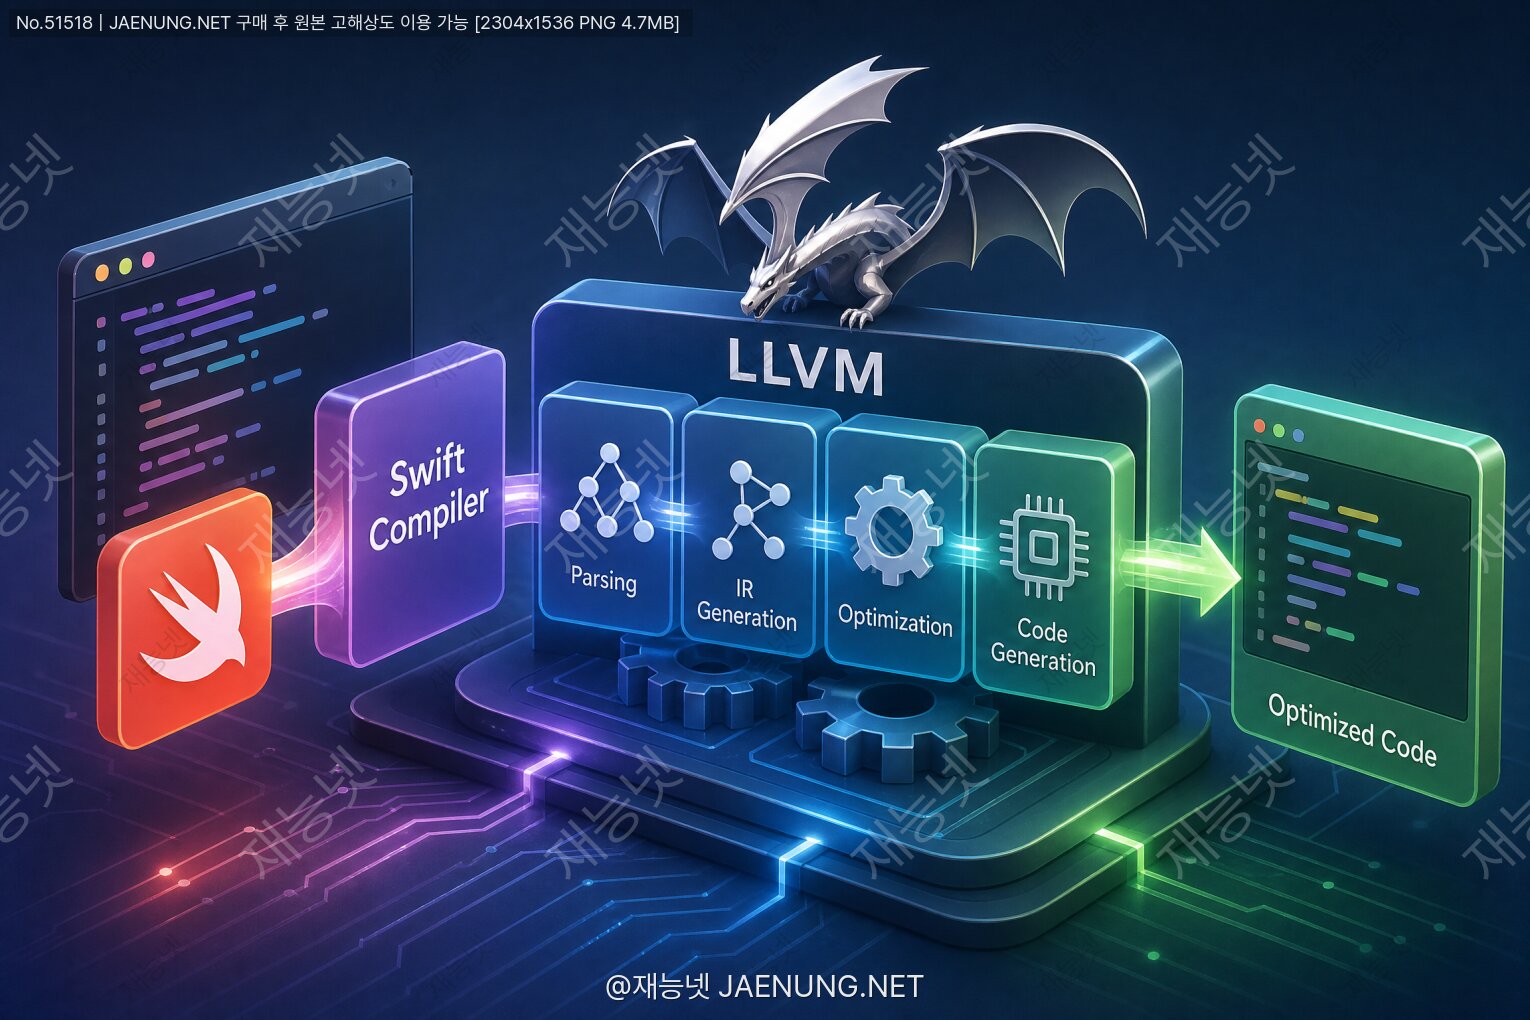
Swift 컴파일러와 LLVM을 통한
코드 최적화 원리와 실전 이해
야, 솔직히 말해봐. Swift로 코드 짜면서 컴파일러가 내 코드를 어떻게 처리하는지 궁금했던 적 없어? 그냥 빌드 누르면 앱이 돌아가니까 "뭐, 알아서 되겠지~" 하고 넘어간 적 분명히 있을 거야. 나도 그랬거든. 😅
근데 있잖아, Swift 컴파일러가 내 코드를 받아서 최종 실행 파일로 만들기까지의 과정을 이해하면, 진짜로 더 빠르고 효율적인 코드를 짤 수 있게 돼. 단순히 "이렇게 하면 빠르다더라"가 아니라, 왜 빠른지를 알게 되는 거지.
오늘은 Swift 컴파일러의 내부 구조부터 LLVM이 뭔지, 그리고 실제로 어떤 최적화가 일어나는지까지 완전 친근하게 파헤쳐볼 거야. 커피 한 잔 들고 편하게 읽어봐! ☕
Swift 컴파일러는 Apple이 만든 오픈소스 컴파일러야. 공식 이름은 swiftc고, 터미널에서 직접 실행할 수도 있어. 근데 이게 단순히 "코드를 기계어로 바꿔주는 도구"라고만 생각하면 너무 억울해. 실제로는 훨씬 복잡하고 정교한 작업을 해.
Swift 컴파일러는 크게 두 개의 큰 덩어리로 나뉘어:
언어마다 문법이나 특성이 다르잖아. 그래서 각 언어의 "특성을 이해하는 부분"(프론트엔드)은 따로 만들고, "기계어로 변환하는 부분"(백엔드)은 공유하는 거야. 덕분에 LLVM 팀이 백엔드를 개선하면 Swift, Rust, C++ 모두가 혜택을 받아! 효율적이지? 😎
Swift 컴파일러는 완전 오픈소스야. GitHub의 apple/swift 레포에서 볼 수 있어. 실제로 컴파일러 내부를 뜯어보고 싶다면 거기서 시작하면 돼. 물론 코드량이 어마어마해서 처음엔 좀 압도될 수 있지만... 😅
자, 이제 진짜 재미있는 부분이야. Swift 소스코드가 실행 파일이 되기까지 어떤 단계를 거치는지 하나씩 살펴볼게.
컴파일러가 제일 먼저 하는 일은 소스코드를 읽는 것이야. 근데 그냥 텍스트로 읽는 게 아니라, 의미 있는 단위로 쪼개는 거야.
렉싱(Lexing)은 소스코드를 토큰(Token)이라는 최소 단위로 분리하는 과정이야. 예를 들어:
let x = 42 + 8이걸 렉서가 처리하면 이런 토큰들이 나와:
let x = (대입) 42 (정수리터럴) + (연산자) 8 (정수리터럴)
파싱(Parsing)은 이 토큰들을 가지고 AST(Abstract Syntax Tree, 추상 구문 트리)를 만드는 과정이야. AST는 코드의 구조를 트리 형태로 표현한 거야.
let result = (a + b) * c 라는 코드가 있으면,
AST는 이렇게 생겼어:
LetDecl (result)
  └── BinaryExpr (*)
        ├── ParenExpr
        │     └── BinaryExpr (+)
        │           ├── DeclRefExpr (a)
        │           └── DeclRefExpr (b)
└── DeclRefExpr (c)AST가 만들어지면, 이제 의미 분석을 해. 이 단계에서 Swift의 강력한 타입 시스템이 작동해.
예를 들어 이런 코드를 쓰면:
let x: Int = "hello" // 타입 에러!의미 분석 단계에서 String을 Int에 넣으려 한다는 걸 감지하고 에러를 뱉어. 우리가 Xcode에서 빨간 줄 보는 게 바로 이 단계에서 발생하는 거야.
타입 추론도 이 단계에서 일어나. let x = 42라고 쓰면 컴파일러가 42를 보고 "아, 이건 Int겠구나"라고 자동으로 타입을 결정해줘.
Swift의 타입 추론은 단순히 리터럴 타입만 추론하는 게 아니야. 복잡한 제네릭 타입도 추론하고, 클로저의 반환 타입도 추론해. 이 모든 게 컴파일 타임에 일어나기 때문에 런타임 오버헤드가 없어!
여기서부터 진짜 흥미로워져. Swift 컴파일러는 AST를 바로 LLVM IR로 변환하지 않아. 중간에 SIL(Swift Intermediate Language)이라는 자체 중간 표현을 거쳐.
SIL은 Swift 팀이 특별히 만든 거야. 왜냐하면 LLVM IR은 Swift의 고수준 개념들(ARC, 프로토콜 디스패치, 제네릭 등)을 표현하기에 너무 저수준이거든. SIL은 이런 Swift 전용 개념들을 표현할 수 있으면서도, 최적화를 적용할 수 있는 형태야.
터미널에서 이렇게 하면 SIL을 볼 수 있어:
swiftc -emit-sil hello.swiftSIL에는 두 가지 형태가 있어:
AST에서 직접 생성된 초기 형태. 아직 최적화 안 됨.
SIL 최적화 패스를 거친 후의 형태. LLVM으로 넘어갈 준비 완료!
SIL 단계에서 Swift 컴파일러는 Swift 언어에 특화된 최적화를 수행해. 이게 Swift가 다른 언어들보다 특별한 이유 중 하나야.
Swift는 메모리 관리를 위해 ARC를 사용해. 객체를 참조할 때마다 retain을 호출하고, 참조가 끝나면 release를 호출하는 방식이야. 근데 이게 너무 많이 호출되면 성능이 떨어지겠지?
SIL 최적화기는 불필요한 retain/release 쌍을 찾아서 제거해. 예를 들어:
// 최적화 전 (개념적으로)
retain(obj)
doSomething(obj)
release(obj)
retain(obj)  // 바로 다시 retain? 불필요!
doAnotherThing(obj)
release(obj)

// 최적화 후
retain(obj)
doSomething(obj)
doAnotherThing(obj)
release(obj)Apple의 발표에 따르면, ARC 최적화를 통해 retain/release 호출 횟수를 상당히 줄일 수 있어. 특히 루프 안에서 객체를 반복적으로 다루는 코드에서 효과가 커.
함수를 호출할 때마다 스택 프레임을 만들고, 인자를 전달하고, 반환값을 받아오는 오버헤드가 생겨. 함수가 작고 자주 호출된다면, 아예 함수 호출 대신 함수 본문을 그 자리에 복사해 넣는 게 더 빠를 수 있어. 이게 인라이닝이야.
// 인라이닝 전
func square(_ x: Int) -> Int { return x * x }
let result = square(5)

// 인라이닝 후 (컴파일러가 자동으로)
let result = 5 * 5  // 함수 호출 없이!
Swift에서는 @inline(__always) 어트리뷰트로 강제 인라이닝을 지시할 수도 있고, @inline(never)로 인라이닝을 막을 수도 있어.
이건 Swift의 진짜 킬러 피처야! 제네릭 함수는 어떤 타입이든 받을 수 있어서 편리하지만, 런타임에 타입 정보를 처리하는 오버헤드가 있어. 근데 Swift 컴파일러는 어떤 타입으로 제네릭 함수가 호출되는지 컴파일 타임에 알 수 있으면, 그 타입에 특화된 버전을 따로 만들어!
// 제네릭 함수
func swap<T>(_ a: inout T, _ b: inout T) {
    let temp = a
    a = b
    b = temp
}

// Int로 호출하면...
var x = 1, y = 2
swap(&x, &y)

// 컴파일러가 이런 특수화 버전을 만들어:
// func swap_Int(_ a: inout Int, _ b: inout Int) { ... }제네릭 특수화 덕분에 Swift의 제네릭 코드는 C++ 템플릿과 비슷한 성능을 낼 수 있어. "제네릭이니까 느리겠지"라는 편견은 버려도 돼! 오히려 잘 작성된 제네릭 코드가 타입별로 특수화되어 최적의 성능을 낼 수 있거든.
프로토콜을 통해 메서드를 호출할 때, 런타임에 어떤 구현을 호출할지 결정해야 해. 이걸 동적 디스패치(Dynamic Dispatch)라고 해. 근데 컴파일러가 "어차피 이 타입은 항상 이 구현을 쓸 거야"라는 걸 알 수 있으면, 동적 디스패치를 정적 디스패치(Static Dispatch)로 바꿔버려. 이게 Devirtualization이야.
protocol Animal {
    func speak() -> String
}

struct Dog: Animal {
    func speak() -> String { return "멍멍!" }
}

// 컴파일러가 Dog임을 알면
let dog = Dog()
let sound = dog.speak() // 동적 디스패치 → 정적 디스패치로 최적화!자, 이제 LLVM 얘기를 해보자. LLVM은 Low Level Virtual Machine의 약자인데, 이름이 좀 오해를 불러일으켜. 실제로는 가상 머신이 아니라 컴파일러 인프라 프레임워크야.
LLVM은 2000년대 초 Chris Lattner가 UIUC(일리노이 대학교)에서 박사 논문 프로젝트로 시작했어. 그리고 이 Chris Lattner가 나중에 Apple에 합류해서 Swift를 만들었지! 그래서 Swift와 LLVM의 궁합이 그렇게 좋은 거야. 😄
LLVM의 핵심 아이디어는 언어와 아키텍처를 분리하는 거야. LLVM IR(Intermediate Representation)이라는 공통 중간 표현을 사용하면:
Swift, C, C++, Rust, Julia, Kotlin Native 등이 모두 LLVM 사용
x86, ARM, ARM64, RISC-V, WebAssembly 등 지원
한 번 개발된 최적화가 모든 언어에 적용됨
LLVM IR은 어셈블리와 비슷하지만 더 추상적이야. 실제로 어떻게 생겼는지 볼까?
Swift 코드:
func add(_ a: Int, _ b: Int) -> Int {
    return a + b
}
LLVM IR (개념적으로):
define i64 @add(i64 %a, i64 %b) {
entry:
  %result = add i64 %a, %b
  ret i64 %result
}
LLVM IR은 SSA(Static Single Assignment) 형태야. 각 변수는 딱 한 번만 할당돼. 이 형태가 최적화를 훨씬 쉽게 만들어줘.
swiftc -emit-ir hello.swift이 명령어로 Swift 코드에서 생성된 LLVM IR을 볼 수 있어. 처음엔 좀 복잡해 보이지만, 패턴을 파악하면 재미있어!
LLVM은 수십 가지의 최적화 패스를 가지고 있어. 그 중에서 가장 중요하고 흥미로운 것들을 살펴보자!
컴파일 타임에 계산할 수 있는 상수 표현식을 미리 계산해버리는 거야.
// 소스코드
let x = 2 * 3 * 7

// 컴파일러가 최적화하면
let x = 42  // 이미 계산됨!
이건 단순해 보이지만, 복잡한 표현식에서도 적용돼. 심지어 함수 인라이닝과 결합되면 엄청난 효과를 발휘해.
루프는 성능에 가장 큰 영향을 미치는 부분이야. LLVM은 다양한 루프 최적화를 수행해:
루프 안에서 매번 같은 결과를 내는 계산을 루프 밖으로 빼내는 거야.
// 최적화 전
for i in 0..<1000 {
    let factor = width * height  // 매번 계산!
    result[i] = data[i] * factor
}

// 최적화 후
let factor = width * height  // 루프 밖으로!
for i in 0..<1000 {
    result[i] = data[i] * factor
}루프를 여러 번 반복하는 대신, 루프 본문을 여러 번 복사해서 루프 오버헤드를 줄이는 거야.
// 최적화 전
for i in 0..<4 {
    sum += arr[i]
}

// 언롤링 후 (개념적으로)
sum += arr[0]
sum += arr[1]
sum += arr[2]
sum += arr[3]현대 CPU는 SIMD(Single Instruction, Multiple Data) 명령어를 지원해. 한 번의 명령으로 여러 데이터를 동시에 처리할 수 있어. LLVM은 루프를 분석해서 자동으로 SIMD 명령어를 사용하도록 변환해!
// 이런 루프를
for i in 0..<8 {
    result[i] = a[i] + b[i]
}

// SIMD로 한 번에 8개씩 처리!절대 실행되지 않는 코드를 찾아서 제거해. 예를 들어:
func compute() -> Int {
    let x = 42
    let y = 100  // y는 사용되지 않음!
    return x
}
// y 관련 코드는 완전히 제거됨같은 계산이 여러 번 나오면, 한 번만 계산하고 결과를 재사용해.
// 최적화 전
let a = x * y + z
let b = x * y - z  // x * y 또 계산!

// 최적화 후
let xy = x * y  // 한 번만 계산
let a = xy + z
let b = xy - z비싼 연산을 더 싼 연산으로 대체해. 가장 고전적인 예는 곱셈을 시프트 연산으로 바꾸는 거야.
// 최적화 전
let x = n * 8

// 최적화 후 (2의 거듭제곱 곱셈)
let x = n << 3  // 왼쪽으로 3비트 시프트 = *8
시프트 연산이 곱셈보다 훨씬 빠르거든!
Swift 컴파일러는 최적화 레벨을 선택할 수 있어. 각 레벨마다 적용되는 최적화의 양이 달라.
| 플래그 | Xcode 설정 | 최적화 수준 | 특징 |
|---|---|---|---|
| -Onone | Debug | 없음 | 빠른 컴파일, 디버깅 용이 |
| -O | Release | 표준 | 성능과 컴파일 시간 균형 |
| -Osize | Release (Size) | 크기 우선 | 바이너리 크기 최소화 |
| -Ounchecked | 특수 상황 | 최대 (위험) | 안전 체크 제거, 주의 필요! |
-Ounchecked는 배열 범위 체크, 정수 오버플로우 체크 등 안전 장치를 제거해서 성능을 극대화해. 근데 이 안전 장치들이 없으면 버그가 발생했을 때 정의되지 않은 동작(Undefined Behavior)이 일어날 수 있어. 정말 성능이 중요한 특수한 상황에서만 사용해야 해!
일반적으로 컴파일러는 파일 단위로 최적화해. 근데 WMO를 사용하면 프로젝트 전체를 한 번에 분석해서 더 강력한 최적화를 적용할 수 있어.
WMO의 장점:
컴파일러가 최적화를 잘 할 수 있도록 코드를 작성하는 방법이 있어. 이걸 알면 진짜 실력 있는 Swift 개발자가 될 수 있어!
Swift의 struct는 값 타입이야. 참조 타입(class)과 달리 힙 할당이 필요 없고, ARC 오버헤드도 없어. 컴파일러가 최적화하기도 훨씬 쉬워.
// 참조 타입 (힙 할당, ARC 오버헤드)
class PointClass {
    var x: Double
    var y: Double
    init(x: Double, y: Double) { self.x = x; self.y = y }
}

// 값 타입 (스택 할당, ARC 없음, 더 빠름!)
struct PointStruct {
    var x: Double
    var y: Double
}- 데이터가 단순하고 복사 비용이 크지 않을 때
- 상속이 필요 없을 때
- 동일성(identity)보다 동등성(equality)이 중요할 때
- 스레드 안전성이 필요할 때 (값 타입은 복사되니까!)
클래스를 사용해야 한다면, 상속이 필요 없는 클래스에는 final을 붙여줘. 컴파일러가 devirtualization을 더 쉽게 할 수 있어.
// final 없이 - 동적 디스패치 필요
class NetworkManager {
    func fetch() { ... }
}

// final 있음 - 정적 디스패치 가능!
final class NetworkManager {
    func fetch() { ... }
}프로토콜 타입으로 값을 저장하면 Existential Container가 사용돼. 이건 내부적으로 값 버퍼 + 타입 메타데이터 + vtable 포인터로 구성되어 있어서 오버헤드가 있어.
// 이렇게 하면 Existential Container 사용 (오버헤드 있음)
var animals: [Animal] = [Dog(), Cat()]

// 제네릭을 사용하면 특수화 가능 (더 효율적)
func process<T: Animal>(_ animal: T) {
    animal.speak()
}Swift 5.7부터 any Animal은 Existential을 명시적으로 나타내고, some Animal은 불투명 타입(Opaque Type)을 나타내. some을 사용하면 컴파일러가 실제 타입을 알 수 있어서 더 최적화하기 좋아!
Swift의 Array, Dictionary, String 같은 표준 라이브러리 타입들은 Copy-on-Write를 구현해. 값 타입이지만 실제 복사는 수정이 일어날 때만 해. 이 덕분에 불필요한 복사를 피할 수 있어.
var array1 = [1, 2, 3, 4, 5]
var array2 = array1  // 아직 복사 안 됨! 같은 버퍼 공유

array2.append(6) // 이 시점에 실제 복사 발생!라이브러리를 만들 때 유용한 어트리뷰트야. @inlinable을 붙이면 라이브러리 외부에서도 이 함수를 인라이닝할 수 있어.
@inlinable
public func fastCompute(_ x: Int) -> Int {
    return x * x + x
}
// 이 함수를 사용하는 코드에서 인라이닝 가능!정말 성능이 중요한 부분에서는 포인터를 직접 다룰 수도 있어. 물론 안전성은 개발자가 보장해야 해.
var value = 42
withUnsafePointer(to: &value) { ptr in
    // ptr을 통해 직접 메모리 접근
    print(ptr.pointee)
}컴파일러가 실제로 어떤 최적화를 했는지 확인하는 방법들이 있어. 이걸 알면 내 코드가 어떻게 처리되는지 직접 볼 수 있어!
| 명령어 | 출력 내용 |
|---|---|
| swiftc -dump-ast hello.swift | AST(추상 구문 트리) 출력 |
| swiftc -emit-sil hello.swift | 최적화된 SIL 출력 |
| swiftc -emit-sil -Onone hello.swift | 최적화 없는 SIL 출력 |
| swiftc -emit-ir hello.swift | LLVM IR 출력 |
| swiftc -emit-assembly hello.swift | 어셈블리 코드 출력 |
Xcode의 Instruments를 사용하면 실제 실행 시 성능을 측정할 수 있어. 특히 Time Profiler는 어떤 함수에서 시간이 많이 걸리는지 보여줘.
Instruments 사용 팁:
swift-benchmark 패키지를 사용하면 코드 성능을 정확하게 측정할 수 있어.
import Benchmark

let benchmarks = {
    Benchmark("Array append") { benchmark in
        for _ in benchmark.scaledIterations {
            var arr = [Int]()
            for i in 0..<1000 {
                arr.append(i)
            }
        }
    }
}이론만 알면 재미없잖아. 실제로 어떤 상황에서 최적화가 큰 차이를 만드는지 살펴보자!
// 방법 A: 프로토콜 타입 사용 (Existential)
func processAnimal(_ animal: any Animal) {
    animal.speak()
}

// 방법 B: 제네릭 사용 (특수화 가능)
func processAnimal<T: Animal>(_ animal: T) {
    animal.speak()
}

// 방법 B가 컴파일러 최적화에 훨씬 유리해!
방법 B는 컴파일러가 실제 타입을 알 수 있어서 인라이닝, devirtualization, 제네릭 특수화 등을 적용할 수 있어. 방법 A는 런타임에 타입을 결정해야 해서 이런 최적화가 어려워.
// 일반 Array (브릿징 오버헤드 가능)
var arr: [SomeClass] = []

// ContiguousArray (항상 연속 메모리 보장)
var arr: ContiguousArray<SomeClass> = []
클래스 타입의 배열에서 ContiguousArray를 사용하면 Objective-C 브릿징 오버헤드를 피할 수 있어. 순수 Swift 코드에서는 성능 차이가 있을 수 있어.
// 느린 방법: 루프에서 문자열 연결
var result = ""
for i in 0..<1000 {
    result += "\(i)"  // 매번 새 문자열 생성!
}

// 빠른 방법: reserveCapacity 사용
var result = ""
result.reserveCapacity(4000)  // 미리 공간 확보
for i in 0..<1000 {
    result += "\(i)"
}

// 더 빠른 방법: joined 사용
let result = (0..<1000).map { "\($0)" }.joined()루프에서 +=로 문자열을 연결하면 매번 새로운 문자열이 생성되어 O(n²) 복잡도가 돼. 큰 문자열을 만들 때는 joined()나 reserveCapacity()를 활용해!
// 클로저가 self를 캡처하면 retain/release 발생
class ViewController {
    var data = [Int]()

    func processData() {
        // [weak self]나 [unowned self]로 캡처 방식 제어
        DispatchQueue.global().async { [weak self] in
            guard let self = self else { return }
            // self 사용
        }
    }
}
클로저의 캡처 리스트를 잘 관리하면 불필요한 ARC 오버헤드를 줄일 수 있어.
Apple Silicon(M1, M2, M3, M4 시리즈)은 ARM64 아키텍처를 기반으로 해. LLVM은 ARM64를 완벽하게 지원하고, Apple은 LLVM에 Apple Silicon 전용 최적화를 추가했어.
LLVM의 ARM64 백엔드는 다음과 같은 최적화를 수행해:
128비트 벡터 연산으로 한 번에 여러 데이터 처리
Apple Matrix Extension으로 행렬 연산 가속
Apple Silicon의 비순서 실행 파이프라인 최적 활용
Apple의 Accelerate 프레임워크는 LLVM이 생성한 코드와 함께 Apple Silicon의 하드웨어 가속을 최대한 활용해. vDSP, vImage, BLAS, LAPACK 등의 함수들이 Apple Silicon에 최적화되어 있어.
import Accelerate

// LLVM + Apple Silicon 최적화된 벡터 덧셈
var a: [Float] = [1.0, 2.0, 3.0, 4.0]
var b: [Float] = [5.0, 6.0, 7.0, 8.0]
var result = [Float](repeating: 0, count: 4)

vDSP_vadd(a, 1, b, 1, &result, 1, vDSP_Length(4))
// 결과: [6.0, 8.0, 10.0, 12.0]Apple Silicon 전환 과정에서 Universal Binary(Fat Binary)가 중요해졌어. 하나의 앱 바이너리에 x86_64와 arm64 코드를 모두 포함하는 거야. LLVM은 두 아키텍처 모두를 위한 코드를 생성할 수 있어서 이게 가능해.
# Universal Binary 빌드
xcodebuild -scheme MyApp \
  -destination "generic/platform=macOS" \
  ARCHS="x86_64 arm64" \
buildSwift 5.9부터 Ownership 기능이 추가됐어. consuming, borrowing, copy 키워드를 통해 값의 소유권을 명시적으로 제어할 수 있어.
// consuming: 값의 소유권을 가져옴 (복사 없음)
func process(_ value: consuming LargeStruct) {
    // value를 소비하고 반환하지 않음
}

// borrowing: 값을 빌려서 읽기만 함
func inspect(_ value: borrowing LargeStruct) {
    print(value.description)
}consuming을 사용하면 컴파일러가 불필요한 복사를 피할 수 있어. 큰 구조체를 함수에 전달할 때 특히 유용해. borrowing은 읽기 전용 접근임을 명시해서 ARC 오버헤드를 줄여줘.
Swift의 async/await와 Actor는 컴파일러 레벨에서 지원돼. 컴파일러는 비동기 함수를 상태 머신으로 변환하고, Actor의 격리를 컴파일 타임에 검증해.
actor BankAccount {
    private var balance: Double = 0

    func deposit(_ amount: Double) {
        balance += amount  // Actor 격리로 안전!
    }
}

// 컴파일러가 Actor 외부에서의 접근을 검증
let account = BankAccount()
await account.deposit(100) // await 필요 - 컴파일러가 강제!Swift 5.9에서 도입된 Macros는 컴파일 타임에 코드를 생성하는 기능이야. 컴파일러 플러그인으로 동작하며, SwiftSyntax를 사용해서 AST를 직접 조작할 수 있어.
// @Observable 매크로 사용 예시
@Observable
class Person {
    var name: String = ""
    var age: Int = 0
}

// 컴파일러가 자동으로 관찰 가능한 코드를 생성!LTO는 링킹 단계에서 추가 최적화를 수행해. 여러 오브젝트 파일을 합칠 때 전체 프로그램을 분석해서 최적화할 수 있어. WMO와 비슷하지만 더 낮은 레벨에서 동작해.
# LTO 활성화 (Xcode Build Settings)
# Other Linker Flags에 추가:
-flto지금까지 배운 내용을 바탕으로, 실제 프로젝트에서 활용할 수 있는 체크리스트를 만들어봤어!
먼저 올바르게 동작하는 코드를 작성하고, 측정을 통해 실제 병목을 찾은 다음 최적화해. 근거 없는 최적화는 코드만 복잡하게 만들어!
와, 여기까지 읽어줬다면 진짜 대단한 거야! 👏 오늘 우리가 함께 살펴본 내용을 정리해볼게.
프론트엔드(SIL)와 LLVM 백엔드의 2단계 구조
렉싱 → 파싱 → 의미분석 → SIL → LLVM IR → 기계어
ARC 최적화, 인라이닝, 제네릭 특수화, Devirtualization
상수 폴딩, 루프 최적화, 벡터화, CSE, 데드코드 제거
final, struct, 제네릭, WMO, 측정 우선 원칙
NEON SIMD, ARM64 최적화, Universal Binary
컴파일러 최적화는 처음엔 어렵게 느껴지지만, 이해하고 나면 코드를 보는 눈이 완전히 달라져. "이 코드가 컴파일러에게 어떻게 보일까?"를 생각하면서 코딩하면 자연스럽게 더 좋은 코드를 작성하게 돼.
더 깊이 공부하고 싶다면 재능넷에서 Swift 성능 최적화 전문가를 찾아보는 것도 좋은 방법이야. 실제 프로젝트에 적용하면서 배우는 게 가장 빠르거든! 🚀
그리고 공식 자료도 꼭 참고해봐:
1. 작은 Swift 파일을 만들어서 swiftc -emit-sil로 SIL을 직접 확인해봐
2. Instruments로 실제 앱의 성능 병목을 찾아봐
3. 제네릭 특수화가 실제로 일어나는지 -emit-ir로 확인해봐
4. WMO 활성화 전후 빌드 시간과 실행 성능을 비교해봐
관련 키워드
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.