

Ver3.5 품질관리 통계와 6시그마를 활용한프로세스 개선 완전 정복 🎯
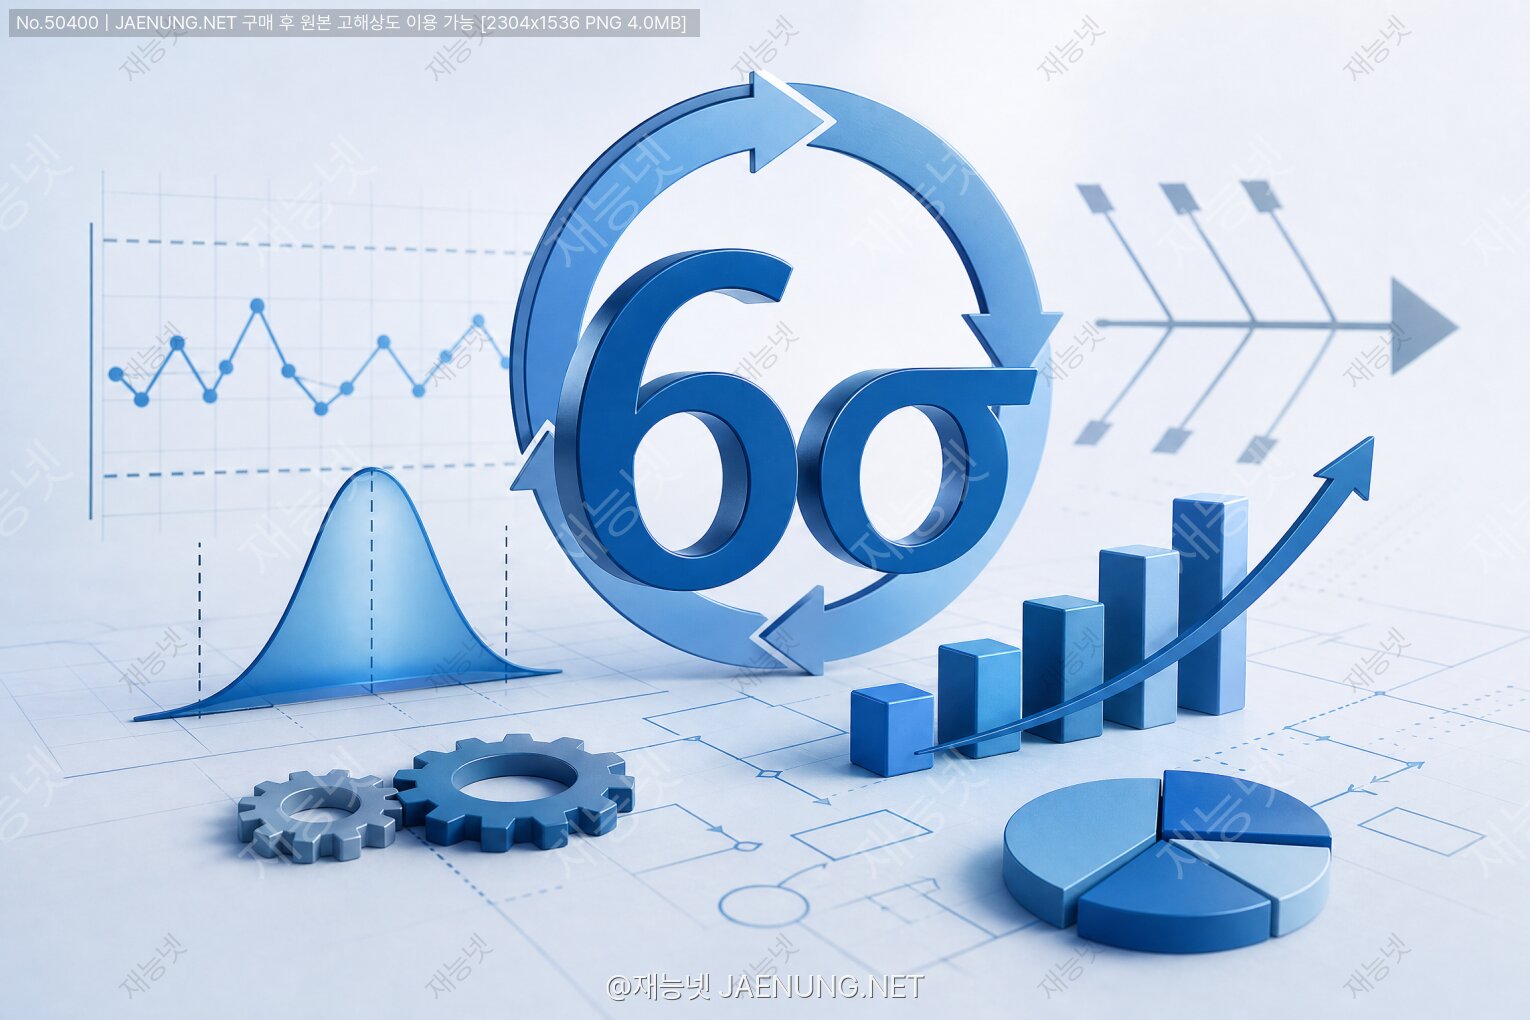
품질관리 통계와 6시그마를 활용한
프로세스 개선 완전 정복 🎯
데이터로 말하고, 숫자로 증명하는 스마트한 품질 혁신의 모든 것
야, 솔직히 말해볼게. 🙋
"품질관리"라는 단어 들으면 왠지 딱딱하고 어렵게 느껴지지 않아? 공장 아저씨들이 클립보드 들고 돌아다니는 이미지? 아니면 두꺼운 매뉴얼 책? 😅
근데 있잖아, 품질관리 통계와 6시그마는 사실 엄청나게 실용적이고 강력한 도구야. 제조업은 물론이고 서비스업, IT, 의료, 금융까지 — 어디서든 "더 잘하고 싶다"는 마음이 있다면 이 방법론이 빛을 발해.
오늘은 친구한테 설명해주듯이, 품질관리 통계의 핵심 개념부터 6시그마 방법론, 실제 프로세스 개선 사례까지 처음부터 끝까지 제대로 파헤쳐볼 거야. 커피 한 잔 들고 편하게 읽어봐! ☕
📐 1. 품질관리 통계, 왜 필요한 거야?
먼저 기본 질문부터 해보자. 왜 품질관리에 통계가 필요할까?
생각해봐. 어떤 공장에서 볼트를 만든다고 치자. 하루에 10만 개를 만드는데, 그걸 하나하나 다 검사할 수 있어? 물리적으로 불가능하잖아. 그래서 통계적 방법을 써서 일부만 검사하고도 전체 품질을 파악하는 거야.
또 다른 이유도 있어. 아무리 잘 만들어도 제품마다 조금씩 차이가 생겨. 이걸 변동(Variation)이라고 하는데, 이 변동을 이해하고 관리하는 게 품질관리의 핵심이야.
🎯 품질관리 통계의 3가지 핵심 목적
1현상 파악 — 지금 프로세스가 어떤 상태인지 객관적으로 측정
2원인 분석 — 문제가 왜 발생하는지 데이터로 규명
3개선 검증 — 개선 후 정말 좋아졌는지 통계적으로 확인
📊 기술통계 vs 추론통계: 뭐가 달라?
품질관리에서 쓰는 통계는 크게 두 가지로 나뉘어.
🔍 기술통계(Descriptive Statistics)
데이터를 요약하고 설명하는 통계야. "우리 제품의 평균 무게는 100g이고, 표준편차는 2g이야" 같은 거지.
주요 지표:
• 평균(Mean) — 데이터의 중심값
• 중앙값(Median) — 데이터를 크기순으로 나열했을 때 가운데 값
• 표준편차(Standard Deviation) — 데이터가 평균에서 얼마나 퍼져있는지
• 범위(Range) — 최댓값 - 최솟값
🔮 추론통계(Inferential Statistics)
표본 데이터로 모집단 전체를 추론하는 통계야. "100개 샘플을 검사했더니 95% 신뢰수준에서 전체 불량률은 2% 이하야" 같은 거지.
주요 기법:
• 가설검정(Hypothesis Testing) — 주장이 통계적으로 유의한지 검증
• 신뢰구간(Confidence Interval) — 모수가 있을 범위 추정
• 회귀분석(Regression Analysis) — 변수 간 관계 분석
• 분산분석(ANOVA) — 여러 그룹 간 평균 차이 검정
📏 측정의 4가지 척도
데이터를 다루기 전에 측정 척도를 이해해야 해. 어떤 척도냐에 따라 쓸 수 있는 통계 기법이 달라지거든.
| 척도 유형 | 특징 | 예시 | 사용 가능 통계 |
|---|---|---|---|
| 명목척도 | 분류만 가능, 순서 없음 | 불량 유형 (A, B, C) | 빈도, 최빈값 |
| 순서척도 | 순서 있음, 간격 불균등 | 만족도 (1~5점) | 중앙값, 백분위 |
| 등간척도 | 균등 간격, 절대 0 없음 | 온도(℃) | 평균, 표준편차 |
| 비율척도 | 절대 0 존재, 비율 의미 있음 | 무게, 길이, 시간 | 모든 통계 기법 |
🔔 2. 정규분포와 변동 — 품질의 언어를 배우자
품질관리 통계에서 가장 중요한 개념이 바로 정규분포(Normal Distribution)야. 왜냐고? 자연계에서 발생하는 대부분의 변동이 정규분포를 따르거든. 제품 치수, 무게, 강도... 거의 다 정규분포야.
🎲 정규분포의 핵심 특성
정규분포는 종 모양(Bell Curve)의 대칭적인 분포야. 핵심 특성을 알아보자:
68-95-99.7 규칙 (경험적 규칙)
• 평균 ± 1σ 범위 안에 전체 데이터의 68.27% 포함
• 평균 ± 2σ 범위 안에 전체 데이터의 95.45% 포함
• 평균 ± 3σ 범위 안에 전체 데이터의 99.73% 포함
• 평균 ± 6σ 범위 안에 전체 데이터의 99.99966% 포함 ← 이게 6시그마!
⚡ 변동의 두 가지 원인
프로세스에서 발생하는 변동은 두 가지 원인으로 나뉘어. 이걸 구분하는 게 엄청 중요해!
🌊 일반 원인 변동 (Common Cause Variation)
프로세스에 내재된 자연스러운 변동이야. 완전히 없애기는 어렵고, 프로세스 자체를 바꿔야 줄일 수 있어.
예시: 원자재의 미세한 성분 차이, 온도·습도의 자연스러운 변화, 작업자의 피로도 변화
→ 이런 변동만 있으면 프로세스가 "통계적 관리 상태"에 있다고 해.
⚠️ 특수 원인 변동 (Special Cause Variation)
특정 원인에 의해 발생하는 비정상적인 변동이야. 원인을 찾아서 제거할 수 있어.
예시: 기계 고장, 불량 원자재 납품, 작업자 실수, 공구 마모
→ 이런 변동이 있으면 프로세스가 통계적 관리 이탈 상태야. 즉시 원인 조사 필요!
품질관리의 첫 번째 목표는 특수 원인 변동을 제거해서 프로세스를 안정적인 상태로 만드는 거야. 그 다음에 일반 원인 변동을 줄여서 프로세스 능력을 향상시키는 거지.
📐 표준편차(σ) 계산법
표준편차는 데이터가 평균에서 얼마나 퍼져있는지를 나타내는 지표야. 공식은 이래:
말로 풀어보면:
1 각 데이터에서 평균을 빼
2 그 차이를 제곱해 (음수 없애려고)
3 다 더해서 데이터 개수로 나눠
4 제곱근 취해
표준편차가 작을수록 데이터가 평균 주변에 몰려있다는 뜻이고, 클수록 퍼져있다는 뜻이야. 품질관리에서는 표준편차가 작을수록 좋아!
📈 3. SPC — 관리도로 프로세스를 실시간 감시하자
SPC(Statistical Process Control, 통계적 공정관리)는 통계 기법을 활용해서 프로세스를 실시간으로 모니터링하고 관리하는 방법이야. 핵심 도구는 바로 관리도(Control Chart)!
관리도는 1920년대 월터 슈하트(Walter Shewhart)가 벨 연구소에서 개발한 거야. 100년이 넘은 도구인데 아직도 현장에서 활발하게 쓰이고 있어. 그만큼 강력하다는 증거지! 💪
🗺️ 관리도의 구조
관리도는 시간 순서에 따라 데이터를 점으로 찍고, 세 가지 선을 그어서 만들어:
• UCL (Upper Control Limit, 관리 상한선) = 평균 + 3σ
• CL (Center Line, 중심선) = 평균
• LCL (Lower Control Limit, 관리 하한선) = 평균 - 3σ
데이터 점이 UCL과 LCL 사이에 있으면 "정상", 벗어나면 "이상 신호"야!
📋 관리도의 종류
데이터 유형에 따라 다른 관리도를 써야 해:
| 데이터 유형 | 관리도 종류 | 사용 상황 |
|---|---|---|
| 계량형 (연속 데이터) | X-bar & R 관리도 X-bar & S 관리도 I-MR 관리도 | 무게, 길이, 온도 등 서브그룹 크기 ≥ 10일 때 서브그룹 크기 = 1일 때 |
| 계수형 (이산 데이터) | p 관리도 np 관리도 c 관리도 u 관리도 | 불량률 관리 불량 개수 관리 결점 수 관리 (일정 면적) 단위당 결점 수 관리 |
🚨 관리도 이상 신호 8가지 규칙 (Nelson Rules)
관리도에서 이상 신호를 감지하는 규칙이 있어. 대표적인 게 넬슨 규칙(Nelson Rules)이야:
Rule 1: 1개 점이 3σ 밖에 위치 (UCL/LCL 초과)
Rule 2: 연속 9개 점이 중심선 같은 쪽에 위치
Rule 3: 연속 6개 점이 계속 증가 또는 감소
Rule 4: 연속 14개 점이 교대로 증가/감소
Rule 5: 연속 2개 점 중 2개가 2σ 밖에 위치
Rule 6: 연속 5개 점 중 4개가 1σ 밖에 위치
Rule 7: 연속 15개 점이 1σ 안에 위치 (너무 좋은 것도 이상!)
Rule 8: 연속 8개 점이 1σ 밖에 위치
Rule 7처럼 "너무 좋은 것도 이상 신호"라는 게 재밌지? 데이터가 너무 중심에 몰려있으면 측정 시스템에 문제가 있거나, 데이터를 조작했을 가능성이 있어. 실제 현장에서 중요한 포인트야!
⚙️ 4. 공정능력지수 — 우리 프로세스가 얼마나 잘하고 있나?
관리도로 프로세스가 안정적인지 확인했다면, 이제 그 프로세스가 고객의 요구사항을 얼마나 잘 충족하는지 측정해야 해. 이게 바로 공정능력지수(Process Capability Index)야! 🎯
📊 Cp와 Cpk — 핵심 지수 두 가지
Cp (공정능력지수)
규격 폭과 프로세스 변동의 비율이야. 프로세스가 규격 안에 들어갈 수 있는 잠재적 능력을 나타내.
여기서 USL = 규격 상한(Upper Specification Limit), LSL = 규격 하한(Lower Specification Limit)이야.
Cpk (수정 공정능력지수)
Cp는 프로세스가 중심에 있다고 가정하는데, 실제로는 중심이 치우쳐있을 수 있어. Cpk는 이 치우침(편향)을 반영한 지수야.
두 값 중 작은 값을 취하는 이유는, 프로세스가 어느 쪽 규격 한계에 더 가까운지를 보수적으로 평가하기 위해서야.
🏆 공정능력지수 해석 기준
| Cpk 값 | 시그마 수준 | 불량률 (PPM) | 평가 |
|---|---|---|---|
| 0.50 | 1.5σ | 133,614 | 매우 불량 ❌ |
| 0.67 | 2σ | 45,500 | 불량 ❌ |
| 1.00 | 3σ | 2,700 | 최소 기준 ⚠️ |
| 1.33 | 4σ | 63 | 양호 ✅ |
| 1.67 | 5σ | 0.57 | 우수 ✅✅ |
| 2.00 | 6σ | 0.0034 | 세계 최고 수준 🏆 |
일반적으로 Cpk ≥ 1.33 (4시그마 수준)을 목표로 해. 자동차 부품 같은 안전 관련 부품은 Cpk ≥ 1.67 이상을 요구하는 경우도 많아. 6시그마 수준인 Cpk = 2.0은 정말 최고 수준이야!
🔄 Cp와 Cpk의 관계
Cp와 Cpk의 관계를 이해하면 프로세스 개선 방향을 잡을 수 있어:
• Cp = Cpk: 프로세스가 규격 중심에 완벽하게 위치
• Cp > Cpk: 프로세스가 중심에서 벗어나 있음 → 중심 조정 필요
• Cp < 1.0: 프로세스 변동 자체가 너무 큼 → 변동 감소 필요
만약 Cp는 높은데 Cpk가 낮다면? 프로세스 능력은 있는데 중심이 치우쳐있다는 뜻이야. 이 경우 프로세스를 중심으로 조정하는 것만으로도 품질이 크게 개선돼!
🚀 5. 6시그마 방법론 — DMAIC로 문제를 완전히 해결하자
자, 이제 본격적으로 6시그마 방법론으로 들어가보자! 🎉
6시그마는 1980년대 모토로라(Motorola)에서 처음 개발됐어. 당시 모토로라는 일본 기업들과의 경쟁에서 밀리고 있었는데, 엔지니어 빌 스미스(Bill Smith)가 이 방법론을 개발해서 품질 혁신을 이뤄냈지. 이후 GE의 잭 웰치(Jack Welch)가 전사적으로 도입하면서 전 세계에 퍼졌어.
6시그마의 핵심 방법론은 DMAIC야. 다섯 단계로 이루어진 문제 해결 프레임워크지!
🔍 D단계 — Define (정의): 무엇을 해결할 건가?
D단계에서는 프로젝트의 범위와 목표를 명확히 정의해. 이 단계를 제대로 안 하면 나중에 엉뚱한 문제를 해결하는 사태가 벌어져!
주요 도구:
• 프로젝트 헌장(Project Charter) — 프로젝트 목표, 범위, 팀원, 일정 정의
• SIPOC 다이어그램 — Supplier(공급자), Input(입력), Process(프로세스), Output(출력), Customer(고객) 분석
• VOC (Voice of Customer) — 고객의 목소리 수집
• CTQ (Critical to Quality) — 품질에 결정적인 요소 도출
SMART 목표 설정: Specific(구체적), Measurable(측정 가능), Achievable(달성 가능), Relevant(관련성), Time-bound(기한 있음)
📏 M단계 — Measure (측정): 현재 상태를 정확히 파악하자
M단계에서는 현재 프로세스의 성능을 데이터로 측정해. 측정 없이는 개선도 없어!
주요 활동:
• 측정 시스템 분석(MSA) — 측정 도구가 정확한지 검증
• 데이터 수집 계획 — 무엇을, 언제, 어떻게 측정할지 계획
• 기준선(Baseline) 설정 — 현재 시그마 수준 계산
• 공정 흐름도(Process Map) — 프로세스 단계별 시각화
MSA의 핵심 — Gage R&R:
측정 시스템의 반복성(Repeatability)과 재현성(Reproducibility)을 분석해. 측정 오차가 전체 변동의 10% 이하면 OK, 30% 이상이면 측정 시스템 개선 필요!
🔬 A단계 — Analyze (분석): 진짜 원인을 찾아라
A단계는 6시그마에서 가장 중요한 단계야. 데이터를 분석해서 문제의 근본 원인을 찾아내는 거지.
주요 도구:
• 특성요인도(Fishbone/Ishikawa Diagram) — 원인을 체계적으로 분류
• 5 Why 분석 — "왜?"를 5번 반복해서 근본 원인 도달
• 파레토 차트 — 80:20 법칙으로 핵심 원인 파악
• 산점도(Scatter Plot) — 변수 간 상관관계 시각화
• 회귀분석 — 입력 변수와 출력 변수의 관계 정량화
• 가설검정 — 원인과 결과의 통계적 유의성 검증
🛠️ I단계 — Improve (개선): 해결책을 실행하자
A단계에서 찾은 근본 원인을 제거하는 해결책을 개발하고 실행해.
주요 도구:
• 브레인스토밍 — 창의적 해결책 아이디어 발굴
• 실험계획법(DOE) — 여러 요인의 최적 조합 찾기
• FMEA (Failure Mode and Effects Analysis) — 잠재적 실패 모드 사전 예방
• 파일럿 테스트 — 소규모로 먼저 검증
• 비용-편익 분석 — 개선 효과의 경제적 가치 산출
🔒 C단계 — Control (관리): 개선 효과를 유지하자
개선 후 다시 원래대로 돌아가는 건 최악의 시나리오야. C단계에서는 개선 효과를 지속적으로 유지하는 시스템을 구축해.
주요 도구:
• 관리 계획서(Control Plan) — 무엇을, 어떻게, 얼마나 자주 모니터링할지 문서화
• SPC 관리도 — 지속적인 프로세스 모니터링
• 표준 작업 절차서(SOP) — 개선된 방법을 표준화
• 실수 방지(Poka-Yoke) — 실수 자체를 불가능하게 만드는 설계
• 교육 훈련 — 관련 인원에게 새로운 방법 교육
🛠️ 6. 품질관리 7가지 기본 도구 (QC 7 Tools)
품질관리에는 "7가지 기본 도구"라고 불리는 클래식한 도구들이 있어. 일본의 품질 전문가 이시카와 가오루(石川馨)가 정리한 거야. 이 7가지만 제대로 써도 현장 품질 문제의 95%는 해결할 수 있다고 해! 🔥
① 체크시트 (Check Sheet)
데이터를 체계적으로 수집하기 위한 양식이야. 불량 유형별로 발생 횟수를 표시하는 가장 기본적인 도구지.
예시: 불량 유형 / 월요일 / 화요일 / 수요일 / 합계
스크래치 / |||| / ||| / |||| / 11
치수 불량 / || / | / ||| / 6
색상 불량 / | / || / | / 4
② 히스토그램 (Histogram)
데이터의 분포를 막대그래프로 시각화한 거야. 데이터가 어떤 모양으로 분포하는지, 정규분포를 따르는지, 이상한 패턴이 있는지 한눈에 볼 수 있어.
히스토그램으로 알 수 있는 것:
• 분포의 중심 위치
• 분포의 퍼짐 정도
• 치우침(왜도) 여부
• 이봉분포(두 개의 봉우리) — 두 개의 다른 프로세스가 섞인 신호!
③ 파레토 차트 (Pareto Chart)
이탈리아 경제학자 빌프레도 파레토의 이름을 딴 도구야. "전체 문제의 80%는 20%의 원인에서 발생한다"는 파레토 법칙을 시각화한 거지.
막대그래프(빈도순 정렬)와 누적 꺾은선 그래프를 합친 형태야. 어떤 원인이 가장 큰 영향을 미치는지 한눈에 파악할 수 있어.
실용 팁: 누적 비율이 80%에 해당하는 원인들에 집중하면 효율적으로 문제를 해결할 수 있어!
④ 특성요인도 (Fishbone / Ishikawa Diagram)
물고기 뼈처럼 생겼다고 해서 피시본 다이어그램이라고도 해. 문제(결과)의 원인을 체계적으로 분류하는 도구야.
4M 분류 (제조업):
• Man (사람) — 작업자 기술, 교육, 피로도
• Machine (기계) — 설비 상태, 정밀도, 유지보수
• Material (재료) — 원자재 품질, 공급업체
• Method (방법) — 작업 방법, 절차, 표준
서비스업에서는 여기에 Environment(환경), Measurement(측정)를 추가해서 6M을 쓰기도 해!
⑤ 산점도 (Scatter Plot)
두 변수 간의 관계를 점으로 표시한 그래프야. 원인 변수(X)와 결과 변수(Y)의 상관관계를 시각적으로 확인할 수 있어.
상관관계 패턴:
• 양의 상관: X가 증가하면 Y도 증가
• 음의 상관: X가 증가하면 Y는 감소
• 무상관: X와 Y 사이에 패턴 없음
• 비선형 상관: 곡선 형태의 관계
⚠️ 주의: 상관관계가 있다고 인과관계가 있는 건 아니야! 통계의 함정 중 하나야.
⑥ 관리도 (Control Chart)
앞에서 자세히 설명했으니 간단히 정리만 할게. 시간에 따른 프로세스 변동을 모니터링하는 도구야. 특수 원인 변동을 감지해서 즉각 대응할 수 있게 해줘.
⑦ 층별 (Stratification)
데이터를 의미 있는 그룹으로 분류해서 분석하는 기법이야. 같은 데이터도 어떻게 층별하느냐에 따라 숨겨진 패턴이 드러나.
층별 기준 예시:
• 시간별 (오전/오후, 요일별, 월별)
• 작업자별
• 기계별
• 원자재 공급업체별
• 생산 라인별
예를 들어 전체 불량률은 3%인데, 층별 분석해보니 A 기계는 1%, B 기계는 8%라면? B 기계에 집중해야 한다는 게 명확해지지!
🧪 7. 실험계획법(DOE) — 최적 조건을 과학적으로 찾자
실험계획법(Design of Experiments, DOE)은 6시그마 I단계에서 핵심적으로 쓰이는 도구야. 여러 요인(Factor)이 결과에 미치는 영향을 효율적으로 파악하고 최적 조건을 찾는 방법이지. 🔬
예를 들어 빵을 만드는데 맛에 영향을 주는 요인이 밀가루 종류(2가지), 발효 시간(3가지), 오븐 온도(3가지)라고 해봐. 모든 조합을 다 실험하면 2×3×3 = 18번 실험해야 해. 요인이 많아지면 실험 횟수가 폭발적으로 늘어나지.
DOE는 이 실험 횟수를 최소화하면서도 최대한 많은 정보를 얻는 방법이야!
📐 완전요인설계 vs 부분요인설계
| 설계 유형 | 특징 | 장점 | 단점 |
|---|---|---|---|
| 완전요인설계 (Full Factorial) | 모든 요인의 모든 수준 조합 실험 | 완전한 정보 획득 | 실험 횟수 많음 |
| 부분요인설계 (Fractional Factorial) | 일부 조합만 선택적으로 실험 | 실험 횟수 대폭 감소 | 일부 교호작용 정보 손실 |
| 다구치 설계 (Taguchi Design) | 직교배열표 활용 | 잡음 인자 고려, 강건 설계 | 교호작용 분석 제한 |
| 반응표면설계 (RSM) | 연속형 요인의 최적점 탐색 | 최적 조건 정밀 탐색 | 실험 횟수 많음 |
🎯 DOE의 핵심 개념
주효과(Main Effect)
한 요인이 결과에 미치는 독립적인 영향이야. 예를 들어 온도를 높이면 반응 속도가 빨라진다면, 온도의 주효과가 있는 거야.
교호작용(Interaction Effect)
두 요인이 함께 작용할 때 나타나는 효과야. 예를 들어 온도가 높을 때는 촉매 A가 효과적이고, 온도가 낮을 때는 촉매 B가 효과적이라면 온도와 촉매 간에 교호작용이 있는 거야.
교호작용이 중요한 이유: 교호작용을 무시하고 각 요인을 독립적으로 최적화하면 실제 최적 조건을 놓칠 수 있어!
DOE를 처음 접하면 어렵게 느껴질 수 있어. 하지만 핵심은 간단해: "한 번에 하나씩 바꾸는 것보다 여러 요인을 동시에 체계적으로 바꾸는 게 훨씬 효율적이다!" 이 원리만 이해해도 DOE의 가치를 알 수 있어.
🔬 8. 가설검정 — 데이터로 주장을 증명하자
가설검정(Hypothesis Testing)은 6시그마 A단계(분석)와 I단계(개선)에서 핵심적으로 쓰여. "개선 전후 차이가 진짜 의미 있는 차이야, 아니면 그냥 우연이야?"를 통계적으로 판단하는 거지. 🤔
📋 가설검정의 기본 구조
귀무가설(H₀, Null Hypothesis)
"차이가 없다" 또는 "효과가 없다"는 기본 가정이야.
예: "개선 전후 평균 불량률에 차이가 없다"
대립가설(H₁, Alternative Hypothesis)
우리가 증명하고 싶은 주장이야.
예: "개선 후 평균 불량률이 개선 전보다 낮다"
p-값(p-value)
귀무가설이 참일 때 관측된 결과가 나올 확률이야. p-값이 유의수준(보통 0.05)보다 작으면 귀무가설을 기각하고 대립가설을 채택해.
📊 주요 가설검정 방법
| 검정 방법 | 사용 상황 | 예시 |
|---|---|---|
| 1-표본 t검정 | 표본 평균 vs 목표값 비교 | 평균 무게가 100g인가? |
| 2-표본 t검정 | 두 그룹 평균 비교 | A라인 vs B라인 불량률 차이 |
| 대응 t검정 | 동일 대상 전후 비교 | 교육 전후 오류율 변화 |
| 일원 분산분석(ANOVA) | 3개 이상 그룹 평균 비교 | 3개 공급업체 품질 비교 |
| 카이제곱 검정 | 범주형 데이터 독립성 검정 | 불량 유형과 작업자 관계 |
| F검정 | 두 그룹 분산 비교 | 개선 전후 변동성 변화 |
⚠️ 1종 오류 vs 2종 오류
가설검정에서 두 가지 실수를 할 수 있어:
1종 오류 (α 오류, False Positive)
귀무가설이 참인데 기각하는 실수야. "차이가 없는데 있다고 판단"하는 거지.
→ 유의수준 α = 0.05는 1종 오류를 5% 허용한다는 뜻이야.
2종 오류 (β 오류, False Negative)
귀무가설이 거짓인데 채택하는 실수야. "차이가 있는데 없다고 판단"하는 거지.
→ 검정력(Power) = 1 - β. 검정력이 높을수록 좋아.
1종 오류를 줄이면 2종 오류가 늘어나는 트레이드오프 관계야. 표본 크기를 늘리면 두 오류를 동시에 줄일 수 있어!
🛡️ 9. FMEA — 문제가 생기기 전에 막자
FMEA(Failure Mode and Effects Analysis, 고장 모드 및 영향 분석)는 잠재적인 실패를 사전에 예방하는 강력한 도구야. "무엇이 잘못될 수 있는가?"를 체계적으로 분석하는 거지. 🛡️
FMEA는 원래 1960년대 NASA에서 아폴로 프로젝트를 위해 개발됐어. 우주선이 고장나면 되돌릴 수 없으니까 사전에 모든 가능한 실패를 분석한 거야. 지금은 자동차, 의료기기, 항공, 반도체 등 다양한 산업에서 필수적으로 사용돼.
📊 RPN (Risk Priority Number) 계산
FMEA의 핵심은 RPN(위험 우선순위 수치)이야. 세 가지 요소를 곱해서 계산해:
RPN = 심각도(S) × 발생도(O) × 검출도(D)
• 심각도(Severity, S): 고장이 발생했을 때 영향의 심각성 (1~10점)
• 발생도(Occurrence, O): 고장이 발생할 가능성 (1~10점)
• 검출도(Detection, D): 고장을 사전에 발견하기 어려운 정도 (1~10점)
RPN이 높을수록 우선적으로 개선해야 해. 일반적으로 RPN ≥ 100이면 즉각 조치가 필요해.
| 점수 | 심각도(S) | 발생도(O) | 검출도(D) |
|---|---|---|---|
| 1~2 | 영향 없음/미미 | 거의 없음 (1/1,000,000) | 거의 확실히 검출 |
| 3~4 | 경미한 영향 | 낮음 (1/10,000) | 높은 검출 가능성 |
| 5~6 | 중간 영향 | 보통 (1/1,000) | 보통 검출 가능성 |
| 7~8 | 심각한 영향 | 높음 (1/100) | 낮은 검출 가능성 |
| 9~10 | 매우 심각/안전 위험 | 매우 높음 (1/10) | 거의 검출 불가 |
🏆 10. 6시그마 조직 구조 — 벨트 시스템
6시그마는 단순한 통계 기법이 아니라 조직 문화와 인재 개발 시스템이기도 해. 무술의 벨트 시스템처럼 역할과 역량에 따라 등급이 나뉘어져. 🥋
| 벨트 등급 | 역할 | 교육 시간 | 주요 역량 |
|---|---|---|---|
| 챔피언 | 경영진, 프로젝트 스폰서 | ~40시간 | 전략적 방향 설정, 자원 지원 |
| 마스터 블랙벨트 | 내부 전문 컨설턴트 | 160시간+ | 교육, 코칭, 고급 통계 분석 |
| 블랙벨트 | 전담 프로젝트 리더 | 160시간 | DMAIC 전 과정 주도, 통계 분석 |
| 그린벨트 | 파트타임 프로젝트 참여 | 80시간 | 기본 통계, 프로젝트 팀원 |
| 옐로우벨트 | 기초 참여자 | ~40시간 | 6시그마 기본 개념 이해 |
💼 11. 실제 프로세스 개선 사례 — 이렇게 쓰는 거야!
이론은 충분히 배웠으니, 이제 실제로 어떻게 적용하는지 사례를 통해 살펴보자! 🎬
🏭 사례 1: 제조업 — 자동차 부품 불량률 감소
문제: 엔진 부품 불량률이 3.2%로 고객 요구사항(0.5% 이하) 초과
목표: 6개월 내 불량률 0.5% 이하로 감소
CTQ: 부품 치수 정밀도 (±0.02mm 이내)
현재 시그마 수준: 3.4σ (Cpk = 1.13)
MSA 결과: 측정 시스템 오차 7.2% (허용 범위 내)
기준선: 불량률 3.2% = 32,000 PPM
파레토 분석: 전체 불량의 78%가 치수 불량
특성요인도 분석: 주요 원인 후보 — 공구 마모, 절삭 온도, 원자재 경도
회귀분석 결과: 공구 마모(R² = 0.73)와 절삭 온도(R² = 0.61)가 유의한 영향
5 Why 분석: 공구 교체 주기가 너무 길었음 (현재 500개 → 최적 300개)
DOE 실험: 공구 교체 주기(250/300/350개), 절삭 온도(60/70/80℃) 조합 실험
최적 조건: 공구 교체 주기 300개, 절삭 온도 70℃
파일럿 결과: 불량률 0.38%로 감소 (목표 달성!)
관리도 설치: X-bar & R 관리도로 치수 실시간 모니터링
SOP 업데이트: 공구 교체 주기 300개로 표준화
최종 결과: 불량률 0.35%, Cpk = 1.71 (5σ 수준 달성!)
연간 절감 효과: 약 2.8억 원
🏥 사례 2: 서비스업 — 병원 대기 시간 단축
문제: 외래 환자 평균 대기 시간 87분 (목표: 45분 이하)
D단계: CTQ = 환자 대기 시간 (접수~진료 시작까지)
M단계: 현재 시그마 수준 2.1σ, 기준선 87분
A단계 분석 결과:
• 층별 분석: 오전 10~11시에 대기 시간 집중 (평균 142분)
• 원인 분석: 예약 없이 방문하는 환자 비율 68%, 의사별 진료 시간 편차 큼
• 회귀분석: 예약 비율과 대기 시간 간 강한 음의 상관관계 (r = -0.82)
I단계 개선:
• 온라인 예약 시스템 강화 (예약 비율 68% → 85%)
• 시간대별 예약 슬롯 최적화
• 간호사 업무 재배분 (의사 진료 전 기본 검사 완료)
C단계 결과:
• 평균 대기 시간 38분 (목표 달성!)
• 시그마 수준 3.8σ로 향상
• 환자 만족도 점수 72점 → 89점
💻 사례 3: IT 서비스 — 소프트웨어 배포 오류율 감소
문제: 소프트웨어 배포 시 오류 발생률 12% (목표: 2% 이하)
분석 결과:
• 파레토 분석: 전체 오류의 82%가 3가지 원인 (환경 설정 오류, 의존성 충돌, 테스트 미흡)
• 5 Why 분석: 표준화된 배포 체크리스트 없음, 개발/운영 환경 불일치
개선 조치:
• CI/CD 파이프라인 구축 (자동화된 테스트 및 배포)
• 컨테이너화(Docker) 도입으로 환경 일관성 확보
• 배포 전 체크리스트 표준화 (Poka-Yoke 적용)
결과:
• 배포 오류율 1.3%로 감소
• 배포 소요 시간 4시간 → 45분
• 연간 장애 대응 비용 절감 약 1.5억 원
⚡ 12. 린 6시그마 (Lean Six Sigma) — 최강의 조합
6시그마와 함께 자주 언급되는 게 린(Lean)이야. 린은 도요타 생산 방식(TPS)에서 발전한 방법론으로, 낭비(Waste)를 제거해서 프로세스를 더 빠르고 효율적으로 만드는 거야.
6시그마가 "품질 변동을 줄이는 것"에 집중한다면, 린은 "낭비를 제거해서 속도를 높이는 것"에 집중해. 이 두 가지를 합친 게 린 6시그마(Lean Six Sigma)야! 🚀
🗑️ 린의 8가지 낭비 (DOWNTIME)
린에서는 8가지 낭비를 DOWNTIME이라는 약어로 기억해:
Defects (불량) — 재작업, 폐기
Overproduction (과잉 생산) — 필요 이상으로 생산
Waiting (대기) — 다음 단계를 기다리는 시간
Non-utilized Talent (미활용 인재) — 직원 역량 미활용
Transportation (운반) — 불필요한 이동
Inventory (재고) — 과잉 재고
Motion (동작) — 불필요한 움직임
Extra Processing (과잉 처리) — 필요 이상의 처리
🗺️ 가치 흐름 지도 (Value Stream Mapping)
린의 핵심 도구 중 하나야. 제품이나 서비스가 고객에게 전달되는 전체 흐름을 시각화해서 낭비를 찾아내는 거야.
핵심 개념:
• 부가가치 활동(VA): 고객이 기꺼이 돈을 낼 의향이 있는 활동
• 비부가가치 활동(NVA): 낭비, 제거 대상
• 필요 비부가가치 활동(NNVA): 현재는 필요하지만 장기적으로 줄여야 할 활동
일반적으로 제조 프로세스에서 실제 부가가치 활동은 전체 리드타임의 5~10%에 불과해. 나머지 90~95%는 대기, 이동, 검사 등 낭비야. 충격적이지? 😲
🔄 린 6시그마의 시너지
| 구분 | 린(Lean) | 6시그마 | 린 6시그마 |
|---|---|---|---|
| 초점 | 속도, 효율 | 품질, 정확성 | 속도 + 품질 |
| 주요 문제 | 낭비, 지연 | 변동, 불량 | 낭비 + 변동 |
| 핵심 도구 | VSM, 5S, 칸반 | DMAIC, SPC, DOE | 통합 적용 |
| 결과 | 리드타임 단축 | 불량률 감소 | 전체 성과 향상 |
🤖 13. 디지털 시대의 품질관리 — Industry 4.0과 빅데이터
요즘은 IoT, 빅데이터, AI가 품질관리에도 혁명을 일으키고 있어. 전통적인 SPC와 6시그마가 디지털 기술과 만나면 어떻게 될까? 🌐
📡 실시간 품질 모니터링 (Real-time Quality Monitoring)
전통적인 SPC는 주기적으로 샘플을 채취해서 분석했어. 하지만 이제는 IoT 센서가 모든 제품을 실시간으로 측정하고, 빅데이터 플랫폼이 즉각 분석해.
장점:
• 100% 검사 가능 (샘플링 오류 없음)
• 이상 발생 즉시 알림
• 방대한 데이터로 더 정밀한 분석
• 예측적 품질 관리 가능
🧠 AI/머신러닝 기반 품질 예측
전통적인 통계 기법은 선형 관계를 가정하는 경우가 많아. 하지만 실제 제조 프로세스는 복잡한 비선형 관계를 가지고 있어. 여기서 머신러닝이 빛을 발해!
활용 사례:
• 불량 예측 모델: 공정 데이터로 불량 발생 전에 예측
• 이상 감지(Anomaly Detection): 정상 패턴에서 벗어난 데이터 자동 감지
• 컴퓨터 비전 검사: 카메라 + AI로 외관 불량 자동 검사
• 예측 유지보수(Predictive Maintenance): 설비 고장 전에 미리 유지보수
📊 디지털 트윈 (Digital Twin)
실제 제조 프로세스의 디지털 복제본을 만들어서 시뮬레이션하는 기술이야.
품질관리에서의 활용:
• 실제 생산 전에 가상으로 프로세스 최적화
• DOE를 가상 환경에서 먼저 실험 (비용, 시간 절감)
• 실시간 데이터로 디지털 트윈 업데이트 → 더 정확한 예측
• 새로운 제품 설계 시 품질 문제 사전 예방
디지털 기술이 아무리 발전해도 통계적 사고와 6시그마의 기본 원리는 여전히 중요해. AI가 패턴을 찾아줘도, 그 결과를 해석하고 의사결정하는 건 사람이야. 통계 기초가 탄탄해야 디지털 도구도 제대로 활용할 수 있어!
💡 14. 실무에서 바로 써먹는 팁 10가지
이론을 배웠으니 이제 실무에서 어떻게 적용할지 핵심 팁을 정리해볼게! 재능넷 같은 플랫폼에서 통계/분석 관련 재능을 제공하거나 배우려는 분들에게도 유용한 내용이야. 📝
1데이터 수집 전에 목적을 명확히 해라
"일단 데이터 모으고 보자"는 최악의 접근법이야. 무엇을 알고 싶은지 먼저 정의하고, 그에 맞는 데이터를 수집해.
2측정 시스템을 먼저 검증해라
측정 도구가 부정확하면 아무리 좋은 분석도 의미 없어. MSA(측정 시스템 분석)로 먼저 측정 신뢰성을 확인해.
3그래프를 먼저 그려라
통계 분석 전에 항상 데이터를 시각화해봐. 히스토그램, 산점도, 시계열 그래프로 데이터의 특성을 먼저 파악해. 이상값이나 특이 패턴을 눈으로 먼저 확인하는 게 중요해.
4상관관계와 인과관계를 혼동하지 마라
아이스크림 판매량과 익사 사고 수가 상관관계가 있어도, 아이스크림이 익사를 유발하는 건 아니야 (둘 다 여름이라는 공통 원인). 인과관계를 주장하려면 실험 설계나 추가 분석이 필요해.
5표본 크기를 충분히 확보해라
표본이 너무 작으면 통계적 검정력이 낮아져서 실제 차이를 감지하지 못할 수 있어. 가설검정 전에 필요한 표본 크기를 계산해봐.
6p-값만 보지 말고 효과 크기도 봐라
p < 0.05라고 해서 항상 실용적으로 의미 있는 건 아니야. 표본이 크면 아주 작은 차이도 통계적으로 유의하게 나올 수 있어. 효과 크기(Cohen's d 등)도 함께 확인해.
7프로세스 안정화 먼저, 능력 향상 나중
프로세스가 불안정한 상태(특수 원인 변동 있음)에서 능력 향상을 시도하면 효과가 없어. 먼저 관리도로 프로세스를 안정화시키고, 그 다음에 Cpk 향상을 추진해.
8개선 후 반드시 통계적으로 검증해라
"느낌상 좋아진 것 같아"는 안 돼. 개선 전후 데이터를 수집하고 가설검정으로 통계적으로 유의한 개선인지 확인해야 해.
9관리 계획서를 반드시 작성해라
개선 후 관리 계획서 없이 방치하면 3~6개월 후 원래대로 돌아가는 경우가 많아. 무엇을, 누가, 언제, 어떻게 모니터링할지 문서화해.
10작은 것부터 시작해라
처음부터 전사적 6시그마 프로젝트를 시작하면 부담스러워. 작은 프로세스에서 DMAIC를 연습하고, 성공 경험을 쌓은 후 점차 확대해나가는 게 현명해.
🚫 15. 6시그마 프로젝트에서 자주 하는 실수들
6시그마를 배우고 적용하다 보면 흔히 하는 실수들이 있어. 미리 알고 피하자! ⚠️
"불량률을 줄이자"는 너무 막연해. "A 라인에서 생산되는 X 부품의 치수 불량률을 현재 3.2%에서 6개월 내 0.5% 이하로 감소"처럼 구체적으로 정의해야 해.
"경험상 이게 문제야"라고 단정하고 분석을 건너뛰는 경우가 많아. 6시그마의 핵심은 데이터 기반 의사결정이야. 직관은 가설로 세우고, 데이터로 검증해야 해.
불량이 나오면 불량품만 제거하고 끝내는 경우가 많아. 5 Why 분석으로 근본 원인까지 파고들어야 재발을 막을 수 있어.
많은 팀이 I단계(개선)까지는 열심히 하는데, C단계에서 힘이 빠져. 관리 계획서 없이 개선 효과가 지속되길 기대하면 안 돼.
"6시그마 프로젝트니까 DOE도 해야 해"라는 식으로 필요하지 않은 도구를 억지로 쓰는 경우가 있어. 문제에 맞는 도구를 선택하는 게 중요해.
🗺️ 16. 품질관리 통계 & 6시그마 학습 로드맵
자, 이제 어떻게 공부하면 좋을지 로드맵을 그려볼게! 재능넷에서도 통계 분석이나 6시그마 관련 재능을 찾아볼 수 있으니 참고해봐. 📚
📖 추천 학습 자료
📚 입문서:
• 《통계학: 이해와 응용》 — 기초 통계 개념 정리
• 《6시그마 경영》 — 6시그마 방법론 전반
• 《린 씽킹》 — 린 방법론 이해
🎓 온라인 강의:
• Coursera: "Six Sigma Yellow Belt" (Kennesaw State University)
• edX: "Statistical Thinking for Data Science"
• 국내 K-MOOC: 품질경영 관련 강의
🛠️ 실습 도구:
• Minitab 무료 체험판 (30일)
• R 언어 + ggplot2 (무료)
• Python + scipy, statsmodels (무료)
🎯 마무리 — 데이터로 말하는 사람이 되자
자, 여기까지 품질관리 통계와 6시그마에 대해 정말 많은 내용을 다뤘어! 😄
처음에 딱딱하게 느껴졌던 "품질관리"가 이제 조금은 친근하게 느껴지지 않아? 핵심을 다시 정리해볼게:
✅ 품질관리 통계는 데이터로 현실을 객관적으로 파악하는 도구야
✅ 변동(Variation)을 이해하고 관리하는 게 품질관리의 핵심이야
✅ SPC와 관리도로 프로세스를 실시간 모니터링할 수 있어
✅ 공정능력지수(Cpk)로 프로세스가 고객 요구를 얼마나 충족하는지 측정해
✅ DMAIC는 문제를 체계적으로 해결하는 5단계 프레임워크야
✅ QC 7 Tools는 현장 품질 문제 해결의 기본 무기야
✅ 린 6시그마는 품질과 속도를 동시에 잡는 최강의 조합이야
✅ 디지털 기술과 결합하면 더욱 강력한 품질 혁신이 가능해
품질관리 통계와 6시그마는 단순히 제조업만의 이야기가 아니야. 서비스업, IT, 의료, 교육, 심지어 개인의 일상적인 문제 해결에도 적용할 수 있는 보편적인 사고 방식이야.
"느낌상 좋아진 것 같아"가 아니라 "데이터로 보면 이렇게 개선됐어"라고 말할 수 있는 사람이 되는 것 — 그게 바로 6시그마가 추구하는 거야. 🎯
오늘 배운 내용을 바탕으로 작은 것부터 시작해봐. 일상에서 데이터를 수집하고, 패턴을 찾고, 개선해보는 연습을 하다 보면 어느새 데이터로 말하는 사람이 되어있을 거야! 💪
(신은 믿어도 되지만, 다른 모든 것은 데이터를 가져와야 한다.)
— W. Edwards Deming, 품질관리의 아버지
🏷️ 관련 태그
품질관리 6시그마 DMAIC SPC 통계적공정관리 공정능력지수 린6시그마 관리도 프로세스개선 QC7Tools 가설검정 DOE댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.






댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.