
Ver3.5 Hugging Face의 역할과 생태계 확장
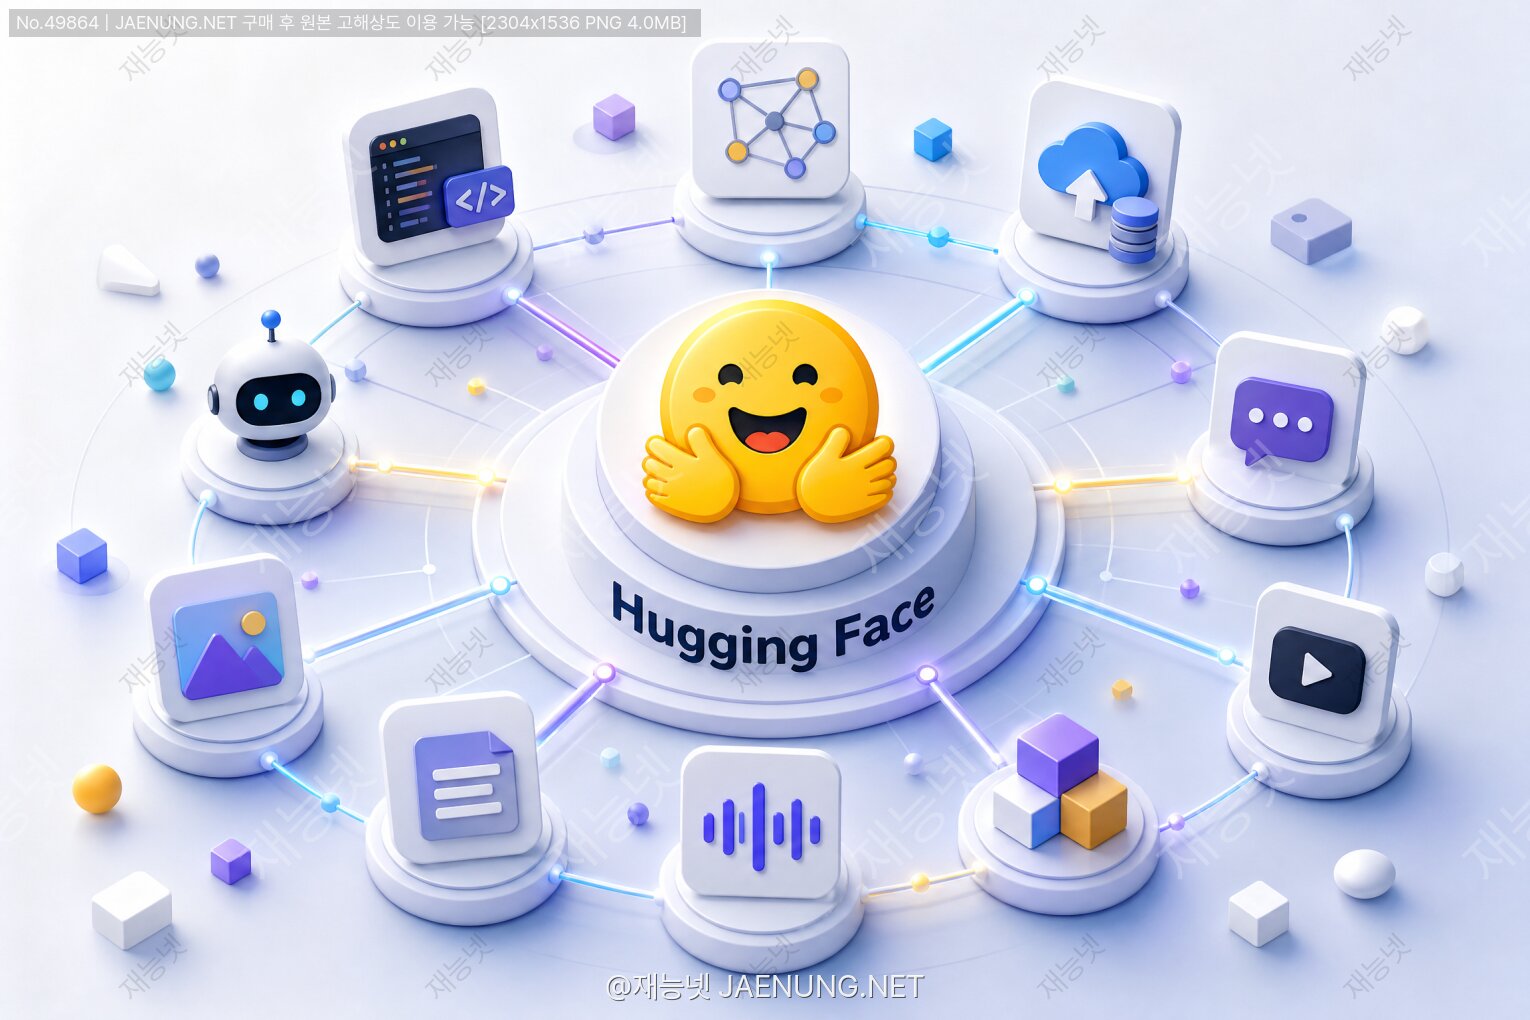
Hugging Face의 역할과 생태계 확장
AI 세계의 '깃허브'가 된 그 플랫폼, 제대로 파헤쳐보자! 🚀
혹시 AI 공부하다가 "Hugging Face"라는 이름을 한 번쯤 들어본 적 있지 않아? 😄
처음엔 이름이 너무 귀여워서 "이게 뭐야?" 싶었는데, 알고 보면 현재 AI/머신러닝 생태계에서 절대 빼놓을 수 없는 핵심 플랫폼이야.
GPT, BERT, LLaMA, Stable Diffusion… 이름만 들어도 설레는 모델들이 전부 이 플랫폼을 거쳐 세상에 퍼져나갔다고 해도 과언이 아니거든.
오늘은 Hugging Face가 도대체 뭔지, 어떻게 AI 생태계의 중심이 됐는지, 그리고 앞으로 어떻게 확장되고 있는지를 친구한테 설명하듯 재미있게 풀어볼게! 🎉
🤔 Hugging Face, 도대체 뭐야?
Hugging Face는 2016년에 뉴욕에서 설립된 AI 스타트업이야.
처음엔 챗봇 앱으로 시작했어. 이름도 귀엽고, 앱도 귀여웠지. 근데 이 회사가 진짜 대박을 친 건 2018년에 Transformers 라이브러리를 오픈소스로 공개하면서부터야! 🎯
GitHub가 코드를 공유하는 플랫폼이라면, Hugging Face는 AI 모델과 데이터셋을 공유하는 플랫폼이야.
2024년 기준으로 50만 개 이상의 모델, 10만 개 이상의 데이터셋, 15만 개 이상의 Spaces(데모 앱)가 올라와 있어. 숫자만 봐도 어마어마하지? 😲
그리고 이 플랫폼을 사용하는 사람이 무려 500만 명 이상이고, Google, Meta, Microsoft, Amazon 같은 빅테크 기업들도 여기에 모델을 올리고 있어.
기업 가치는 2023년 기준으로 약 45억 달러(약 6조 원)로 평가받았어. 진짜 어마어마하지?
🔧 Transformers 라이브러리 — 게임 체인저의 등장
Hugging Face가 AI 생태계의 중심이 된 가장 큰 이유는 바로 Transformers 라이브러리 때문이야.
2018년에 처음 공개됐고, 지금은 GitHub에서 13만 개 이상의 스타를 받은 역대급 오픈소스 프로젝트야. ⭐
이 라이브러리가 뭘 해주냐고? 간단히 말하면 복잡한 AI 모델을 단 몇 줄의 코드로 사용할 수 있게 해줘!
예를 들어, 예전에는 BERT 같은 모델을 쓰려면 논문 읽고, 코드 짜고, 학습시키고… 엄청난 시간이 필요했어.
근데 Transformers 라이브러리를 쓰면?
from transformers import pipeline

# 감성 분석 — 단 3줄!
classifier = pipeline("sentiment-analysis")
result = classifier("Hugging Face is amazing!")
print(result)
# [{'label': 'POSITIVE', 'score': 0.9998}]
이게 전부야! 😱 복잡한 모델 구조를 몰라도, GPU 세팅을 몰라도, 그냥 pipeline 하나로 끝!
이 단순함이 전 세계 개발자들을 열광하게 만든 거야.
Transformers 라이브러리가 지원하는 주요 기능들을 정리해볼게:
| 기능 | 설명 | 대표 모델 |
|---|---|---|
| 📝 텍스트 분류 | 감성 분석, 스팸 필터링 등 | BERT, RoBERTa |
| 🌐 번역 | 다국어 자동 번역 | MarianMT, mBART |
| ✍️ 텍스트 생성 | 글쓰기, 코드 생성 등 | GPT-2, LLaMA, Mistral |
| 🖼️ 이미지 분류 | 사진 속 객체 인식 | ViT, CLIP |
| 🎙️ 음성 인식 | 음성을 텍스트로 변환 | Whisper |
| 🎨 이미지 생성 | 텍스트로 이미지 만들기 | Stable Diffusion |
PyTorch, TensorFlow, JAX 등 주요 딥러닝 프레임워크를 모두 지원하고,
Python 패키지 하나로 이 모든 걸 쓸 수 있다는 게 진짜 혁명적이야. 🔥
🗂️ 모델 허브 — AI의 앱스토어
Hugging Face의 Model Hub는 말 그대로 AI 모델들의 앱스토어야. 📱
누구나 자신이 학습시킨 모델을 올릴 수 있고, 누구나 다운로드해서 쓸 수 있어.
2024년 기준으로 50만 개가 넘는 모델이 올라와 있는데, 이 숫자가 매달 엄청난 속도로 늘고 있어.
• 컴퓨터 비전: 이미지 분류, 객체 탐지, 이미지 생성
• 음성: STT(음성→텍스트), TTS(텍스트→음성)
• 멀티모달: 텍스트+이미지 동시 처리
• 강화학습, 시계열 분석 등 다양한 분야
모델 허브의 진짜 강점은 버전 관리야.
Git 기반으로 모델 파일을 관리하기 때문에, 모델의 변경 이력을 추적하고 이전 버전으로 롤백하는 것도 가능해.
또한 각 모델마다 Model Card라는 문서가 있어서, 모델이 어떤 데이터로 학습됐는지, 어떤 용도로 쓰면 좋은지, 한계점은 뭔지 등을 투명하게 공개하고 있어. 이게 AI 윤리 측면에서도 굉장히 중요한 부분이야! 🌱
모델 허브에서 모델을 불러오는 것도 엄청 간단해:
from transformers import AutoModelForCausalLM, AutoTokenizer

# 모델 이름만 알면 끝!
model_name = "meta-llama/Llama-2-7b-chat-hf"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

# 이제 로컬에서 LLaMA 2를 사용할 수 있어!
Meta의 LLaMA, Google의 Gemma, Mistral AI의 Mistral, Microsoft의 Phi 등
빅테크 기업들이 공개한 최신 모델들이 전부 Hugging Face 허브를 통해 배포돼.
이제 Hugging Face 없이 AI 개발을 논하기 어려운 시대가 된 거야. 💪
📊 데이터셋 허브 — AI의 원재료 창고
AI 모델을 학습시키려면 데이터가 필요해. 그리고 좋은 데이터를 구하는 게 사실 모델 설계보다 더 어려울 때도 많아.
Hugging Face의 Dataset Hub는 이 문제를 해결해줘! 🎯
10만 개 이상의 데이터셋이 공개되어 있고, datasets 라이브러리를 통해 단 몇 줄로 불러올 수 있어:
from datasets import load_dataset

# 유명한 감성 분석 데이터셋 IMDb 로드
dataset = load_dataset("imdb")
print(dataset["train"][0])
# {'text': '...영화 리뷰...', 'label': 1}

# 한국어 데이터셋도 있어!
ko_dataset = load_dataset("klue", "ynat")
데이터셋 허브의 특징을 정리해볼게:
🚀 Spaces — AI 앱을 5분 만에 배포하기
Spaces는 Hugging Face에서 제공하는 AI 앱 호스팅 플랫폼이야.
모델을 만들었는데 다른 사람들이 쉽게 써볼 수 있게 하고 싶다면? Spaces가 답이야! 🎉
Gradio나 Streamlit으로 만든 앱을 Spaces에 올리면, 별도의 서버 세팅 없이 바로 웹에서 접근 가능한 데모 앱이 만들어져.
무료 플랜도 있어서 개인 개발자나 연구자들이 자신의 모델을 세상에 선보이는 데 많이 활용하고 있어.
• Whisper로 음성 인식 데모
• LLM 기반 챗봇 데모
• 실시간 객체 탐지 데모
• 논문 구현 결과 공유
2024년 기준으로 15만 개 이상의 Spaces가 운영 중이야.
GPU가 필요한 앱은 유료 플랜을 통해 A100, H100 같은 고성능 GPU도 사용할 수 있어.
기업들은 Spaces를 통해 자사 AI 제품의 데모를 공개하기도 하고, 연구자들은 논문 결과를 직접 체험해볼 수 있는 인터랙티브 데모를 만들기도 해. 정말 편리하지? 😊
슬라이더, 텍스트박스, 이미지 업로드 등 다양한 UI 컴포넌트를 제공해서 AI 데모 만들기에 최적화되어 있어!
📦 Hugging Face 라이브러리 생태계
Hugging Face는 Transformers 하나만 있는 게 아니야.
다양한 목적에 맞는 라이브러리들이 하나의 생태계를 이루고 있어. 마치 레고 블록처럼 조합해서 쓸 수 있지! 🧩
| 라이브러리 | 역할 | 특징 |
|---|---|---|
| 🔧 Transformers | 모델 로드·추론·파인튜닝 | 핵심 라이브러리, 가장 많이 사용 |
| 📊 Datasets | 데이터셋 로드·처리 | 대용량 데이터 스트리밍 지원 |
| ⚡ Accelerate | 분산 학습·혼합 정밀도 | 코드 변경 최소화로 멀티 GPU 지원 |
| 🎯 PEFT | 효율적 파인튜닝 | LoRA, Prefix Tuning 등 지원 |
| 🔢 Tokenizers | 고속 토크나이저 | Rust 기반, 초고속 처리 |
| 🤖 TRL | RLHF 학습 | ChatGPT 방식 강화학습 지원 |
| 🔍 Evaluate | 모델 성능 평가 | BLEU, ROUGE 등 다양한 메트릭 |
| 🌐 Gradio | 웹 UI 생성 | AI 데모 앱 초간단 제작 |
| 🔗 Hub | 허브 API 연동 | 모델·데이터셋 업로드/다운로드 |
이 라이브러리들이 서로 유기적으로 연결되어 있어서,
데이터 수집 → 전처리 → 모델 학습 → 평가 → 배포까지 전체 ML 파이프라인을 Hugging Face 생태계 안에서 완결할 수 있어.
이게 바로 Hugging Face가 단순한 모델 저장소를 넘어 완전한 AI 개발 플랫폼으로 성장한 이유야! 🏆
🎯 PEFT와 효율적 파인튜닝 — 적은 자원으로 큰 모델 다루기
GPT-4나 LLaMA 같은 대형 언어 모델(LLM)을 내 용도에 맞게 커스터마이징하고 싶은데,
수백억 개의 파라미터를 전부 다시 학습시키려면 엄청난 GPU와 시간이 필요해. 😰
이 문제를 해결하는 게 바로 PEFT(Parameter-Efficient Fine-Tuning)야!
Hugging Face의 PEFT 라이브러리가 지원하는 주요 기법들:
모델의 가중치 행렬을 저랭크 행렬로 근사해서 학습. 가장 널리 쓰이는 방법이야.
예: 70억 파라미터 모델을 소비자용 GPU 하나로 파인튜닝 가능!
모델을 4비트로 양자화한 뒤 LoRA 적용. 메모리 사용량을 극적으로 줄여줘.
예: 65억 파라미터 모델을 48GB GPU 대신 24GB GPU로 학습 가능!
모델 앞에 학습 가능한 토큰을 추가해서 태스크에 맞게 조정하는 방법.
LoRA보다 더 적은 파라미터로 비슷한 성능을 내는 최신 기법.
from peft import LoraConfig, get_peft_model
from transformers import AutoModelForCausalLM

# 기본 모델 로드
model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf")

# LoRA 설정
lora_config = LoraConfig(
    r=16,           # 랭크 (작을수록 파라미터 적음)
    lora_alpha=32,  # 스케일링 파라미터
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.1,
)

# LoRA 적용
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
# trainable params: 4,194,304 || all params: 6,742,609,920
# trainable%: 0.0622  ← 전체의 0.06%만 학습!
이런 기술들 덕분에 이제 개인 개발자도 집에 있는 RTX 3090 하나로
수십억 파라미터짜리 LLM을 자신의 도메인에 맞게 파인튜닝할 수 있게 됐어. 🔥
AI 민주화의 핵심이 바로 여기에 있어!
🏢 기업 생태계 확장 — 빅테크도 Hugging Face를 선택한 이유
Hugging Face는 단순히 개인 개발자들만의 놀이터가 아니야.
세계 최대 기업들이 Hugging Face를 핵심 AI 인프라로 채택하고 있어. 🌍
| 기업 | Hugging Face 활용 방식 |
|---|---|
| 🔵 Meta | LLaMA 시리즈를 Hugging Face Hub를 통해 배포 |
| Gemma, T5, BERT 등 공개 모델 배포 | |
| 🟢 Microsoft | Phi 시리즈 배포, Azure와 Hugging Face 파트너십 |
| 🟠 Amazon | AWS SageMaker와 Hugging Face 공식 통합 |
| 🟡 Nvidia | NeMo 모델 배포, GPU 최적화 협력 |
| ⚫ Mistral AI | Mistral, Mixtral 등 고성능 모델 배포 |
Hugging Face는 Enterprise Hub라는 기업용 플랜도 운영하고 있어.
프라이빗 모델 저장소, 팀 협업 기능, 보안 강화, SLA 보장 등 기업 환경에 맞는 기능들을 제공해.
또한 Inference Endpoints라는 서비스를 통해 모델을 클라우드에 바로 배포하고 API로 호출할 수 있는 서비스도 제공하고 있어. 🚀
• 2023년 시리즈 D: 2억 3,500만 달러 유치 (기업가치 45억 달러)
• 투자자: Google, Nvidia, Amazon, Salesforce, IBM 등 빅테크 총출동!
이 투자 라인업만 봐도 Hugging Face가 AI 생태계에서 얼마나 중요한 위치를 차지하는지 알 수 있지? 😎
경쟁사들이 서로 투자하는 이 아이러니한 상황이 Hugging Face의 중립적 플랫폼 포지션을 잘 보여줘.
🌱 AI 윤리와 책임 — Hugging Face의 또 다른 역할
Hugging Face는 단순히 모델을 공유하는 것에 그치지 않고,
AI 윤리와 책임 있는 AI 개발에도 적극적으로 나서고 있어. 이 부분이 진짜 중요해! 🌿
모든 모델에 대해 학습 데이터, 의도된 사용 목적, 한계점, 편향 가능성 등을 문서화하도록 권장해.
이게 AI 투명성의 핵심이야.
2021~2022년에 전 세계 1,000명 이상의 연구자들이 협력해서 만든 오픈소스 LLM BLOOM을 공개했어.
46개 언어를 지원하는 1,760억 파라미터 모델이야!
유해한 모델이나 데이터셋을 모니터링하고 제거하는 정책을 운영하고 있어.
AI 안전성을 위한 커뮤니티 가이드라인도 지속적으로 업데이트 중이야.
고가의 상업용 AI API에 의존하지 않고, 누구나 오픈소스 모델로 AI를 활용할 수 있는 환경을 만들고 있어.
이건 AI 기술의 독점을 막는 중요한 역할이야.
Hugging Face도 AI 지식과 모델을 공유하는 커뮤니티 정신을 핵심 가치로 삼고 있어.
오픈소스와 공유 문화가 기술 생태계를 얼마나 풍요롭게 만드는지 잘 보여주는 사례야! 🤝
🛠️ 실전 활용 가이드 — 지금 당장 시작하는 법
자, 이제 이론은 충분히 알았으니까 실제로 어떻게 시작하면 되는지 알아보자! 💪
huggingface.co에서 무료 계정을 만들어. GitHub 계정으로도 로그인 가능해.
pip install transformers datasets accelerate peft이 한 줄로 핵심 라이브러리 설치 완료!
허브에서 원하는 태스크(text-generation, translation 등)로 필터링해서 모델을 찾아봐.
다운로드 수, 좋아요 수, 최근 업데이트 날짜를 참고해서 선택하면 돼.
pipeline()으로 모델을 바로 테스트해봐. 코드 3줄이면 충분해!
내 데이터로 모델을 커스터마이징하고 싶다면
Trainer API나 PEFT를 활용해봐.
Gradio로 UI 만들고 Spaces에 올리면 전 세계 사람들이 내 모델을 써볼 수 있어!
# 1. 설치
# pip install transformers

from transformers import pipeline

# 2. 한국어 감성 분석
classifier = pipeline(
    "text-classification",
    model="snunlp/KR-FinBert-SC"  # 한국어 금융 감성 분석 모델
)

# 3. 추론
texts = [
    "삼성전자 실적이 예상을 크게 상회했습니다.",
    "글로벌 경기 침체 우려로 주가가 하락했습니다."
]
results = classifier(texts)
for text, result in zip(texts, results):
    print(f"텍스트: {text}")
    print(f"결과: {result['label']} (신뢰도: {result['score']:.3f})")
print()🔮 미래 전망 — Hugging Face는 어디로 가고 있을까?
Hugging Face의 성장은 아직 끝나지 않았어. 오히려 지금이 시작점에 가까울 수도 있어! 🚀
앞으로 주목해야 할 방향들을 살펴볼게.
단순한 모델 추론을 넘어, AI 에이전트가 도구를 사용하고 복잡한 태스크를 수행하는 방향으로 발전 중이야.
Hugging Face의 smolagents 라이브러리가 이 분야를 리드하고 있어.
클라우드 없이 스마트폰이나 엣지 디바이스에서 직접 AI를 실행하는 방향.
양자화, 경량화 기술과 함께 Hugging Face의 모델들이 점점 더 작아지고 효율적이 되고 있어.
영어 중심의 AI에서 벗어나 다양한 언어와 문화를 지원하는 모델 개발이 활발해지고 있어.
한국어 AI 모델도 Hugging Face를 통해 계속 발전하고 있어! 🇰🇷
의료, 법률, 금융, 과학 등 전문 분야에 특화된 모델들이 Hugging Face를 통해 공개되는 추세야.
일반 목적 LLM보다 특정 분야에서 훨씬 뛰어난 성능을 보여주는 모델들이 늘어나고 있어.
Hugging Face의 모델 포맷, API 설계, Model Card 표준이 사실상 업계 표준이 되어가고 있어.
이는 AI 생태계의 상호운용성을 높이는 데 큰 역할을 하고 있어.
모델 학습부터 배포, 모니터링, 협업까지 AI 개발의 모든 단계를 아우르는 플랫폼이 목표야.
마치 GitHub가 코드 저장소에서 DevOps 전체 플랫폼으로 진화한 것처럼! 💡
🇰🇷 한국 개발자를 위한 Hugging Face 활용 팁
한국 개발자라면 특히 주목해야 할 Hugging Face 활용 포인트들이 있어! 🎯
• klue/bert-base — 한국어 BERT 모델, KLUE 벤치마크 기반
• snunlp/KR-ELECTRA-discriminator — 한국어 ELECTRA 모델
• beomi/kcbert-base — 한국어 BERT, 트위터 데이터 기반
• kakaobrain/kogpt — 카카오브레인의 한국어 GPT
• LGAI-EXAONE/EXAONE-3.5-7.8B-Instruct — LG AI 연구원의 한국어 LLM
• naver-clova-ix/donut-base — 네이버의 문서 이해 모델
재능넷 같은 플랫폼에서 AI 관련 서비스를 제공하는 프리랜서라면,
Hugging Face를 통해 최신 AI 모델을 빠르게 습득하고 클라이언트에게 제공할 수 있어.
특히 한국어 NLP 프로젝트, AI 챗봇 개발, 이미지 생성 서비스 등에서 Hugging Face 생태계 지식이 큰 경쟁력이 될 거야! 💼
• Hugging Face 문서: 각 라이브러리별 상세한 공식 문서
• Hugging Face 포럼: 커뮤니티 Q&A, 최신 트렌드 공유
• Papers with Code: 논문과 코드를 함께 제공, Hugging Face와 연동
🎉 마무리 — Hugging Face, 이제 친구가 됐지?
자, 오늘 Hugging Face에 대해 정말 많은 걸 알아봤어! 😊
처음엔 귀여운 이름의 챗봇 회사였던 Hugging Face가 어떻게 AI 생태계의 중심이 됐는지 이제 감이 오지?
핵심을 다시 정리하면:
AI 개발을 시작하고 싶다면, 혹은 더 깊이 파고들고 싶다면
Hugging Face는 반드시 알아야 할 필수 플랫폼이야. 🌟
오픈소스와 공유의 힘이 얼마나 강력한지, Hugging Face가 잘 보여주고 있어.
이 글을 읽은 너도 언젠가 Hugging Face에 멋진 모델을 올리는 날이 오길 바라! 🤗
pip install transformers 한 줄로 AI 개발의 세계로 입문할 수 있어.Hugging Face는 언제나 열려 있고, 커뮤니티는 항상 환영해! 💜

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.