
Ver3.5 코드 품질 분석 자동화 파이프라인 완전 정복 🚀AI가 내 코드를 대신 검토해준다고? 진짜로?
코드 품질 분석 자동화 파이프라인 완전 정복 🚀
AI가 내 코드를 대신 검토해준다고? 진짜로?
야, 솔직히 말해봐. 🙋
코드 리뷰할 때 "이거 변수명 왜 이렇게 지었어?", "여기 들여쓰기 틀렸잖아", "이 함수 너무 길다" 같은 말 들어본 적 있지? 아니면 반대로 네가 그런 말 해야 하는 입장이었거나.
코드 품질 관리, 진짜 중요한데 솔직히 귀찮잖아. 사람이 일일이 다 보기엔 시간도 없고, 놓치는 것도 생기고. 그래서 등장한 게 바로 코드 품질 분석 자동화 파이프라인이야.
AI와 자동화 도구들이 결합해서 코드가 커밋되는 순간부터 배포까지, 품질을 자동으로 체크해주는 시스템. 이게 요즘 개발 현장에서 얼마나 핫한지 모르겠지? 오늘 이걸 처음부터 끝까지 제대로 파헤쳐볼게. 🔥
🎯 코드 품질, 그게 뭔데 그렇게 중요해?
먼저 기본부터 짚고 가자. 코드 품질(Code Quality)이란 단순히 "동작하는 코드"를 넘어서, 읽기 쉽고, 유지보수하기 쉽고, 버그가 적고, 성능이 좋은 코드를 의미해.
코드 품질을 측정하는 주요 지표들이 있는데, 이걸 알아야 자동화 파이프라인이 뭘 체크하는지 이해할 수 있어.
📐 코드 품질의 핵심 지표들
변수명, 함수명이 의미 있는지, 주석이 적절한지, 코드 구조가 명확한지. 남이 봤을 때 "아 이게 뭐하는 코드구나" 바로 알 수 있어야 해.
순환 복잡도(Cyclomatic Complexity)라고 하는데, 코드 내 분기(if/else, switch, loop)가 얼마나 많은지 측정해. 복잡도가 높으면 버그 발생 확률도 올라가.
같은 코드가 여러 곳에 반복되면 유지보수 악몽이 시작돼. DRY(Don't Repeat Yourself) 원칙 위반 감지.
전체 코드 중 테스트가 실행되는 비율. 80% 이상이면 양호, 90% 이상이면 우수로 봐.
SQL 인젝션, XSS, 하드코딩된 비밀번호 등 보안 구멍을 자동으로 탐지.
지금 당장은 동작하지만 나중에 고쳐야 할 코드들. 쌓이면 나중에 엄청난 비용이 들어.
⚙️ 자동화 파이프라인, 도대체 어떻게 작동해?
CI/CD 파이프라인(Continuous Integration / Continuous Delivery)은 코드가 변경될 때마다 자동으로 일련의 작업들을 실행하는 시스템이야.
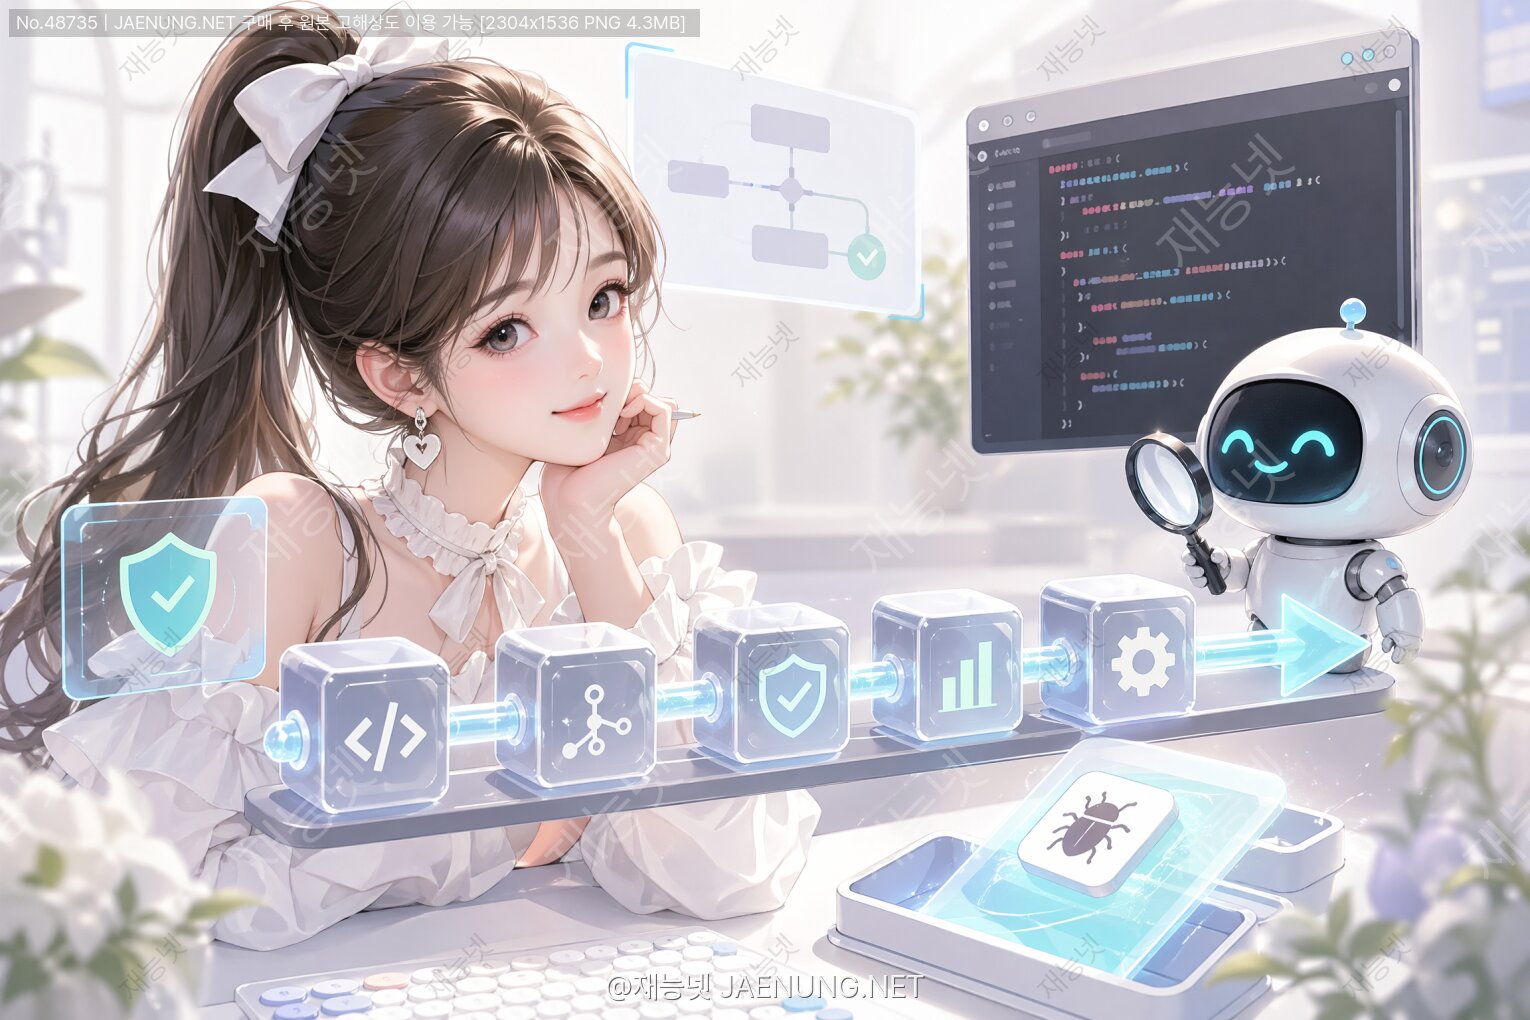
여기에 코드 품질 분석을 얹으면? 개발자가 코드를 푸시하는 순간부터 배포까지 모든 품질 체크가 자동으로 돌아가는 거지. 마치 공장 컨베이어 벨트처럼! 🏭
🔄 파이프라인의 전체 흐름
개발자가
git push 또는 Pull Request를 생성하면 파이프라인이 자동으로 시작돼. GitHub Actions, GitLab CI, Jenkins 등이 이 역할을 담당해.
필요한 의존성 설치, 환경 변수 설정, 도커 컨테이너 준비 등. 매번 깨끗한 환경에서 시작하는 게 핵심이야.
코드를 실행하지 않고 소스 코드 자체를 분석해. 문법 오류, 스타일 위반, 잠재적 버그 등을 찾아내.
LLM(대형 언어 모델)이 코드 로직, 아키텍처 패턴, 보안 취약점 등 더 깊은 수준의 분석을 수행해.
단위 테스트, 통합 테스트, E2E 테스트가 자동으로 실행되고 커버리지 리포트가 생성돼.
설정한 기준(예: 커버리지 80% 이상, 치명적 버그 0개)을 통과해야만 다음 단계로 진행 가능해. 통과 못하면 자동으로 차단!
분석 결과를 대시보드에 시각화하고, Slack/이메일로 팀에 알림을 보내. PR에 자동으로 코멘트도 달아줘.
🛠️ 실전에서 쓰는 핵심 도구들 총정리
자, 이제 실제로 어떤 도구들이 쓰이는지 알아보자. 카테고리별로 정리했으니까 필요한 거 골라서 써봐!
🔍 정적 분석 도구 (Static Analysis Tools)
| 도구 | 언어 | 주요 기능 |
|---|---|---|
| ESLint | JavaScript/TypeScript | 코드 스타일, 잠재적 오류 탐지 |
| Pylint / Flake8 | Python | PEP8 준수, 코드 품질 점수 |
| SonarQube | 다국어 지원 | 종합 품질 분석, 기술 부채 측정 |
| Checkstyle | Java | 코딩 표준 준수 검사 |
| RuboCop | Ruby | 스타일 가이드 적용 |
| golangci-lint | Go | 다양한 린터 통합 실행 |
🤖 AI 기반 코드 리뷰 도구
GitHub의 AI가 Pull Request를 분석해서 자동으로 코드 리뷰 코멘트를 달아줘. 변경된 코드의 맥락을 이해하고 개선 제안을 해주는 게 특징이야.
GPT-4 기반의 AI 코드 리뷰 도구. PR이 열리면 자동으로 전체 코드를 분석하고 상세한 피드백을 제공해. 한국어 지원도 돼서 국내 팀들이 많이 써.
Python 특화 AI 리팩토링 도구. 코드를 더 Pythonic하게 개선하는 방법을 자동으로 제안하고, 심지어 자동 수정 PR까지 만들어줘.
보안에 특화된 AI 분석 도구. 수백만 개의 오픈소스 코드를 학습해서 보안 취약점을 높은 정확도로 탐지해.
AWS의 ML 기반 코드 리뷰 서비스. Java와 Python을 지원하며, 성능 문제와 보안 취약점을 자동으로 찾아줘. AWS 환경에서 쓰기 딱 좋아.
🧪 테스트 자동화 도구
| 도구 | 유형 | 특징 |
|---|---|---|
| Jest | 단위/통합 테스트 | JavaScript 생태계 표준, 스냅샷 테스트 지원 |
| pytest | 단위/통합 테스트 | Python 표준, 플러그인 생태계 풍부 |
| Playwright | E2E 테스트 | 크로스 브라우저, 자동 대기 기능 |
| Cypress | E2E 테스트 | 실시간 리로드, 디버깅 편의성 |
| k6 | 성능 테스트 | 부하 테스트, JavaScript로 스크립트 작성 |
📊 품질 대시보드 & 모니터링
SonarCloud — SonarQube의 클라우드 버전. GitHub/GitLab과 완벽 통합되고, 무료 플랜도 있어서 오픈소스 프로젝트에 많이 써.
Codecov — 테스트 커버리지 시각화 전문. PR마다 커버리지 변화를 그래프로 보여주고, 커버리지가 떨어지면 자동으로 경고해줘.
Code Climate — 유지보수성 점수(A~F)를 매겨주는 도구. 기술 부채를 시간 단위로 환산해서 보여주는 게 독특해. "이 코드 고치는 데 3시간 걸려요" 이런 식으로!
Grafana + Prometheus — 커스텀 품질 메트릭을 수집하고 시각화하는 오픈소스 조합. 자유도가 높아서 원하는 대로 대시보드 구성 가능해.
💻 실제로 어떻게 구현해? 코드로 보자!
말로만 하면 재미없지. 실제 GitHub Actions 기반의 코드 품질 자동화 파이프라인을 구현하는 예시를 보여줄게. Python 프로젝트 기준이야.
📁 기본 GitHub Actions 워크플로우
# .github/workflows/code-quality.yml
name: 코드 품질 자동 분석

on:
  push:
    branches: [ main, develop ]
  pull_request:
    branches: [ main ]

jobs:
  quality-check:
    runs-on: ubuntu-latest

    steps:
      - name: 코드 체크아웃
        uses: actions/checkout@v4
        with:
          fetch-depth: 0  # SonarQube를 위해 전체 히스토리 필요

      - name: Python 환경 설정
        uses: actions/setup-python@v4
        with:
          python-version: '3.11'
          cache: 'pip'

      - name: 의존성 설치
        run: |
          pip install -r requirements.txt
          pip install flake8 pylint pytest pytest-cov bandit

      - name: Flake8 린팅
        run: |
          flake8 . --count --select=E9,F63,F7,F82 --show-source
          flake8 . --count --exit-zero --max-complexity=10 \
            --max-line-length=127 --statistics

      - name: Pylint 코드 품질 검사
        run: |
          pylint src/ --fail-under=8.0

      - name: Bandit 보안 취약점 스캔
        run: |
          bandit -r src/ -f json -o bandit-report.json

      - name: 테스트 실행 및 커버리지 측정
        run: |
          pytest tests/ --cov=src --cov-report=xml \
            --cov-report=html --cov-fail-under=80

      - name: Codecov 업로드
        uses: codecov/codecov-action@v3
        with:
          file: ./coverage.xml
          fail_ci_if_error: true

      - name: SonarCloud 분석
        uses: SonarSource/sonarcloud-github-action@master
        env:
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
SONAR_TOKEN: ${{ secrets.SONAR_TOKEN }}fetch-depth: 0 설정이 중요해. SonarQube는 코드 변경 히스토리를 분석해서 새로 추가된 코드와 기존 코드를 구분하거든. 이게 없으면 제대로 분석이 안 돼.
🤖 AI 코드 리뷰 자동화 (OpenAI API 활용)
이제 진짜 재미있는 부분이야. OpenAI API를 직접 활용해서 PR에 AI 코드 리뷰를 자동으로 달아주는 커스텀 액션을 만들어볼게.
# .github/workflows/ai-review.yml
name: AI 코드 리뷰

on:
  pull_request:
    types: [opened, synchronize]

jobs:
  ai-code-review:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write

    steps:
      - uses: actions/checkout@v4

      - name: PR 변경사항 가져오기
        id: get-diff
        run: |
          git fetch origin ${{ github.base_ref }}
          git diff origin/${{ github.base_ref }}...HEAD > diff.txt
          echo "diff_size=$(wc -c < diff.txt)" >> $GITHUB_OUTPUT

      - name: AI 코드 리뷰 실행
        if: steps.get-diff.outputs.diff_size > 0
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
          PR_NUMBER: ${{ github.event.pull_request.number }}
          REPO: ${{ github.repository }}
        run: |
          python scripts/ai_review.py
# scripts/ai_review.py
import os
import json
import requests
from openai import OpenAI
client = OpenAI(api_key=os.environ['OPENAI_API_KEY'])
def get_pr_diff():
with open('diff.txt', 'r', encoding='utf-8') as f:
return f.read()
def analyze_code_with_ai(diff_content):
"""GPT-4로 코드 변경사항 분석"""
prompt = f"""
당신은 시니어 소프트웨어 엔지니어입니다.
다음 코드 변경사항(Git diff)을 분석하고 리뷰해주세요.
분석 항목:
1. 잠재적 버그나 오류
2. 성능 문제
3. 보안 취약점
4. 코드 가독성 및 유지보수성
5. 개선 제안
응답은 한국어로, 구체적이고 실용적으로 작성해주세요.
코드 변경사항:
{diff_content[:8000]} # 토큰 제한 고려
"""
response = client.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "system", "content": "코드 리뷰 전문가"},
{"role": "user", "content": prompt}
],
max_tokens=2000,
temperature=0.3 # 일관성 있는 분석을 위해 낮게 설정
)
return response.choices[0].message.content
def post_pr_comment(review_content):
"""GitHub PR에 리뷰 코멘트 게시"""
headers = {
'Authorization': f"token {os.environ['GITHUB_TOKEN']}",
'Accept': 'application/vnd.github.v3+json'
}
comment_body = f"""## 🤖 AI 코드 리뷰 결과
{review_content}
---
*이 리뷰는 GPT-4o에 의해 자동 생성되었습니다.*
*AI 리뷰는 참고용이며, 최종 판단은 사람이 해야 합니다.*"""
url = f"https://api.github.com/repos/{os.environ['REPO']}/issues/{os.environ['PR_NUMBER']}/comments"
response = requests.post(url, headers=headers,
json={'body': comment_body})
response.raise_for_status()
print("✅ AI 리뷰 코멘트 게시 완료!")
if __name__ == "__main__":
diff = get_pr_diff()
if len(diff.strip()) > 0:
review = analyze_code_with_ai(diff)
post_pr_comment(review)
else:
print("변경사항 없음, 리뷰 스킵")🏆 SonarQube 제대로 활용하기
코드 품질 분석 도구 중에서 가장 널리 쓰이는 게 SonarQube야. 오픈소스 버전도 있고, 클라우드 버전(SonarCloud)도 있어서 팀 규모에 맞게 선택할 수 있어.
SonarQube가 분석하는 것들을 좀 더 자세히 알아보자.
📊 SonarQube의 7가지 품질 카테고리
1. 버그(Bugs) 🐛
코드에서 명확하게 잘못된 부분. 런타임 오류를 일으킬 가능성이 높은 코드야. 예를 들어 null 체크 없이 객체 메서드를 호출하는 경우.
2. 취약점(Vulnerabilities) 🔓
보안 공격에 노출될 수 있는 코드. SQL 인젝션, XSS, CSRF 등 OWASP Top 10 기준으로 분석해.
3. 보안 핫스팟(Security Hotspots) 🔥
취약점은 아니지만 보안 검토가 필요한 코드. 개발자가 직접 확인하고 "안전함" 또는 "취약점"으로 분류해야 해.
4. 코드 스멜(Code Smells) 👃
당장 버그는 아니지만 유지보수를 어렵게 만드는 코드 패턴. 너무 긴 함수, 중복 코드, 복잡한 조건문 등이 여기 해당해.
5. 커버리지(Coverage) 📈
테스트가 실행하는 코드의 비율. 라인 커버리지, 브랜치 커버리지, 조건 커버리지 등 다양한 방식으로 측정해.
6. 중복(Duplications) 📋
동일하거나 유사한 코드 블록이 얼마나 반복되는지. 3% 이하가 권장 수준이야.
7. 크기(Size) 📏
코드 라인 수, 파일 수, 함수 수, 클래스 수 등 프로젝트 규모 지표.
⚙️ sonar-project.properties 설정 예시
# sonar-project.properties
sonar.projectKey=my-awesome-project
sonar.projectName=My Awesome Project
sonar.projectVersion=1.0

# 소스 경로
sonar.sources=src
sonar.tests=tests

# 언어 설정
sonar.language=python

# 커버리지 리포트 경로
sonar.python.coverage.reportPaths=coverage.xml

# 제외 경로 (테스트, 마이그레이션 등)
sonar.exclusions=**/migrations/**,**/__pycache__/**,**/node_modules/**

# 품질 게이트 설정
# (SonarQube UI에서 설정하는 게 더 편해)

# 인코딩
sonar.sourceEncoding=UTF-8🦾 나만의 AI 코드 품질 에이전트 만들기
기존 도구들을 조합하는 것도 좋지만, 팀의 특수한 요구사항에 맞는 커스텀 AI 에이전트를 만들 수도 있어. LangChain이나 직접 API를 활용해서 더 정교한 분석 시스템을 구축하는 방법을 알아보자.
🔗 LangChain 기반 코드 분석 에이전트
# code_quality_agent.py
from langchain.agents import create_openai_functions_agent, AgentExecutor
from langchain.tools import tool
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate, MessagesPlaceholder
import ast
import subprocess

# 도구 정의
@tool
def analyze_python_syntax(code: str) -> str:
    """Python 코드의 문법 오류를 분석합니다."""
    try:
        ast.parse(code)
        return "문법 오류 없음 ✅"
    except SyntaxError as e:
        return f"문법 오류 발견: {e.msg} (라인 {e.lineno})"

@tool
def check_code_complexity(file_path: str) -> str:
    """코드 복잡도를 측정합니다 (radon 사용)."""
    result = subprocess.run(
        ['radon', 'cc', file_path, '-s', '-j'],
        capture_output=True, text=True
    )
    return result.stdout if result.returncode == 0 else result.stderr

@tool
def run_security_scan(file_path: str) -> str:
    """보안 취약점을 스캔합니다 (bandit 사용)."""
    result = subprocess.run(
        ['bandit', '-r', file_path, '-f', 'txt'],
        capture_output=True, text=True
    )
    return result.stdout

@tool
def check_test_coverage(test_path: str) -> str:
    """테스트 커버리지를 측정합니다."""
    result = subprocess.run(
        ['pytest', test_path, '--cov=src', '--cov-report=term-missing'],
        capture_output=True, text=True
    )
    return result.stdout[-2000:]  # 마지막 2000자만 반환

# 에이전트 설정
llm = ChatOpenAI(model="gpt-4o", temperature=0)

tools = [
    analyze_python_syntax,
    check_code_complexity,
    run_security_scan,
    check_test_coverage
]

prompt = ChatPromptTemplate.from_messages([
    ("system", """당신은 전문 코드 품질 분석 AI 에이전트입니다.
    주어진 코드나 프로젝트를 분석하고, 사용 가능한 도구들을 활용하여
    종합적인 품질 리포트를 생성하세요.

    분석 순서:
    1. 문법 오류 확인
    2. 복잡도 측정
    3. 보안 취약점 스캔
    4. 테스트 커버리지 확인
    5. 종합 평가 및 개선 제안

    모든 분석 결과를 한국어로 명확하게 설명하세요."""),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad")
])

agent = create_openai_functions_agent(llm, tools, prompt)
agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

# 실행
if __name__ == "__main__":
    result = agent_executor.invoke({
        "input": "src/ 디렉토리의 코드 품질을 전체적으로 분석해주세요."
    })
print(result['output'])📱 Slack 알림 연동
분석 결과를 팀 Slack 채널에 자동으로 보내주는 기능도 추가해보자.
# slack_notifier.py
import requests
import json

def send_quality_report_to_slack(
    webhook_url: str,
    pr_title: str,
    author: str,
    quality_score: float,
    issues: dict
):
    """코드 품질 리포트를 Slack으로 전송"""

    # 점수에 따른 이모지 선택
    if quality_score >= 90:
        emoji = "🟢"
        status = "우수"
    elif quality_score >= 70:
        emoji = "🟡"
        status = "보통"
    else:
        emoji = "🔴"
        status = "개선 필요"

    message = {
        "blocks": [
            {
                "type": "header",
                "text": {
                    "type": "plain_text",
                    "text": f"{emoji} 코드 품질 분석 결과"
                }
            },
            {
                "type": "section",
                "fields": [
                    {"type": "mrkdwn", "text": f"*PR:*\n{pr_title}"},
                    {"type": "mrkdwn", "text": f"*작성자:*\n{author}"},
                    {"type": "mrkdwn", "text": f"*품질 점수:*\n{quality_score}/100"},
                    {"type": "mrkdwn", "text": f"*상태:*\n{status}"}
                ]
            },
            {
                "type": "section",
                "text": {
                    "type": "mrkdwn",
                    "text": (
                        f"*발견된 이슈:*\n"
                        f"• 🐛 버그: {issues.get('bugs', 0)}개\n"
                        f"• 🔓 취약점: {issues.get('vulnerabilities', 0)}개\n"
                        f"• 👃 코드 스멜: {issues.get('code_smells', 0)}개\n"
                        f"• 📊 커버리지: {issues.get('coverage', 0)}%"
                    )
                }
            }
        ]
    }

    response = requests.post(
        webhook_url,
        data=json.dumps(message),
        headers={'Content-Type': 'application/json'}
    )

    return response.status_code == 200
🎮 실전 도입 전략 — 이렇게 시작해!
자, 이론은 충분히 봤으니까 실제로 팀에 도입할 때 어떻게 해야 하는지 전략적으로 알아보자. 처음부터 너무 완벽하게 하려다가 팀원들 반발 사는 경우 많거든. 😅
📈 단계적 도입 로드맵
ESLint, Pylint 등 기본 린터부터 시작해. 처음엔 경고만 표시하고 빌드를 막지 않는 모드로 시작해. 팀이 적응할 시간을 줘야 해.
GitHub Actions나 GitLab CI에 린팅을 연동해. 이 단계에서도 아직 빌드 차단은 하지 말고, 결과만 보여주는 형태로.
현재 코드베이스의 품질 수준을 측정하고 기준선(Baseline)을 설정해. "새로 추가되는 코드"에만 엄격한 기준을 적용하는 게 현실적이야.
이제 기준 미달 코드는 머지를 차단해. 처음엔 팀원들이 불편해할 수 있지만, 장기적으로 코드 품질이 눈에 띄게 좋아져.
CodeRabbit이나 커스텀 AI 리뷰를 추가해. 이 단계에서 AI는 "제안"만 하고 차단은 하지 않는 게 좋아. 팀이 AI 리뷰에 익숙해지면 점점 더 활용도를 높여가.
모든 단계가 자동화되고 팀이 익숙해지면, 기준을 점점 높여가면서 코드 품질을 지속적으로 개선해. 대시보드를 통해 트렌드를 모니터링하고 팀 회고에 활용해.
🚫 흔히 하는 실수들
❌ 실수 1: 처음부터 모든 규칙 활성화
수백 개의 린팅 규칙을 한 번에 켜면 수천 개의 경고가 쏟아져. 팀이 압도당해서 아무것도 안 고치게 돼. → 핵심 규칙 10~20개부터 시작해!
❌ 실수 2: 레거시 코드에 동일한 기준 적용
오래된 코드베이스에 새 기준을 적용하면 수천 개의 이슈가 나와. 현실적으로 다 고칠 수 없어. → 새 코드에만 엄격한 기준 적용!
❌ 실수 3: 팀 동의 없이 강제 도입
갑자기 "내일부터 이 기준 안 맞으면 머지 안 됨"이라고 하면 팀 분위기 망해. → 팀과 함께 기준을 정하고 점진적으로 도입!
❌ 실수 4: 파이프라인 속도 무시
품질 체크가 30분 걸리면 개발 속도가 너무 느려져. → 병렬 실행, 캐싱 활용으로 10분 이내로 유지!
❌ 실수 5: AI 리뷰를 100% 신뢰
AI가 틀릴 수도 있어. 특히 비즈니스 로직이나 도메인 특수성은 AI가 이해 못할 수 있어. → AI는 보조 도구, 최종 판단은 사람이!
⚡ 파이프라인 속도 최적화 — 빠를수록 좋아!
파이프라인이 느리면 개발자들이 짜증내고 결국 안 쓰게 돼. 빠른 피드백이 핵심이야. 목표는 10분 이내!
🚀 속도 최적화 기법들
pip install이나 npm install을 매번 실행하면 시간이 엄청 걸려. GitHub Actions의 cache 액션을 활용하면 의존성을 캐싱해서 설치 시간을 90%까지 줄일 수 있어.
린팅, 테스트, 보안 스캔을 순서대로 실행하지 말고 동시에 실행해. GitHub Actions에서
needs 없이 여러 job을 정의하면 자동으로 병렬 실행돼.
전체 코드베이스를 매번 분석하지 말고, 변경된 파일만 분석해.
git diff로 변경 파일 목록을 가져와서 해당 파일만 린팅하는 방식이야.
테스트가 많으면 여러 러너에 나눠서 실행해. pytest의
pytest-xdist나 Jest의 --shard 옵션을 활용하면 테스트 시간을 N분의 1로 줄일 수 있어.
도커를 사용한다면 레이어 캐싱을 최대한 활용해.
COPY requirements.txt를 소스 코드 복사보다 먼저 해서 의존성 레이어가 자주 재빌드되지 않도록 해.
# 병렬 실행 예시 (GitHub Actions)
jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: 린팅 실행
        run: flake8 src/

  test:
    runs-on: ubuntu-latest
    strategy:
      matrix:
        shard: [1, 2, 3, 4]  # 4개로 분할
    steps:
      - uses: actions/checkout@v4
      - name: 테스트 실행 (분할)
        run: |
          pytest tests/ \
            --shard-id=${{ matrix.shard }} \
            --num-shards=4

  security:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: 보안 스캔
        run: bandit -r src/

  # lint, test, security가 모두 병렬로 실행됨!
  quality-gate:
    needs: [lint, test, security]  # 모두 완료 후 실행
    runs-on: ubuntu-latest
    steps:
      - name: 품질 게이트 통과 확인
        run: echo "모든 품질 체크 통과! 🎉"
📊 품질 메트릭 추적 & 대시보드 구축
파이프라인을 돌리는 것만큼 중요한 게 결과를 잘 보여주는 거야. 숫자가 눈에 보여야 팀이 동기부여가 되거든!
📈 추적해야 할 핵심 메트릭
| 메트릭 | 목표값 | 측정 도구 |
|---|---|---|
| 테스트 커버리지 | 80% 이상 | pytest-cov, Jest |
| 순환 복잡도 | 함수당 10 이하 | radon, SonarQube |
| 코드 중복률 | 3% 이하 | SonarQube, jscpd |
| 기술 부채 비율 | 5% 이하 | SonarQube |
| 치명적 취약점 | 0개 | Snyk, Bandit |
| 파이프라인 실행 시간 | 10분 이내 | CI 플랫폼 내장 |
| 빌드 성공률 | 95% 이상 | CI 플랫폼 내장 |
| 평균 수정 시간(MTTR) | 1시간 이내 | 커스텀 추적 |
🖥️ Grafana 대시보드 구성 예시
# prometheus_metrics.py
# 커스텀 메트릭을 Prometheus로 수집하는 예시

from prometheus_client import Gauge, Counter, start_http_server
import subprocess
import json
import time

# 메트릭 정의
code_coverage = Gauge('code_coverage_percent',
                       '테스트 커버리지 (%)', ['project'])
bug_count = Gauge('sonar_bugs_total',
                   'SonarQube 버그 수', ['project', 'severity'])
vulnerability_count = Gauge('sonar_vulnerabilities_total',
                             '취약점 수', ['project'])
technical_debt_hours = Gauge('technical_debt_hours',
                              '기술 부채 (시간)', ['project'])

def collect_sonar_metrics(project_key: str, sonar_url: str, token: str):
    """SonarQube API에서 메트릭 수집"""
    import requests

    metrics = [
        'coverage', 'bugs', 'vulnerabilities',
        'sqale_index', 'code_smells'
    ]

    response = requests.get(
        f"{sonar_url}/api/measures/component",
        params={
            'component': project_key,
            'metricKeys': ','.join(metrics)
        },
        auth=(token, '')
    )

    data = response.json()
    measures = {m['metric']: m['value']
                for m in data['component']['measures']}

    # Prometheus 메트릭 업데이트
    code_coverage.labels(project=project_key).set(
        float(measures.get('coverage', 0))
    )
    bug_count.labels(project=project_key, severity='all').set(
        float(measures.get('bugs', 0))
    )
    vulnerability_count.labels(project=project_key).set(
        float(measures.get('vulnerabilities', 0))
    )
    # sqale_index는 분 단위, 시간으로 변환
    technical_debt_hours.labels(project=project_key).set(
        float(measures.get('sqale_index', 0)) / 60
    )

if __name__ == "__main__":
    start_http_server(8000)  # Prometheus가 스크랩할 포트

    while True:
        collect_sonar_metrics(
            'my-project',
            'http://sonarqube:9000',
            'your-token'
        )
        time.sleep(300)  # 5분마다 수집
💼 실무에서 바로 써먹는 꿀팁 모음
이론은 충분히 봤으니까, 실무에서 진짜 도움이 되는 꿀팁들을 정리해볼게. 이런 자동화 파이프라인 구축 능력은 요즘 개발 시장에서 엄청난 경쟁력이 돼. 실제로 재능넷 같은 플랫폼에서도 "CI/CD 파이프라인 구축", "코드 품질 자동화 설정" 같은 서비스가 꽤 인기 있는 재능으로 거래되고 있어. 🎯
🔑 Pre-commit 훅으로 로컬에서 먼저 잡기
CI 파이프라인에서 오류가 나면 이미 코드를 푸시한 후야. 로컬에서 커밋하기 전에 먼저 체크하면 훨씬 빠른 피드백을 받을 수 있어.
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/pre-commit/pre-commit-hooks
    rev: v4.5.0
    hooks:
      - id: trailing-whitespace      # 줄 끝 공백 제거
      - id: end-of-file-fixer        # 파일 끝 개행 추가
      - id: check-yaml               # YAML 문법 검사
      - id: check-json               # JSON 문법 검사
      - id: check-merge-conflict     # 머지 충돌 마커 검사
      - id: detect-private-key       # 개인키 실수 커밋 방지!

  - repo: https://github.com/psf/black
    rev: 23.12.0
    hooks:
      - id: black                    # Python 코드 자동 포맷팅

  - repo: https://github.com/pycqa/flake8
    rev: 7.0.0
    hooks:
      - id: flake8                   # Python 린팅

  - repo: https://github.com/pre-commit/mirrors-eslint
    rev: v8.56.0
    hooks:
      - id: eslint                   # JavaScript 린팅
        files: \.[jt]sx?$
        types: [file]

# 설치: pip install pre-commit && pre-commit installdetect-private-key 훅은 진짜 생명의 은인이야. AWS 키나 API 토큰을 실수로 커밋하는 사고를 막아줘. 이런 사고 한 번 나면 키 전체 교체해야 하는데, 그 고통을 미리 막아주는 거지!
🔐 보안 스캔 자동화 심화
Trivy — 컨테이너 이미지, 파일시스템, Git 저장소의 취약점을 스캔해. 특히 도커 이미지에 포함된 OS 패키지 취약점까지 잡아줘.
OWASP Dependency-Check — 프로젝트 의존성(라이브러리)의 알려진 취약점을 CVE 데이터베이스와 대조해서 검사해.
Semgrep — 커스텀 보안 규칙을 정의할 수 있는 정적 분석 도구. 회사 특유의 보안 패턴을 규칙으로 만들어서 자동으로 검사할 수 있어.
GitLeaks — Git 히스토리 전체를 스캔해서 실수로 커밋된 비밀번호, API 키, 토큰 등을 찾아줘. 이미 커밋된 것도 찾아낼 수 있어!
📝 자동 문서화 연동
코드 품질에는 문서화도 포함돼. 파이프라인에 자동 문서화를 추가해보자.
# 자동 API 문서 생성 (Python FastAPI 예시)
# GitHub Actions에서 실행

- name: API 문서 자동 생성
  run: |
    python -m pdoc src/ --html --output-dir docs/api

- name: 문서 커버리지 체크
  run: |
    # interrogate로 docstring 커버리지 측정
    pip install interrogate
    interrogate src/ --fail-under=70 --verbose
🎯 팀 코딩 컨벤션 자동 적용
팀마다 코딩 스타일이 다른데, 이걸 자동으로 통일시켜주는 도구들이 있어.
Prettier (JavaScript/TypeScript) — 코드 포맷팅을 완전 자동화. 설정 파일 하나로 팀 전체가 동일한 스타일을 유지해.
Black (Python) — "The Uncompromising Code Formatter". 설정 여지가 거의 없어서 팀 내 스타일 논쟁이 사라져. 그냥 Black이 정한 대로 따르면 돼!
gofmt (Go) — Go 언어 공식 포맷터. Go 생태계에서는 이게 표준이야.
EditorConfig — 에디터 설정을 통일해주는 파일. 들여쓰기 스타일(탭 vs 스페이스), 줄 끝 문자 등을 팀 전체에 강제 적용해.
🔮 코드 품질 자동화의 미래 — 어디로 가고 있나?
마지막으로 이 분야가 앞으로 어떻게 발전할지 살펴보자. AI와 자동화 기술이 빠르게 발전하면서 코드 품질 관리의 패러다임이 바뀌고 있어.
🌟 주목할 트렌드들
단순히 문제를 찾는 것을 넘어서, AI가 직접 코드를 수정하는 PR을 자동으로 생성해. Dependabot이 의존성 업데이트 PR을 자동으로 만드는 것처럼, 코드 품질 이슈도 AI가 자동으로 수정하는 시대가 오고 있어. Devin, GitHub Copilot Workspace 같은 도구들이 이 방향으로 발전하고 있지.
과거 데이터를 학습해서 "이 코드는 나중에 버그가 될 가능성이 높다"를 미리 예측하는 AI가 등장하고 있어. 단순한 패턴 매칭을 넘어서 코드의 맥락과 변경 히스토리를 종합적으로 분석하는 거야.
GitHub Copilot, Cursor, Codeium 같은 AI 코딩 어시스턴트가 코드를 작성하는 순간 실시간으로 품질을 체크해줘. 파이프라인에서 잡는 게 아니라 코드를 타이핑하는 순간에 피드백을 받는 거야.
현재 AI는 코드 패턴은 잘 분석하지만 비즈니스 로직은 잘 이해 못해. 앞으로는 도메인 지식을 학습한 AI가 "이 할인 로직은 비즈니스 규칙과 맞지 않아요"라고 알려주는 수준까지 발전할 거야.
여러 AI 에이전트가 각자 다른 관점(보안 전문가, 성능 전문가, 아키텍처 전문가 등)에서 코드를 리뷰하고 의견을 종합하는 시스템. 마치 여러 시니어 개발자가 동시에 리뷰하는 것처럼!
🎊 마무리 — 지금 당장 시작해!
자, 오늘 코드 품질 분석 자동화 파이프라인에 대해 진짜 많은 걸 다뤘어. 처음엔 복잡해 보일 수 있지만, 사실 하나씩 차근차근 도입하면 그렇게 어렵지 않아.
핵심을 다시 정리해볼게:
✅ 코드 품질 자동화는 선택이 아닌 필수 — 팀 규모가 커질수록, 코드베이스가 복잡해질수록 수동 리뷰만으로는 한계가 있어.
✅ 점진적 도입이 성공의 열쇠 — 처음부터 완벽한 시스템을 만들려 하지 말고, 작은 것부터 시작해서 점점 발전시켜나가.
✅ AI는 강력한 보조 도구 — CodeRabbit, GitHub Copilot, 커스텀 LLM 에이전트 등을 활용하면 코드 리뷰 품질이 획기적으로 올라가.
✅ 빠른 피드백이 핵심 — 파이프라인은 10분 이내로 유지해야 개발자들이 실제로 사용해.
✅ 메트릭으로 트렌드를 추적 — 숫자가 보여야 팀이 동기부여가 되고 지속적인 개선이 가능해.
이런 자동화 파이프라인 구축 능력은 요즘 개발 시장에서 정말 귀한 스킬이야. 재능넷에서도 DevOps, CI/CD 파이프라인 구축 관련 재능이 꾸준히 수요가 있는 이유가 바로 이거야. 배워두면 개인 프로젝트에도 쓸 수 있고, 팀에 기여할 수도 있고, 프리랜서 서비스로도 제공할 수 있어.
오늘 배운 것 중에서 딱 하나만 골라서 지금 당장 시작해봐. pre-commit 설정이든, GitHub Actions 린팅이든, SonarCloud 연동이든. 완벽한 시작보다 불완전한 시작이 훨씬 낫거든! 💪

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.