
Ver3.5 AutoGPT를 이용한 자동 콘텐츠 제작 라인 구축 완전 가이드
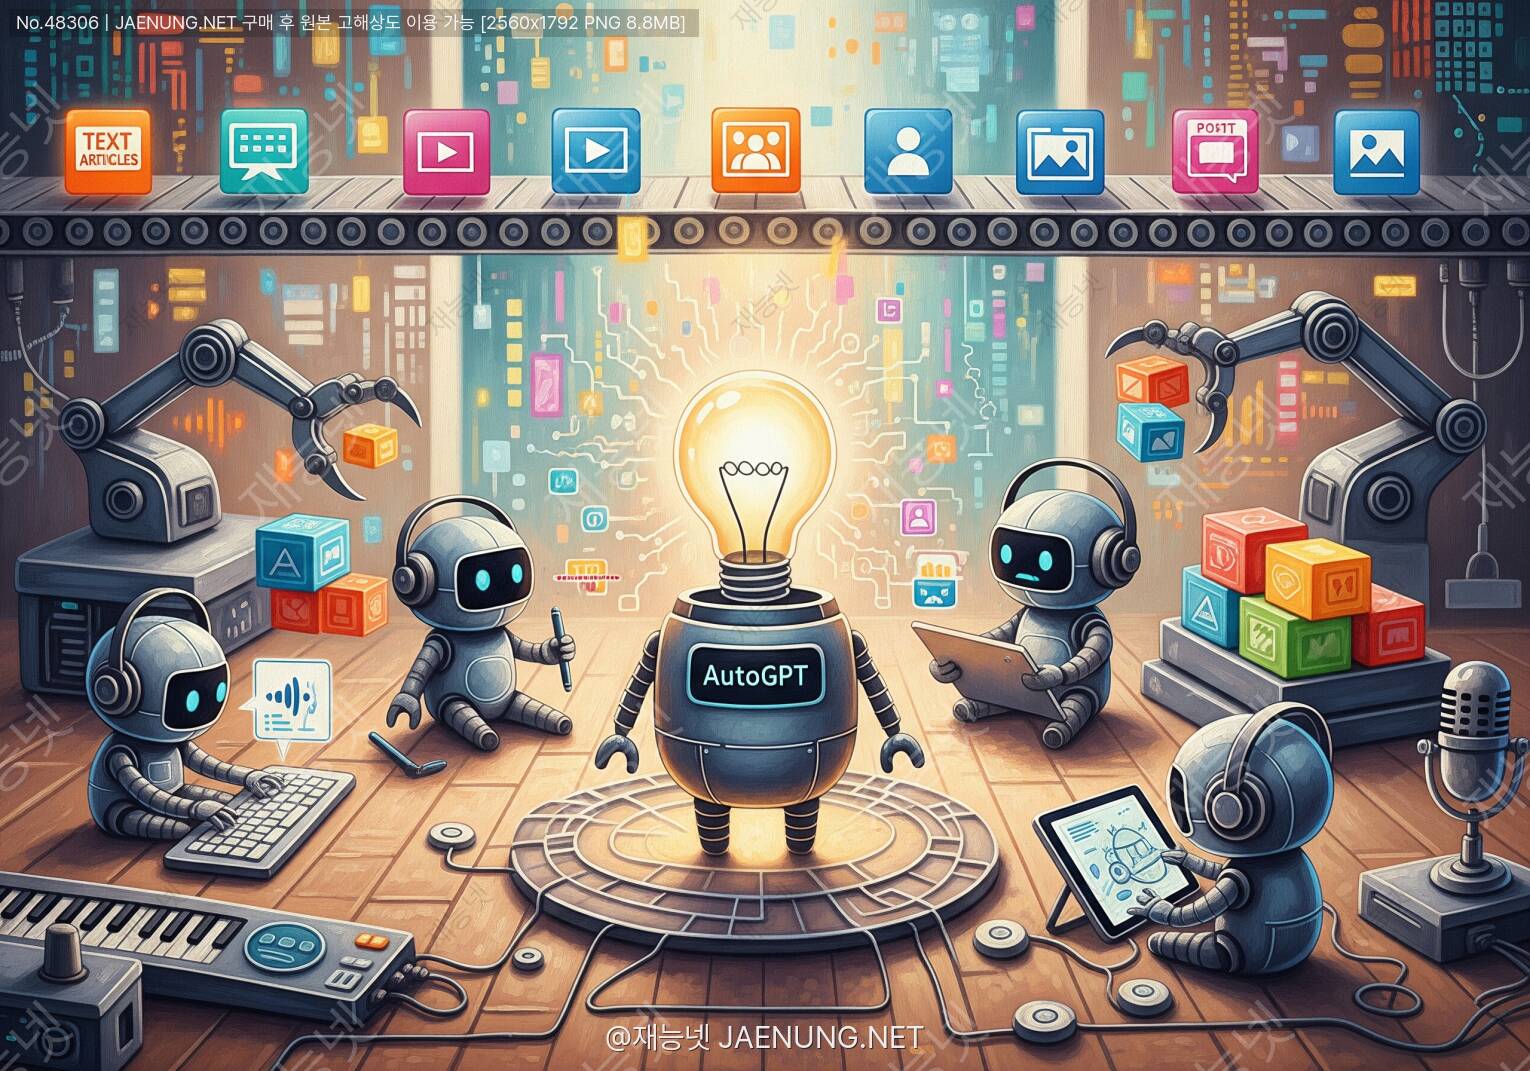
AutoGPT를 이용한 자동 콘텐츠 제작 라인 구축 완전 가이드
💬 "ㅇㅇ 진짜임 ㅋㅋ 근데 그냥 켜놓는다고 되는 건 아니고 파이프라인 설계가 핵심이야"
💬 "오 그럼 어떻게 하는 건데?? 알려줘 제발"
💬 "ㅋㅋㅋ 지금부터 다 알려줄게 집중해"
콘텐츠 마케팅 시대에 살고 있는 우리, 매일 블로그 포스팅, SNS 피드, 뉴스레터, 유튜브 스크립트까지... 솔직히 사람 손으로 다 만들다 보면 번아웃 오는 거 시간문제잖아요 😮💨
그래서 요즘 개발자들이랑 마케터들 사이에서 AutoGPT 기반 자동 콘텐츠 파이프라인이 엄청 핫한 주제로 떠오르고 있어요.
이 글에서는 AutoGPT의 작동 원리부터 실제 콘텐츠 제작 라인 구축까지, 팩트 기반으로 쫙 정리해드릴게요!
AutoGPT는 2023년 3월 Toran Bruce Richards가 오픈소스로 공개한 자율 AI 에이전트(Autonomous AI Agent)예요.
단순히 "질문하면 답해주는" ChatGPT랑은 차원이 다른 녀석인데, 핵심 차이점은 바로 목표를 주면 스스로 계획 세우고 실행까지 한다는 거예요.
쉽게 말하면 이런 느낌이에요:
🤖 AutoGPT: "알겠습니다. 먼저 최신 AI 뉴스를 검색하고, 키워드 분석하고, 아웃라인 잡고, 본문 작성하고, SEO 최적화까지 진행할게요!"
🤖 AutoGPT: (혼자서 웹 검색 → 정보 수집 → 글 작성 → 파일 저장 → 완료 보고)
이게 가능한 이유는 AutoGPT가 ReAct(Reasoning + Acting) 패턴을 사용하기 때문이에요.
생각(Thought) → 행동(Action) → 관찰(Observation) 사이클을 반복하면서 목표를 향해 스스로 나아가는 구조죠.
AutoGPT로 콘텐츠 자동화 파이프라인을 구축할 때, 전체 흐름을 먼저 이해하는 게 진짜 중요해요.
무작정 "AutoGPT야 블로그 써줘" 하면 퀄리티가 들쭉날쭉하거든요 ㅋㅋㅋ
제대로 된 파이프라인은 이런 단계로 구성돼요:
자 이제 진짜 실전으로 들어가볼게요. AutoGPT를 콘텐츠 자동화에 쓰려면 먼저 환경 세팅이 필요해요.
2024년 기준 AutoGPT는 AutoGPT Platform (구 Forge) 형태로 발전했고, 로컬 설치 방식과 클라우드 방식 둘 다 지원해요.
| 항목 | 내용 | 비고 |
|---|---|---|
| Python | 3.10 이상 | 필수 |
| OpenAI API Key | GPT-4 이상 권장 | 유료 (토큰 과금) |
| Git | 최신 버전 | 소스 클론용 |
| Docker (선택) | 컨테이너 실행 | 권장 |
| 검색 API | SerpAPI 또는 Tavily | 웹 검색 기능용 |
터미널에서 아래 순서대로 진행하면 돼요:
# 1. AutoGPT 레포 클론
git clone https://github.com/Significant-Gravitas/AutoGPT.git
cd AutoGPT

# 2. 의존성 설치
pip install -r requirements.txt

# 3. 환경변수 설정 (.env 파일)
cp .env.template .env
# .env 파일 열어서 API 키 입력

# 4. 실행
python -m autogptOPENAI_API_KEY=sk-xxxxxxxxxxxxxxxx
OPENAI_API_MODEL=gpt-4-turbo-preview
# 검색 기능 (Tavily 추천)
TAVILY_API_KEY=tvly-xxxxxxxxxxxxxxxx
# 메모리 백엔드 (로컬 JSON 또는 Redis)
MEMORY_BACKEND=json_file
# 작업 결과 저장 경로
WORKSPACE_DIRECTORY=./workspace
AutoGPT를 그냥 켜놓는다고 좋은 콘텐츠가 나오는 게 아니에요 ㅋㅋㅋ
핵심은 에이전트에게 명확한 역할과 목표를 부여하는 것이에요.
콘텐츠 자동화에서는 보통 멀티 에이전트 구조를 사용해요. 각자 전문 역할을 맡기는 거죠!
각 에이전트에게 역할을 부여할 때 프롬프트 설계가 핵심이에요. 실제 코드 예시를 볼게요:
# 리서처 에이전트 설정 예시 (Python)
researcher_config = {
    "name": "ContentResearcher",
    "role": "당신은 전문 콘텐츠 리서처입니다.",
    "goals": [
        "주어진 주제에 대한 최신 트렌드와 정보를 웹에서 수집하세요",
        "신뢰할 수 있는 출처 3개 이상을 찾아 핵심 내용을 요약하세요",
        "경쟁 콘텐츠 분석을 통해 차별화 포인트를 파악하세요",
        "수집한 정보를 구조화된 JSON 형식으로 저장하세요"
    ],
    "tools": ["web_search", "read_webpage", "write_file"]
}

# 라이터 에이전트 설정 예시
writer_config = {
    "name": "ContentWriter",
    "role": "당신은 SEO에 능숙한 전문 콘텐츠 라이터입니다.",
    "goals": [
        "리서처가 제공한 자료를 바탕으로 2000자 이상의 블로그 포스팅을 작성하세요",
        "H2, H3 태그를 활용한 명확한 구조를 유지하세요",
        "독자 친화적인 톤으로 작성하되 전문성을 잃지 마세요",
        "완성된 글을 마크다운 형식으로 저장하세요"
    ],
    "tools": ["read_file", "write_file"]
}
AutoGPT 혼자서는 한계가 있어요. 진짜 강력한 콘텐츠 자동화 라인을 만들려면 외부 도구들과 연동이 필수예요!
아래는 콘텐츠 제작에 자주 쓰이는 핵심 연동 도구들이에요 👇
| 도구 | 용도 | 특징 |
|---|---|---|
| Tavily API | AI 최적화 검색 | LLM 친화적 결과 반환, 무료 티어 있음 |
| SerpAPI | 구글 검색 결과 수집 | 정확도 높음, 유료 |
| Bing Search API | 마이크로소프트 검색 | Azure 연동 가능 |
| NewsAPI | 최신 뉴스 수집 | 실시간 뉴스 트렌드 파악 |
| 플랫폼 | API 방식 | 자동화 가능 작업 |
|---|---|---|
| WordPress | REST API | 포스팅 생성, 카테고리 설정, 예약 발행 |
| Notion | Notion API | 데이터베이스 저장, 페이지 생성 |
| Medium | Medium API | 아티클 발행, 태그 설정 |
| Ghost CMS | Admin API | 포스팅 생성 및 관리 |
| Twitter/X | Twitter API v2 | 트윗 자동 발행, 스레드 생성 |
import requests
import json

def publish_to_wordpress(title, content, tags, category_id):
    """AutoGPT 에이전트가 호출하는 WordPress 발행 함수"""

    wp_url = "https://yourblog.com/wp-json/wp/v2/posts"
    wp_user = "your_username"
    wp_app_password = "xxxx xxxx xxxx xxxx"  # 앱 비밀번호

    post_data = {
        "title": title,
        "content": content,
        "status": "draft",  # 초안으로 저장 (검토 후 발행)
        "categories": [category_id],
        "tags": tags,
        "meta": {
            "_yoast_wpseo_focuskw": tags[0] if tags else ""
        }
    }

    response = requests.post(
        wp_url,
        json=post_data,
        auth=(wp_user, wp_app_password),
        headers={"Content-Type": "application/json"}
    )

    if response.status_code == 201:
        post_id = response.json()["id"]
        print(f"✅ 포스팅 생성 완료! Post ID: {post_id}")
        return post_id
    else:
        print(f"❌ 발행 실패: {response.status_code}")
        return None
이제 진짜 핵심이에요! 실제로 동작하는 콘텐츠 자동화 파이프라인을 어떻게 구축하는지 단계별로 알아볼게요.
여기서는 블로그 포스팅 자동화를 예시로 설명할게요 ㅋㅋ
가장 먼저 할 일은 어떤 주제로 글을 쓸지 자동으로 찾아내는 거예요.
트렌드 기반 주제 탐색은 이렇게 구성해요:
# 주제 탐색 에이전트 프롬프트 예시
topic_discovery_prompt = """
당신은 콘텐츠 전략가입니다. 다음 작업을 수행하세요:

1. Tavily API를 사용하여 "{niche}" 분야의 최신 트렌드를 검색하세요
2. Google Trends 데이터를 참고하여 상승 중인 키워드를 파악하세요
3. 경쟁도가 낮고 검색량이 적당한 롱테일 키워드 10개를 추출하세요
4. 각 키워드에 대해 예상 독자층과 콘텐츠 방향을 제안하세요
5. 결과를 topics.json 파일로 저장하세요

출력 형식:
{
  "topics": [
    {
      "keyword": "키워드",
      "search_volume": "예상 검색량",
      "difficulty": "낮음/중간/높음",
      "content_angle": "콘텐츠 방향",
      "target_audience": "타겟 독자"
    }
  ]
}
"""주제가 정해지면 글의 구조를 잡는 단계예요:
# 아웃라인 생성 프롬프트
outline_prompt = """
당신은 SEO 전문 콘텐츠 기획자입니다.

주제: {topic}
타겟 키워드: {keyword}
목표 글자수: {target_length}자

다음 기준으로 블로그 포스팅 아웃라인을 작성하세요:
1. 클릭을 유도하는 매력적인 제목 3개 제안
2. 독자의 검색 의도(Search Intent)를 반영한 서론
3. H2 섹션 5-7개로 구성된 본문 구조
4. 각 섹션별 핵심 포인트 3개씩
5. 행동 유도(CTA)가 포함된 결론
6. LSI 키워드 목록 (연관 키워드 10개)

결과를 outline.json으로 저장하세요.
"""아웃라인을 바탕으로 실제 글을 작성하는 단계예요. 이 부분이 가장 중요해요!
# 본문 작성 프롬프트 (핵심!)
writing_prompt = """
당신은 전문 콘텐츠 라이터입니다.

[입력 파일 읽기]
- outline.json: 글 구조 및 키워드
- research_data.json: 수집된 자료

[작성 가이드라인]
1. 서론: 독자의 공감을 이끌어내는 훅(Hook)으로 시작
2. 각 H2 섹션: 최소 300자 이상 작성
3. 데이터/통계는 반드시 출처 명시
4. 전문 용어 사용 시 쉬운 설명 병행
5. 능동적 문체 사용 (수동태 최소화)
6. 독자에게 직접 말하는 2인칭 활용

[SEO 요소]
- 제목(H1)에 타겟 키워드 포함
- 첫 100자 내 키워드 자연스럽게 삽입
- 이미지 alt 텍스트 제안 포함
- 내부 링크 제안 3개 이상

완성된 글을 final_post.md로 저장하세요.
"""AI가 쓴 글도 검수가 필요해요! 자동 품질 체크 에이전트를 구성해요:
# 품질 검수 체크리스트
quality_check_prompt = """
당신은 엄격한 콘텐츠 에디터입니다.
final_post.md를 읽고 다음 항목을 체크하세요:

✅ 팩트 체크
- 통계/데이터의 출처가 명확한가?
- 최신 정보인가? (2년 이내)
- 잘못된 정보가 없는가?

✅ 가독성 체크
- 문단이 너무 길지 않은가? (5줄 이내 권장)
- 전환어(그러나, 따라서 등)가 적절히 사용되었는가?
- 제목과 본문의 일관성이 있는가?

✅ SEO 체크
- 타겟 키워드 밀도: 1-2% 범위인가?
- 메타 디스크립션 (150자 이내)이 작성되었는가?
- 내부/외부 링크가 포함되었는가?

✅ 독창성 체크
- AI 특유의 반복 표현이 없는가?
- 인간적인 관점과 경험이 담겨있는가?

검수 결과를 quality_report.json으로 저장하고,
수정이 필요한 부분은 구체적으로 명시하세요.
"""
요즘 실무에서는 AutoGPT 단독보다 LangChain과 함께 사용하는 경우가 많아요.
LangChain은 LLM 기반 애플리케이션 개발 프레임워크인데, AutoGPT의 에이전트 로직과 결합하면 훨씬 세밀한 제어가 가능해요!
💬 "ㅋㅋㅋ 처음엔 좀 복잡해 보이는데 익숙해지면 진짜 강력함. 각자 잘하는 게 달라서 같이 쓰면 시너지 미침"
from langchain.agents import AgentExecutor, create_openai_tools_agent
from langchain_openai import ChatOpenAI
from langchain.tools import Tool
from langchain.prompts import ChatPromptTemplate, MessagesPlaceholder

# LLM 설정
llm = ChatOpenAI(model="gpt-4-turbo-preview", temperature=0.7)

# 콘텐츠 제작 도구 정의
tools = [
    Tool(
        name="web_search",
        func=tavily_search,
        description="최신 정보와 트렌드를 검색합니다"
    ),
    Tool(
        name="save_content",
        func=save_to_file,
        description="생성된 콘텐츠를 파일로 저장합니다"
    ),
    Tool(
        name="publish_wordpress",
        func=publish_to_wordpress,
        description="WordPress에 포스팅을 발행합니다"
    ),
    Tool(
        name="seo_analysis",
        func=analyze_seo,
        description="콘텐츠의 SEO 점수를 분석합니다"
    )
]

# 콘텐츠 제작 에이전트 생성
prompt = ChatPromptTemplate.from_messages([
    ("system", "당신은 전문 콘텐츠 마케터입니다. 주어진 주제로 SEO 최적화된 블로그 포스팅을 작성하고 발행하세요."),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad")
])

agent = create_openai_tools_agent(llm, tools, prompt)
agent_executor = AgentExecutor(
    agent=agent,
    tools=tools,
    verbose=True,
    max_iterations=15,  # 최대 반복 횟수 제한
    handle_parsing_errors=True
)

# 실행!
result = agent_executor.invoke({
    "input": "AutoGPT 활용법에 대한 2000자 블로그 포스팅을 작성하고 WordPress에 초안으로 저장해줘"
})
에이전트를 만들었다면 이제 언제, 얼마나 자주 실행할지 스케줄링이 필요해요.
여기서 n8n(노코드 자동화 플랫폼)이 진짜 빛을 발해요!
n8n은 오픈소스라 자체 서버에 설치 가능하고, AutoGPT 에이전트와 연동이 매우 쉬워요.
n8n에서 AutoGPT를 호출하는 방법은 HTTP Request 노드를 사용하는 거예요:
// n8n HTTP Request 노드 설정 (AutoGPT API 호출)
{
  "method": "POST",
  "url": "http://localhost:8000/api/v1/agents/run",
  "headers": {
    "Content-Type": "application/json",
    "Authorization": "Bearer {{$env.AUTOGPT_API_KEY}}"
  },
  "body": {
    "task": "{{$json.topic}}에 대한 SEO 최적화 블로그 포스팅 작성",
    "agent_settings": {
      "model": "gpt-4-turbo-preview",
      "max_steps": 20,
      "tools": ["web_search", "write_file", "wordpress_publish"]
    }
  }
}
AutoGPT 기반 자동화의 가장 큰 걱정거리가 바로 API 비용이에요.
GPT-4 Turbo 기준으로 입력 토큰 $0.01/1K, 출력 토큰 $0.03/1K인데,
에이전트가 여러 번 반복 실행되면 비용이 생각보다 빠르게 쌓여요 ㅋㅋㅋ
모든 작업에 GPT-4를 쓸 필요 없어요. 단순 작업(분류, 요약)은 GPT-3.5-turbo나 GPT-4o-mini를 사용하고, 복잡한 창작 작업만 GPT-4를 써요. 비용을 60-70% 절감할 수 있어요!
동일한 프롬프트나 검색 결과는 Redis에 캐싱해서 재사용해요. 특히 리서치 단계에서 같은 키워드 검색이 반복되는 경우 캐싱 효과가 커요.
각 에이전트 호출마다 max_tokens를 적절히 설정해요. 아웃라인 생성은 500토큰, 본문 작성은 2000토큰 등 작업별로 다르게 설정하면 낭비를 줄일 수 있어요.
여러 콘텐츠를 개별 실행하지 말고 배치로 묶어서 처리해요. OpenAI Batch API를 활용하면 비용을 50% 절감할 수 있어요 (단, 처리 시간이 24시간 이내).
Ollama로 로컬에서 Llama 3, Mistral 등을 실행해서 초안 작성에 활용하고, 최종 다듬기만 GPT-4를 써요. 인프라 비용이 있지만 대량 생성 시 훨씬 경제적이에요.
| 모델 | 입력 (1K 토큰) | 출력 (1K 토큰) | 추천 용도 |
|---|---|---|---|
| GPT-4o | $0.005 | $0.015 | 고품질 창작, 복잡한 추론 |
| GPT-4o-mini | $0.00015 | $0.0006 | 분류, 요약, 간단한 작업 |
| GPT-3.5-turbo | $0.0005 | $0.0015 | 초안 작성, 반복 작업 |
| Claude 3 Haiku | $0.00025 | $0.00125 | 빠른 처리, 비용 효율 |
| Llama 3 (로컬) | 무료 | 무료 | 대량 처리, 초안 생성 |
솔직히 말하면 AutoGPT가 생성한 콘텐츠는 그냥 쓰면 안 돼요 ㅋㅋㅋ
AI 특유의 패턴이 있거든요. 이걸 극복하는 방법들을 알아볼게요!
| 문제 | 증상 | 해결책 |
|---|---|---|
| 반복 표현 | "중요한 것은", "주목할 점은" 남발 | 금지 표현 목록 프롬프트에 명시 |
| 일반론적 내용 | 구체적 사례 없이 추상적 설명 | 실제 사례/데이터 포함 지시 |
| 과도한 긍정 | 모든 것이 "훌륭하고 놀라운" | 균형 잡힌 시각 요구 |
| 구조 획일화 | 항상 같은 패턴의 글 구조 | 다양한 포맷 템플릿 제공 |
| 최신성 부족 | 학습 데이터 이후 정보 없음 | 웹 검색 도구 필수 연동 |
# 고품질 콘텐츠를 위한 시스템 프롬프트 예시
QUALITY_SYSTEM_PROMPT = """
당신은 10년 경력의 전문 콘텐츠 라이터입니다.

[절대 사용 금지 표현]
- "중요한 것은", "주목할 점은", "흥미롭게도"
- "~할 수 있습니다" (능동형으로 변환)
- "매우", "정말", "굉장히" (구체적 수치로 대체)

[반드시 포함할 요소]
- 실제 사례 또는 데이터 (출처 포함)
- 독자가 바로 실행할 수 있는 액션 아이템
- 반론 또는 주의사항 (균형 있는 시각)
- 개인적 관점이나 경험 (1인칭 활용)

[문체 가이드]
- 짧고 명확한 문장 (한 문장 = 한 아이디어)
- 전문 용어 사용 시 즉시 설명
- 독자에게 직접 말하는 방식 ("당신은...", "여러분이...")

[금지 구조]
- 서론에서 "이 글에서는 ~에 대해 알아보겠습니다" 금지
- 결론에서 단순 요약만 하는 것 금지
"""def calculate_content_quality_score(content: str) -> dict:
"""콘텐츠 품질 자동 평가 함수"""
score = 100
issues = []
# 1. AI 특유 표현 체크
ai_phrases = ["중요한 것은", "주목할 점은", "흥미롭게도", "매우 중요"]
for phrase in ai_phrases:
count = content.count(phrase)
if count > 0:
score -= count * 5
issues.append(f"AI 특유 표현 '{phrase}' {count}회 사용")
# 2. 문단 길이 체크
paragraphs = content.split('\n\n')
long_paragraphs = [p for p in paragraphs if len(p) > 500]
if long_paragraphs:
score -= len(long_paragraphs) * 3
issues.append(f"너무 긴 문단 {len(long_paragraphs)}개")
# 3. 키워드 밀도 체크
# (실제 구현 시 타겟 키워드 파라미터 추가)
# 4. 가독성 점수 (Flesch-Kincaid 변형)
sentences = content.split('.')
avg_sentence_length = sum(len(s.split()) for s in sentences) / len(sentences)
if avg_sentence_length > 25:
score -= 10
issues.append("평균 문장 길이가 너무 김")
return {
"score": max(0, score),
"grade": "A" if score >= 90 else "B" if score >= 75 else "C",
"issues": issues,
"recommendation": "발행 가능" if score >= 75 else "수정 필요"
}
블로그 포스팅 하나를 만들었다면, 이걸 여러 SNS 채널에 맞게 변환하는 것도 자동화할 수 있어요!
이걸 콘텐츠 리퍼포징(Content Repurposing)이라고 하는데, AutoGPT로 완전 자동화 가능해요 ㅋㅋ
# SNS 리퍼포징 에이전트
repurposing_prompts = {
    "twitter_thread": """
원본 블로그 포스팅을 트위터 스레드로 변환하세요.
- 첫 트윗: 핵심 가치 제안 (훅) - 280자 이내
- 2-8번 트윗: 주요 포인트 각각 - 280자 이내
- 마지막 트윗: CTA + 블로그 링크
- 각 트윗 번호 표시 (1/8, 2/8...)
- 이모지 적극 활용
""",
    "instagram_caption": """
원본 블로그를 인스타그램 캡션으로 변환하세요.
- 첫 줄: 시선을 끄는 훅 (이모지 포함)
- 본문: 핵심 내용 3-5개 포인트 (줄바꿈 활용)
- 해시태그: 관련 해시태그 20-30개
- CTA: "링크 바이오 참고" 등
- 전체 2200자 이내
""",
    "newsletter": """
원본 블로그를 이메일 뉴스레터로 변환하세요.
- 제목: 클릭률 높은 이메일 제목 (50자 이내)
- 프리뷰 텍스트: 40자 이내
- 인트로: 개인적인 인사말 (2-3문장)
- 본문: 핵심 내용 요약 (원본의 30% 분량)
- 독점 인사이트: 뉴스레터 구독자만을 위한 추가 팁
- CTA: 전체 글 읽기 버튼
"""
}
자동화 파이프라인을 구축했다면 끝이 아니에요!
어떤 콘텐츠가 잘 되고 있는지 데이터를 수집해서 AI에게 피드백을 주는 게 진짜 중요해요.
이걸 통해 시간이 지날수록 콘텐츠 품질이 자동으로 향상되는 구조를 만들 수 있어요!
| 지표 | 수집 방법 | 활용 방법 |
|---|---|---|
| 페이지뷰 | Google Analytics API | 인기 주제 패턴 파악 |
| 체류 시간 | GA4 Engagement | 콘텐츠 깊이 최적화 |
| 검색 순위 | Google Search Console API | SEO 전략 개선 |
| 소셜 공유 | 각 플랫폼 API | 바이럴 콘텐츠 패턴 학습 |
| 전환율 | GA4 Goals | CTA 최적화 |
import json
from datetime import datetime, timedelta

def collect_performance_data(post_id: str, days: int = 30) -> dict:
    """발행된 콘텐츠의 성과 데이터 수집"""

    # Google Analytics 4 API 호출
    ga_data = ga4_client.run_report(
        property=f"properties/{GA4_PROPERTY_ID}",
        date_ranges=[{"start_date": f"{days}daysAgo", "end_date": "today"}],
        dimensions=[{"name": "pagePath"}],
        metrics=[
            {"name": "screenPageViews"},
            {"name": "averageSessionDuration"},
            {"name": "bounceRate"}
        ],
        dimension_filter={
            "filter": {
                "field_name": "pagePath",
                "string_filter": {"value": f"/post/{post_id}"}
            }
        }
    )

    return {
        "post_id": post_id,
        "pageviews": ga_data.rows[0].metric_values[0].value,
        "avg_duration": ga_data.rows[0].metric_values[1].value,
        "bounce_rate": ga_data.rows[0].metric_values[2].value,
        "collected_at": datetime.now().isoformat()
    }

def update_content_strategy(performance_data: list) -> str:
    """성과 데이터를 바탕으로 콘텐츠 전략 업데이트"""

    # 상위 20% 콘텐츠 패턴 분석
    top_performers = sorted(
        performance_data,
        key=lambda x: int(x['pageviews']),
        reverse=True
    )[:len(performance_data)//5]

    # AutoGPT에게 분석 요청
    analysis_prompt = f"""
    다음 고성과 콘텐츠 데이터를 분석하세요:
    {json.dumps(top_performers, ensure_ascii=False, indent=2)}

    분석 항목:
    1. 공통 주제 패턴
    2. 제목 구조 패턴
    3. 최적 콘텐츠 길이
    4. 성공 요인 3가지
    5. 다음 달 콘텐츠 전략 제안

    결과를 content_strategy.json으로 저장하세요.
    """

    return analysis_prompt
AutoGPT로 콘텐츠를 자동화할 때 반드시 알아야 할 주의사항들이 있어요.
이 부분 무시했다가 나중에 큰 문제 생길 수 있어요 ㅋㅋㅋ (진지하게)
자 이제 전체 그림을 봤으니, 실제로 어떻게 시작하면 좋을지 단계별 로드맵을 정리해드릴게요!
처음부터 완전 자동화를 목표로 하면 오히려 실패하기 쉬워요. 단계적으로 접근하는 게 핵심이에요 ㅋㅋ
💬 "ㅋㅋㅋ 일단 LangChain으로 단순한 에이전트 하나 만들어봐. AutoGPT 풀 버전은 처음엔 좀 무거울 수 있어"
💬 "오 그럼 AutoGPT 안 써도 돼?"
💬 "AutoGPT의 개념(자율 에이전트)을 LangChain으로 구현하는 게 더 유연해. 나중에 AutoGPT Platform으로 확장하면 돼"
💬 "아 그렇구나 ㅋㅋ 고마워!"
실제로 많은 개발자들이 AutoGPT의 개념을 LangChain으로 구현하는 방식을 선호해요.
AutoGPT는 개념과 철학을 제시하고, LangChain은 그걸 실제로 구현하는 도구라고 생각하면 돼요.
그리고 재능넷 같은 플랫폼에서 AI 자동화 전문가들의 도움을 받는 것도 좋은 방법이에요.
처음 파이프라인 설계를 전문가에게 맡기고, 이후 운영은 직접 하는 방식으로 시작하면 시행착오를 많이 줄일 수 있거든요!
2024-2025년 기준으로 AutoGPT 기반 콘텐츠 자동화는 어디로 향하고 있을까요?
현재 진행 중인 주요 트렌드들을 살펴볼게요!
텍스트뿐만 아니라 이미지(DALL-E 3, Midjourney API), 음성(ElevenLabs), 영상(Sora)까지 통합한 완전한 멀티미디어 콘텐츠 자동화가 현실화되고 있어요.
독자 데이터를 분석해서 개인별 맞춤 콘텐츠를 자동 생성하는 시스템. 이메일 뉴스레터에서 이미 활발히 적용 중이에요.
소셜 미디어 트렌드를 실시간으로 감지하고 30분 이내에 관련 콘텐츠를 자동 발행하는 시스템이 등장하고 있어요.
OpenAI의 Assistants API, Anthropic의 Claude, Google의 Gemini 등 다양한 AI를 목적에 맞게 조합하는 멀티 AI 파이프라인이 표준이 되고 있어요.
성과 데이터를 학습해서 스스로 프롬프트를 최적화하는 메타 학습 시스템. 아직 초기 단계지만 빠르게 발전 중이에요.
자 이제 긴 여정이 끝났어요 ㅋㅋㅋ 핵심 내용을 한 번에 정리해드릴게요!
| 핵심 요소 | 내용 |
|---|---|
| 🤖 AutoGPT 본질 | 목표 기반 자율 실행 AI 에이전트 (ReAct 패턴) |
| 🏗️ 파이프라인 구조 | 탐색 → 기획 → 작성 → 검수 → SEO → 발행 → 분석 |
| 🤝 멀티 에이전트 | 역할 분담으로 품질과 효율 동시 향상 |
| 🔌 핵심 연동 | Tavily(검색) + WordPress(발행) + n8n(스케줄링) |
| 💰 비용 관리 | 모델 계층화 + 캐싱 + 배치 처리로 60-70% 절감 |
| ✅ 품질 관리 | 자동 스코어링 + 사람 최종 검토 병행 |
| ⚠️ 주의사항 | 저작권, 팩트체크, AI 표시 의무 준수 |
| 🚀 시작 방법 | LangChain 단일 에이전트 → 멀티 에이전트 → 완전 자동화 |

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.