
Ver3.5 쇼핑몰 추천 시스템 구현:협업 필터링과 AI 추천 알고리즘
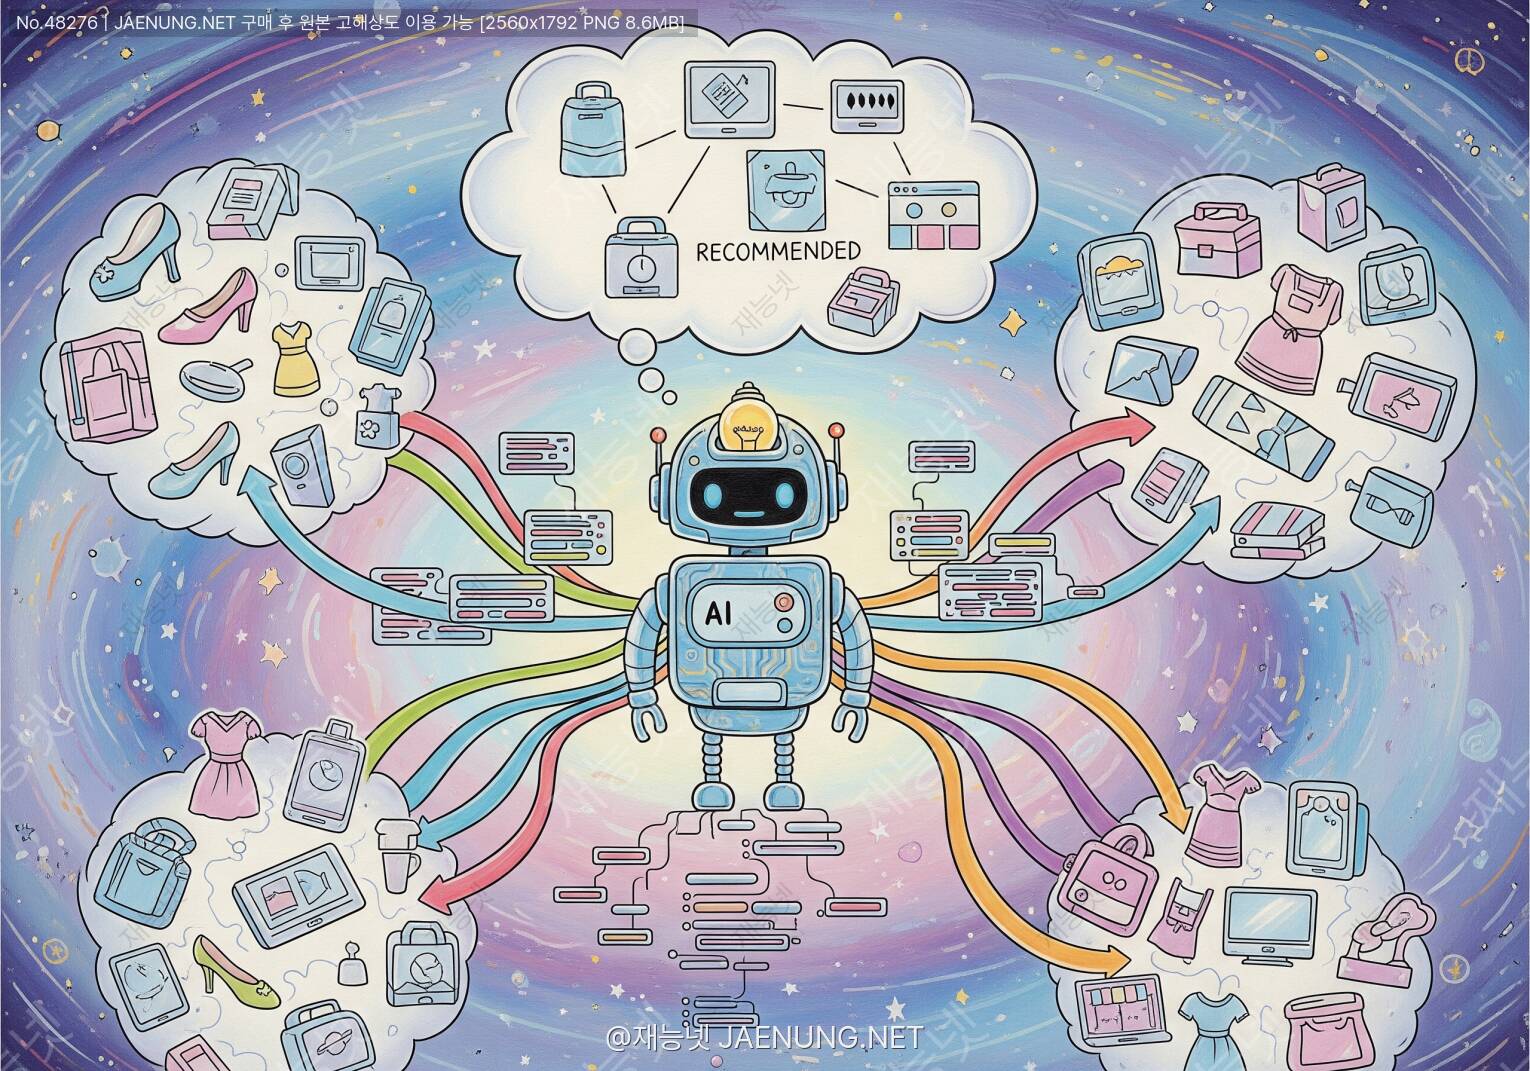
쇼핑몰 추천 시스템 구현:
협업 필터링과 AI 추천 알고리즘
협업 필터링부터 딥러닝 기반 추천까지, 실전 코드와 함께 완전 정복 🚀
야 솔직히 말해서... 쿠팡이나 무신사 들어갔을 때 "어? 이거 내가 딱 사고 싶었던 건데?!" 하고 소름 돋은 적 있지 않음? ㅋㅋㅋ 그게 바로 추천 시스템의 마법이야. 그냥 운이 아니라 수십만 줄의 알고리즘이 너를 분석한 결과임 😎
오늘은 쇼핑몰 개발자라면 반드시 알아야 할 추천 시스템의 모든 것을 파헤쳐볼 거야. 협업 필터링(Collaborative Filtering)부터 콘텐츠 기반 필터링, 그리고 요즘 핫한 딥러닝 기반 추천까지! 이론만 떠들면 재미없으니까 실제 코드도 같이 보면서 가자고 🔥
참고로 이런 기술 지식들, 재능넷 같은 플랫폼에서 실제로 거래되는 고급 개발 스킬이기도 해. 추천 시스템 구현 능력 하나만 있어도 프리랜서로 꽤 먹고 살 수 있다는 거 알지? ㅎㅎ
🤔 추천 시스템, 도대체 뭔데?
추천 시스템(Recommendation System)은 사용자가 좋아할 만한 아이템을 자동으로 예측하고 제안하는 시스템이야. 쇼핑몰에서는 이게 매출과 직결되기 때문에 진짜 핵심 기능 중 하나임.
아마존은 전체 매출의 35%가 추천 시스템에서 나온다고 알려져 있어. 넷플릭스는 사용자가 보는 콘텐츠의 80%가 추천을 통해 발견된다고 하고. 이 숫자들 보면 왜 대기업들이 추천 알고리즘에 수백억을 쏟아붓는지 이해가 되지? ㅋㅋㅋ
추천 시스템이 해결하는 핵심 문제들
상품이 수백만 개인데 사용자가 원하는 걸 어떻게 찾음? 추천이 없으면 사용자는 그냥 나가버림 🚪
인기 상품만 팔리는 게 아니라, 숨어있는 니치 상품들도 적절한 사용자에게 연결해줌 💎
"어? 이거 딱 내 취향인데?" 하는 순간 → 구매 전환율 폭발 📈
개인화된 경험을 제공하면 사용자가 다시 돌아올 이유가 생김 🔄
추천 시스템의 입력 데이터 종류
추천 시스템이 뭘 먹고 사는지 알아야 제대로 만들 수 있어. 크게 두 가지 타입의 데이터가 있음:
| 데이터 타입 | 예시 | 특징 |
|---|---|---|
| 명시적 피드백 (Explicit Feedback) |
별점, 리뷰, 좋아요 | 정확하지만 수집량이 적음 (사람들이 귀찮아서 잘 안 함 ㅋㅋ) |
| 암묵적 피드백 (Implicit Feedback) |
클릭, 구매, 체류시간, 스크롤 | 수집량 많지만 노이즈 존재 (실수로 클릭한 거일 수도) |
| 사용자 프로필 | 나이, 성별, 지역, 관심사 | 콜드스타트 문제 해결에 도움 |
| 아이템 메타데이터 | 카테고리, 브랜드, 가격, 태그 | 콘텐츠 기반 필터링의 핵심 재료 |
| 컨텍스트 데이터 | 시간, 날씨, 디바이스, 위치 | 상황 인식 추천에 활용 |
👥 협업 필터링 (Collaborative Filtering)
협업 필터링은 추천 시스템의 클래식 중의 클래식이야. 핵심 아이디어는 엄청 단순함: "나랑 비슷한 취향의 사람이 좋아하는 걸 나도 좋아할 거야" 이거임 ㅋㅋㅋ
예를 들어 A, B, C 세 명이 있는데 A랑 B가 같은 운동화, 같은 청바지를 샀어. 그러면 B가 산 후드티를 A한테도 추천해주는 거지. 이게 협업 필터링의 본질이야.
1) 사용자 기반 협업 필터링 (User-Based CF)
알고리즘 흐름:
코사인 유사도 공식은 이렇게 생겼어:
# 코사인 유사도 계산
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

# 사용자-아이템 평점 행렬 (행: 사용자, 열: 아이템)
# 0은 평점 없음을 의미
ratings = np.array([
[5, 3, 0, 1, 0],   # 사용자 A
[4, 0, 4, 1, 2],   # 사용자 B
[1, 1, 0, 5, 4],   # 사용자 C
[0, 0, 4, 4, 0],   # 사용자 D
[2, 1, 0, 4, 5],   # 사용자 E (타겟)
])

# 사용자 간 코사인 유사도 계산
user_similarity = cosine_similarity(ratings)
print("사용자 유사도 행렬:")
print(user_similarity)

# 타겟 사용자(E, 인덱스 4)와 가장 유사한 사용자 찾기
target_user = 4
similarities = user_similarity[target_user]
# 자기 자신 제외하고 정렬
similar_users = np.argsort(similarities)[::-1][1:]
print(f"\n타겟 사용자와 유사도 순위: {similar_users}")
2) 아이템 기반 협업 필터링 (Item-Based CF)
사용자 기반이 "나랑 비슷한 사람"을 찾는 거라면, 아이템 기반은 "내가 좋아한 상품과 비슷한 상품"을 찾는 거야. 실제로 아마존이 초기에 사용한 방식이 바로 이거임!
import pandas as pd
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

# 사용자-아이템 평점 데이터 생성
data = {
'운동화A': [5, 4, 0, 0, 2],
'운동화B': [4, 5, 0, 0, 1],
'청바지A': [0, 0, 5, 4, 0],
'청바지B': [0, 0, 4, 5, 0],
'후드티A': [3, 0, 0, 0, 5],
}
df = pd.DataFrame(data, index=['유저1','유저2','유저3','유저4','유저5'])

# 아이템 간 유사도 계산 (전치행렬 사용)
item_similarity = cosine_similarity(df.T)
item_sim_df = pd.DataFrame(
item_similarity,
index=df.columns,
columns=df.columns
)

print("아이템 유사도 행렬:")
print(item_sim_df.round(3))

# 특정 아이템과 가장 유사한 아이템 추천
def get_similar_items(item_name, n=3):
similar = item_sim_df[item_name].sort_values(ascending=False)
return similar[1:n+1]  # 자기 자신 제외

print("\n'운동화A'와 유사한 아이템:")
print(get_similar_items('운동화A'))
🔥 Item-Based vs User-Based 비교
| 구분 | User-Based | Item-Based |
|---|---|---|
| 계산 대상 | 사용자 간 유사도 | 아이템 간 유사도 |
| 안정성 | 낮음 (사용자 취향 변함) | 높음 (아이템 속성 고정) |
| 확장성 | 사용자 수 증가 시 느려짐 | 상품 수 증가 시 느려짐 |
| 적합한 상황 | 사용자 수 < 아이템 수 | 아이템 수 < 사용자 수 |
| 실제 사용 | 소규모 서비스 | 대규모 이커머스 (아마존) |
3) 행렬 분해 (Matrix Factorization) - 협업 필터링의 진화
협업 필터링의 가장 큰 문제가 뭔지 알아? 바로 희소성(Sparsity) 문제야. 쇼핑몰에 상품이 100만 개인데 한 사람이 구매한 상품은 고작 10~20개잖아. 그러면 평점 행렬의 99.99%가 비어있는 거야. 이걸 어떻게 채울 거임?
그래서 나온 게 행렬 분해(Matrix Factorization)야. 넷플릭스 프라이즈 대회(2009년)에서 우승한 알고리즘이 바로 이 방식이었어. 당시 상금이 100만 달러였는데 ㄷㄷ
핵심 아이디어: 사용자-아이템 행렬 R을 두 개의 저차원 행렬로 분해
R ≈ P × Q^T
여기서:
• R: 사용자-아이템 평점 행렬 (m × n)
• P: 사용자 잠재 요인 행렬 (m × k)
• Q: 아이템 잠재 요인 행렬 (n × k)
• k: 잠재 요인의 수 (하이퍼파라미터, 보통 20~200)
import numpy as np

class MatrixFactorization:
def __init__(self, R, k=10, lr=0.01, reg=0.01, epochs=100):
"""
R: 사용자-아이템 평점 행렬
k: 잠재 요인 수
lr: 학습률
reg: 정규화 파라미터
epochs: 학습 반복 횟수
"""
self.R = R
self.num_users, self.num_items = R.shape
self.k = k
self.lr = lr
self.reg = reg
self.epochs = epochs

def train(self):
# 사용자, 아이템 잠재 행렬 랜덤 초기화
self.P = np.random.normal(0, 0.1, (self.num_users, self.k))
self.Q = np.random.normal(0, 0.1, (self.num_items, self.k))

# 평점이 있는 위치만 학습
self.samples = [
(i, j, self.R[i, j])
for i in range(self.num_users)
for j in range(self.num_items)
if self.R[i, j] > 0
]

for epoch in range(self.epochs):
np.random.shuffle(self.samples)
self._sgd()  # 확률적 경사 하강법

if (epoch + 1) % 10 == 0:
loss = self._compute_loss()
print(f"Epoch {epoch+1}/{self.epochs}, Loss: {loss:.4f}")

def _sgd(self):
"""확률적 경사 하강법으로 P, Q 업데이트"""
for i, j, r_ij in self.samples:
# 예측값 계산
prediction = self.P[i, :].dot(self.Q[j, :].T)
error = r_ij - prediction

# 그래디언트 업데이트
self.P[i, :] += self.lr * (
error * self.Q[j, :] - self.reg * self.P[i, :]
)
self.Q[j, :] += self.lr * (
error * self.P[i, :] - self.reg * self.Q[j, :]
)

def _compute_loss(self):
"""RMSE 계산"""
predicted = self.P.dot(self.Q.T)
error = 0
for i, j, r_ij in self.samples:
error += (r_ij - predicted[i, j]) ** 2
return np.sqrt(error / len(self.samples))

def predict(self, user_id, item_id):
"""특정 사용자-아이템 쌍의 평점 예측"""
return self.P[user_id, :].dot(self.Q[item_id, :].T)

def recommend(self, user_id, n=5):
"""사용자에게 상위 N개 아이템 추천"""
user_ratings = self.R[user_id, :]
predictions = self.P[user_id, :].dot(self.Q.T)

# 이미 평점을 준 아이템 제외
unrated_items = np.where(user_ratings == 0)[0]
recommendations = [
(item_id, predictions[item_id])
for item_id in unrated_items
]
recommendations.sort(key=lambda x: x[1], reverse=True)
return recommendations[:n]

# 사용 예시
R = np.array([
[5, 3, 0, 1, 0],
[4, 0, 4, 1, 2],
[1, 1, 0, 5, 4],
[0, 0, 4, 4, 0],
[2, 1, 0, 4, 5],
])

mf = MatrixFactorization(R, k=3, lr=0.01, reg=0.01, epochs=100)
mf.train()
print("\n사용자 0에 대한 추천:")
print(mf.recommend(user_id=0, n=3))
surprise 라이브러리나 implicit 라이브러리 써. 특히 implicit는 암묵적 피드백 데이터에 최적화되어 있어서 쇼핑몰에 딱임!
📦 콘텐츠 기반 필터링 (Content-Based Filtering)
협업 필터링이 "다른 사람들의 행동"을 보는 거라면, 콘텐츠 기반 필터링은 "아이템 자체의 특성"을 분석해. 사용자가 빨간 운동화를 샀으면, 다른 빨간 운동화나 비슷한 스타일의 신발을 추천하는 식이지.
이 방식의 가장 큰 장점은 콜드스타트 문제에 강하다는 거야. 새로운 상품이 등록되어도 메타데이터만 있으면 바로 추천 가능! 새로운 사용자도 프로필 정보만 있으면 어느 정도 추천이 됨 👍
TF-IDF를 활용한 상품 유사도 계산
상품 설명 텍스트를 벡터화해서 유사도를 계산하는 방법이야. 쇼핑몰에서 상품 설명, 태그, 카테고리 정보를 활용하면 꽤 괜찮은 결과가 나와.
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

# 상품 데이터 (실제로는 DB에서 가져옴)
products = pd.DataFrame({
'product_id': [1, 2, 3, 4, 5, 6],
'name': [
'나이키 에어맥스 270',
'아디다스 울트라부스트',
'뉴발란스 990v5',
'나이키 조던 1',
'아디다스 스탠스미스',
'컨버스 척테일러'
],
'description': [
'에어 쿠션 러닝화 스포츠 조깅 편안함 나이키 에어맥스',
'부스트 쿠션 러닝화 스포츠 달리기 아디다스 에너지리턴',
'클래식 러닝화 데일리 캐주얼 뉴발란스 미국산 프리미엄',
'농구화 하이탑 스트릿 패션 나이키 에어조던 레트로',
'캐주얼 스니커즈 클래식 화이트 아디다스 오리지널',
'캔버스 스니커즈 클래식 캐주얼 컨버스 올스타 데일리'
],
'category': ['러닝화', '러닝화', '러닝화', '농구화', '스니커즈', '스니커즈'],
'price': [189000, 219000, 299000, 259000, 129000, 99000]
})

# TF-IDF 벡터화
# 상품 설명 + 카테고리를 합쳐서 특성 생성
products['features'] = (
products['description'] + ' ' +
products['category'] + ' ' +
products['name']
)

tfidf = TfidfVectorizer(
analyzer='word',
min_df=1,
stop_words=None  # 한국어는 별도 처리 필요
)

tfidf_matrix = tfidf.fit_transform(products['features'])
print(f"TF-IDF 행렬 크기: {tfidf_matrix.shape}")
# (6개 상품, N개 단어)

# 코사인 유사도 계산
cosine_sim = cosine_similarity(tfidf_matrix, tfidf_matrix)
print("\n상품 간 코사인 유사도:")
sim_df = pd.DataFrame(
cosine_sim,
index=products['name'],
columns=products['name']
)
print(sim_df.round(3))

# 특정 상품과 유사한 상품 추천 함수
def content_based_recommend(product_name, n=3):
"""상품명을 입력받아 유사한 상품 N개 추천"""
idx = products[products['name'] == product_name].index[0]
sim_scores = list(enumerate(cosine_sim[idx]))
sim_scores = sorted(sim_scores, key=lambda x: x[1], reverse=True)
sim_scores = sim_scores[1:n+1]  # 자기 자신 제외

product_indices = [i[0] for i in sim_scores]
result = products.iloc[product_indices][['name', 'category', 'price']].copy()
result['similarity'] = [round(i[1], 3) for i in sim_scores]
return result

print("\n'나이키 에어맥스 270'과 유사한 상품:")
print(content_based_recommend('나이키 에어맥스 270'))
Word2Vec / 임베딩 기반 상품 유사도
TF-IDF는 단어 빈도 기반이라 의미적 유사성을 잘 못 잡아. 예를 들어 "운동화"랑 "스니커즈"는 같은 의미인데 TF-IDF는 다른 단어로 취급함 ㅠㅠ
이걸 해결하는 게 Word2Vec이나 BERT 같은 임베딩 모델이야. 단어를 고차원 벡터 공간에 매핑해서 의미적으로 비슷한 단어는 벡터 공간에서도 가깝게 위치하게 만들어.
from sentence_transformers import SentenceTransformer
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

# 사전 학습된 한국어 BERT 모델 사용
# pip install sentence-transformers
model = SentenceTransformer('jhgan/ko-sroberta-multitask')

# 상품 설명 임베딩
product_descriptions = [
"에어 쿠션이 있는 러닝화, 조깅과 스포츠에 적합",
"부스트 기술이 적용된 달리기용 운동화",
"클래식한 디자인의 일상용 캐주얼 신발",
"농구 경기용 하이탑 스포츠화",
"흰색 캔버스 소재의 레트로 스타일 스니커즈",
]

# 문장 임베딩 생성 (각 설명을 768차원 벡터로 변환)
embeddings = model.encode(product_descriptions)
print(f"임베딩 차원: {embeddings.shape}")  # (5, 768)

# 코사인 유사도 계산
sim_matrix = cosine_similarity(embeddings)

# "러닝화" 관련 상품 찾기
query = "달리기할 때 신기 좋은 쿠션감 있는 신발"
query_embedding = model.encode([query])
similarities = cosine_similarity(query_embedding, embeddings)[0]

print("\n쿼리와 각 상품의 유사도:")
for i, (desc, sim) in enumerate(zip(product_descriptions, similarities)):
print(f"상품{i+1}: {sim:.3f} - {desc[:30]}...")
🎯 콘텐츠 기반 필터링의 장단점
✅ 장점:
• 새 상품/사용자에도 즉시 추천 가능 (콜드스타트 해결)
• 추천 이유를 설명하기 쉬움 ("이 상품과 비슷해서요~")
• 다른 사용자 데이터 없이도 동작
❌ 단점:
• 과도한 특화(Over-specialization): 비슷한 것만 계속 추천 → 다양성 부족
• 메타데이터 품질에 크게 의존
• 사용자의 잠재적 관심사 발굴 어려움
🧠 딥러닝 기반 추천 시스템
자 이제 진짜 핫한 영역으로 들어왔어 ㅋㅋㅋ 딥러닝 기반 추천은 기존 방법들의 한계를 극복하면서 훨씬 복잡한 패턴을 학습할 수 있어. 요즘 대형 플랫폼들이 다 이 방향으로 가고 있음.
1) Neural Collaborative Filtering (NCF)
행렬 분해의 선형적 한계를 극복하기 위해 신경망을 도입한 방법이야. 2017년 He et al.이 발표한 논문인데 지금도 많이 쓰임.
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers
import numpy as np

class NCF(keras.Model):
"""Neural Collaborative Filtering 모델"""

def __init__(self, num_users, num_items, embedding_dim=32, layers_dims=[64, 32, 16]):
super(NCF, self).__init__()

# GMF (Generalized Matrix Factorization) 파트
self.gmf_user_embedding = layers.Embedding(
num_users, embedding_dim, name='gmf_user'
)
self.gmf_item_embedding = layers.Embedding(
num_items, embedding_dim, name='gmf_item'
)

# MLP (Multi-Layer Perceptron) 파트
self.mlp_user_embedding = layers.Embedding(
num_users, embedding_dim, name='mlp_user'
)
self.mlp_item_embedding = layers.Embedding(
num_items, embedding_dim, name='mlp_item'
)

# MLP 레이어들
self.mlp_layers = []
for dim in layers_dims:
self.mlp_layers.append(layers.Dense(dim, activation='relu'))
self.mlp_layers.append(layers.Dropout(0.2))

# 최종 출력 레이어
self.output_layer = layers.Dense(1, activation='sigmoid')

def call(self, inputs):
user_input, item_input = inputs

# GMF 파트: 요소별 곱
gmf_user = self.gmf_user_embedding(user_input)
gmf_item = self.gmf_item_embedding(item_input)
gmf_output = gmf_user * gmf_item  # element-wise product

# MLP 파트: 연결 후 신경망 통과
mlp_user = self.mlp_user_embedding(user_input)
mlp_item = self.mlp_item_embedding(item_input)
mlp_input = tf.concat([mlp_user, mlp_item], axis=-1)

mlp_output = mlp_input
for layer in self.mlp_layers:
mlp_output = layer(mlp_output)

# GMF + MLP 결합
combined = tf.concat([gmf_output, mlp_output], axis=-1)

# 최종 예측 (0~1 사이 값, 구매 확률)
prediction = self.output_layer(combined)
return prediction

# 모델 생성
num_users = 10000
num_items = 50000
model = NCF(num_users, num_items)

# 컴파일
model.compile(
optimizer=keras.optimizers.Adam(learning_rate=0.001),
loss='binary_crossentropy',
metrics=['accuracy', keras.metrics.AUC()]
)

# 학습 데이터 예시 (실제로는 DB에서 가져옴)
# 양성 샘플: 실제 구매한 (user, item) 쌍
# 음성 샘플: 구매하지 않은 (user, item) 쌍 (네거티브 샘플링)
train_users = np.random.randint(0, num_users, 100000)
train_items = np.random.randint(0, num_items, 100000)
train_labels = np.random.randint(0, 2, 100000).astype(float)

# 학습
history = model.fit(
[train_users, train_items],
train_labels,
batch_size=256,
epochs=10,
validation_split=0.1,
verbose=1
)

# 특정 사용자에 대한 추천
def recommend_for_user(user_id, n=10, candidate_items=None):
if candidate_items is None:
candidate_items = np.arange(num_items)

user_array = np.full(len(candidate_items), user_id)
predictions = model.predict([user_array, candidate_items], batch_size=1024)

top_indices = np.argsort(predictions.flatten())[::-1][:n]
return candidate_items[top_indices], predictions[top_indices].flatten()

items, scores = recommend_for_user(user_id=42, n=5)
print(f"사용자 42에 대한 추천 아이템: {items}")
print(f"예측 점수: {scores}")
2) 순차적 추천 (Sequential Recommendation)
사용자의 행동 순서(시퀀스)를 고려하는 추천이야. "운동화 봤다가 → 양말 봤다가 → 스포츠 바지 봤다가" 이런 패턴을 학습해서 다음에 볼 상품을 예측하는 거지. 요즘 쇼핑몰에서 "최근 본 상품 기반 추천"이 이 방식임.
import tensorflow as tf
from tensorflow.keras import layers
import numpy as np

class SASRec(tf.keras.Model):
"""Self-Attention based Sequential Recommendation"""

def __init__(self, num_items, seq_len=50, d_model=64, num_heads=2, num_blocks=2):
super(SASRec, self).__init__()
self.seq_len = seq_len
self.d_model = d_model

# 아이템 임베딩
self.item_embedding = layers.Embedding(
num_items + 1, d_model, mask_zero=True
)

# 위치 임베딩
self.pos_embedding = layers.Embedding(seq_len, d_model)

# Transformer 블록들
self.attention_layers = []
self.ffn_layers = []
self.norm_layers = []

for _ in range(num_blocks):
self.attention_layers.append(
layers.MultiHeadAttention(num_heads=num_heads, key_dim=d_model//num_heads)
)
self.ffn_layers.append(tf.keras.Sequential([
layers.Dense(d_model * 4, activation='relu'),
layers.Dense(d_model)
]))
self.norm_layers.append([
layers.LayerNormalization(),
layers.LayerNormalization()
])

self.dropout = layers.Dropout(0.2)
self.final_norm = layers.LayerNormalization()

def call(self, item_seq, training=False):
# 아이템 임베딩
seq_emb = self.item_embedding(item_seq)

# 위치 임베딩 추가
positions = tf.range(self.seq_len)
pos_emb = self.pos_embedding(positions)
x = seq_emb + pos_emb
x = self.dropout(x, training=training)

# 인과적 마스크 (미래 정보 차단)
seq_len = tf.shape(item_seq)[1]
causal_mask = tf.linalg.band_part(
tf.ones((seq_len, seq_len)), -1, 0
)

# Transformer 블록 통과
for i, (attn, ffn, norms) in enumerate(
zip(self.attention_layers, self.ffn_layers, self.norm_layers)
):
# Self-Attention
attn_out = attn(x, x, attention_mask=causal_mask, training=training)
x = norms[0](x + attn_out)

# Feed-Forward Network
ffn_out = ffn(x, training=training)
x = norms[1](x + ffn_out)

return self.final_norm(x)

# 사용 예시
num_items = 50000
seq_len = 50
model = SASRec(num_items, seq_len=seq_len)

# 사용자 행동 시퀀스 (최근 50개 상품 ID)
user_sequence = np.array([[
1234, 5678, 9012, 3456, 7890,  # 최근 구매/클릭 상품들
0, 0, 0, 0, 0,  # 패딩 (50개 맞추기)
# ... (50개까지)
]])

# 패딩 처리
padded_seq = tf.keras.preprocessing.sequence.pad_sequences(
[[1234, 5678, 9012, 3456, 7890]],
maxlen=seq_len,
padding='pre'
)

# 시퀀스 인코딩
output = model(padded_seq)
print(f"시퀀스 인코딩 결과 shape: {output.shape}")
# (1, 50, 64) - 각 위치에서의 사용자 상태 표현
• Surprise: 협업 필터링 특화, 사용하기 쉬움
• LightFM: 하이브리드 추천, 콜드스타트 강함
• implicit: 암묵적 피드백 특화, 빠른 속도
• TensorFlow Recommenders (TFRS): 구글이 만든 프레임워크
🔀 하이브리드 추천 시스템
실제 서비스에서는 하나의 알고리즘만 쓰는 경우가 거의 없어. 협업 필터링은 콜드스타트에 약하고, 콘텐츠 기반은 다양성이 부족하고... 각각의 단점이 있잖아. 그래서 여러 방법을 조합하는 하이브리드 방식을 씀!
하이브리드 방식의 종류:
각 알고리즘의 점수를 가중 평균으로 합산
예: 최종점수 = 0.6 × CF점수 + 0.4 × CBF점수
상황에 따라 다른 알고리즘 사용
예: 신규 사용자 → 콘텐츠 기반, 기존 사용자 → 협업 필터링
한 알고리즘이 후보를 생성하고, 다른 알고리즘이 재랭킹
예: CF로 100개 후보 → 딥러닝으로 상위 10개 선택
여러 소스의 피처를 하나의 모델에 입력
예: 사용자 임베딩 + 아이템 임베딩 + 컨텍스트 피처 → 딥러닝
class HybridRecommender:
"""협업 필터링 + 콘텐츠 기반 하이브리드 추천"""

def __init__(self, cf_model, cbf_model, cf_weight=0.6, cbf_weight=0.4):
self.cf_model = cf_model
self.cbf_model = cbf_model
self.cf_weight = cf_weight
self.cbf_weight = cbf_weight

def recommend(self, user_id, user_history, n=10):
"""
user_id: 사용자 ID
user_history: 사용자 구매/클릭 이력 (아이템 ID 리스트)
n: 추천 개수
"""
# 신규 사용자 처리 (콜드스타트)
if len(user_history) < 3:
print("신규 사용자 → 콘텐츠 기반 추천 사용")
return self._cold_start_recommend(user_history, n)

# 협업 필터링 점수
cf_scores = self.cf_model.predict_scores(user_id)

# 콘텐츠 기반 점수 (최근 본 상품 기반)
recent_items = user_history[-5:]  # 최근 5개
cbf_scores = self.cbf_model.predict_scores(recent_items)

# 점수 정규화 (0~1 범위로)
cf_scores_norm = self._normalize(cf_scores)
cbf_scores_norm = self._normalize(cbf_scores)

# 가중 결합
hybrid_scores = (
self.cf_weight * cf_scores_norm +
self.cbf_weight * cbf_scores_norm
)

# 이미 본 상품 제외
for item_id in user_history:
hybrid_scores[item_id] = -1

# 상위 N개 반환
top_items = sorted(
enumerate(hybrid_scores),
key=lambda x: x[1],
reverse=True
)[:n]

return [item_id for item_id, score in top_items]

def _cold_start_recommend(self, user_history, n):
"""신규 사용자: 인기 상품 + 콘텐츠 기반"""
if not user_history:
return self._get_popular_items(n)

cbf_scores = self.cbf_model.predict_scores(user_history)
top_items = sorted(
enumerate(cbf_scores),
key=lambda x: x[1],
reverse=True
)[:n]
return [item_id for item_id, score in top_items]

def _normalize(self, scores):
"""Min-Max 정규화"""
import numpy as np
min_val = min(scores)
max_val = max(scores)
if max_val == min_val:
return [0.5] * len(scores)
return [(s - min_val) / (max_val - min_val) for s in scores]

def _get_popular_items(self, n):
"""인기 상품 반환 (신규 사용자용)"""
# 실제로는 DB에서 인기 상품 조회
return list(range(n))
⚡ 실전 구현: FastAPI 추천 API 서버
이론은 충분히 했으니까 이제 실제로 쇼핑몰에 붙일 수 있는 추천 API 서버를 만들어보자! FastAPI + Redis 조합으로 빠르고 확장 가능한 서버를 구축할 거야.
# main.py - FastAPI 추천 서버
from fastapi import FastAPI, HTTPException, BackgroundTasks
from pydantic import BaseModel
from typing import List, Optional
import redis
import json
import numpy as np
from datetime import datetime

app = FastAPI(title="쇼핑몰 추천 API", version="1.0.0")

# Redis 연결 (추천 결과 캐싱)
redis_client = redis.Redis(host='localhost', port=6379, db=0)
CACHE_TTL = 3600  # 1시간 캐시

# 요청/응답 모델
class RecommendRequest(BaseModel):
user_id: int
context: Optional[str] = "home"  # home, product_detail, cart, checkout
item_id: Optional[int] = None    # 상품 상세 페이지용
limit: int = 10

class RecommendItem(BaseModel):
item_id: int
score: float
reason: str  # 추천 이유 (설명 가능한 AI)

class RecommendResponse(BaseModel):
user_id: int
recommendations: List[RecommendItem]
algorithm: str
generated_at: str

# 추천 엔진 (실제로는 학습된 모델 로드)
class RecommendationEngine:
def __init__(self):
# 실제로는 저장된 모델 파일 로드
# self.model = load_model('ncf_model.h5')
# self.item_embeddings = np.load('item_embeddings.npy')
pass

def get_user_recommendations(self, user_id: int, limit: int = 10):
"""사용자 기반 추천"""
# 실제 구현에서는 학습된 모델 사용
# 여기서는 예시 데이터 반환
items = [
RecommendItem(
item_id=1001 + i,
score=round(0.95 - i * 0.05, 3),
reason="구매 이력 기반 추천"
)
for i in range(limit)
]
return items, "collaborative_filtering"

def get_similar_items(self, item_id: int, limit: int = 10):
"""유사 상품 추천"""
items = [
RecommendItem(
item_id=2001 + i,
score=round(0.90 - i * 0.04, 3),
reason=f"상품 {item_id}와 유사한 상품"
)
for i in range(limit)
]
return items, "content_based"

def get_cart_recommendations(self, user_id: int, limit: int = 5):
"""장바구니 기반 추천 (함께 구매하면 좋은 상품)"""
items = [
RecommendItem(
item_id=3001 + i,
score=round(0.85 - i * 0.06, 3),
reason="함께 구매하면 좋은 상품"
)
for i in range(limit)
]
return items, "association_rules"

engine = RecommendationEngine()

@app.post("/recommend", response_model=RecommendResponse)
async def get_recommendations(
request: RecommendRequest,
background_tasks: BackgroundTasks
):
"""메인 추천 엔드포인트"""

# 캐시 키 생성
cache_key = f"rec:{request.user_id}:{request.context}:{request.item_id}"

# 캐시 확인
cached = redis_client.get(cache_key)
if cached:
return json.loads(cached)

# 컨텍스트에 따른 추천 전략 선택
if request.context == "product_detail" and request.item_id:
items, algorithm = engine.get_similar_items(
request.item_id, request.limit
)
elif request.context == "cart":
items, algorithm = engine.get_cart_recommendations(
request.user_id, request.limit
)
else:  # home, checkout 등
items, algorithm = engine.get_user_recommendations(
request.user_id, request.limit
)

response = RecommendResponse(
user_id=request.user_id,
recommendations=items,
algorithm=algorithm,
generated_at=datetime.now().isoformat()
)

# 백그라운드에서 캐시 저장
background_tasks.add_task(
cache_recommendations,
cache_key,
response.dict(),
CACHE_TTL
)

return response

def cache_recommendations(key: str, data: dict, ttl: int):
"""추천 결과 Redis 캐싱"""
redis_client.setex(key, ttl, json.dumps(data, ensure_ascii=False))

@app.post("/feedback")
async def record_feedback(
user_id: int,
item_id: int,
action: str,  # click, purchase, skip, like
background_tasks: BackgroundTasks
):
"""사용자 피드백 수집 (모델 업데이트용)"""
feedback_data = {
"user_id": user_id,
"item_id": item_id,
"action": action,
"timestamp": datetime.now().isoformat()
}

# 피드백을 Kafka나 DB에 저장 (비동기)
background_tasks.add_task(save_feedback, feedback_data)

# 해당 사용자 캐시 무효화
pattern = f"rec:{user_id}:*"
for key in redis_client.scan_iter(pattern):
redis_client.delete(key)

return {"status": "ok", "message": "피드백 저장 완료"}

async def save_feedback(data: dict):
"""피드백 데이터 저장 (실제로는 Kafka 프로듀서 사용)"""
print(f"피드백 저장: {data}")

@app.get("/health")
async def health_check():
return {"status": "healthy", "redis": redis_client.ping()}

# 실행: uvicorn main:app --reload --port 8000
🔥 API 호출 예시 (프론트엔드에서):
// JavaScript - 메인 페이지 추천 로드
async function loadRecommendations(userId) {
const response = await fetch('/recommend', {
method: 'POST',
headers: { 'Content-Type': 'application/json' },
body: JSON.stringify({
user_id: userId,
context: 'home',
limit: 10
})
});

const data = await response.json();

// 추천 상품 렌더링
const container = document.getElementById('recommendations');
data.recommendations.forEach(item => {
const card = createProductCard(item.item_id, item.reason);
container.appendChild(card);
});
}

// 상품 클릭 시 피드백 전송
async function onProductClick(userId, itemId) {
await fetch('/feedback', {
method: 'POST',
headers: { 'Content-Type': 'application/json' },
body: JSON.stringify({
user_id: userId,
item_id: itemId,
action: 'click'
})
});
}
📊 추천 시스템 평가 지표
추천 시스템 만들었다고 끝이 아니야! 얼마나 잘 추천하는지 측정해야 개선이 가능하지. 추천 시스템 평가는 크게 오프라인 평가와 온라인 평가로 나뉘어.
오프라인 평가 지표
import numpy as np

def precision_at_k(recommended, relevant, k):
"""
Precision@K: 추천한 K개 중 실제 관련 있는 비율
"""
recommended_k = recommended[:k]
hits = len(set(recommended_k) & set(relevant))
return hits / k

def recall_at_k(recommended, relevant, k):
"""
Recall@K: 전체 관련 아이템 중 추천된 비율
"""
recommended_k = recommended[:k]
hits = len(set(recommended_k) & set(relevant))
return hits / len(relevant) if relevant else 0

def ndcg_at_k(recommended, relevant, k):
"""
NDCG@K: 순서를 고려한 추천 품질 (위에 있을수록 가중치 높음)
"""
recommended_k = recommended[:k]

# DCG 계산
dcg = 0
for i, item in enumerate(recommended_k):
if item in relevant:
dcg += 1 / np.log2(i + 2)  # i+2 because log2(1)=0

# IDCG 계산 (이상적인 DCG)
ideal_hits = min(len(relevant), k)
idcg = sum(1 / np.log2(i + 2) for i in range(ideal_hits))

return dcg / idcg if idcg > 0 else 0

def mean_average_precision(all_recommended, all_relevant):
"""
MAP: 여러 사용자에 대한 평균 정밀도
"""
ap_scores = []
for recommended, relevant in zip(all_recommended, all_relevant):
ap = 0
hits = 0
for i, item in enumerate(recommended):
if item in relevant:
hits += 1
ap += hits / (i + 1)
ap /= len(relevant) if relevant else 1
ap_scores.append(ap)
return np.mean(ap_scores)

# 평가 예시
recommended = [101, 203, 305, 407, 509, 611, 713, 815, 917, 1019]
relevant = {203, 509, 815, 1019, 1121}  # 실제 구매한 상품

print(f"Precision@5: {precision_at_k(recommended, relevant, 5):.3f}")
print(f"Precision@10: {precision_at_k(recommended, relevant, 10):.3f}")
print(f"Recall@5: {recall_at_k(recommended, relevant, 5):.3f}")
print(f"Recall@10: {recall_at_k(recommended, relevant, 10):.3f}")
print(f"NDCG@5: {ndcg_at_k(recommended, relevant, 5):.3f}")
print(f"NDCG@10: {ndcg_at_k(recommended, relevant, 10):.3f}")
| 지표 | 의미 | 언제 중요? |
|---|---|---|
| Precision@K | 추천 K개 중 맞춘 비율 | 추천 정확도가 중요할 때 |
| Recall@K | 전체 정답 중 찾은 비율 | 놓치는 상품이 없어야 할 때 |
| NDCG@K | 순위를 고려한 품질 | 상위 노출 순서가 중요할 때 |
| MAP | 전체 사용자 평균 정밀도 | 전반적인 성능 비교 |
| Coverage | 추천된 아이템 다양성 | 롱테일 상품 노출 중요할 때 |
| Novelty | 새로운 아이템 추천 비율 | 발견 경험이 중요할 때 |
온라인 평가: A/B 테스트
오프라인 지표가 좋아도 실제 비즈니스 성과로 이어지지 않을 수 있어. 그래서 A/B 테스트가 필수야!
📈 A/B 테스트 핵심 지표:
• CTR (Click-Through Rate): 추천 상품 클릭률
• CVR (Conversion Rate): 추천 → 구매 전환율
• Revenue per User: 사용자당 매출
• Session Duration: 세션 체류 시간
• Bounce Rate: 이탈률
⚠️ 주의: 통계적 유의성 확보를 위해 최소 1~2주, 충분한 샘플 수(보통 수천~수만 명)가 필요해!
🥶 콜드스타트 문제 해결 전략
추천 시스템 개발자들의 영원한 숙제 ㅋㅋㅋ 콜드스타트(Cold Start)는 데이터가 없는 새로운 사용자나 새로운 상품에 대해 추천을 못 하는 문제야.
🆕 신규 사용자 콜드스타트
• 인기 상품 추천
• 온보딩 설문 (취향 수집)
• 인구통계 기반 추천
• 탐색 vs 활용 균형
📦 신규 상품 콜드스타트
• 콘텐츠 기반 유사 상품 연결
• 카테고리 인기 상품 대체
• 메타데이터 임베딩 활용
• 탐색적 노출 (Exploration)
class ColdStartHandler:
"""콜드스타트 문제 처리 전략"""

def __init__(self, popularity_model, content_model, user_threshold=5):
self.popularity_model = popularity_model  # 인기도 기반
self.content_model = content_model        # 콘텐츠 기반
self.user_threshold = user_threshold      # 이 이상 구매해야 CF 사용

def recommend(self, user_id, user_interactions, user_profile=None, n=10):
"""
상호작용 수에 따라 전략 자동 선택
"""
interaction_count = len(user_interactions)

if interaction_count == 0:
# 완전 신규: 인기 상품 + 프로필 기반
return self._new_user_recommend(user_profile, n)

elif interaction_count < self.user_threshold:
# 초기 사용자: 콘텐츠 기반 + 인기 상품 혼합
return self._early_user_recommend(
user_interactions, n,
content_ratio=0.7
)

else:
# 충분한 데이터: 협업 필터링 사용
return self._mature_user_recommend(user_id, n)

def _new_user_recommend(self, user_profile, n):
"""완전 신규 사용자 추천"""
if user_profile:
# 나이, 성별, 관심사 기반 세그먼트 추천
segment = self._get_user_segment(user_profile)
return self.popularity_model.get_segment_popular(segment, n)
else:
# 전체 인기 상품
return self.popularity_model.get_global_popular(n)

def _early_user_recommend(self, interactions, n, content_ratio=0.7):
"""초기 사용자: 콘텐츠 기반 위주"""
content_n = int(n * content_ratio)
popular_n = n - content_n

content_recs = self.content_model.recommend(interactions, content_n)
popular_recs = self.popularity_model.get_global_popular(popular_n)

# 중복 제거 후 합치기
all_recs = content_recs + [
r for r in popular_recs if r not in content_recs
]
return all_recs[:n]

def _mature_user_recommend(self, user_id, n):
"""충분한 데이터: 협업 필터링"""
# 실제 CF 모델 호출
return [f"cf_item_{i}" for i in range(n)]

def _get_user_segment(self, profile):
"""사용자 프로필로 세그먼트 분류"""
age = profile.get('age', 25)
gender = profile.get('gender', 'unknown')

if age < 25:
return f"young_{gender}"
elif age < 40:
return f"mid_{gender}"
else:
return f"senior_{gender}"
⏱️ 실시간 vs 배치 추천 전략
추천 시스템을 운영할 때 언제 추천을 계산하느냐가 성능과 비용에 큰 영향을 미쳐. 크게 두 가지 방식이 있어:
배치 추천 (Batch Recommendation)
주기적으로(매일, 매시간) 미리 추천을 계산해두고 캐시에 저장하는 방식
✅ 장점: 빠른 응답 속도, 서버 부하 낮음, 복잡한 모델 사용 가능
❌ 단점: 실시간 행동 반영 안 됨, 저장 공간 필요
적합한 경우: 메인 페이지 추천, 이메일 추천, 주간 추천
실시간 추천 (Real-time Recommendation)
사용자의 현재 행동을 즉시 반영해서 추천을 생성하는 방식
✅ 장점: 최신 행동 즉시 반영, 개인화 수준 높음
❌ 단점: 높은 서버 부하, 복잡한 인프라 필요
적합한 경우: 상품 상세 페이지 유사 상품, 검색 결과 추천
# 배치 추천 생성 스크립트 (매일 새벽 실행)
# batch_recommend.py

import schedule
import time
import redis
import json
from datetime import datetime

redis_client = redis.Redis(host='localhost', port=6379, db=0)

def generate_batch_recommendations():
"""전체 활성 사용자에 대한 추천 사전 계산"""
print(f"[{datetime.now()}] 배치 추천 생성 시작...")

# 활성 사용자 목록 조회 (최근 30일 내 접속)
active_users = get_active_users()

# 모델 로드
model = load_recommendation_model()

batch_size = 1000
for i in range(0, len(active_users), batch_size):
batch_users = active_users[i:i+batch_size]

# 배치로 추천 생성
recommendations = model.batch_predict(batch_users, n=20)

# Redis에 저장 (24시간 TTL)
pipeline = redis_client.pipeline()
for user_id, recs in zip(batch_users, recommendations):
key = f"batch_rec:{user_id}"
pipeline.setex(key, 86400, json.dumps(recs))
pipeline.execute()

print(f"  처리 완료: {i+len(batch_users)}/{len(active_users)} 사용자")

print(f"[{datetime.now()}] 배치 추천 생성 완료!")

def get_active_users():
"""최근 30일 활성 사용자 조회"""
# 실제로는 DB 쿼리
return list(range(10000))  # 예시

def load_recommendation_model():
"""학습된 모델 로드"""
# 실제로는 저장된 모델 파일 로드
pass

# 매일 새벽 2시에 실행
schedule.every().day.at("02:00").do(generate_batch_recommendations)

if __name__ == "__main__":
generate_batch_recommendations()  # 즉시 실행
while True:
schedule.run_pending()
time.sleep(60)
🌈 다양성 확보와 필터 버블 방지
추천 시스템의 어두운 면도 알아야 해 ㅋㅋㅋ 너무 정확한 추천만 하다 보면 필터 버블(Filter Bubble) 문제가 생겨. 사용자가 항상 비슷한 상품만 보게 되어서 새로운 발견의 기회가 없어지는 거야.
🎯 다양성 확보 기법들:
ε 확률로 랜덤 추천, (1-ε) 확률로 최적 추천
탐색(Exploration)과 활용(Exploitation)의 균형
관련성 높으면서도 이미 추천된 것과 다른 아이템 선택
다양성과 관련성의 균형
추천 목록에 여러 카테고리 상품이 포함되도록 제약
예: 같은 카테고리 최대 3개까지만
신규 상품이나 비인기 상품에 가산점 부여
롱테일 상품 발굴 기회 제공
def mmr_rerank(candidates, query_embedding, item_embeddings,
lambda_param=0.5, n=10):
"""
MMR (Maximal Marginal Relevance) 재랭킹
관련성과 다양성의 균형을 맞춤

lambda_param: 0이면 최대 다양성, 1이면 최대 관련성
"""
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np

selected = []
remaining = candidates.copy()

while len(selected) < n and remaining:
if not selected:
# 첫 번째: 가장 관련성 높은 아이템 선택
scores = cosine_similarity(
[query_embedding],
[item_embeddings[i] for i in remaining]
)[0]
best_idx = remaining[np.argmax(scores)]
else:
# 이후: MMR 점수로 선택
mmr_scores = []
for item in remaining:
# 쿼리와의 관련성
relevance = cosine_similarity(
[query_embedding], [item_embeddings[item]]
)[0][0]

# 이미 선택된 아이템들과의 최대 유사도
if selected:
similarities = cosine_similarity(
[item_embeddings[item]],
[item_embeddings[s] for s in selected]
)[0]
max_sim = max(similarities)
else:
max_sim = 0

# MMR 점수: 관련성 - 다양성 패널티
mmr = lambda_param * relevance - (1 - lambda_param) * max_sim
mmr_scores.append(mmr)

best_idx = remaining[np.argmax(mmr_scores)]

selected.append(best_idx)
remaining.remove(best_idx)

return selected

def add_diversity_constraint(recommendations, item_categories, max_per_category=3):
"""카테고리 다양성 제약 추가"""
category_count = {}
diverse_recs = []

for item_id in recommendations:
category = item_categories.get(item_id, 'unknown')
count = category_count.get(category, 0)

if count < max_per_category:
diverse_recs.append(item_id)
category_count[category] = count + 1

return diverse_recs
🌟 실제 서비스 사례와 최신 트렌드
대형 플랫폼들의 추천 시스템
| 플랫폼 | 핵심 기술 | 특징 |
|---|---|---|
| 아마존 | Item-to-Item CF + DNN | "이 상품을 산 사람들이 함께 산 상품" 원조 |
| 넷플릭스 | Matrix Factorization + 딥러닝 | 썸네일 개인화까지 추천 시스템으로 처리 |
| 유튜브 | Two-Tower DNN + Transformer | 수십억 개 영상 중 실시간 추천 |
| 쿠팡 | 하이브리드 + 실시간 재랭킹 | 로켓배송 가능 상품 우선 노출 결합 |
| 무신사 | 패션 특화 임베딩 + CF | 스타일 코디 기반 추천 |
2024-2025 최신 트렌드
GPT, LLaMA 같은 대형 언어 모델을 추천에 활용. 자연어로 "여름에 입기 좋은 시원한 원피스 추천해줘" 같은 대화형 추천이 가능해짐 🔥
사용자-아이템 관계를 그래프로 모델링. 간접적인 연결 관계까지 학습 가능 (A가 B를 샀고, B가 C를 샀으면 A에게 C 추천)
텍스트 + 이미지 + 영상을 함께 활용. 상품 이미지를 보고 비슷한 스타일 추천하는 "비주얼 서치" 기능
장기적인 사용자 만족도를 최적화. 단기 클릭이 아닌 장기 구매 패턴을 학습
연합 학습(Federated Learning)으로 개인 데이터를 서버에 올리지 않고 추천 모델 학습. GDPR 대응에 필수
🛠️ 개발 환경 세팅 가이드
자 이제 실제로 시작하려는 사람들을 위한 환경 세팅 가이드야. 처음 시작할 때 뭘 설치해야 하는지 헷갈리잖아 ㅋㅋㅋ
# 1. 가상환경 생성
python -m venv rec_env
source rec_env/bin/activate  # Windows: rec_env\Scripts\activate

# 2. 핵심 라이브러리 설치
pip install numpy pandas scikit-learn

# 3. 추천 시스템 특화 라이브러리
pip install surprise          # 협업 필터링
pip install implicit          # 암묵적 피드백 CF
pip install lightfm           # 하이브리드 추천

# 4. 딥러닝 프레임워크
pip install tensorflow        # 또는 torch
pip install tensorflow-recommenders  # 구글 추천 프레임워크

# 5. NLP/임베딩
pip install sentence-transformers  # BERT 기반 임베딩
pip install gensim               # Word2Vec

# 6. API 서버
pip install fastapi uvicorn
pip install redis

# 7. 데이터 처리
pip install scipy               # 희소 행렬 처리
pip install faiss-cpu           # 빠른 유사도 검색 (GPU: faiss-gpu)

# 8. 실험 관리
pip install mlflow              # 모델 버전 관리
pip install wandb               # 학습 모니터링

# requirements.txt 생성
pip freeze > requirements.txt
# 프로젝트 구조 예시
recommendation_system/
├── data/
│   ├── raw/              # 원본 데이터
│   ├── processed/        # 전처리된 데이터
│   └── embeddings/       # 사전 계산된 임베딩
├── models/
│   ├── collaborative/    # 협업 필터링 모델
│   ├── content_based/    # 콘텐츠 기반 모델
│   ├── deep_learning/    # 딥러닝 모델
│   └── hybrid/           # 하이브리드 모델
├── api/
│   ├── main.py           # FastAPI 앱
│   ├── routers/          # API 라우터
│   └── schemas/          # Pydantic 스키마
├── training/
│   ├── train_cf.py       # CF 학습 스크립트
│   ├── train_ncf.py      # NCF 학습 스크립트
│   └── evaluate.py       # 평가 스크립트
├── batch/
│   ├── batch_recommend.py  # 배치 추천 생성
│   └── feature_pipeline.py # 피처 파이프라인
├── tests/
│   └── test_recommend.py
├── docker-compose.yml    # Redis, API 서버 등
└── requirements.txt
# docker-compose.yml - 개발 환경
version: '3.8'
services:
redis:
image: redis:7-alpine
ports:
- "6379:6379"
volumes:
- redis_data:/data

api:
build: .
ports:
- "8000:8000"
environment:
- REDIS_HOST=redis
- REDIS_PORT=6379
depends_on:
- redis
volumes:
- ./models:/app/models
command: uvicorn api.main:app --host 0.0.0.0 --port 8000 --reload

jupyter:
image: jupyter/scipy-notebook
ports:
- "8888:8888"
volumes:
- ./:/home/jovyan/work

volumes:
redis_data:
🎯 마무리: 추천 시스템 개발 로드맵
와 여기까지 왔으면 진짜 대단한 거야 ㅋㅋㅋ 추천 시스템은 처음에는 복잡해 보이지만, 단계별로 접근하면 충분히 구현할 수 있어. 마지막으로 단계별 로드맵을 정리해줄게!
• 협업 필터링 기본 구현 (User-Based, Item-Based)
• surprise 라이브러리로 SVD 실습
• 기본 평가 지표 이해 (Precision@K, Recall@K)
• Matrix Factorization 직접 구현
• TF-IDF + 코사인 유사도 콘텐츠 기반 구현
• FastAPI로 추천 API 서버 구축
• Redis 캐싱 적용
• NCF, SASRec 등 딥러닝 모델 구현
• 하이브리드 추천 시스템 설계
• A/B 테스트 프레임워크 구축
• 실시간 추천 파이프라인 구축
• LLM 기반 대화형 추천
• GNN 기반 추천 시스템
• 강화학습 적용
• 대규모 분산 시스템 설계
추천 시스템은 데이터 사이언스, 머신러닝, 백엔드 개발, 인프라 엔지니어링이 모두 결합된 종합 예술이야. 어렵지만 그만큼 배울 게 많고, 실제 비즈니스 임팩트도 엄청나게 크지. 이 글이 너의 추천 시스템 개발 여정에 도움이 됐으면 좋겠어! 화이팅 🔥

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.



아직 댓글이 없습니다.