
Ver3.5 고객문의 → AI 자동분류 → 담당자 배정 시스템완전 정복 가이드
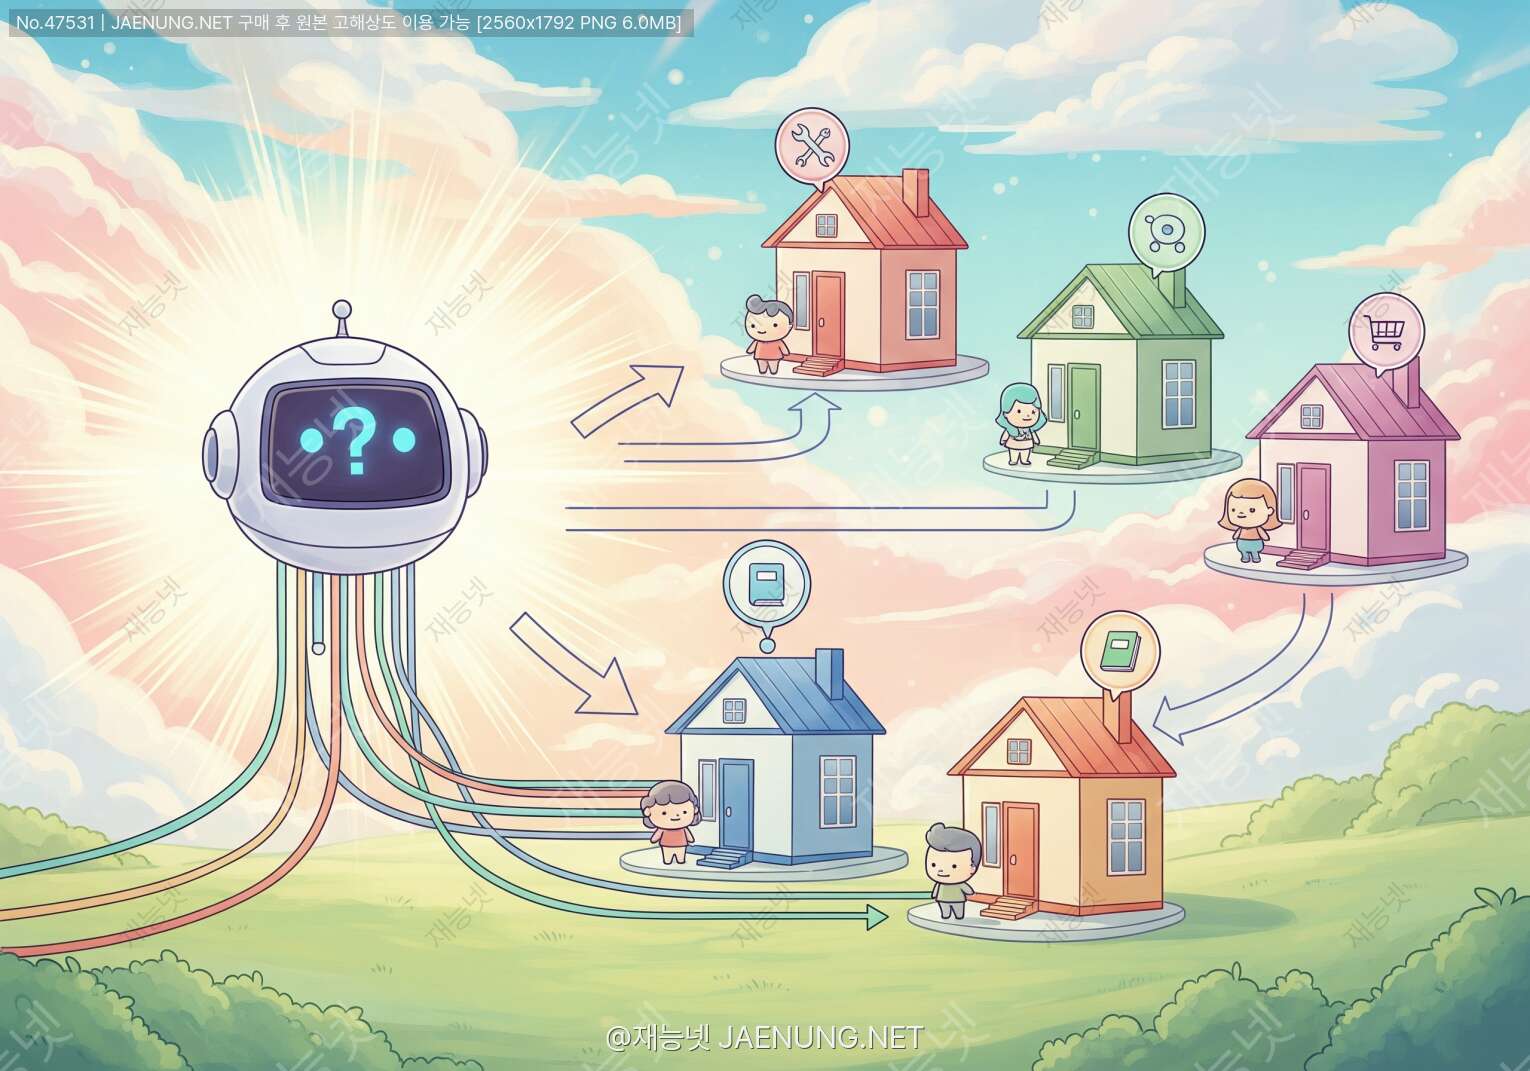
고객문의 → AI 자동분류 → 담당자 배정 시스템
완전 정복 가이드
야 솔직히 말해서, 고객센터 담당자들 진짜 힘들잖아ㅋㅋㅋ
하루에 수백 개씩 쏟아지는 문의들... "환불해주세요", "배송이 왜 이래요", "비밀번호 찾고 싶어요", "이거 버그 아닌가요?" 이런 거 일일이 읽고 분류하고 적절한 담당자한테 넘기는 게 얼마나 노가다인지 😅
근데 이제 그 노가다를 AI가 대신 해주는 시대가 왔음.
고객문의 → AI 자동분류 → 담당자 배정 이 세 단계를 자동화하면, CS팀이 진짜 중요한 일에만 집중할 수 있게 됨.
이 글에서는 이 시스템이 어떻게 작동하는지, 어떤 기술이 쓰이는지, 실제로 어떻게 구현하는지까지 팩트 기반으로 빡세게 파헤쳐볼 거임.
개발자든, 기획자든, CS 매니저든 다 읽어봐야 함 진짜로.
🤔 근데 이게 왜 필요함? 배경부터 이해하자
일단 현실 직시부터 해보자.
중소기업 기준으로 하루 CS 문의가 200~500건이라고 치면, 담당자가 이걸 수동으로 분류하는 데만 하루 2~3시간이 날아감.
대기업이나 이커머스 플랫폼은 하루 수만 건이 들어오는데, 이걸 사람이 다 처리한다? 불가능하지 ㅋㅋㅋ
이런 문제들을 AI 자동화로 해결하면 어떻게 되냐고?
분류 정확도 90%+, 응답 시간 수 초 이내, 24/7 무중단 운영 이게 가능해짐.
실제로 Zendesk, Freshdesk, Salesforce Service Cloud 같은 글로벌 CS 플랫폼들이 이미 AI 자동분류를 핵심 기능으로 탑재하고 있고,
국내에서도 카카오, 네이버, 쿠팡 등 대형 플랫폼들이 자체 AI CS 시스템을 운영 중임.
🏗️ 시스템 전체 아키텍처 뜯어보기
자, 이제 본격적으로 시스템이 어떻게 생겼는지 봐보자.
크게 5개 레이어로 나눌 수 있음.
고객 문의가 들어오는 모든 채널을 통합. 이메일, 웹 채팅, 앱 내 문의, 소셜미디어 DM, 전화 STT 변환 텍스트 등.
텍스트 정제, 노이즈 제거, 언어 감지, 토크나이징, 임베딩 변환 등.
NLP 모델 또는 LLM이 카테고리, 우선순위, 감정(sentiment), 긴급도 등을 판단.
분류 결과를 바탕으로 담당자/팀 배정 로직 실행. 스킬 매칭, 부하 분산, 우선순위 큐 관리.
분류 정확도 추적, 담당자 피드백 수집, 모델 재학습 파이프라인.
📐 기술 스택 선택지
AWS Comprehend Google Cloud NL API Azure Text Analytics OpenAI GPT API
장점: 빠른 구축, 관리 부담 없음
단점: 비용, 데이터 외부 전송 이슈
KoBERT KLUE-RoBERTa LLaMA 파인튜닝 Hugging Face
장점: 데이터 보안, 커스터마이징
단점: 구축 비용, 전문 인력 필요
🔧 1단계: 텍스트 전처리 — 이게 제일 중요함
AI 모델이 아무리 좋아도 입력 데이터가 쓰레기면 결과도 쓰레기임.
이걸 GIGO (Garbage In, Garbage Out) 원칙이라고 하는데, 전처리가 전체 시스템 성능의 40~50%를 좌우한다고 봐도 과언이 아님.
실제 고객 문의 텍스트가 어떻게 생겼는지 보면...
이렇게 날 것의 텍스트를 AI가 처리할 수 있는 형태로 바꿔주는 게 전처리임.
주요 전처리 단계를 하나씩 보자.
🧹 텍스트 정제 (Text Cleaning)
특수문자 처리: "ㅡㅡ", "ㅠㅠ", "!!", "??" 같은 감정 표현 문자들은 제거하거나 감정 레이블로 변환.
HTML/마크업 제거: 웹 폼에서 들어오는 HTML 태그 제거.
URL/이메일 정규화: 링크나 이메일 주소를 [URL], [EMAIL] 토큰으로 대체.
반복 문자 처리: "진짜진짜진짜" → "진짜" (강조 의미는 별도 피처로 추출).
맞춤법 교정: 오타가 많은 경우 Hunspell, py-hanspell 등 활용.
🔒 개인정보 마스킹 (PII Masking)
이거 진짜 중요함. GDPR, 개인정보보호법 때문에 AI 모델에 개인정보 그대로 넣으면 안 됨.
마스킹 대상:
- 전화번호: 010-1234-5678 → [PHONE]
- 이메일: user@example.com → [EMAIL]
- 주민번호: 901231-1234567 → [SSN]
- 주문번호/계좌번호: 별도 메타데이터로 분리 저장
- 이름: 정규식 + NER(개체명 인식) 모델 조합으로 감지
구현 방법: 정규식(Regex) + NER 모델 조합이 가장 효과적. 한국어는 KoNLP, KLUE-NER 모델 활용.
🔤 한국어 토크나이징 (Tokenization)
한국어는 영어랑 달리 형태소 분석이 필요함. 이게 한국어 NLP의 핵심 난이도임ㅋㅋㅋ
주요 형태소 분석기:
- KoNLPy: Okt, Komoran, Hannanum, Kkma, Mecab 포함. 가장 많이 쓰임.
- Mecab-ko: 속도 최고. 대용량 처리에 적합.
- Kiwi: 최근 성능 좋아서 인기 상승 중.
예시: "배송이 늦어요" → ["배송", "이", "늦", "어요"] (Mecab 기준)
근데 요즘은 BERT 계열 모델들이 자체 서브워드 토크나이저(WordPiece, BPE)를 쓰기 때문에 형태소 분석기 없이도 잘 작동함.
📊 메타데이터 추출
텍스트 내용 외에도 분류에 도움이 되는 메타데이터를 추출해야 함:
- 문의 채널: 이메일 vs 채팅 vs 앱 (채널별 특성 다름)
- 문의 시간: 업무시간 외 문의는 자동 응답 처리
- 고객 등급: VIP 고객은 우선 배정
- 이전 문의 이력: 반복 문의 여부, 이전 담당자 정보
- 첨부파일 유무: 스크린샷 있으면 기술 문의일 가능성 높음
- 문의 길이: 짧은 문의 vs 긴 문의 (복잡도 예측)
# Python 전처리 파이프라인 예시
import re
from konlpy.tag import Mecab

class CSTextPreprocessor:
def __init__(self):
self.mecab = Mecab()

def clean_text(self, text: str) -> str:
# HTML 태그 제거
text = re.sub(r'<[^>]+>', '', text)
# URL 마스킹
text = re.sub(r'https?://\S+', '[URL]', text)
# 전화번호 마스킹
text = re.sub(r'01[0-9]-?\d{3,4}-?\d{4}', '[PHONE]', text)
# 이메일 마스킹
text = re.sub(r'\S+@\S+\.\S+', '[EMAIL]', text)
# 반복 문자 정규화 (3회 이상 → 2회)
text = re.sub(r'(.)\1{2,}', r'\1\1', text)
return text.strip()

def extract_metadata(self, raw_data: dict) -> dict:
return {
'channel': raw_data.get('channel', 'unknown'),
'customer_tier': raw_data.get('customer_tier', 'normal'),
'has_attachment': bool(raw_data.get('attachments')),
'text_length': len(raw_data.get('text', '')),
'hour_of_day': raw_data.get('timestamp').hour
}

def preprocess(self, raw_data: dict) -> dict:
cleaned = self.clean_text(raw_data['text'])
metadata = self.extract_metadata(raw_data)
return {
'cleaned_text': cleaned,
'metadata': metadata,
'original_id': raw_data['id']
}
🤖 2단계: AI 분류 모델 — 뭘 써야 함?
이제 진짜 핵심임. AI가 텍스트를 읽고 "이건 배송 문의네", "이건 긴급이네", "이 고객 엄청 화났네" 이런 걸 판단하는 부분.
크게 3가지 접근법이 있음.
TF-IDF + SVM/Random Forest
✅ 빠름, 가벼움
✅ 해석 가능
❌ 성능 한계
❌ 피처 엔지니어링 필요
BERT/RoBERTa 파인튜닝
✅ 높은 정확도
✅ 문맥 이해
❌ 학습 데이터 필요
❌ 추론 속도 느림
GPT-4/Claude/Gemini
✅ 제로샷 가능
✅ 복잡한 케이스 처리
❌ 비용 높음
❌ 레이턴시 이슈
🏆 현업에서 가장 많이 쓰는 조합
실제 프로덕션 환경에서는 하이브리드 접근법이 대세임:
1차 분류 (빠른 처리): 파인튜닝된 BERT 계열 모델 (KoBERT, KLUE-RoBERTa)
→ 신뢰도 0.85 이상이면 자동 처리
2차 분류 (애매한 케이스): LLM (GPT-4, Claude) 호출
→ 신뢰도 0.85 미만인 케이스만 처리 (비용 절감)
3차 (최후 수단): 사람이 직접 분류
→ LLM도 확신 못하는 케이스
📌 KLUE-RoBERTa 파인튜닝 예시 (실제 코드)
from transformers import AutoTokenizer, AutoModelForSequenceClassification
from transformers import TrainingArguments, Trainer
import torch

# 카테고리 정의
CATEGORIES = [
"배송_물류", "결제_환불", "기술_버그",
"계정_보안", "상품_문의", "일반_문의", "기타"
]

class CSClassifier:
def __init__(self, model_name="klue/roberta-base"):
self.tokenizer = AutoTokenizer.from_pretrained(model_name)
self.model = AutoModelForSequenceClassification.from_pretrained(
model_name,
num_labels=len(CATEGORIES)
)
self.categories = CATEGORIES

def predict(self, text: str) -> dict:
inputs = self.tokenizer(
text,
return_tensors="pt",
max_length=512,
truncation=True,
padding=True
)

with torch.no_grad():
outputs = self.model(**inputs)
probs = torch.softmax(outputs.logits, dim=-1)

pred_idx = probs.argmax().item()
confidence = probs[0][pred_idx].item()

return {
"category": self.categories[pred_idx],
"confidence": confidence,
"all_probs": {
cat: probs[0][i].item()
for i, cat in enumerate(self.categories)
}
}

def predict_with_fallback(self, text: str, threshold=0.85) -> dict:
result = self.predict(text)

if result["confidence"] < threshold:
# LLM 폴백 호출
result["needs_llm_review"] = True
else:
result["needs_llm_review"] = False

return result
🎯 LLM 프롬프트 엔지니어링 (GPT-4 활용)
LLM을 분류기로 쓸 때는 프롬프트 설계가 핵심임. 아래가 실제 프로덕션에서 쓰는 수준의 프롬프트 구조임:
CLASSIFICATION_PROMPT = """
당신은 고객 문의를 분류하는 전문 AI입니다.
다음 고객 문의를 분석하여 JSON 형식으로 응답하세요.

[분류 카테고리]
- 배송_물류: 배송 지연, 배송지 변경, 반품 수거 등
- 결제_환불: 결제 오류, 환불 요청, 취소 요청 등
- 기술_버그: 앱/웹 오류, 기능 이상, 로딩 문제 등
- 계정_보안: 로그인 불가, 비밀번호 찾기, 계정 도용 등
- 상품_문의: 상품 정보, 재고, 사이즈 등
- 일반_문의: 영업시간, 이용방법 등
- 기타: 위 카테고리에 해당하지 않는 경우

[고객 문의]
{customer_message}

[응답 형식]
{
"category": "카테고리명",
"priority": "긴급|높음|보통|낮음",
"sentiment": "매우부정|부정|중립|긍정",
"intent": "문의|불만|요청|취소|기타",
"summary": "문의 내용 한 줄 요약",
"confidence": 0.0~1.0,
"reasoning": "분류 근거 설명"
}
"""
response_format={"type": "json_object"} 옵션(OpenAI) 또는 Pydantic 스키마 검증을 반드시 추가해야 함. 프로덕션에서 파싱 에러로 시스템 다운되는 거 진짜 흔한 실수임 ㅋㅋㅋ
⚡ 우선순위 자동 판단 — 이게 진짜 돈 되는 기능
카테고리 분류만큼이나 중요한 게 우선순위 자동 판단임.
"환불해주세요"랑 "환불 안 해주면 소비자원 신고하고 SNS에 올릴 거예요"는 같은 환불 문의지만 완전히 다른 우선순위임ㅋㅋㅋ
단순 부정 vs 극도로 화난 상태. "불편했어요" vs "진짜 최악이에요 고소할 거예요" — 이 차이를 AI가 감지해야 함.
"소비자원", "공정위", "법적 조치", "변호사", "신고" 등의 키워드가 포함되면 자동으로 긴급 처리.
"SNS에 올릴 거예요", "유튜브에 올리겠습니다", "커뮤니티에 공유" 등 — 브랜드 리스크 감지.
VIP 고객, 장기 고객, 반복 문의 고객은 우선 처리. CRM 데이터와 연동 필수.
고액 결제 관련 문의는 자동으로 우선순위 상향. "500만원 결제했는데" vs "3,000원 결제했는데" — 다르게 처리해야 함.
👤 3단계: 담당자 자동 배정 — 알고리즘이 핵심
분류가 끝났으면 이제 "누구한테 줄 것인가"를 결정해야 함.
이게 단순히 "배송 문의 → 물류팀"으로 끝나는 게 아님.
물류팀 안에도 여러 담당자가 있고, 각자 현재 처리 중인 건수도 다르고, 전문 분야도 다르고, 근무 중인지 아닌지도 다름.
이걸 최적화하는 게 라우팅 알고리즘임.
🎯 라우팅 알고리즘 종류
가장 단순한 방식. 담당자들에게 순서대로 배정. 구현 쉽고 공평하지만, 담당자 역량 차이나 현재 부하를 고려 못 함.
현재 처리 중인 티켓이 가장 적은 담당자에게 배정. 부하 분산에 효과적. 실시간 담당자 상태 모니터링 필요.
담당자별 전문 스킬 태그를 관리하고, 문의 카테고리와 매칭. 예: "영어 가능 + 결제 전문 + VIP 담당" 이런 식으로.
과거 데이터를 학습해서 "이 유형의 문의를 A 담당자가 처리했을 때 해결률과 만족도가 가장 높다"를 예측. 가장 고도화된 방식.
같은 고객의 반복 문의는 이전 담당자에게 우선 배정. 고객 경험 향상에 효과적.
# 스킬 기반 + 최소 부하 하이브리드 라우팅 예시
from dataclasses import dataclass
from typing import List, Optional
import heapq

@dataclass
class Agent:
id: str
name: str
skills: List[str]          # ["배송_물류", "결제_환불"]
current_load: int          # 현재 처리 중인 티켓 수
max_capacity: int          # 최대 처리 가능 티켓 수
is_available: bool         # 근무 중 여부
performance_score: float   # 과거 성과 점수 (0.0~1.0)
tier: str                  # "junior" | "senior" | "expert"

class SmartRouter:
def __init__(self, agents: List[Agent]):
self.agents = agents

def find_best_agent(
self,
category: str,
priority: str,
customer_tier: str = "normal",
previous_agent_id: Optional[str] = None
) -> Optional[Agent]:

# 1. 가용 담당자 필터링
available = [
a for a in self.agents
if a.is_available and a.current_load < a.max_capacity
]

if not available:
return None  # 에스컬레이션 처리

# 2. 스킬 매칭
skilled = [a for a in available if category in a.skills]
candidates = skilled if skilled else available

# 3. 우선순위별 담당자 티어 필터
if priority == "긴급" or customer_tier == "VIP":
senior_candidates = [
a for a in candidates
if a.tier in ["senior", "expert"]
]
if senior_candidates:
candidates = senior_candidates

# 4. Sticky Assignment 체크
if previous_agent_id:
prev_agent = next(
(a for a in candidates if a.id == previous_agent_id),
None
)
if prev_agent:
return prev_agent

# 5. 스코어 계산 (부하 + 성과 점수 종합)
def score(agent: Agent) -> float:
load_ratio = agent.current_load / agent.max_capacity
return agent.performance_score * (1 - load_ratio * 0.5)

return max(candidates, key=score)

def assign_ticket(self, ticket: dict) -> dict:
agent = self.find_best_agent(
category=ticket["category"],
priority=ticket["priority"],
customer_tier=ticket.get("customer_tier", "normal"),
previous_agent_id=ticket.get("previous_agent_id")
)

if agent:
agent.current_load += 1
return {
"ticket_id": ticket["id"],
"assigned_to": agent.id,
"agent_name": agent.name,
"status": "assigned",
"sla_deadline": self._calculate_sla(ticket["priority"])
}
else:
return {
"ticket_id": ticket["id"],
"status": "queued",
"reason": "no_available_agent"
}

def _calculate_sla(self, priority: str) -> int:
# SLA 기준 시간 (분)
sla_map = {
"긴급": 30,
"높음": 120,
"보통": 480,
"낮음": 1440
}
return sla_map.get(priority, 480)
⏰ SLA (Service Level Agreement) 관리
담당자 배정 후에는 SLA 타이머가 시작됨.
일반적인 SLA 기준:
- 긴급: 30분 이내 첫 응답
- 높음: 2시간 이내
- 보통: 8시간 이내 (영업시간 기준)
- 낮음: 24시간 이내
SLA 위반 임박 시 자동 알림 → 에스컬레이션 → 상위 담당자 배정 이런 흐름이 자동으로 돌아가야 함.
이걸 자동 에스컬레이션 (Auto-Escalation)이라고 함.
🛠️ 실제 구현 — 처음부터 만들 때 vs 솔루션 활용
자, 이제 "그래서 어떻게 만들어요?"에 대한 답을 해보자.
크게 두 가지 선택지가 있음: 직접 개발 vs 기존 솔루션 활용.
🔨 직접 개발 (Custom Build)
언제 선택? 특수한 도메인, 높은 보안 요구사항, 기존 시스템과 깊은 통합이 필요할 때.
필요한 기술 스택:
Python (FastAPI/Django)
Node.js (Express)
Redis (큐 관리)
PostgreSQL/MongoDB
Celery (비동기 처리)
Hugging Face Transformers
OpenAI API
LangChain
MLflow (모델 관리)
Weights & Biases
🚀 기존 솔루션 활용 (SaaS/플랫폼)
언제 선택? 빠른 도입, 소규모 팀, 검증된 솔루션이 필요할 때.
주요 솔루션들:
| 솔루션 | 특징 | AI 기능 |
|---|---|---|
| Zendesk | 글로벌 1위 CS 플랫폼 | AI 자동 태깅, 스마트 라우팅 |
| Freshdesk | 가성비 좋음 | Freddy AI 자동분류 |
| Intercom | 채팅 특화 | Fin AI 에이전트 |
| Salesforce SC | 엔터프라이즈 | Einstein AI 분류 |
| 카카오 i 상담 | 국내 특화 | 한국어 AI 분류 |
🔗 API 연동 아키텍처 (Webhook 기반)
기존 CS 솔루션에 AI 분류를 붙이는 가장 현실적인 방법은 Webhook + API 연동임:
# FastAPI 기반 AI 분류 서버 예시
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import asyncio

app = FastAPI()

class TicketWebhook(BaseModel):
ticket_id: str
subject: str
body: str
customer_email: str
channel: str
created_at: str

class ClassificationResult(BaseModel):
ticket_id: str
category: str
priority: str
sentiment: str
assigned_agent_id: str
confidence: float

# 전역 컴포넌트 초기화
preprocessor = CSTextPreprocessor()
classifier = CSClassifier()
router = SmartRouter(agents=load_agents_from_db())

@app.post("/webhook/new-ticket", response_model=ClassificationResult)
async def process_new_ticket(ticket: TicketWebhook):
try:
# 1. 전처리
processed = preprocessor.preprocess({
"text": f"{ticket.subject}\n{ticket.body}",
"channel": ticket.channel,
"id": ticket.ticket_id
})

# 2. AI 분류
classification = classifier.predict_with_fallback(
processed["cleaned_text"]
)

# 3. LLM 폴백 (필요시)
if classification.get("needs_llm_review"):
classification = await llm_classify(processed["cleaned_text"])

# 4. 담당자 배정
assignment = router.assign_ticket({
"id": ticket.ticket_id,
"category": classification["category"],
"priority": classification["priority"],
"customer_tier": get_customer_tier(ticket.customer_email)
})

# 5. CS 플랫폼에 결과 업데이트 (Zendesk API 등)
await update_ticket_in_platform(
ticket_id=ticket.ticket_id,
classification=classification,
assignment=assignment
)

return ClassificationResult(
ticket_id=ticket.ticket_id,
category=classification["category"],
priority=classification["priority"],
sentiment=classification["sentiment"],
assigned_agent_id=assignment.get("assigned_to", "queue"),
confidence=classification["confidence"]
)

except Exception as e:
raise HTTPException(status_code=500, detail=str(e))

@app.get("/health")
async def health_check():
return {"status": "ok", "model_loaded": True}
📚 학습 데이터 구축 — 이게 제일 힘든 부분임ㅋㅋㅋ
AI 모델을 파인튜닝하려면 레이블링된 학습 데이터가 필요함.
"이 문의는 배송 문의입니다" 이런 식으로 사람이 직접 태깅한 데이터.
이게 없으면 모델 성능이 안 나옴. 근데 이걸 모으는 게 진짜 노가다임 ㅠㅠ
📊 필요한 데이터 양 (경험적 기준)
| 목표 정확도 | 카테고리당 최소 샘플 | 총 데이터 규모 |
|---|---|---|
| 70~80% | 100~200개 | 700~1,400개 |
| 80~90% | 500~1,000개 | 3,500~7,000개 |
| 90%+ | 2,000개 이상 | 14,000개 이상 |
물론 이건 도메인 복잡도, 카테고리 수, 모델 크기에 따라 크게 달라짐.
LLM 기반이면 훨씬 적은 데이터로도 괜찮은 성능 나옴 (Few-shot learning).
🤖 데이터 부족할 때 해결책
GPT-4한테 "배송 지연 관련 고객 문의 100개 만들어줘" 하면 됨. 실제로 많이 씀. 단, 실제 데이터와 분포 차이가 있을 수 있음.
기존 데이터를 변형해서 늘리는 방법. 동의어 치환, 역번역(한국어→영어→한국어), 문장 순서 변경 등.
모델이 확신 못하는 케이스만 사람이 레이블링. 효율적인 데이터 수집 방법. 초기 소량 데이터로 시작해서 점진적으로 개선.
학습 데이터 없이 LLM 프롬프트만으로 분류. 초기 도입 시 유용. 성능이 어느 정도 나오면 그 결과로 파인튜닝 데이터 구축.
📊 모니터링 & 지속적 개선 — 배포가 끝이 아님
AI 시스템은 배포하고 끝이 아님. 오히려 배포 후가 더 중요함.
모델 드리프트(Model Drift)라는 현상이 있는데, 시간이 지나면서 고객 문의 패턴이 바뀌면 모델 성능이 서서히 떨어짐.
예를 들어 새로운 서비스를 출시하면 그 관련 문의가 갑자기 늘어나는데, 기존 모델은 이걸 제대로 분류 못 함.
📈 핵심 모니터링 지표 (KPI)
| 지표 | 설명 | 목표값 |
|---|---|---|
| 분류 정확도 | AI 분류가 맞은 비율 | 90%+ |
| 신뢰도 분포 | 낮은 신뢰도 비율 추적 | 낮은 신뢰도 <10% |
| FRT (첫 응답 시간) | 배정 후 첫 응답까지 시간 | SLA 준수율 95%+ |
| CSAT | 고객 만족도 점수 | 4.0/5.0 이상 |
| 재배정률 | 잘못 배정되어 재배정된 비율 | 5% 이하 |
| 에스컬레이션율 | 상위 담당자로 에스컬레이션된 비율 | 10% 이하 |
🔄 피드백 루프 구축
담당자들이 AI 분류 결과를 수정할 때마다 그 데이터를 수집해야 함.
"AI가 이걸 배송 문의로 분류했는데 실제로는 결제 문의였다" → 이 케이스가 재학습 데이터가 됨.
피드백 수집 방법:
- 담당자 UI에 "분류 수정" 버튼 제공
- 수정 시 원래 분류 + 수정된 분류 + 수정 이유 저장
- 주기적으로 수집된 피드백으로 모델 재학습 (월 1회 또는 분기 1회)
- A/B 테스트로 새 모델 vs 기존 모델 성능 비교 후 배포
📈 실제 도입 효과 — 숫자로 보는 ROI
이론은 충분히 봤으니까 이제 "그래서 실제로 얼마나 좋아지냐"를 보자.
업계 리포트와 실제 케이스 스터디 기반 데이터임.
🏆 도입 전후 비교 (중견기업 기준)
| 지표 | 도입 전 | 도입 후 | 개선율 |
|---|---|---|---|
| 분류 소요 시간 | 평균 3~5분/건 | 2~5초/건 | 🔥 98% 감소 |
| 분류 정확도 | 70~80% | 88~95% | 📈 15~20% 향상 |
| 첫 응답 시간(FRT) | 평균 4.2시간 | 평균 1.1시간 | ⚡ 74% 감소 |
| 고객 만족도(CSAT) | 3.6/5.0 | 4.3/5.0 | 😊 19% 향상 |
| 담당자 생산성 | 일 30건 처리 | 일 45건 처리 | 💪 50% 향상 |
| 오배정 재처리 비용 | 전체의 20% | 전체의 4% | 💰 80% 감소 |
💰 비용 절감 계산 (예시)
가정: 하루 500건 문의, CS 담당자 10명, 평균 연봉 3,500만원
도입 전:
- 분류 작업: 500건 × 4분 = 2,000분 = 33시간/일
- 담당자 2명이 하루 종일 분류만 함
- 연간 인건비 낭비: 3,500만원 × 2명 = 7,000만원
도입 후:
- AI 분류 비용: 500건 × GPT-4 API 비용 ≈ 하루 약 5,000원
- 연간 AI 비용: 약 180만원 (서버 포함 500만원 내외)
- 절감액: 7,000만원 - 500만원 = 연간 6,500만원 절감
물론 초기 구축 비용(개발 + 데이터 구축)이 있지만, 보통 6~12개월 내 ROI 달성.
⚠️ 함정과 주의사항 — 이거 모르면 망함
AI 자동화 시스템 도입할 때 흔히 하는 실수들 정리해봄.
이거 진짜 중요함. 실제 프로젝트에서 이 실수들 때문에 시스템 전체를 다시 만드는 경우가 많음.
✅ 성공적인 도입을 위한 체크리스트
🔮 2025년 이후 트렌드 — 다음 단계는 뭐임?
지금까지 본 건 현재 기술 기준이고, 이 분야는 엄청나게 빠르게 발전하고 있음.
앞으로 어떤 방향으로 갈지 봐보자.
분류 + 배정에서 끝나는 게 아니라, AI가 직접 답변까지 생성하고 처리하는 방향으로 진화 중.
단순 문의(FAQ, 배송 조회 등)는 AI가 완전 자율 처리.
복잡한 케이스만 사람에게 넘기는 구조.
텍스트뿐만 아니라 이미지(스크린샷, 사진), 음성, 동영상까지 분석.
"앱이 이렇게 됐어요" + 스크린샷 → AI가 이미지 분석해서 버그 유형까지 자동 분류.
고객의 현재 세션 데이터(어떤 페이지에 있었는지, 어떤 버튼을 눌렀는지)와 문의를 연결해서 더 정확한 분류.
"결제 페이지에서 오류 발생 후 문의" → 자동으로 결제 버그로 분류.
문의가 들어오기 전에 문제를 예측해서 선제적으로 대응.
배송 지연 예측 → 고객이 문의하기 전에 먼저 알림 발송.
CS 문의 자체를 줄이는 방향.
🌟 LLM 기반 완전 자율 CS 에이전트
2024~2025년에 가장 핫한 트렌드는 Agentic AI임.
단순 분류기가 아니라, 도구(Tool)를 사용할 수 있는 AI 에이전트가 CS를 처리하는 방식.
예시 흐름:
1. 고객: "주문 #12345 환불해주세요"
2. AI 에이전트: 주문 조회 API 호출 → 주문 상태 확인
3. AI 에이전트: 환불 정책 DB 조회 → 환불 가능 여부 확인
4. AI 에이전트: 환불 처리 API 호출 → 자동 처리
5. AI 에이전트: 고객에게 처리 완료 메시지 발송
이 모든 게 사람 개입 없이 자동으로 처리됨.
Intercom의 Fin, Zendesk의 AI 에이전트, Salesforce Agentforce 등이 이 방향으로 가고 있음.
물론 아직은 단순 케이스에만 적용 가능하고, 복잡한 케이스는 여전히 사람이 필요함.
하지만 전체 CS 문의의 40~60%는 단순 반복 문의라는 점에서 엄청난 효율화가 가능함.
재능넷처럼 다양한 재능 거래가 이루어지는 플랫폼에서도 이런 AI CS 시스템은 점점 더 중요해지고 있음.
거래 관련 분쟁, 서비스 문의, 결제 이슈 등 다양한 유형의 문의를 효율적으로 처리하는 데 AI 자동분류 시스템이 핵심 역할을 하게 될 것임.
🎯 정리 — 이것만 기억해
엄청 길게 썼는데 핵심만 정리해보면:
텍스트 정제, PII 마스킹, 메타데이터 추출 — 이게 제대로 안 되면 아무리 좋은 모델도 소용없음.
BERT 파인튜닝 + LLM 폴백 조합. 비용과 성능의 균형점.
스킬 매칭 + 부하 분산 + Sticky Assignment 조합이 최적.
모델 드리프트, 피드백 루프, 재학습 파이프라인 — 이게 없으면 6개월 후 망함.
AI는 보조 도구. 낮은 신뢰도 케이스, 복잡한 케이스는 항상 사람이 처리하는 레이어 유지.
이 시스템을 처음부터 구축하는 게 부담스럽다면, Zendesk나 Freshdesk 같은 솔루션의 AI 기능을 먼저 써보고, 그 다음에 커스터마이징하는 방향으로 가는 게 현실적임.
그리고 AI 분류 모델 학습을 위한 데이터 레이블링이나 프롬프트 엔지니어링 작업이 필요하다면, 재능넷 같은 플랫폼에서 관련 전문가를 찾아보는 것도 좋은 방법임. 실제로 많은 스타트업들이 이런 방식으로 빠르게 AI CS 시스템을 구축하고 있음.
자, 이제 진짜 만들어볼 차례임 🚀

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.