
Ver3.5 AI 에이전트의 메모리 시스템 설계 원리
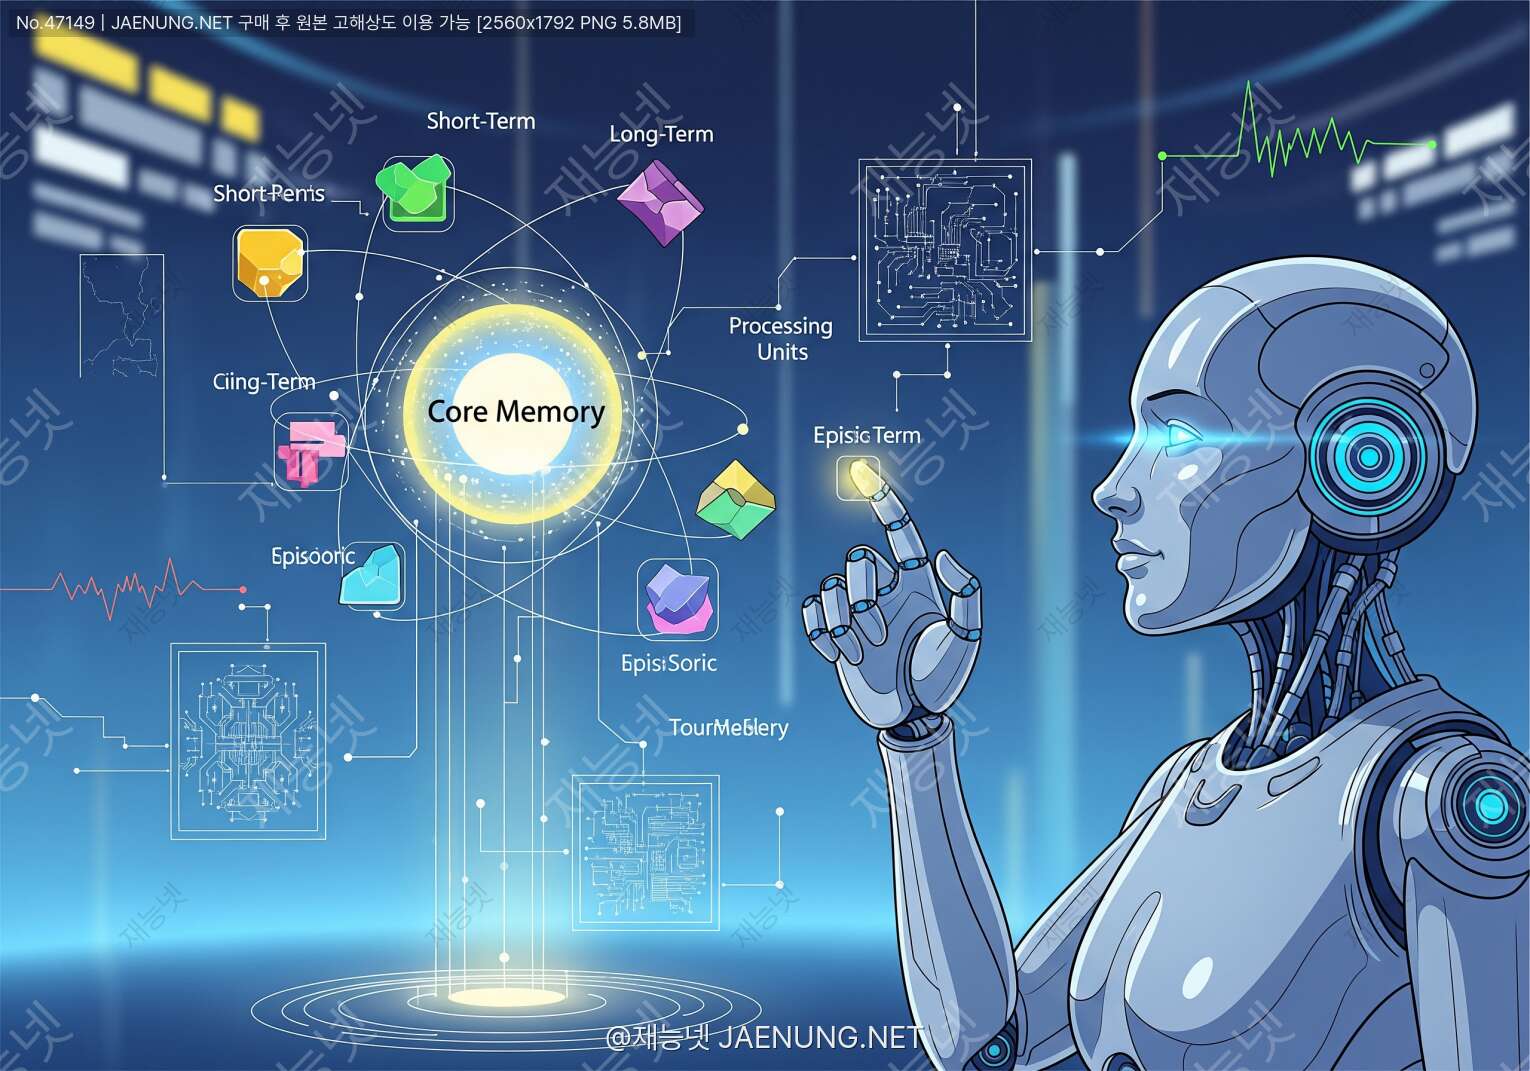
AI 에이전트의 메모리 시스템 설계 원리
야, 솔직히 말해봐. AI 챗봇이랑 대화하다가 이런 경험 해본 적 없어? 🤔
"아까 내가 말한 거 기억해?" 했더니 "죄송합니다, 이전 대화 내용을 기억하지 못합니다" 라고 답하는 그 순간의 허탈함.
아니면 반대로, 몇 달 전에 했던 대화를 AI가 정확히 기억하고 있어서 소름 돋았던 경험.
이 차이가 바로 메모리 시스템 설계에서 나와. 오늘은 AI 에이전트가 어떻게 기억을 저장하고, 꺼내 쓰고, 잊어버리는지 — 그 설계 원리를 완전히 파헤쳐볼 거야. 개발자든 AI에 관심 있는 사람이든, 이 글 읽고 나면 "아, 이래서 그랬구나!" 하는 순간이 분명히 올 거야. 💡
🧩 1. AI 에이전트에서 '메모리'란 무엇인가?
먼저 기본 개념부터 잡고 가자. AI 에이전트에서 메모리는 인간의 기억과 놀랍도록 비슷한 구조를 가지고 있어. 심리학에서 인간의 기억을 분류하는 방식 — 단기기억, 장기기억, 절차기억, 에피소딕 기억 — 이 개념들이 AI 시스템 설계에 그대로 차용되거든.
근데 왜 AI 에이전트에 메모리가 필요한 걸까? 🤔
LLM(대형 언어 모델) 자체는 사실 무상태(stateless)야. 매번 새로운 입력을 받으면 이전에 뭘 했는지 전혀 모르는 상태로 처리해. 마치 매번 기억을 잃는 영화 주인공처럼. 그래서 에이전트가 복잡한 작업을 수행하거나, 사용자와 지속적인 관계를 유지하거나, 여러 단계에 걸친 추론을 하려면 별도의 메모리 시스템이 반드시 필요해.
메모리 있음: "지난번에 파이썬 프로젝트 도와드렸는데, 그 프로젝트 잘 마무리되셨나요? 오늘은 어떤 부분이 막히셨어요?" → 맥락을 이해하는 진짜 어시스턴트
AI 에이전트 메모리 시스템의 핵심 기능은 크게 세 가지야:
1저장(Storage) — 정보를 어디에, 어떤 형태로 저장할 것인가
2검색(Retrieval) — 필요한 정보를 어떻게 빠르고 정확하게 꺼낼 것인가
3망각(Forgetting) — 어떤 정보를 언제 버릴 것인가 (이게 생각보다 엄청 중요해!)
🔬 2. 메모리의 4가지 유형 완전 해부
AI 에이전트 메모리는 크게 4가지 유형으로 나뉘어. 각각의 특성과 구현 방법이 완전히 달라서, 실제 시스템에서는 이것들을 조합해서 쓰는 게 일반적이야.
① 단기 메모리 (Short-term / Working Memory)
단기 메모리는 현재 진행 중인 대화나 작업의 컨텍스트를 담는 공간이야. 기술적으로는 LLM의 컨텍스트 윈도우(Context Window)가 바로 이 역할을 해.
GPT-4는 128K 토큰, Claude 3는 200K 토큰, Gemini 1.5 Pro는 무려 1M 토큰의 컨텍스트 윈도우를 가지고 있어. 이 안에 들어가는 모든 텍스트 — 시스템 프롬프트, 대화 히스토리, 현재 작업 상태 — 가 단기 메모리야.
- ✅ 접근 속도: 즉각적 (이미 컨텍스트 안에 있으니까)
- ✅ 정밀도: 매우 높음 (토큰 단위로 정확하게 처리)
- ❌ 용량: 제한적 (컨텍스트 윈도우 크기에 종속)
- ❌ 지속성: 없음 (세션 종료 시 사라짐)
- ❌ 비용: 토큰 수에 비례해서 API 비용 증가
단기 메모리 관리의 핵심 과제는 컨텍스트 압축(Context Compression)이야. 대화가 길어질수록 컨텍스트 윈도우가 꽉 차게 되는데, 이때 어떤 정보를 유지하고 어떤 정보를 버릴지 결정해야 해.
# 단기 메모리 관리 예시 (Python)
class ShortTermMemory:
    def __init__(self, max_tokens=4000):
        self.messages = []
        self.max_tokens = max_tokens

    def add_message(self, role, content):
        self.messages.append({"role": role, "content": content})
        # 토큰 초과 시 오래된 메시지 제거
        while self._count_tokens() > self.max_tokens:
            # 시스템 메시지는 유지, 가장 오래된 대화 제거
            if len(self.messages) > 1:
                self.messages.pop(1)

    def _count_tokens(self):
        # 간단한 토큰 추정 (실제로는 tiktoken 등 사용)
        return sum(len(m["content"].split()) * 1.3
                   for m in self.messages)
② 장기 메모리 (Long-term Memory)
장기 메모리는 세션을 넘어서 영구적으로 유지되는 정보야. 외부 데이터베이스에 저장되고, 필요할 때 검색해서 컨텍스트에 주입하는 방식으로 작동해.
장기 메모리의 핵심 기술은 벡터 데이터베이스(Vector Database)야. 텍스트를 고차원 벡터로 변환(임베딩)해서 저장하고, 의미적 유사성을 기반으로 검색하는 방식이지. 이게 뒤에서 자세히 다룰 핵심 내용이야.
③ 에피소딕 메모리 (Episodic Memory)
에피소딕 메모리는 특정 사건이나 경험의 시퀀스를 기록하는 메모리야. "언제, 어디서, 무슨 일이 있었는가"를 시간 순서대로 저장해.
AI 에이전트에서 에피소딕 메모리는 주로 작업 실행 로그나 사용자 상호작용 히스토리로 구현돼. 예를 들어 에이전트가 웹 검색을 했을 때 어떤 쿼리를 썼고, 어떤 결과를 얻었고, 그게 최종 답변에 어떻게 기여했는지를 기록하는 거야.
④ 시맨틱 메모리 (Semantic Memory)
시맨틱 메모리는 사실(facts), 개념(concepts), 그리고 그것들 간의 관계를 저장하는 메모리야. "파리는 프랑스의 수도다", "파이썬은 프로그래밍 언어다" 같은 일반적인 지식이 여기에 해당해.
AI 에이전트에서 시맨틱 메모리는 지식 그래프(Knowledge Graph)나 구조화된 데이터베이스로 구현되는 경우가 많아. 특히 특정 도메인에 특화된 에이전트를 만들 때 중요한 역할을 해.
| 메모리 유형 | 저장 위치 | 지속성 | 주요 용도 |
|---|---|---|---|
| 단기 메모리 | 컨텍스트 윈도우 | 세션 내 | 현재 대화 추적 |
| 장기 메모리 | 벡터 DB / RDB | 영구 | 사용자 선호도, 과거 정보 |
| 에피소딕 | 로그 DB | 영구 | 경험 학습, 실수 방지 |
| 시맨틱 | 지식 그래프 / DB | 영구 | 도메인 지식, 사실 관계 |
🗄️ 3. 벡터 데이터베이스 — 장기 메모리의 심장
자, 이제 진짜 핵심으로 들어가보자. AI 에이전트의 장기 메모리를 구현하는 데 있어서 벡터 데이터베이스(Vector Database)는 거의 필수 기술이 됐어. 왜 그런지, 어떻게 작동하는지 제대로 파헤쳐볼게.
임베딩(Embedding)이란?
텍스트를 컴퓨터가 수학적으로 처리할 수 있는 숫자 벡터로 변환하는 과정이야. 예를 들어 "강아지"라는 단어는 [0.23, -0.45, 0.87, 0.12, ...] 같은 수백~수천 차원의 숫자 배열로 표현돼.
핵심은 의미적으로 유사한 텍스트는 벡터 공간에서 가까운 위치에 배치된다는 거야. "강아지"와 "개"는 벡터 공간에서 매우 가깝고, "강아지"와 "자동차"는 멀리 떨어져 있어. 이 특성을 이용해서 의미 기반 검색이 가능해지는 거지.
OpenAI text-embedding-3-small: 1536차원, 비용 효율적
Cohere embed-v3: 1024차원, 다국어 강점
BGE-M3 (오픈소스): 1024차원, 로컬 실행 가능, 한국어 성능 우수
E5-mistral-7b: 4096차원, 최고 수준의 검색 성능
주요 벡터 데이터베이스 비교
벡터 DB 시장은 지금 엄청나게 빠르게 성장하고 있어. 주요 선택지들을 살펴보자:
| 이름 | 특징 | 적합한 상황 |
|---|---|---|
| Pinecone | 완전 관리형 서비스, 빠른 시작 | 프로덕션, 빠른 개발 |
| Weaviate | 오픈소스, 하이브리드 검색 | 복잡한 쿼리, 자체 호스팅 |
| Chroma | 경량, 로컬 실행 가능 | 프로토타입, 소규모 프로젝트 |
| Qdrant | Rust 기반, 고성능 | 대규모 데이터, 고성능 필요 |
| pgvector | PostgreSQL 확장 | 기존 PostgreSQL 사용 중 |
| FAISS | Facebook 개발, 라이브러리 | 연구, 커스텀 구현 |
RAG (Retrieval-Augmented Generation) 패턴
벡터 DB를 활용한 장기 메모리의 가장 대표적인 패턴이 바로 RAG야. 이름이 좀 어렵게 들리지만 개념은 간단해:
1 사용자 질문을 임베딩으로 변환
2 벡터 DB에서 유사한 문서/기억 검색
3 검색된 내용을 컨텍스트에 추가
4 LLM이 풍부한 컨텍스트로 답변 생성
# RAG 기반 메모리 검색 예시
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings

class LongTermMemory:
    def __init__(self):
        self.embeddings = OpenAIEmbeddings(
            model="text-embedding-3-small"
        )
        self.vectorstore = Chroma(
            embedding_function=self.embeddings,
            persist_directory="./memory_db"
        )

    def store(self, content: str, metadata: dict = {}):
        """기억 저장"""
        self.vectorstore.add_texts(
            texts=[content],
            metadatas=[metadata]
        )

    def retrieve(self, query: str, k: int = 5):
        """관련 기억 검색"""
        results = self.vectorstore.similarity_search_with_score(
            query=query,
            k=k
        )
        # 유사도 점수 기준 필터링 (0.7 이상만)
        return [doc for doc, score in results if score > 0.7]

    def retrieve_with_mmr(self, query: str, k: int = 5):
        """MMR로 다양성 확보한 검색"""
        # Maximum Marginal Relevance
        # 유사도 높으면서도 서로 다양한 결과 반환
        return self.vectorstore.max_marginal_relevance_search(
            query=query, k=k, fetch_k=20
)⚙️ 4. 메모리 아키텍처 설계 패턴
이론은 충분히 봤으니까, 이제 실제로 어떻게 설계하는지 패턴을 살펴보자. 현업에서 자주 쓰이는 패턴들이야.
패턴 1: 계층적 메모리 아키텍처
가장 일반적인 패턴이야. 단기 → 중기 → 장기 메모리를 계층적으로 구성하고, 정보가 중요도와 시간에 따라 상위 계층으로 "승격"되거나 하위 계층으로 "강등"되는 구조야.
↓ 요약 및 압축
L2 (세션 요약): 세션 단위 요약 → 빠른 접근, 중간 정밀도
↓ 중요도 평가
L3 (장기 벡터 DB): 중요 정보 영구 저장 → 의미 검색, 대용량
패턴 2: 메모리 컨트롤러 패턴
에이전트가 직접 메모리를 관리하는 게 아니라, 별도의 메모리 컨트롤러가 저장/검색/삭제를 담당하는 패턴이야. 관심사 분리(Separation of Concerns) 원칙을 적용한 거지.
# 메모리 컨트롤러 패턴
class MemoryController:
    def __init__(self):
        self.short_term = ShortTermMemory(max_tokens=4000)
        self.long_term = LongTermMemory()
        self.importance_threshold = 0.7

    def process_interaction(self, user_input, agent_response):
        # 1. 단기 메모리에 추가
        self.short_term.add_message("user", user_input)
        self.short_term.add_message("assistant", agent_response)

        # 2. 중요도 평가 (LLM 활용)
        importance = self._evaluate_importance(
            user_input, agent_response
        )

        # 3. 중요한 정보는 장기 메모리에 저장
        if importance >= self.importance_threshold:
            memory_text = f"사용자: {user_input}\n응답: {agent_response}"
            self.long_term.store(
                content=memory_text,
                metadata={
                    "timestamp": datetime.now().isoformat(),
                    "importance": importance,
                    "type": "interaction"
                }
            )

    def get_context_for_query(self, query: str) -> str:
        # 장기 메모리에서 관련 정보 검색
        memories = self.long_term.retrieve(query, k=3)

        # 단기 메모리의 최근 대화
        recent = self.short_term.get_recent(n=10)

        return self._format_context(memories, recent)

    def _evaluate_importance(self, user_input, response) -> float:
        # 실제로는 LLM을 사용해 중요도 평가
        # 여기서는 간단한 휴리스틱 사용
        important_keywords = ["기억해", "중요", "반드시", "이름", "날짜"]
        score = sum(1 for kw in important_keywords
                   if kw in user_input or kw in response)
        return min(score / len(important_keywords), 1.0)
패턴 3: 반성적 메모리 (Reflective Memory)
이 패턴은 에이전트가 주기적으로 자신의 기억을 반성(reflection)하고 고차원 인사이트를 추출하는 방식이야. Stanford의 Generative Agents 논문에서 제안된 개념이야.
예를 들어 에이전트가 "사용자가 파이썬을 좋아한다", "사용자가 딥러닝에 관심 있다", "사용자가 Kaggle 대회에 참가한다"는 기억들을 가지고 있다면, 반성 과정에서 "이 사용자는 머신러닝 개발자다"라는 고차원 인사이트를 생성하는 거야.
패턴 4: 메모리 그래프 (Memory Graph)
기억들 사이의 관계를 그래프 구조로 표현하는 패턴이야. 단순히 텍스트를 저장하는 것을 넘어서, 기억들 간의 연결 관계를 명시적으로 관리해.
예를 들어 "프로젝트 A" 기억이 "사용자 B"와 연결되고, "기술 스택 C"와도 연결되는 식이야. 이런 그래프 구조는 복잡한 추론이 필요한 에이전트에서 특히 유용해.
Microsoft GraphRAG: 텍스트에서 자동으로 지식 그래프 생성
Mem0: 메모리 관리 특화 라이브러리, 그래프+벡터 하이브리드
Zep: 에이전트 메모리 전용 플랫폼
🔍 5. 메모리 검색 알고리즘 심층 분석
메모리를 저장하는 것만큼 중요한 게 올바른 메모리를 올바른 타이밍에 꺼내는 것이야. 검색 알고리즘을 잘못 설계하면 관련 없는 기억이 컨텍스트를 오염시키거나, 정작 필요한 기억을 못 찾는 문제가 생겨.
코사인 유사도 (Cosine Similarity)
벡터 검색의 기본 중의 기본이야. 두 벡터 사이의 각도를 측정해서 유사도를 계산해. 값이 1에 가까울수록 유사하고, 0에 가까울수록 다른 내용이야.
import numpy as np

def cosine_similarity(vec_a, vec_b):
    """두 벡터의 코사인 유사도 계산"""
    dot_product = np.dot(vec_a, vec_b)
    norm_a = np.linalg.norm(vec_a)
    norm_b = np.linalg.norm(vec_b)
    return dot_product / (norm_a * norm_b)

# 예시
query_vec = embed("오늘 날씨 어때?")
memory_vec = embed("어제 비가 많이 왔어요")
similarity = cosine_similarity(query_vec, memory_vec)
# similarity ≈ 0.72 (날씨 관련이라 유사도 높음)
하이브리드 검색 (Hybrid Search)
순수 벡터 검색만으로는 한계가 있어. 예를 들어 "GPT-4o 출시일"을 검색할 때, 의미 검색보다 키워드 검색이 더 정확할 수 있거든. 그래서 벡터 검색 + 키워드 검색(BM25)을 결합한 하이브리드 검색이 실제 프로덕션에서 많이 쓰여.
최종 점수 = α × 벡터_유사도 + (1-α) × BM25_점수α 값은 보통 0.5~0.7 사이로 설정해. 도메인에 따라 튜닝이 필요해.
전문 용어가 많은 기술 문서: α를 낮게 (키워드 검색 비중 높임)
자연어 대화 기반: α를 높게 (의미 검색 비중 높임)
시간 가중치 (Temporal Weighting)
최근 기억이 오래된 기억보다 더 관련성이 높은 경우가 많아. 특히 사용자의 선호도나 상황은 시간이 지남에 따라 변하거든. 그래서 검색 점수에 시간 가중치를 적용하는 게 중요해.
import math
from datetime import datetime

def temporal_decay_score(base_score, timestamp, decay_factor=0.99):
    """시간 경과에 따른 점수 감쇠"""
    hours_elapsed = (datetime.now() - timestamp).total_seconds() / 3600
    # 지수 감쇠 함수
    temporal_weight = math.exp(-decay_factor * hours_elapsed / 24)
    return base_score * temporal_weight

# 예시: 1주일 전 기억은 현재 기억의 약 93% 점수
# 1달 전 기억은 약 74% 점수
# 1년 전 기억은 약 7% 점수
중요도 기반 검색 (Importance-weighted Retrieval)
모든 기억이 동등하게 중요하지 않아. 사용자가 "반드시 기억해줘"라고 강조한 정보는 일반 대화보다 훨씬 높은 중요도를 가져야 해. 저장 시 중요도 점수를 메타데이터로 함께 저장하고, 검색 시 이를 가중치로 활용하는 방식이야.
최종_점수 = 유사도_점수 × 시간_가중치 × 중요도_가중치이 세 가지 요소를 균형 있게 조합하면 훨씬 더 지능적인 메모리 검색이 가능해!
🧹 6. 메모리 관리 — 잊는 것도 기술이다
이 부분이 많은 개발자들이 간과하는 부분인데, 사실 엄청 중요해. 메모리를 무한정 쌓기만 하면 어떤 문제가 생길까?
첫째, 검색 품질 저하. 관련 없는 오래된 정보가 많아질수록 진짜 필요한 정보를 찾기 어려워져.
둘째, 저장 비용 증가. 벡터 DB는 데이터가 많아질수록 비용이 늘어나.
셋째, 프라이버시 문제. 사용자가 삭제를 요청한 정보가 계속 남아있으면 법적 문제가 될 수 있어 (GDPR 등).
메모리 만료 전략
메모리에 TTL(Time-To-Live)을 설정하는 방식이야. 중요도에 따라 다른 TTL을 적용할 수 있어:
| 메모리 유형 | TTL 예시 | 이유 |
|---|---|---|
| 일반 대화 내용 | 7일 | 단기적 맥락, 빠르게 구식화 |
| 사용자 선호도 | 90일 | 중기적으로 변할 수 있음 |
| 중요 사실 정보 | 1년 | 장기적으로 유효 |
| 사용자 명시 기억 | 무기한 | 사용자가 기억 요청 |
메모리 압축 (Memory Consolidation)
여러 개의 관련된 기억을 하나의 요약으로 합치는 과정이야. 인간의 수면 중 기억 통합 과정과 유사해. 예를 들어 "사용자가 파이썬 질문을 10번 했다"는 10개의 기억을 "사용자는 파이썬 개발자이며 주로 데이터 처리 관련 질문을 한다"는 하나의 요약으로 압축하는 거야.
# 메모리 압축 예시
async def consolidate_memories(memories: list, llm) -> str:
    """여러 기억을 하나의 요약으로 압축"""
    memory_texts = "\n".join([m.content for m in memories])

    prompt = f"""다음 기억들을 분석하여 핵심 인사이트를 추출해줘:

{memory_texts}

다음 형식으로 요약해줘:
- 사용자 특성: [핵심 특성]
- 주요 관심사: [관심 분야]
- 중요 사실: [기억해야 할 사실들]"""

    summary = await llm.generate(prompt)
    return summary

# 압축 트리거: 같은 주제의 기억이 10개 이상 쌓이면 실행
메모리 업데이트 (Memory Update)
기존 기억이 새로운 정보로 인해 무효화될 때 처리하는 방법이야. 예를 들어 "사용자의 직업은 학생이다"라는 기억이 있는데, 나중에 "저 취직했어요"라는 정보가 들어오면 기존 기억을 업데이트해야 해.
2. 버전 관리: 이전 기억도 보존하되 "구버전" 태그 추가
3. LLM 판단: 충돌 감지 시 LLM에게 어떤 정보가 맞는지 판단 요청
🛠️ 7. 실전 구현 — LangChain과 LangGraph로 메모리 시스템 만들기
이론은 충분히 봤으니까, 실제로 어떻게 구현하는지 보자. 현재 AI 에이전트 개발에서 가장 많이 쓰이는 프레임워크인 LangChain과 LangGraph를 활용한 메모리 시스템 구현이야.
LangChain 메모리 컴포넌트
LangChain은 다양한 메모리 컴포넌트를 제공해. 각각의 특성을 알고 상황에 맞게 선택하는 게 중요해:
ConversationBufferWindowMemory: 최근 K개 대화만 유지
ConversationSummaryMemory: 오래된 대화를 요약으로 압축
ConversationSummaryBufferMemory: 최근 대화는 그대로, 오래된 건 요약
VectorStoreRetrieverMemory: 벡터 DB 기반 의미 검색 메모리
# LangChain 하이브리드 메모리 구현
from langchain.memory import (
    ConversationSummaryBufferMemory,
    VectorStoreRetrieverMemory
)
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings
from langchain.chat_models import ChatOpenAI

# 단기 메모리: 최근 대화 + 요약
short_term = ConversationSummaryBufferMemory(
    llm=ChatOpenAI(model="gpt-4o-mini"),
    max_token_limit=2000,
    return_messages=True
)

# 장기 메모리: 벡터 DB 기반
vectorstore = Chroma(
    embedding_function=OpenAIEmbeddings(),
    persist_directory="./long_term_memory"
)
long_term = VectorStoreRetrieverMemory(
    retriever=vectorstore.as_retriever(
        search_kwargs={"k": 3}
    )
)

# 두 메모리를 결합한 컨텍스트 생성
def get_combined_context(query: str) -> str:
    # 장기 메모리에서 관련 기억 검색
    relevant_memories = long_term.load_memory_variables(
        {"input": query}
    )

    # 단기 메모리에서 최근 대화 가져오기
    recent_history = short_term.load_memory_variables({})

    context = f"""관련 기억:
{relevant_memories.get('history', '없음')}

최근 대화:
{recent_history.get('history', '없음')}"""

    return context
LangGraph로 상태 기반 메모리 에이전트 만들기
LangGraph는 에이전트의 상태(state)를 그래프 노드로 관리하는 프레임워크야. 메모리 시스템을 에이전트 상태의 일부로 통합하는 데 매우 적합해.
# LangGraph 메모리 에이전트 기본 구조
from langgraph.graph import StateGraph, END
from typing import TypedDict, List, Annotated
import operator

# 에이전트 상태 정의 (메모리 포함)
class AgentState(TypedDict):
    messages: Annotated[List, operator.add]  # 대화 히스토리
    memories: List[str]                       # 검색된 장기 기억
    current_query: str                        # 현재 쿼리
    importance_score: float                   # 현재 상호작용 중요도

# 메모리 검색 노드
def retrieve_memories(state: AgentState) -> AgentState:
    query = state["current_query"]
    # 벡터 DB에서 관련 기억 검색
    memories = memory_db.search(query, k=3)
    return {"memories": memories}

# LLM 추론 노드
def agent_reasoning(state: AgentState) -> AgentState:
    context = "\n".join(state["memories"])
    messages = state["messages"]
    # 메모리 컨텍스트를 포함한 LLM 호출
    response = llm.invoke(
        system=f"관련 기억:\n{context}",
        messages=messages
    )
    return {"messages": [response]}

# 메모리 저장 노드
def save_memory(state: AgentState) -> AgentState:
    if state["importance_score"] > 0.7:
        interaction = f"Q: {state['current_query']}\nA: {state['messages'][-1].content}"
        memory_db.store(interaction)
    return state

# 그래프 구성
workflow = StateGraph(AgentState)
workflow.add_node("retrieve", retrieve_memories)
workflow.add_node("reason", agent_reasoning)
workflow.add_node("save", save_memory)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "reason")
workflow.add_edge("reason", "save")
workflow.add_edge("save", END)

app = workflow.compile()MemorySaver나 SqliteSaver를 사용하면 세션 간 상태 유지가 매우 간단해져!
⚖️ 8. 메모리 시스템 설계의 핵심 트레이드오프
메모리 시스템을 설계할 때는 여러 가지 상충 관계(tradeoff)를 고려해야 해. 완벽한 시스템은 없고, 상황에 맞는 최적의 균형점을 찾는 게 핵심이야.
트레이드오프 1: 정확도 vs 속도
더 많은 메모리를 검색할수록 정확도는 높아지지만 응답 속도가 느려져. 실시간 대화 에이전트라면 속도가 중요하고, 연구 보조 에이전트라면 정확도가 더 중요할 수 있어.
- ✅ 캐싱: 자주 검색되는 쿼리 결과를 Redis 등에 캐시
- ✅ 비동기 검색: 메모리 검색을 비동기로 처리해 응답 지연 최소화
- ✅ 인덱스 최적화: HNSW(Hierarchical Navigable Small World) 알고리즘으로 근사 최근접 이웃 검색
- ✅ 계층적 검색: 먼저 거친 필터링 후 세밀한 검색 수행
트레이드오프 2: 메모리 용량 vs 비용
더 많은 메모리를 저장할수록 에이전트가 더 많은 것을 기억하지만, 저장 비용과 검색 비용이 증가해. 특히 임베딩 생성 비용(API 호출)과 벡터 DB 저장 비용을 고려해야 해.
| 전략 | 장점 | 단점 |
|---|---|---|
| 모든 것 저장 | 최대 기억력 | 높은 비용, 검색 품질 저하 |
| 중요도 기반 선택 저장 | 비용 효율적 | 중요도 판단 오류 가능 |
| 요약 후 저장 | 공간 효율적 | 세부 정보 손실 |
| TTL 기반 자동 삭제 | 자동 관리 | 중요 정보 삭제 위험 |
트레이드오프 3: 프라이버시 vs 개인화
더 많은 사용자 정보를 기억할수록 더 개인화된 경험을 제공할 수 있지만, 프라이버시 위험도 커져. 특히 GDPR, CCPA 같은 개인정보보호 규정을 준수해야 하는 경우 메모리 설계에 법적 요구사항이 반영되어야 해.
2. 목적 제한: 저장 목적 외 사용 금지
3. 삭제권 보장: 사용자 요청 시 즉시 삭제 가능한 구조
4. 암호화: 저장된 메모리 데이터 암호화
5. 접근 제어: 메모리 접근 권한 엄격히 관리
🚀 9. 최신 트렌드 — 2024-2025년 메모리 기술의 진화
AI 에이전트 메모리 기술은 정말 빠르게 발전하고 있어. 최신 트렌드를 알아야 미래를 대비할 수 있지!
트렌드 1: 초장문 컨텍스트 윈도우의 부상
Gemini 1.5 Pro의 1M 토큰 컨텍스트 윈도우는 메모리 시스템 설계에 큰 변화를 가져왔어. 이론적으로는 책 한 권 분량의 텍스트를 통째로 컨텍스트에 넣을 수 있어. 그러면 별도의 외부 메모리 시스템이 필요 없어지는 걸까?
꼭 그렇지는 않아. 컨텍스트 윈도우가 커져도 "Lost in the Middle" 문제가 있어 — 컨텍스트 중간에 있는 정보는 앞뒤에 있는 정보보다 LLM이 잘 활용하지 못하는 현상이야. 그래서 여전히 관련 정보를 선별해서 컨텍스트에 주입하는 RAG 방식이 유효해.
트렌드 2: 메모리 특화 AI 시스템
Mem0는 AI 에이전트를 위한 메모리 레이어를 전문으로 제공하는 서비스야. 사용자, 세션, 에이전트 레벨의 메모리를 자동으로 관리해주고, 메모리 추출, 업데이트, 충돌 해결을 LLM이 자동으로 처리해줘.
# Mem0 사용 예시
from mem0 import Memory

m = Memory()

# 메모리 추가 (자동으로 중요 정보 추출)
m.add(
    "저는 파이썬 개발자이고 머신러닝에 관심이 많아요. "
    "특히 NLP 분야를 공부하고 있어요.",
    user_id="user_123"
)

# 관련 메모리 검색
memories = m.search(
    query="사용자의 기술 스택은?",
    user_id="user_123"
)
# 결과: [{"memory": "파이썬 개발자, 머신러닝/NLP 관심"}]

# 메모리 업데이트 (자동 충돌 해결)
m.add(
    "최근에 취직해서 이제 풀타임 ML 엔지니어로 일하고 있어요",
    user_id="user_123"
)
# 자동으로 "학생" → "ML 엔지니어"로 업데이트
트렌드 3: 멀티모달 메모리
텍스트뿐만 아니라 이미지, 오디오, 비디오도 메모리로 저장하고 검색하는 멀티모달 메모리가 주목받고 있어. 예를 들어 사용자가 공유한 이미지를 기억하고, 나중에 "그때 보여준 그 그래프 기억해?"라고 물으면 해당 이미지를 검색해서 활용하는 거야.
트렌드 4: 에이전트 간 공유 메모리
멀티 에이전트 시스템에서 여러 에이전트가 공유하는 메모리 공간이 중요해지고 있어. 한 에이전트가 수집한 정보를 다른 에이전트가 활용할 수 있는 구조야. 이를 위해 공유 메모리 버스(Shared Memory Bus) 패턴이 등장하고 있어.
💼 10. 실전 적용 가이드 — 어떤 메모리 시스템을 선택할까?
자, 이제 실제로 프로젝트에 적용할 때 어떤 선택을 해야 하는지 정리해보자. 재능넷 같은 플랫폼에서 AI 에이전트를 개발한다면, 사용자의 재능과 선호도를 기억하는 개인화 에이전트가 필요할 텐데, 이런 경우에도 아래 가이드가 도움이 될 거야.
프로젝트 규모별 추천 스택
장기 메모리: Chroma (로컬 벡터 DB)
임베딩: OpenAI text-embedding-3-small
프레임워크: LangChain
예상 비용: 월 $10~50
장기 메모리: Pinecone 또는 Qdrant
임베딩: OpenAI text-embedding-3-large 또는 BGE-M3
프레임워크: LangGraph
메모리 관리: Mem0 또는 자체 구현
예상 비용: 월 $100~500
장기 메모리: Weaviate 또는 자체 호스팅 Qdrant
임베딩: 파인튜닝된 도메인 특화 임베딩 모델
프레임워크: LangGraph + 커스텀 오케스트레이션
메모리 그래프: Neo4j 또는 Microsoft GraphRAG
예상 비용: 월 $1,000+
메모리 시스템 성능 평가 지표
메모리 시스템을 구축했으면 제대로 작동하는지 평가해야 해. 주요 평가 지표들이야:
1메모리 정밀도(Memory Precision): 검색된 메모리 중 실제로 관련 있는 비율
2메모리 재현율(Memory Recall): 관련 있는 메모리 중 실제로 검색된 비율
3응답 지연(Latency): 메모리 검색에 걸리는 시간
4메모리 활용률: 검색된 메모리가 실제 응답에 활용되는 비율
5사용자 만족도: 메모리 기반 개인화에 대한 사용자 평가
🎓 11. 심화 개념 — 메모리와 추론의 통합
메모리 시스템을 단순히 "정보 저장소"로만 보면 안 돼. 진짜 지능적인 에이전트는 메모리와 추론이 긴밀하게 통합되어야 해. 이 섹션에서는 좀 더 심화된 개념들을 다뤄볼게.
메모리 기반 계획 수립 (Memory-Augmented Planning)
에이전트가 복잡한 작업을 수행할 때, 과거 유사한 작업의 경험을 메모리에서 검색해서 계획 수립에 활용하는 방식이야. 예를 들어 "데이터 분석 보고서 작성"이라는 작업을 받으면, 과거에 비슷한 작업을 어떻게 처리했는지 메모리에서 검색하고, 그 경험을 바탕으로 더 효율적인 계획을 세우는 거야.
메타 메모리 (Meta-Memory)
에이전트가 자신의 메모리 시스템 자체에 대해 아는 것 — "나는 어떤 정보를 기억하고 있는가", "내 기억이 얼마나 신뢰할 수 있는가" — 을 관리하는 개념이야. 이를 통해 에이전트는 자신의 지식 한계를 인식하고, 불확실한 경우 사용자에게 확인을 요청하거나 추가 검색을 수행할 수 있어.
# 메타 메모리 구현 예시
class MetaMemory:
    def __init__(self):
        self.memory_index = {}  # 메모리 목록과 신뢰도

    def register_memory(self, memory_id, content, confidence=1.0):
        self.memory_index[memory_id] = {
            "content": content,
            "confidence": confidence,
            "access_count": 0,
            "last_accessed": datetime.now(),
            "source": "user_interaction"
        }

    def get_memory_confidence(self, memory_id) -> float:
        """특정 기억의 신뢰도 반환"""
        if memory_id in self.memory_index:
            return self.memory_index[memory_id]["confidence"]
        return 0.0

    def should_verify(self, memory_id, threshold=0.8) -> bool:
        """신뢰도가 낮으면 검증 필요 여부 반환"""
        confidence = self.get_memory_confidence(memory_id)
        return confidence < threshold

    def decay_confidence(self, memory_id, decay_rate=0.01):
        """시간이 지남에 따라 신뢰도 감소"""
        if memory_id in self.memory_index:
            current = self.memory_index[memory_id]["confidence"]
            self.memory_index[memory_id]["confidence"] = max(
                0.1, current * (1 - decay_rate)
            )
연상 메모리 (Associative Memory)
인간의 연상 기억처럼, 하나의 기억이 관련된 다른 기억들을 자동으로 활성화하는 방식이야. 예를 들어 "파이썬"이라는 키워드가 나오면 "머신러닝", "데이터 분석", "사용자의 프로젝트 A" 같은 관련 기억들이 함께 활성화되는 거야.
이는 그래프 기반 메모리 시스템에서 구현할 수 있어. 기억들 사이에 연결 엣지를 만들고, 하나의 기억에 접근할 때 연결된 기억들도 함께 검색하는 방식이지.
인간의 대뇌피질(Neocortex) → AI의 장기 메모리 (벡터 DB)
인간의 수면 중 기억 통합 → AI의 메모리 압축/통합 프로세스
인간의 망각 곡선 → AI의 TTL 및 시간 가중치
인간의 감정 기반 기억 강화 → AI의 중요도 기반 메모리 선택
🔧 12. 디버깅과 모니터링 — 메모리 시스템 유지보수
메모리 시스템을 구축했다고 끝이 아니야. 실제 운영 환경에서는 다양한 문제가 발생할 수 있어. 어떻게 디버깅하고 모니터링할지 알아보자.
흔한 메모리 시스템 버그들
🐛 버그 1: 메모리 오염 (Memory Contamination)
서로 다른 사용자의 메모리가 섞이는 문제. 멀티 테넌트 환경에서 user_id 기반 격리가 제대로 안 된 경우 발생해.
🐛 버그 2: 스테일 메모리 (Stale Memory)
오래되어 더 이상 유효하지 않은 정보가 계속 검색되는 문제. TTL 설정이나 업데이트 로직이 없을 때 발생해.
🐛 버그 3: 메모리 환각 (Memory Hallucination)
LLM이 실제로 저장되지 않은 기억을 "기억한다"고 주장하는 문제. 메모리 검색 결과를 명확하게 구분해서 프롬프트에 주입해야 해.
🐛 버그 4: 컨텍스트 오버플로우 (Context Overflow)
검색된 메모리가 너무 많아서 컨텍스트 윈도우를 초과하는 문제. 검색 결과 수(k)와 각 메모리의 최대 길이를 제한해야 해.
모니터링 대시보드 구성
메모리 시스템의 건강 상태를 모니터링하기 위해 추적해야 할 주요 지표들이야:
| 지표 | 설명 | 경고 임계값 |
|---|---|---|
| 메모리 저장 수 | 총 저장된 메모리 개수 | 급격한 증가 시 알림 |
| 검색 지연시간 | 메모리 검색 평균 시간 | 500ms 초과 시 알림 |
| 검색 히트율 | 검색 시 관련 메모리 발견 비율 | 30% 미만 시 검토 |
| 메모리 활용률 | 검색된 메모리 실제 활용 비율 | 50% 미만 시 검토 |
| 임베딩 비용 | 임베딩 생성 API 비용 | 예산 80% 초과 시 알림 |
🎯 마무리 — 메모리 시스템 설계의 핵심 원칙
자, 긴 여정이었는데 마지막으로 핵심 원칙들을 정리해볼게. 이것만 기억해도 메모리 시스템 설계에서 큰 실수는 안 할 거야.
2. 계층적 설계: 단기-중기-장기 메모리를 계층적으로 구성해
3. 선택적 저장: 모든 것을 저장하려 하지 마. 중요한 것만 저장해
4. 스마트 검색: 단순 키워드 검색이 아닌 의미 기반 검색을 구현해
5. 시간 가중치: 최신 정보에 더 높은 가중치를 부여해
6. 망각 설계: TTL과 압축으로 메모리를 주기적으로 정리해
7. 프라이버시 우선: 개인정보 보호를 설계 단계부터 고려해
8. 모니터링: 메모리 시스템의 성능을 지속적으로 추적해
9. 점진적 개선: 처음부터 완벽하게 만들려 하지 말고 단계적으로 발전시켜
10. 사용자 제어: 사용자가 자신의 메모리를 확인하고 삭제할 수 있게 해
AI 에이전트의 메모리 시스템은 단순한 기술적 구현을 넘어서, 에이전트가 얼마나 지능적이고 신뢰할 수 있는 파트너가 될 수 있는가를 결정하는 핵심 요소야. 재능넷에서 AI 관련 개발 서비스를 제공하는 개발자라면, 이 메모리 시스템 설계 능력이 차별화된 경쟁력이 될 거야.
기억하는 AI를 만드는 것, 그게 바로 진짜 지능적인 에이전트를 만드는 첫 걸음이야. 🚀
논문: "MemGPT: Towards LLMs as Operating Systems" (2023)
라이브러리: LangChain Memory, LangGraph, Mem0, Zep
벡터 DB: Pinecone, Weaviate, Qdrant, Chroma 공식 문서
평가 도구: RAGAS, LangSmith

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.