
Ver3.5 LangGraph로 복잡한 에이전트 워크플로우 구성
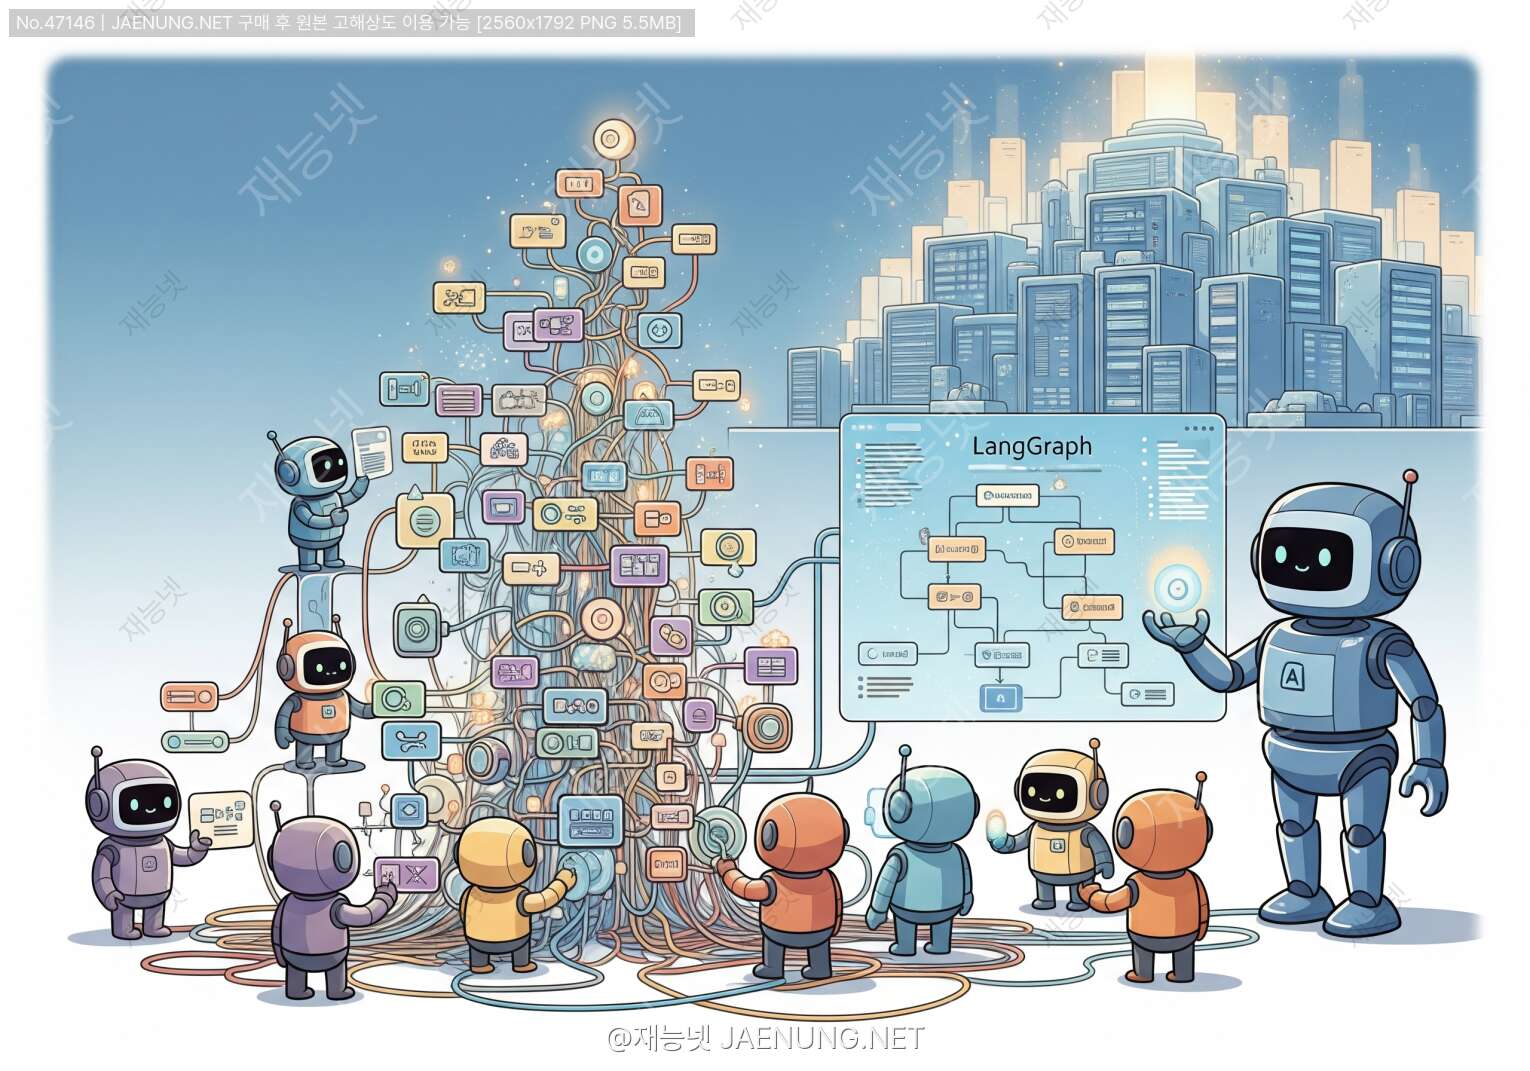
LangGraph로 복잡한 에이전트 워크플로우 구성
야 솔직히 말해서... LangChain만 쓰다가 LangGraph 처음 봤을 때 "이게 뭐야 갑자기 그래프가 왜 나와?" 싶었잖아ㅋㅋㅋ
근데 써보면 진짜 소름 돋음. 복잡한 AI 에이전트 워크플로우를 이렇게 깔끔하게 짤 수 있다고?? 🤯
오늘은 LangGraph가 뭔지, 왜 필요한지, 어떻게 쓰는지 — 진짜 실전 위주로 낱낱이 파헤쳐볼게. 개발자라면 이거 모르면 이제 좀 아쉬운 시대가 됐거든ㅋㅋ
LangGraph는 LangChain 팀이 만든 라이브러리인데, AI 에이전트 워크플로우를 방향성 그래프(Directed Graph) 형태로 설계할 수 있게 해줘.
2024년에 급부상하면서 지금은 복잡한 멀티 에이전트 시스템 구축의 사실상 표준 중 하나가 됐음.
기존 LangChain의 Chain이나 AgentExecutor는 기본적으로 선형(Linear) 구조야.
A → B → C 이렇게 순서대로 가는 건 잘 되는데, 문제는 실제 AI 에이전트는 이렇게 단순하지 않다는 거ㅋㅋ
예를 들어볼게:
✅ "검색 결과가 불충분하면 다시 검색해"
✅ "에러가 나면 다른 도구로 재시도해"
✅ "사용자 승인이 필요하면 잠깐 멈춰"
✅ "여러 에이전트가 병렬로 작업하고 결과를 합쳐"
이런 조건 분기, 루프, 병렬 처리, 중간 개입을 기존 방식으로 구현하면... 코드가 스파게티가 됨 🍝
노드는 그래프에서 실제 작업을 수행하는 함수야.
LLM 호출, 도구 실행, 데이터 처리, 사용자 입력 대기 등 뭐든 노드가 될 수 있어.
노드는 State를 입력받고, 업데이트된 State를 반환하는 구조야. 되게 단순하지?
def agent_node(state: AgentState) -> AgentState:
    # LLM 호출
    response = llm.invoke(state["messages"])
    # 상태 업데이트해서 반환
return {"messages": state["messages"] + [response]}엣지는 노드와 노드를 연결하는 화살표야. 두 종류가 있어:
일반 엣지(Normal Edge): A 끝나면 무조건 B로 가
조건부 엣지(Conditional Edge): 상태를 보고 B로 갈지 C로 갈지 결정해
조건부 엣지가 진짜 핵심임. 이게 있어야 "도구 호출이 필요하면 도구 노드로, 아니면 END로" 같은 분기가 가능해.
# 조건부 엣지 함수 예시
def should_continue(state: AgentState) -> str:
    last_message = state["messages"][-1]
    # 도구 호출이 있으면 "tools"로, 없으면 "end"로
    if last_message.tool_calls:
        return "tools"
return "end"State는 그래프 전체에서 공유되는 데이터 구조야.
모든 노드가 이 State를 읽고 쓰면서 정보를 주고받아. TypedDict나 Pydantic 모델로 정의해.
LangGraph의 State는 불변(Immutable)이 아니라 리듀서(Reducer) 패턴으로 업데이트돼.
특히 메시지 리스트는 기본적으로 add_messages 리듀서가 적용돼서 덮어쓰기가 아니라 추가(append) 방식으로 동작함.
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages

class AgentState(TypedDict):
    messages: Annotated[list, add_messages]
    step_count: int
final_answer: str | None자 이제 진짜 코드 들어가보자ㅋㅋ 설치는 간단해:
pip install langgraph langchain langchain-openai가장 기본적인 패턴인 ReAct(Reasoning + Acting) 에이전트를 LangGraph로 만들어볼게.
ReAct는 "생각하고 → 도구 쓰고 → 결과 보고 → 다시 생각하고..." 를 반복하는 패턴이야.
from langgraph.graph import StateGraph, END
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages
from langgraph.prebuilt import ToolNode

# 1. 상태 정의
class AgentState(TypedDict):
    messages: Annotated[list, add_messages]

# 2. 도구 정의
@tool
def search_web(query: str) -> str:
    """웹에서 정보를 검색합니다."""
    # 실제로는 검색 API 연결
    return f"'{query}'에 대한 검색 결과입니다."

tools = [search_web]

# 3. LLM 설정
llm = ChatOpenAI(model="gpt-4o").bind_tools(tools)

# 4. 노드 함수 정의
def agent_node(state: AgentState):
    response = llm.invoke(state["messages"])
    return {"messages": [response]}

# 5. 조건부 엣지 함수
def should_continue(state: AgentState) -> str:
    last_msg = state["messages"][-1]
    if hasattr(last_msg, "tool_calls") and last_msg.tool_calls:
        return "tools"
    return "end"

# 6. 그래프 구성
graph = StateGraph(AgentState)

graph.add_node("agent", agent_node)
graph.add_node("tools", ToolNode(tools))

graph.set_entry_point("agent")
graph.add_conditional_edges(
    "agent",
    should_continue,
    {"tools": "tools", "end": END}
)
graph.add_edge("tools", "agent")  # 도구 실행 후 다시 에이전트로

# 7. 컴파일
app = graph.compile()

# 8. 실행
result = app.invoke({
    "messages": [("user", "오늘 서울 날씨 알려줘")]
})graph.add_edge("tools", "agent") 이 한 줄이 루프를 만들어줘.도구 실행 → 에이전트 → 도구 실행 → 에이전트... 이게 자동으로 반복되는 거임. 진짜 간단하지?ㅋㅋ
LangGraph의 킬러 기능 중 하나야. 체크포인터(Checkpointer)를 붙이면 그래프 실행 상태를 저장해서 나중에 이어서 실행할 수 있어.
이게 왜 중요하냐면 — 멀티턴 대화, 장기 실행 작업, 사람의 개입(Human-in-the-loop) 구현에 필수거든!
from langgraph.checkpoint.memory import MemorySaver
from langgraph.checkpoint.sqlite import SqliteSaver

# 메모리 체크포인터 (개발/테스트용)
memory = MemorySaver()

# SQLite 체크포인터 (프로덕션용)
# with SqliteSaver.from_conn_string("checkpoints.db") as checkpointer:

app = graph.compile(checkpointer=memory)

# thread_id로 대화 세션 구분
config = {"configurable": {"thread_id": "user_123"}}

# 첫 번째 메시지
result1 = app.invoke(
    {"messages": [("user", "내 이름은 김철수야")]},
    config=config
)

# 두 번째 메시지 — 이전 대화 기억함!
result2 = app.invoke(
    {"messages": [("user", "내 이름이 뭐라고?")]},
    config=config
)
# → "김철수라고 하셨습니다!" 라고 답함 ✅thread_id만 같으면 이전 대화 내용을 자동으로 불러와서 이어서 대화해. 세션 관리가 이렇게 쉬워도 되나ㅋㅋ
AI가 혼자 다 결정하면 위험한 작업들이 있잖아. 예를 들어 이메일 발송, 결제, 파일 삭제 같은 거.
LangGraph는 interrupt_before나 interrupt_after로 특정 노드 실행 전후에 사람의 승인을 받을 수 있어.
# 특정 노드 실행 전에 중단
app = graph.compile(
    checkpointer=memory,
    interrupt_before=["send_email"]  # 이메일 발송 전에 멈춤
)

config = {"configurable": {"thread_id": "task_001"}}

# 실행 → send_email 노드 직전에 자동 중단
result = app.invoke({"messages": [...]}, config=config)
print("현재 상태:", app.get_state(config))

# 사람이 확인 후 승인
user_input = input("이메일을 발송할까요? (y/n): ")
if user_input == "y":
    # None을 넣으면 중단된 지점부터 재개
    app.invoke(None, config=config)
else:
    # 상태를 수정해서 재개할 수도 있음
app.update_state(config, {"approved": False})LangGraph는 Send API를 통해 동적 병렬 처리를 지원해.
예를 들어 여러 문서를 동시에 요약하거나, 여러 API를 동시에 호출하는 게 가능해.
from langgraph.types import Send

# 여러 문서를 병렬로 처리하는 예시
def distribute_tasks(state: AgentState):
    documents = state["documents"]
    # 각 문서마다 별도의 "summarize" 노드 인스턴스 생성
    return [
        Send("summarize", {"doc": doc, "doc_id": i})
        for i, doc in enumerate(documents)
    ]

def summarize(state: dict):
    doc = state["doc"]
    summary = llm.invoke(f"다음을 요약해: {doc}")
    return {"summaries": [summary.content]}

graph.add_node("distribute", distribute_tasks)
graph.add_node("summarize", summarize)
graph.add_conditional_edges("distribute", distribute_tasks)
# → 10개 문서면 10개 summarize 노드가 동시 실행!이제 진짜 복잡한 거 들어가보자ㅋㅋ 실제 프로덕션 레벨에서는 에이전트 하나로 다 하려고 하면 한계가 있어.
그래서 여러 전문 에이전트를 조합하는 멀티 에이전트 아키텍처가 필요해.
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI

# 각 전문 에이전트 정의
def researcher_agent(state):
    """웹 검색 전문 에이전트"""
    # 검색 도구 사용
    ...

def writer_agent(state):
    """글쓰기 전문 에이전트"""
    # 콘텐츠 작성
    ...

def reviewer_agent(state):
    """검토 전문 에이전트"""
    # 품질 검토
    ...

# 슈퍼바이저 — 누구한테 일 시킬지 결정
supervisor_prompt = ChatPromptTemplate.from_messages([
    ("system", """당신은 팀 매니저입니다.
    다음 팀원 중 누가 다음 작업을 해야 하는지 결정하세요:
    - researcher: 정보 수집이 필요할 때
    - writer: 글쓰기가 필요할 때
    - reviewer: 검토가 필요할 때
    - FINISH: 작업이 완료됐을 때"""),
    ("human", "{messages}")
])

def supervisor_node(state):
    chain = supervisor_prompt | llm
    result = chain.invoke(state)
    return {"next": result.content}  # 다음 에이전트 지정

# 그래프 구성
graph = StateGraph(TeamState)
graph.add_node("supervisor", supervisor_node)
graph.add_node("researcher", researcher_agent)
graph.add_node("writer", writer_agent)
graph.add_node("reviewer", reviewer_agent)

# 슈퍼바이저가 라우팅
graph.add_conditional_edges(
    "supervisor",
    lambda x: x["next"],
    {
        "researcher": "researcher",
        "writer": "writer",
        "reviewer": "reviewer",
        "FINISH": END
    }
)
# 모든 에이전트는 작업 후 슈퍼바이저에게 보고
for agent in ["researcher", "writer", "reviewer"]:
graph.add_edge(agent, "supervisor")코드 짜다 보면 특정 워크플로우가 반복되는 경우가 많잖아ㅋㅋ
LangGraph의 서브그래프는 그래프 안에 또 다른 그래프를 넣는 기능이야. 재사용성 최고!
# 서브그래프 정의 (독립적인 그래프)
sub_graph = StateGraph(SubState)
sub_graph.add_node("fetch_data", fetch_data_node)
sub_graph.add_node("process", process_node)
sub_graph.add_edge("fetch_data", "process")
sub_graph.set_entry_point("fetch_data")
sub_graph.add_edge("process", END)

# 서브그래프 컴파일
compiled_sub = sub_graph.compile()

# 메인 그래프에 서브그래프를 노드로 추가
main_graph = StateGraph(MainState)
main_graph.add_node("preprocessing", compiled_sub)
main_graph.add_node("main_agent", main_agent_node)
main_graph.add_edge("preprocessing", "main_agent")
main_graph.set_entry_point("preprocessing")

# 서브그래프는 독립적으로 테스트 가능!
test_result = compiled_sub.invoke({"query": "테스트"})사용자 입장에서 AI가 "생각 중..." 만 보여주다가 갑자기 결과를 탁 던지면 UX가 별로잖아.
LangGraph는 스트리밍을 기본 지원해서 실시간으로 진행 상황을 보여줄 수 있어.
# 1. values 모드 — 각 스텝마다 전체 State 스트리밍
for chunk in app.stream({"messages": [...]}, stream_mode="values"):
    print("현재 상태:", chunk)

# 2. updates 모드 — 각 노드의 업데이트만 스트리밍 (가장 효율적)
for chunk in app.stream({"messages": [...]}, stream_mode="updates"):
    node_name = list(chunk.keys())[0]
    print(f"[{node_name}] 실행 완료:", chunk[node_name])

# 3. messages 모드 — LLM 토큰 단위 스트리밍 (ChatGPT처럼!)
async for chunk in app.astream(
    {"messages": [...]},
    stream_mode="messages"
):
    if chunk[1]["langgraph_node"] == "agent":
        print(chunk[0].content, end="", flush=True)

# 실제 FastAPI 서버에서 사용 예시
from fastapi import FastAPI
from fastapi.responses import StreamingResponse

app_api = FastAPI()

@app_api.post("/chat")
async def chat(request: ChatRequest):
    async def generate():
        async for chunk in langgraph_app.astream(
            {"messages": [("user", request.message)]},
            stream_mode="messages"
        ):
            yield f"data: {chunk[0].content}\n\n"

return StreamingResponse(generate(), media_type="text/event-stream")복잡한 에이전트 워크플로우 디버깅은 진짜 고통스러울 수 있어ㅋㅋ
LangGraph는 LangSmith와 완벽하게 연동돼서 각 노드의 입출력, 실행 시간, 토큰 사용량을 추적할 수 있어.
import os

# 환경변수 설정만 하면 자동으로 추적됨
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = "your-api-key"
os.environ["LANGCHAIN_PROJECT"] = "my-agent-project"

# 이후 모든 LangGraph 실행이 자동으로 LangSmith에 기록됨
result = app.invoke({"messages": [...]})
# → LangSmith 대시보드에서 전체 실행 흐름 시각화 확인 가능!# 그래프 구조를 Mermaid 다이어그램으로 출력
print(app.get_graph().draw_mermaid())
# PNG 이미지로 저장 (graphviz 필요)
app.get_graph().draw_png("my_graph.png")
# 현재 상태 스냅샷 확인
config = {"configurable": {"thread_id": "debug_001"}}
snapshot = app.get_state(config)
print("현재 노드:", snapshot.next)
print("현재 상태:", snapshot.values)
# 상태 히스토리 확인
for state in app.get_state_history(config):
print(state.metadata["step"], state.values)| 패턴 이름 | 언제 쓰냐 | 핵심 특징 |
|---|---|---|
| ReAct | 도구 사용이 필요한 일반 에이전트 | 추론→행동→관찰 반복 |
| Plan & Execute | 복잡한 멀티스텝 작업 | 먼저 계획 세우고 실행 |
| Reflection | 품질이 중요한 작업 | 자기 비판 후 개선 반복 |
| LATS | 최적 경로 탐색 | 트리 탐색 + 백트래킹 |
| Corrective RAG | RAG 품질 향상 | 검색 결과 평가 후 재검색 |
| Self-RAG | 할루시네이션 방지 | 생성 중 실시간 검증 |
AI가 뭔가를 생성하고, 그걸 다시 비판하고, 개선하는 패턴이야.
글쓰기, 코드 생성, 분석 보고서 등에서 품질이 확 올라가.
def generate_node(state):
    """초안 생성"""
    draft = llm.invoke(f"다음 주제로 글을 써줘: {state['topic']}")
    return {"draft": draft.content, "iteration": state.get("iteration", 0)}

def reflect_node(state):
    """자기 비판"""
    critique = llm.invoke(
        f"다음 글의 문제점을 분석해줘:\n{state['draft']}"
    )
    return {"critique": critique.content}

def revise_node(state):
    """개선"""
    revised = llm.invoke(
        f"원본:\n{state['draft']}\n\n비판:\n{state['critique']}\n\n개선된 버전:"
    )
    return {
        "draft": revised.content,
        "iteration": state["iteration"] + 1
    }

def should_continue_reflection(state) -> str:
    # 3번 반복하거나 품질이 충분하면 종료
    if state["iteration"] >= 3:
        return "end"
    return "reflect"

graph.add_node("generate", generate_node)
graph.add_node("reflect", reflect_node)
graph.add_node("revise", revise_node)
graph.add_edge("generate", "reflect")
graph.add_edge("reflect", "revise")
graph.add_conditional_edges("revise", should_continue_reflection,
{"reflect": "reflect", "end": END})| 항목 | LangGraph | AutoGen | CrewAI |
|---|---|---|---|
| 제어 수준 | 🟢 매우 높음 | 🟡 중간 | 🟡 중간 |
| 학습 곡선 | 🔴 가파름 | 🟡 중간 | 🟢 완만 |
| 상태 관리 | 🟢 내장 (강력) | 🟡 제한적 | 🟡 제한적 |
| 스트리밍 | 🟢 완벽 지원 | 🟡 부분 지원 | 🟡 부분 지원 |
| Human-in-Loop | 🟢 내장 | 🟢 지원 | 🔴 제한적 |
| 프로덕션 적합성 | 🟢 높음 | 🟡 중간 | 🟡 중간 |
복잡한 상태 관리, 조건 분기, 루프, 멀티 에이전트가 필요할 때 진가를 발휘해!
2024년 말부터 LangGraph Platform(구 LangGraph Cloud)이 정식 출시됐어.
로컬에서 개발한 LangGraph 에이전트를 클라우드에 바로 배포할 수 있는 서비스야.
# langgraph.json 설정 파일
{
  "dependencies": ["."],
  "graphs": {
    "agent": "./my_agent/graph.py:app"
  },
  "env": ".env"
}

# 배포 명령어
langgraph up  # 로컬 테스트
langgraph deploy # 클라우드 배포조건부 엣지를 잘못 설정하면 에이전트가 무한 루프에 빠질 수 있어.
반드시 최대 반복 횟수를 State에 넣고 체크해야 해.
class AgentState(TypedDict):
    messages: Annotated[list, add_messages]
    iteration: int  # 반복 횟수 추적

def should_continue(state: AgentState) -> str:
    # 최대 10번 반복 후 강제 종료
    if state["iteration"] >= 10:
        return "end"
    if state["messages"][-1].tool_calls:
        return "tools"
return "end"도구 실행 중 에러가 나면 에이전트가 멈추지 않고 에러를 처리하도록 해야 해.
from langgraph.prebuilt import ToolNode

# ToolNode는 기본적으로 에러를 메시지로 변환해줌
tool_node = ToolNode(tools, handle_tool_errors=True)

# 커스텀 에러 처리
def safe_tool_node(state):
    try:
        return tool_node.invoke(state)
    except Exception as e:
        return {
            "messages": [
                ToolMessage(
                    content=f"에러 발생: {str(e)}",
                    tool_call_id="error"
                )
            ]
}from pydantic import BaseModel, Field
class AgentState(BaseModel):
messages: list = Field(default_factory=list)
task: str = ""
result: str | None = None
error: str | None = None
iteration: int = 0
class Config:
arbitrary_types_allowed = True
# TypedDict보다 Pydantic이 유효성 검사 + IDE 자동완성 더 잘 됨자 이제 LangGraph에 대해 꽤 깊게 파봤는데ㅋㅋ 정리해보면:
재능넷 같은 플랫폼에서 AI 자동화 서비스를 개발하거나, 복잡한 업무 자동화 에이전트를 만들 때 LangGraph는 진짜 강력한 선택지야.
처음엔 그래프 개념이 낯설어서 진입장벽이 있지만, 한번 익숙해지면 "이거 없이 어떻게 에이전트 만들었지?" 싶을 거임ㅋㅋ
특히 재능넷처럼 다양한 전문가들이 모인 플랫폼에서 LangGraph 기반 AI 에이전트 개발 서비스를 제공하면 꽤 경쟁력 있는 포지션이 될 수 있어. 멀티 에이전트로 복잡한 비즈니스 프로세스를 자동화하는 수요가 폭발적으로 늘고 있거든!
2️⃣ 체크포인터 붙여서 멀티턴 대화 구현
3️⃣ Human-in-the-Loop 추가
4️⃣ 서브그래프로 모듈화
5️⃣ 멀티 에이전트 Supervisor 패턴 도전!
관련 키워드

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.