
Ver3.5 LLaMA 3 모델의 프롬프트 튜닝 방식 완전 정복 가이드
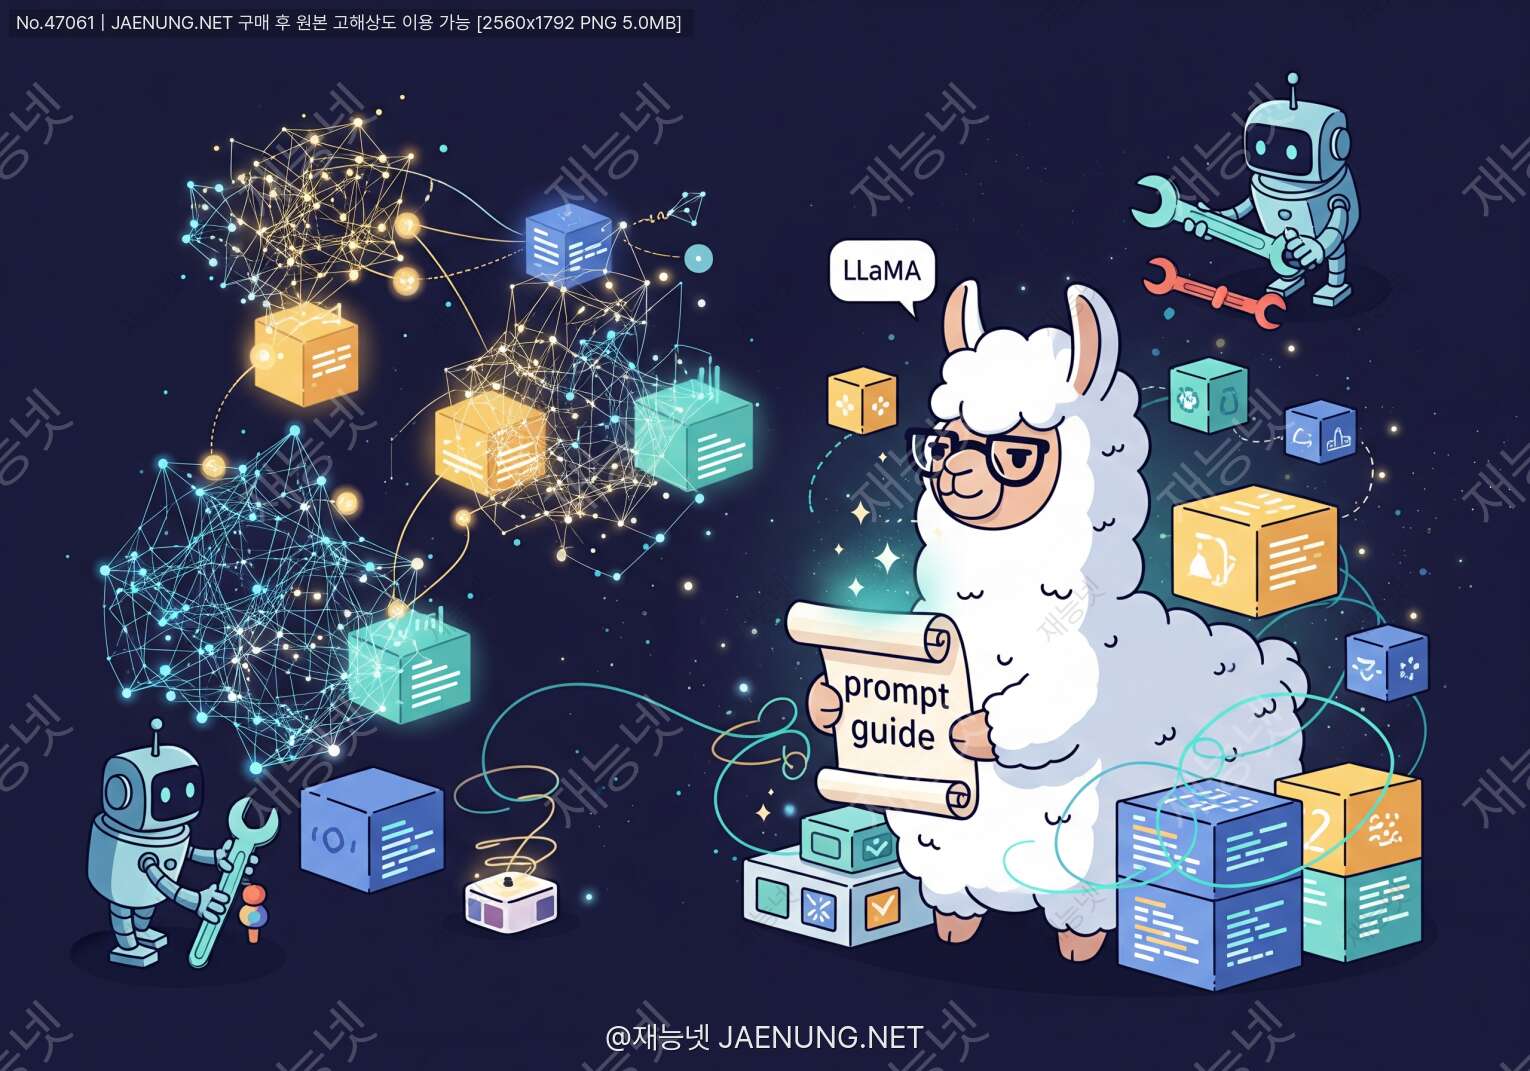
LLaMA 3 모델의 프롬프트 튜닝 방식 완전 정복 가이드
야 진짜 요즘 LLaMA 3 얘기 안 나오는 데가 없잖아 ㅋㅋ
근데 막상 "프롬프트 튜닝 어떻게 해요?" 물어보면 다들 얼버무리는 거 알지?
오늘은 그 베일을 완전히 벗겨버리는 시간~ 🔥
이론부터 실전 코드까지, 진짜 쓸모있는 내용만 모아봤어!
🦙 LLaMA 3가 뭔데 이렇게 핫해?
솔직히 말하면 LLaMA 3 나왔을 때 AI 커뮤니티 반응이 진짜 난리났었잖아 ㅋㅋㅋ
Meta가 2024년 4월에 공개한 LLaMA 3는 오픈소스 LLM 역사에서 진짜 게임체인저급이야.
기존 LLaMA 2 대비 성능이 확 올라갔고, 특히 코딩이나 추론 능력에서 GPT-4에 근접하는 수준을 보여줬거든.
컨텍스트 길이: 8,192 토큰 (기본), 최대 확장 가능
학습 데이터: 15조 토큰 이상 (LLaMA 2의 7배!)
어휘 크기: 128,256 토큰 (LLaMA 2의 4배 확장)
아키텍처: Grouped Query Attention (GQA) 적용
라이선스: Meta Llama 3 Community License (상업적 이용 가능, 조건부)
LLaMA 3의 핵심 개선점 중 하나가 바로 Grouped Query Attention(GQA)야.
기존 Multi-Head Attention 대비 추론 속도가 훨씬 빠르고 메모리 효율도 좋아졌어.
8B 모델 기준으로 일반 소비자 GPU(RTX 3090, 4090)에서도 충분히 돌릴 수 있다는 게 진짜 매력 포인트지 ㅋㅋ
LLaMA 3의 토크나이저 변화 - 이게 왜 중요하냐면
LLaMA 2에서 LLaMA 3로 넘어오면서 토크나이저가 tiktoken 기반으로 바뀌었어.
어휘 크기가 32,000 → 128,256으로 4배 늘었는데, 이게 프롬프트 튜닝할 때 엄청 중요한 포인트야.
왜냐면 한국어, 일본어, 코드 같은 비영어권 텍스트 처리 효율이 확 올라갔거든!
같은 문장을 표현하는 데 필요한 토큰 수가 줄어들어서 컨텍스트 활용도가 높아진 거야.
<|begin_of_text|>, <|start_header_id|>, <|end_header_id|>, <|eot_id|> 같은 새로운 특수 토큰들이 생겼고,이걸 제대로 이해해야 프롬프트 튜닝을 제대로 할 수 있어!
💬 LLaMA 3 공식 프롬프트 포맷 - 이거 모르면 진짜 손해야
LLaMA 3 Instruct 모델을 쓸 때 가장 먼저 알아야 할 게 바로 공식 채팅 템플릿이야.
이 포맷을 제대로 안 지키면 모델이 엉뚱한 답변을 내놓거나 성능이 확 떨어지거든.
실제로 많은 개발자들이 이 부분에서 삽질하는 걸 많이 봤어 ㅋㅋㅋ
LLaMA 3 Instruct 공식 채팅 템플릿 구조
<|begin_of_text|><|start_header_id|>system<|end_header_id|>

당신은 도움이 되는 AI 어시스턴트입니다.<|eot_id|><|start_header_id|>user<|end_header_id|>

안녕하세요! 파이썬으로 피보나치 수열을 구현해주세요.<|eot_id|><|start_header_id|>assistant<|end_header_id|>
위 구조를 보면 알겠지만, 각 역할(system, user, assistant)이 헤더 토큰으로 명확히 구분돼.
그리고 각 메시지 끝에는 반드시 <|eot_id|>(End of Turn ID)가 붙어야 해.
assistant 턴의 마지막에는 <|eot_id|>를 붙이지 않는 게 포인트 - 모델이 계속 생성하도록 열어두는 거야!
멀티턴 대화 구성 방법
<|begin_of_text|><|start_header_id|>system<|end_header_id|>

당신은 파이썬 전문가입니다. 간결하고 명확하게 답변하세요.<|eot_id|>
<|start_header_id|>user<|end_header_id|>

리스트 컴프리헨션이 뭔가요?<|eot_id|>
<|start_header_id|>assistant<|end_header_id|>

리스트 컴프리헨션은 기존 리스트를 기반으로 새 리스트를
간결하게 생성하는 파이썬 문법입니다.<|eot_id|>
<|start_header_id|>user<|end_header_id|>

예시 코드 보여주세요.<|eot_id|>
<|start_header_id|>assistant<|end_header_id|>
Base 모델은 텍스트 완성(text completion) 방식으로 동작하기 때문에,
채팅 포맷 없이 그냥 텍스트를 이어서 쓰는 방식으로 프롬프팅해야 해!
Hugging Face transformers로 채팅 템플릿 자동 적용하기
매번 저 복잡한 포맷 직접 짜기 귀찮잖아 ㅋㅋ
Hugging Face의 apply_chat_template 메서드를 쓰면 자동으로 처리해줘!
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("meta-llama/Meta-Llama-3-8B-Instruct")

messages = [
    {"role": "system", "content": "당신은 도움이 되는 AI 어시스턴트입니다."},
    {"role": "user", "content": "파이썬으로 피보나치 수열을 구현해주세요."},
]

# 채팅 템플릿 자동 적용
input_text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True  # assistant 헤더 자동 추가
)

print(input_text)
# 출력:
# <|begin_of_text|><|start_header_id|>system<|end_header_id|>
# 당신은 도움이 되는 AI 어시스턴트입니다.<|eot_id|>
# <|start_header_id|>user<|end_header_id|>
# 파이썬으로 피보나치 수열을 구현해주세요.<|eot_id|>
# <|start_header_id|>assistant<|end_header_id|>
🎯 LLaMA 3에서 통하는 프롬프트 엔지니어링 기법들
자 이제 진짜 실전이야 ㅋㅋㅋ
LLaMA 3는 GPT-4 API처럼 쓸 수 있는 모델이 아니라 직접 호스팅해서 쓰는 거잖아.
그래서 프롬프트 설계가 더 중요해! 어떤 기법들이 효과적인지 하나씩 파헤쳐보자.
① Zero-shot 프롬프팅
예시 없이 그냥 태스크만 설명하는 방식이야.
LLaMA 3 8B Instruct도 충분히 강력해서 간단한 태스크는 zero-shot으로 잘 처리해.
messages = [
    {
        "role": "system",
        "content": """당신은 감성 분석 전문가입니다.
주어진 텍스트의 감성을 분석하고
'긍정', '부정', '중립' 중 하나로만 답하세요."""
    },
    {
        "role": "user",
        "content": "오늘 날씨가 너무 좋아서 기분이 최고야!"
    }
]
# 예상 출력: 긍정
② Few-shot 프롬프팅 - LLaMA 3에서 특히 효과적!
몇 가지 예시를 보여주면서 패턴을 학습시키는 방식인데,
LLaMA 3는 컨텍스트 학습(in-context learning) 능력이 뛰어나서 few-shot 효과가 진짜 좋아!
messages = [
    {
        "role": "system",
        "content": "당신은 한국어 문장을 영어로 번역하는 전문가입니다."
    },
    {
        "role": "user",
        "content": "안녕하세요"
    },
    {
        "role": "assistant",
        "content": "Hello"
    },
    {
        "role": "user",
        "content": "감사합니다"
    },
    {
        "role": "assistant",
        "content": "Thank you"
    },
    {
        "role": "user",
        "content": "오늘 날씨가 정말 좋네요"  # 실제 번역할 문장
    }
]
③ Chain-of-Thought (CoT) 프롬프팅
복잡한 추론이 필요한 태스크에서 단계별 사고 과정을 유도하는 기법이야.
LLaMA 3 70B에서 특히 효과가 극대화돼!
messages = [
    {
        "role": "system",
        "content": """복잡한 문제를 풀 때 반드시 다음 형식으로 답하세요:
1단계: 문제 파악
2단계: 풀이 과정
3단계: 최종 답변

각 단계를 명확히 구분하여 설명하세요."""
    },
    {
        "role": "user",
        "content": """철수는 사과 5개를 가지고 있었습니다.
영희에게 2개를 주고, 마트에서 3개를 더 샀습니다.
그런데 집에 오다가 1개를 잃어버렸습니다.
철수에게 남은 사과는 몇 개인가요?"""
    }
]LLaMA 3가 자동으로 추론 과정을 펼쳐서 답변 정확도가 올라가!
특히 수학 문제나 논리 추론에서 효과가 엄청나게 좋아.
④ System 프롬프트 최적화 전략
LLaMA 3에서 system 프롬프트는 모델의 전반적인 행동 방식을 결정하는 핵심이야.
잘 짜인 system 프롬프트 하나가 파인튜닝 없이도 엄청난 성능 향상을 가져올 수 있어!
⚙️ PEFT, LoRA, QLoRA - 파인튜닝의 삼총사
자 이제 진짜 핵심 파트야! 🔥
LLaMA 3를 내 도메인에 맞게 튜닝하고 싶은데 GPU가 A100 8장 없잖아 ㅋㅋㅋ
그래서 나온 게 바로 PEFT(Parameter-Efficient Fine-Tuning) 기법들이야.
전체 모델 파라미터를 다 학습시키는 게 아니라 일부만 효율적으로 학습시키는 방법이거든.
LoRA (Low-Rank Adaptation) 이해하기
LoRA의 핵심 아이디어는 진짜 천재적이야.
거대한 가중치 행렬을 직접 업데이트하는 대신, 두 개의 작은 저랭크(low-rank) 행렬의 곱으로 업데이트를 근사하는 거야.
수식으로 표현하면: W' = W + ΔW = W + BA
여기서 B는 (d×r), A는 (r×k) 크기의 행렬이고, r은 랭크(보통 4~64)야.
전체 파라미터의 0.1~1%만 학습시켜도 풀 파인튜닝에 근접한 성능을 낼 수 있어!
lora_alpha: 스케일링 팩터. 보통 r의 2배 설정 (r=16이면 alpha=32)
lora_dropout: 과적합 방지용 드롭아웃. 보통 0.05~0.1
target_modules: LoRA를 적용할 레이어 지정 (q_proj, v_proj 등)
bias: 바이어스 학습 여부 ("none", "all", "lora_only")
QLoRA - 메모리 효율의 끝판왕
QLoRA는 LoRA에 4비트 양자화(NF4 quantization)를 결합한 기법이야.
Tim Dettmers 팀이 2023년에 발표했는데, 이게 나오면서 소비자 GPU로 70B 모델도 파인튜닝할 수 있게 됐어!
LLaMA 3 8B 기준으로 RTX 3090(24GB) 한 장으로도 QLoRA 파인튜닝이 가능해.
| 방법 | LLaMA 3 8B | LLaMA 3 70B |
|---|---|---|
| 풀 파인튜닝 (FP16) | ~160GB | ~1.4TB |
| LoRA (FP16) | ~20GB | ~160GB |
| QLoRA (4bit) | ~10GB | ~48GB |
실전! LLaMA 3 QLoRA 파인튜닝 코드
자 이제 진짜 코드 보여줄게 ㅋㅋ
transformers, peft, bitsandbytes, trl 라이브러리 조합이야.
# 필요 라이브러리 설치
# pip install transformers peft bitsandbytes trl accelerate datasets

import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from trl import SFTTrainer
from datasets import load_dataset

# ===== 1. 모델 및 토크나이저 로드 =====
model_id = "meta-llama/Meta-Llama-3-8B-Instruct"

# 4비트 양자화 설정 (QLoRA)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=True,  # 이중 양자화로 메모리 추가 절약
    bnb_4bit_quant_type="nf4",       # NormalFloat4 양자화
    bnb_4bit_compute_dtype=torch.bfloat16  # 계산은 bfloat16으로
)

# 모델 로드
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True
)

# 토크나이저 로드
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"

# ===== 2. LoRA 설정 =====
lora_config = LoraConfig(
    r=16,                    # 랭크
    lora_alpha=32,           # 스케일링 팩터
    target_modules=[         # LLaMA 3에서 효과적인 타겟 모듈
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj"
    ],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

# kbit 학습을 위한 모델 준비
model = prepare_model_for_kbit_training(model)
model = get_peft_model(model, lora_config)

# 학습 가능한 파라미터 확인
model.print_trainable_parameters()
# 출력 예시: trainable params: 83,886,080 || all params: 8,114,589,696
#            || trainable%: 1.0338
# ===== 3. 데이터셋 준비 =====
# 채팅 형식 데이터셋 예시
def format_chat_template(example):
"""데이터를 LLaMA 3 채팅 포맷으로 변환"""
messages = [
{"role": "system", "content": "당신은 도움이 되는 AI 어시스턴트입니다."},
{"role": "user", "content": example["instruction"]},
{"role": "assistant", "content": example["output"]}
]
text = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=False
)
return {"text": text}
# 데이터셋 로드 및 변환
dataset = load_dataset("your_dataset_name", split="train")
dataset = dataset.map(format_chat_template)
# ===== 4. 학습 설정 =====
training_args = TrainingArguments(
output_dir="./llama3-finetuned",
num_train_epochs=3,
per_device_train_batch_size=2,
gradient_accumulation_steps=4, # 실질적 배치 크기 = 2*4 = 8
warmup_steps=100,
learning_rate=2e-4,
fp16=False,
bf16=True, # bfloat16 사용 (A100, RTX 30/40 시리즈)
logging_steps=10,
save_strategy="epoch",
evaluation_strategy="epoch",
optim="paged_adamw_32bit", # 메모리 효율적인 옵티마이저
lr_scheduler_type="cosine",
report_to="wandb" # W&B 로깅 (선택사항)
)
# ===== 5. SFT 트레이너 설정 및 학습 =====
trainer = SFTTrainer(
model=model,
args=training_args,
train_dataset=dataset,
dataset_text_field="text",
tokenizer=tokenizer,
max_seq_length=2048,
packing=False
)
trainer.train()
# ===== 6. 모델 저장 =====
trainer.save_model("./llama3-finetuned-final")
tokenizer.save_pretrained("./llama3-finetuned-final")model.gradient_checkpointing_enable()을 모델 준비 전에 호출하면 돼.단, 학습 속도가 약 20~30% 느려지는 트레이드오프가 있어!
🧩 Soft Prompt Tuning - 프롬프트를 학습시킨다고?
이거 처음 들으면 "프롬프트를 학습시킨다고??" 싶잖아 ㅋㅋㅋ
Soft Prompt Tuning은 모델 가중치는 전혀 건드리지 않고,
입력 앞에 붙이는 학습 가능한 가상 토큰(soft prompt)만 최적화하는 방법이야.
2021년 Google이 제안한 기법인데, 파라미터 효율성이 극도로 높아!
- 사람이 읽을 수 있는 텍스트로 구성
- 수동으로 설계, 최적화
- 모델 파라미터 변경 없음
- 예: "당신은 전문가입니다. 다음을 분석하세요..."
Soft Prompt (학습 가능한 프롬프트):
- 연속적인 임베딩 벡터 (사람이 읽을 수 없음)
- 그래디언트 기반 최적화
- 모델 파라미터 변경 없음
- 학습 데이터에 맞게 자동 최적화
from peft import PromptTuningConfig, PromptTuningInit, get_peft_model
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "meta-llama/Meta-Llama-3-8B-Instruct"

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_id)

# Soft Prompt Tuning 설정
peft_config = PromptTuningConfig(
    task_type="CAUSAL_LM",
    prompt_tuning_init=PromptTuningInit.TEXT,  # 텍스트로 초기화
    num_virtual_tokens=20,                      # 가상 토큰 수 (20개)
    prompt_tuning_init_text="다음 텍스트를 분류하세요:",  # 초기화 텍스트
    tokenizer_name_or_path=model_id
)

model = get_peft_model(model, peft_config)
model.print_trainable_parameters()
# 출력: trainable params: 40,960 || all params: 8,030,261,248
# 전체 파라미터의 0.0005%만 학습!!! 🤯LLaMA 3 8B 정도면 괜찮지만, 작은 모델(1B 이하)에서는 LoRA 대비 성능이 떨어질 수 있어.
또한 태스크가 매우 특화된 경우에는 LoRA/QLoRA가 더 나은 선택일 수 있어!
📚 파인튜닝 데이터셋 준비 - 쓰레기 넣으면 쓰레기 나와
"Garbage in, garbage out" 이 말 진짜 LLM 파인튜닝에서 100% 맞는 말이야 ㅋㅋ
아무리 좋은 모델이라도 데이터 품질이 구리면 결과도 구려.
LLaMA 3 파인튜닝에서 데이터셋 준비가 전체 작업의 60~70%를 차지한다고 봐도 과언이 아니야!
SFT(Supervised Fine-Tuning) 데이터 형식
LLaMA 3 Instruct 파인튜닝에 가장 많이 쓰이는 데이터 형식은 instruction-response 쌍이야.
# 데이터셋 형식 예시 (JSON Lines)
{
    "instruction": "파이썬으로 버블 정렬 알고리즘을 구현해주세요.",
    "input": "",  # 추가 컨텍스트 (없으면 빈 문자열)
    "output": "def bubble_sort(arr):\n    n = len(arr)\n    for i in range(n):\n        for j in range(0, n-i-1):\n            if arr[j] > arr[j+1]:\n                arr[j], arr[j+1] = arr[j+1], arr[j]\n    return arr"
}

# 멀티턴 대화 형식
{
    "conversations": [
        {"role": "system", "content": "당신은 파이썬 전문가입니다."},
        {"role": "user", "content": "리스트 정렬 방법을 알려주세요."},
        {"role": "assistant", "content": "파이썬에서 리스트를 정렬하는 방법은..."},
        {"role": "user", "content": "역순 정렬은요?"},
        {"role": "assistant", "content": "역순 정렬은 sorted(list, reverse=True)..."}
    ]
}
데이터 품질 관리 체크리스트
데이터 증강 - 적은 데이터로 많은 효과 내기
데이터가 부족할 때 쓸 수 있는 꿀팁이야!
LLaMA 3 자체를 이용해서 데이터를 증강하는 Self-Instruct 방법이 있어.
# Self-Instruct 데이터 증강 예시
# 기존 예시 데이터를 바탕으로 새로운 instruction-response 쌍 생성

augmentation_prompt = """
다음은 AI 어시스턴트 학습용 예시 데이터입니다:

예시 1:
질문: 파이썬에서 딕셔너리를 정렬하는 방법은?
답변: dict(sorted(d.items(), key=lambda x: x[1]))

예시 2:
질문: 리스트에서 중복을 제거하는 방법은?
답변: list(set(original_list))

위 예시들과 유사한 스타일로 파이썬 관련 질문-답변 쌍을 5개 더 생성해주세요.
각 쌍은 JSON 형식으로 출력하세요:
{"question": "...", "answer": "..."}
"""도메인 특화 데이터 수집부터 품질 검수까지 전문가의 도움을 받으면 훨씬 효율적이야.
🚀 추론 최적화 - 빠르게, 더 빠르게!
파인튜닝 다 했다고 끝이 아니야 ㅋㅋ
실제 서비스에 올리려면 추론 속도가 진짜 중요하거든.
LLaMA 3를 빠르게 서빙하는 방법들을 알아보자!
① vLLM - 프로덕션 서빙의 표준
vLLM은 UC Berkeley에서 개발한 LLM 서빙 프레임워크야.
PagedAttention 기술을 사용해서 KV 캐시를 효율적으로 관리하고,
기존 HuggingFace Transformers 대비 24배 이상 처리량이 높아!
# vLLM 설치
# pip install vllm

from vllm import LLM, SamplingParams

# LLaMA 3 모델 로드
llm = LLM(
    model="meta-llama/Meta-Llama-3-8B-Instruct",
    dtype="bfloat16",
    max_model_len=8192,
    gpu_memory_utilization=0.9  # GPU 메모리 90% 활용
)

# 샘플링 파라미터 설정
sampling_params = SamplingParams(
    temperature=0.7,      # 창의성 조절 (0=결정적, 1=창의적)
    top_p=0.9,            # nucleus sampling
    max_tokens=512,       # 최대 생성 토큰 수
    stop=["<|eot_id|>"]  # 생성 중단 토큰
)

# 배치 추론 (여러 프롬프트 동시 처리)
prompts = [
    "<|begin_of_text|><|start_header_id|>user<|end_header_id|>\n\n안녕하세요!<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n",
    "<|begin_of_text|><|start_header_id|>user<|end_header_id|>\n\n파이썬이란?<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
]

outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    print(output.outputs[0].text)
② llama.cpp - CPU/엣지 디바이스 서빙
GPU 없이 CPU로도 LLaMA 3를 돌리고 싶다면 llama.cpp가 정답이야!
C++로 구현된 초경량 추론 엔진인데, GGUF 포맷으로 양자화된 모델을 사용해.
맥북 M1/M2/M3에서도 꽤 쓸만한 속도로 돌아가!
# llama-cpp-python 설치
# pip install llama-cpp-python

from llama_cpp import Llama

# GGUF 포맷 모델 로드 (Hugging Face에서 다운로드 가능)
llm = Llama(
    model_path="./Meta-Llama-3-8B-Instruct-Q4_K_M.gguf",
    n_ctx=8192,      # 컨텍스트 길이
    n_gpu_layers=35, # GPU 레이어 수 (0이면 CPU 전용)
    verbose=False
)

# 채팅 완성 API 사용
response = llm.create_chat_completion(
    messages=[
        {"role": "system", "content": "당신은 도움이 되는 AI입니다."},
        {"role": "user", "content": "안녕하세요!"}
    ],
    temperature=0.7,
    max_tokens=256
)

print(response['choices'][0]['message']['content'])
③ 생성 파라미터 튜닝 - 이것만 알아도 반은 먹고 들어가
| 파라미터 | 범위 | 권장값 | 효과 |
|---|---|---|---|
| temperature | 0.0~2.0 | 0.6~0.8 | 낮을수록 결정적, 높을수록 창의적 |
| top_p | 0.0~1.0 | 0.9 | 누적 확률 임계값 (nucleus sampling) |
| top_k | 1~∞ | 40~50 | 상위 k개 토큰만 고려 |
| repetition_penalty | 1.0~2.0 | 1.1~1.3 | 반복 억제 (1.0=없음) |
| max_new_tokens | 1~8192 | 태스크별 | 최대 생성 토큰 수 |
사실 기반 Q&A: 0.3~0.5
일반 대화: 0.6~0.8
창의적 글쓰기: 0.8~1.2
브레인스토밍: 1.0~1.5
🔬 고급 프롬프트 튜닝 기법들
기본기 다 익혔으면 이제 고급 기법들 알아볼 차례야!
이 기법들 알면 진짜 LLaMA 3 고수 소리 들을 수 있어 ㅋㅋㅋ
① RAG (Retrieval-Augmented Generation)
LLaMA 3의 지식 한계를 극복하는 가장 실용적인 방법이야.
외부 데이터베이스에서 관련 정보를 검색해서 프롬프트에 포함시키는 방식이거든.
환각(hallucination) 문제를 크게 줄일 수 있어!
# RAG 구현 예시 (LangChain + LLaMA 3)
# pip install langchain langchain-community chromadb sentence-transformers

from langchain.vectorstores import Chroma
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.document_loaders import TextLoader

# 1. 문서 로드 및 분할
loader = TextLoader("your_document.txt", encoding="utf-8")
documents = loader.load()

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50
)
chunks = text_splitter.split_documents(documents)

# 2. 임베딩 및 벡터 저장소 생성
embeddings = HuggingFaceEmbeddings(
    model_name="sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
)
vectorstore = Chroma.from_documents(chunks, embeddings)

# 3. 검색 및 프롬프트 구성
def rag_query(question: str, k: int = 3) -> str:
    # 관련 문서 검색
    relevant_docs = vectorstore.similarity_search(question, k=k)
    context = "\n\n".join([doc.page_content for doc in relevant_docs])

    # RAG 프롬프트 구성
    messages = [
        {
            "role": "system",
            "content": f"""당신은 주어진 컨텍스트를 기반으로 질문에 답하는 AI입니다.
컨텍스트에 없는 내용은 "제공된 정보에서 찾을 수 없습니다"라고 답하세요.

[컨텍스트]
{context}"""
        },
        {
            "role": "user",
            "content": question
        }
    ]
    return messages
② Function Calling / Tool Use
LLaMA 3는 공식적으로 Function Calling을 지원해!
모델이 외부 함수나 API를 호출할 수 있도록 프롬프트를 구성하는 방식이야.
이걸 잘 활용하면 LLaMA 3를 진짜 에이전트처럼 쓸 수 있어.
# LLaMA 3 Function Calling 예시
import json

# 사용 가능한 함수 정의
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "특정 도시의 현재 날씨를 가져옵니다",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "날씨를 조회할 도시 이름"
                    },
                    "unit": {
                        "type": "string",
                        "enum": ["celsius", "fahrenheit"],
                        "description": "온도 단위"
                    }
                },
                "required": ["city"]
            }
        }
    }
]

# Function Calling 프롬프트 구성
system_prompt = f"""당신은 도움이 되는 AI 어시스턴트입니다.
다음 도구들을 사용할 수 있습니다:

{json.dumps(tools, ensure_ascii=False, indent=2)}

도구를 사용해야 할 때는 다음 형식으로 응답하세요:
{{"tool_call": {{"name": "함수명", "arguments": {{...}}}}}}"""

messages = [
    {"role": "system", "content": system_prompt},
    {"role": "user", "content": "서울의 현재 날씨가 어때요?"}
]
③ RLHF 대안 - DPO (Direct Preference Optimization)
RLHF(인간 피드백 강화학습)는 구현이 복잡하고 비용이 많이 들잖아.
그래서 나온 게 DPO(Direct Preference Optimization)야!
선호 데이터(chosen/rejected 쌍)만 있으면 강화학습 없이도 RLHF와 유사한 효과를 낼 수 있어.
# DPO 학습 예시 (TRL 라이브러리 활용)
from trl import DPOTrainer, DPOConfig
from datasets import Dataset

# DPO 데이터셋 형식
# chosen: 더 좋은 응답, rejected: 더 나쁜 응답
dpo_data = {
    "prompt": [
        "파이썬에서 예외 처리를 어떻게 하나요?",
        # ... 더 많은 데이터
    ],
    "chosen": [
        "파이썬에서 예외 처리는 try-except 블록을 사용합니다:\n\ntry:\n    # 예외가 발생할 수 있는 코드\n    result = 10 / 0\nexcept ZeroDivisionError as e:\n    print(f'오류 발생: {e}')\nfinally:\n    print('항상 실행됩니다')",
        # ... 더 많은 데이터
    ],
    "rejected": [
        "예외 처리는 try except를 씁니다.",
        # ... 더 많은 데이터
    ]
}

dataset = Dataset.from_dict(dpo_data)

# DPO 설정
dpo_config = DPOConfig(
    beta=0.1,                    # KL 패널티 강도
    max_length=1024,
    max_prompt_length=512,
    output_dir="./llama3-dpo",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    learning_rate=5e-7,
    bf16=True
)

# DPO 트레이너
dpo_trainer = DPOTrainer(
    model=model,
    ref_model=None,  # None이면 자동으로 참조 모델 생성
    args=dpo_config,
    train_dataset=dataset,
    tokenizer=tokenizer
)

dpo_trainer.train()📊 파인튜닝 결과 평가 - 내 모델이 잘 됐는지 어떻게 알아?
학습 다 했다고 끝이 아니야 ㅋㅋ
내 모델이 실제로 잘 됐는지 평가해야 하잖아.
LLaMA 3 파인튜닝 결과를 평가하는 방법들을 알아보자!
자동 평가 지표들
BLEU Score: 번역/요약 품질 평가. 참조 텍스트와의 n-gram 겹침 측정
ROUGE Score: 요약 품질 평가. 재현율 기반 지표
BERTScore: 의미적 유사도 기반 평가. BLEU보다 더 정확한 편
MT-Bench: 멀티턴 대화 능력 평가 (GPT-4 judge 활용)
MMLU: 다양한 도메인 지식 평가 (57개 과목)
# 파인튜닝 모델 평가 코드 예시
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
import math

def calculate_perplexity(model, tokenizer, text: str) -> float:
    """텍스트에 대한 Perplexity 계산"""
    inputs = tokenizer(text, return_tensors="pt").to(model.device)

    with torch.no_grad():
        outputs = model(**inputs, labels=inputs["input_ids"])
        loss = outputs.loss

    perplexity = math.exp(loss.item())
    return perplexity

# 평가 데이터셋으로 평균 PPL 계산
def evaluate_model(model, tokenizer, eval_texts: list) -> dict:
    ppls = []
    for text in eval_texts:
        ppl = calculate_perplexity(model, tokenizer, text)
        ppls.append(ppl)

    return {
        "mean_perplexity": sum(ppls) / len(ppls),
        "min_perplexity": min(ppls),
        "max_perplexity": max(ppls)
    }

# 사용 예시
eval_texts = [
    "파이썬은 간결하고 읽기 쉬운 프로그래밍 언어입니다.",
    "머신러닝은 데이터로부터 패턴을 학습하는 기술입니다.",
    # ... 더 많은 평가 텍스트
]

results = evaluate_model(model, tokenizer, eval_texts)
print(f"평균 Perplexity: {results['mean_perplexity']:.2f}")
LLM-as-Judge 평가 방법
요즘 가장 핫한 평가 방법이야!
GPT-4나 Claude 같은 강력한 모델을 심사위원으로 써서 내 모델 출력을 평가하는 방식이거든.
MT-Bench나 AlpacaEval이 이 방식을 사용해.
# LLM-as-Judge 평가 프롬프트 예시
judge_prompt = """
당신은 AI 응답의 품질을 평가하는 전문 심사위원입니다.

[질문]
{question}

[AI 응답]
{response}

다음 기준으로 1~10점 척도로 평가하세요:
1. 정확성: 정보가 사실에 부합하는가?
2. 완전성: 질문에 충분히 답했는가?
3. 명확성: 이해하기 쉽게 설명했는가?
4. 유용성: 실제로 도움이 되는가?

JSON 형식으로 답하세요:
{{"accuracy": 점수, "completeness": 점수, "clarity": 점수, "usefulness": 점수, "overall": 점수, "reason": "평가 이유"}}
"""
🛠️ 실전 팁 & 트러블슈팅 - 삽질 방지 가이드
이 파트가 진짜 꿀이야 ㅋㅋㅋ
내가 직접 겪었거나 커뮤니티에서 자주 보이는 문제들 모아봤어.
이거 미리 알면 진짜 시간 엄청 절약할 수 있어!
자주 발생하는 문제들과 해결책
해결:
-
per_device_train_batch_size를 1로 줄이고 gradient_accumulation_steps를 늘려-
max_seq_length를 줄여 (2048 → 1024)-
gradient_checkpointing=True 활성화-
torch.cuda.empty_cache() 호출
해결:
- 학습률을 10배 낮춰봐 (2e-4 → 2e-5)
-
max_grad_norm=0.3으로 그래디언트 클리핑 적용- 데이터에 빈 문자열이나 너무 짧은 샘플이 없는지 확인
-
bf16=True 대신 fp16=True 시도
해결:
-
repetition_penalty=1.1~1.3 설정-
temperature를 약간 높여봐- 학습 에포크를 줄여봐 (과적합 방지)
-
no_repeat_ngram_size=3 설정
해결:
- 일반 대화 데이터를 도메인 데이터와 혼합해서 학습 (보통 10~20% 비율)
- LoRA rank를 낮춰서 더 보수적으로 학습
- 학습률을 낮추고 에포크를 줄여
- Replay 기법: 이전 태스크 데이터 일부를 섞어서 학습
성능 향상을 위한 고급 팁들
# LoRA 어댑터를 기본 모델에 병합하기
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

# 기본 모델 로드 (FP16)
base_model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Meta-Llama-3-8B-Instruct",
    torch_dtype=torch.float16,
    device_map="auto"
)

# LoRA 어댑터 로드
model = PeftModel.from_pretrained(base_model, "./llama3-finetuned-final")

# 어댑터 병합 (추론 속도 향상)
model = model.merge_and_unload()

# 병합된 모델 저장
model.save_pretrained("./llama3-merged")
tokenizer.save_pretrained("./llama3-merged")

print("✅ LoRA 병합 완료! 추론 속도가 향상됩니다.")
💼 LLaMA 3 프롬프트 튜닝 실제 활용 사례
이론은 충분히 봤으니까 실제로 어떻게 쓰이는지 보자 ㅋㅋ
다양한 도메인에서 LLaMA 3 파인튜닝이 어떻게 활용되고 있는지 알아볼게!
① 코드 어시스턴트 특화 모델
LLaMA 3는 기본적으로 코딩 능력이 뛰어난데, 특정 언어나 프레임워크에 특화된 파인튜닝을 하면 더 강력해져.
예를 들어 회사 내부 코드베이스 스타일에 맞는 코드를 생성하도록 튜닝할 수 있어.
# 코드 어시스턴트 System 프롬프트 예시
code_assistant_system = """당신은 Python 전문 코드 어시스턴트입니다.

코딩 원칙:
1. PEP 8 스타일 가이드를 엄격히 준수합니다
2. 타입 힌트를 반드시 사용합니다
3. docstring을 Google 스타일로 작성합니다
4. 예외 처리를 항상 포함합니다
5. 단위 테스트 코드도 함께 제공합니다

출력 형식:
- 코드 블록은 ```python으로 시작합니다
- 설명은 코드 위에 간략히 작성합니다
- 주의사항이 있으면 마지막에 ⚠️로 표시합니다"""
② 고객 서비스 챗봇
기업 내부 FAQ, 제품 매뉴얼, 정책 문서를 학습시켜서
회사 특화 고객 서비스 챗봇을 만드는 사례가 많아.
RAG와 결합하면 최신 정보도 반영할 수 있어서 진짜 강력해!
③ 의료/법률 도메인 특화
의료 기록 요약, 법률 문서 분석 같은 전문 도메인에서도 LLaMA 3 파인튜닝이 활발히 사용돼.
물론 이런 분야는 반드시 전문가 검토가 필요하고, 모델 출력을 그대로 신뢰하면 안 돼!
반드시 전문가의 검토와 감수가 필요해.
AI 모델의 출력은 참고 자료로만 활용하고, 최종 판단은 전문가가 해야 해!
④ 한국어 특화 모델 만들기
LLaMA 3는 한국어 처리 능력이 LLaMA 2보다 훨씬 좋아졌어.
하지만 여전히 영어 대비 한국어 성능이 낮은 편이라,
한국어 데이터로 파인튜닝하면 엄청난 성능 향상을 볼 수 있어!
재능넷 같은 플랫폼에서 한국어 AI 서비스를 개발하는 분들에게 특히 유용한 접근법이야.
# 한국어 특화 파인튜닝을 위한 데이터 준비 팁
# 한국어 고품질 데이터셋 예시들:
# - KoAlpaca: 한국어 instruction 데이터셋
# - KLUE: 한국어 언어 이해 벤치마크
# - AIHub 데이터셋: 다양한 한국어 NLP 데이터

# 한국어 토크나이저 효율 확인
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("meta-llama/Meta-Llama-3-8B-Instruct")

# LLaMA 3 vs LLaMA 2 한국어 토큰화 비교
text_ko = "안녕하세요, 저는 인공지능 개발자입니다."

tokens_llama3 = tokenizer.encode(text_ko)
print(f"LLaMA 3 토큰 수: {len(tokens_llama3)}")
# LLaMA 3: ~15개 토큰 (LLaMA 2 대비 약 40% 감소!)

# 한국어 특화 System 프롬프트
korean_system = """당신은 한국어를 모국어로 사용하는 AI 어시스턴트입니다.

언어 규칙:
- 항상 자연스러운 한국어로 답변합니다
- 존댓말을 기본으로 사용합니다
- 한국 문화와 정서를 이해하고 반영합니다
- 외래어는 한국어 표기법에 맞게 사용합니다
- 필요한 경우 영어 원문을 괄호 안에 병기합니다"""
🔮 LLaMA 3 관련 최신 트렌드 & 앞으로의 방향
AI 분야는 진짜 빠르게 변하잖아 ㅋㅋ
LLaMA 3 생태계에서 지금 가장 핫한 트렌드들을 정리해봤어!
① LLaMA 3.1 / 3.2 - 업그레이드 버전들
Meta는 LLaMA 3 이후에도 계속 업데이트를 내놓고 있어.
LLaMA 3.1은 128K 컨텍스트 길이를 지원하고, 405B 파라미터 모델도 공개했어.
LLaMA 3.2는 멀티모달(이미지 이해) 기능이 추가됐고, 1B/3B 경량 모델도 나왔어.
이 모델들도 기본적으로 같은 프롬프트 포맷을 사용하니까 이 글에서 배운 내용이 그대로 적용돼!
2024년 7월: LLaMA 3.1 8B, 70B, 405B 공개 (128K 컨텍스트)
2024년 9월: LLaMA 3.2 1B, 3B, 11B, 90B 공개 (멀티모달 포함)
2024년 12월: LLaMA 3.3 70B 공개 (405B 수준 성능을 70B로!)
② Unsloth - 2~5배 빠른 파인튜닝
Unsloth는 LLaMA 3 파인튜닝을 2~5배 빠르게 해주는 라이브러리야.
커스텀 CUDA 커널을 사용해서 메모리 효율도 크게 개선했어.
HuggingFace PEFT와 완전 호환되면서 속도는 훨씬 빠르니까 진짜 추천해!
# Unsloth로 LLaMA 3 파인튜닝 (2~5배 빠름!)
# pip install unsloth

from unsloth import FastLanguageModel
import torch

# 모델 로드 (Unsloth 최적화 버전)
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="unsloth/Meta-Llama-3-8B-Instruct",
    max_seq_length=2048,
    dtype=None,          # 자동 감지
    load_in_4bit=True,   # QLoRA
)

# LoRA 설정 (Unsloth 최적화)
model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                    "gate_proj", "up_proj", "down_proj"],
    lora_alpha=16,
    lora_dropout=0,      # Unsloth는 0 권장
    bias="none",
    use_gradient_checkpointing="unsloth",  # Unsloth 최적화
    random_state=42,
)

print("✅ Unsloth 모델 준비 완료! 기존 대비 2~5배 빠른 학습 가능")
③ 멀티모달 프롬프트 튜닝
LLaMA 3.2부터 이미지를 이해할 수 있는 멀티모달 모델이 나왔어.
텍스트뿐만 아니라 이미지도 프롬프트에 포함할 수 있게 됐는데,
이 분야도 빠르게 발전하고 있어서 앞으로 더 많은 가능성이 열릴 것 같아!
# LLaMA 3.2 Vision 멀티모달 프롬프트 예시
from transformers import MllamaForConditionalGeneration, AutoProcessor
from PIL import Image
import requests

model_id = "meta-llama/Llama-3.2-11B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)
processor = AutoProcessor.from_pretrained(model_id)

# 이미지 + 텍스트 멀티모달 프롬프트
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},  # 이미지 플레이스홀더
            {"type": "text", "text": "이 이미지에서 무엇이 보이나요? 자세히 설명해주세요."}
        ]
    }
]

# 이미지 로드
image = Image.open("your_image.jpg")

# 입력 처리
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(image, input_text, return_tensors="pt").to(model.device)

# 생성
output = model.generate(**inputs, max_new_tokens=256)
print(processor.decode(output[0]))
🎯 핵심 정리 - 이것만 기억해!
자 오늘 진짜 많은 내용을 다뤘는데 ㅋㅋㅋ
핵심만 딱 정리해줄게!
<|begin_of_text|>, <|start_header_id|> 등)를 반드시 지켜야 해
LLaMA 3 프롬프트 튜닝은 진짜 배우면 배울수록 재밌는 분야야.
처음엔 복잡해 보여도 하나씩 따라하다 보면 금방 익숙해지거든!
이 글에서 다룬 내용들을 직접 실습해보면서 자신만의 모델을 만들어봐 ㅋㅋ
궁금한 점이나 더 알고 싶은 내용이 있으면 AI/머신러닝 커뮤니티나 Hugging Face 포럼을 적극 활용해봐!
그리고 전문적인 도움이 필요하다면 재능 공유 플랫폼을 통해 AI 전문가를 찾아보는 것도 좋은 방법이야. 🚀

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.