
Ver3.5 AI 에이전트 협업: Writer + Reviewer + Publisher 모델
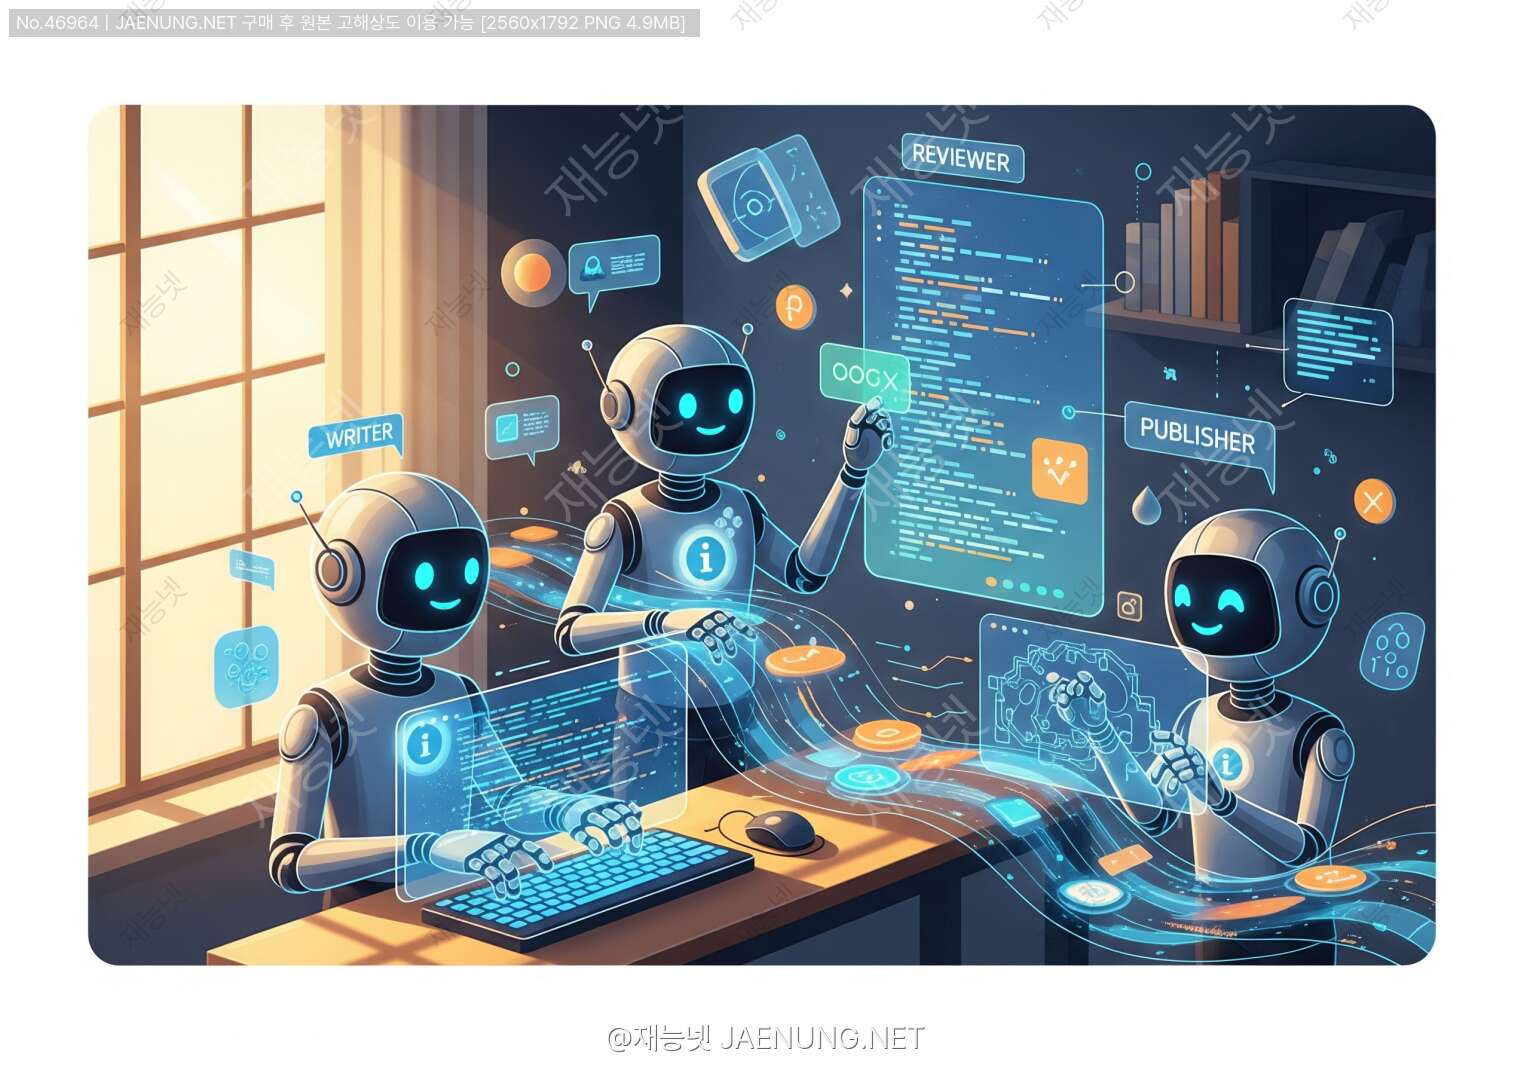
AI 에이전트 협업: Writer + Reviewer + Publisher 모델
혼자 다 하려다 번아웃 온 AI 시대는 끝났다ㅋㅋ
이제는 AI끼리 팀플하는 시대! 🚀
야 솔직히 말해봐. 처음에 ChatGPT 같은 AI 써봤을 때 "오 이거 다 해주네?" 했다가 막상 복잡한 작업 시키면 뭔가 아쉬운 느낌 받은 적 있지 않아? 🤔
예를 들어서 블로그 글 써달라고 했는데 내용이 좀 허술하다거나, 코드 짜달라고 했는데 버그가 있다거나... 그런 경험 있잖아ㅋㅋ
그 이유가 뭔지 알아? 단일 AI 에이전트 하나한테 "기획하고, 작성하고, 검토하고, 배포까지 다 해!" 라고 시키는 게 사실 말이 안 되는 거거든. 사람도 혼자 다 하면 퀄리티가 떨어지잖아. 그래서 나온 개념이 바로 멀티 에이전트 협업 시스템이야!
오늘은 그 중에서도 실무에서 진짜 많이 쓰이는 Writer + Reviewer + Publisher 모델에 대해서 완전 깊게 파봐볼 거야. 개발자든 기획자든 AI 자동화에 관심 있는 사람이라면 이거 알아두면 진짜 레벨업 가능함 💪
먼저 기초부터 잡고 가자. AI 에이전트(AI Agent)란 단순히 질문에 답하는 게 아니라, 목표를 설정하고, 계획을 세우고, 도구를 사용하면서 스스로 작업을 완료하는 AI를 말해.
그리고 이런 에이전트가 여러 개 모여서 서로 역할을 나눠 협업하는 게 바로 멀티 에이전트 시스템(Multi-Agent System, MAS)이야.
위 그림처럼 단일 에이전트는 혼자 모든 걸 처리하려다 보니 퀄리티가 떨어지고, 멀티 에이전트는 각자 전문 역할을 맡아서 훨씬 좋은 결과를 만들어내는 거야.
이 개념은 사실 소프트웨어 공학에서 오래전부터 쓰던 관심사 분리(Separation of Concerns) 원칙을 AI에 적용한 거거든. 새로운 개념이 아니라 검증된 원칙을 AI에 맞게 진화시킨 거지 😎
자, 이제 본격적으로 각 역할을 파헤쳐보자. 첫 번째는 Writer 에이전트야.
Writer 에이전트는 말 그대로 콘텐츠를 생성하는 역할을 담당해. 근데 단순히 글만 쓰는 게 아니야. 코드를 작성하거나, 데이터를 분석해서 보고서를 만들거나, API 응답을 생성하는 등 다양한 형태의 "아웃풋"을 만들어내는 에이전트야.
실제로 어떻게 구현하는지 코드로 보여줄게. LangChain 기반으로 간단하게 Writer 에이전트를 만드는 예시야:
from langchain.agents import AgentExecutor, create_openai_tools_agent
from langchain_openai import ChatOpenAI
from langchain.tools import tool
from langchain.prompts import ChatPromptTemplate, MessagesPlaceholder

# Writer 에이전트용 LLM 설정
writer_llm = ChatOpenAI(
    model="gpt-4o",
    temperature=0.7  # 창의성을 위해 약간 높게 설정
)

# Writer 에이전트 시스템 프롬프트
WRITER_SYSTEM_PROMPT = """
당신은 전문 콘텐츠 작성 에이전트입니다.
주어진 주제와 요구사항을 바탕으로 고품질 콘텐츠를 생성하세요.

규칙:
1. 명확하고 구조화된 내용을 작성하세요
2. 사실에 기반한 정보만 포함하세요
3. 독자의 수준에 맞는 언어를 사용하세요
4. 작성 완료 후 [DRAFT_COMPLETE] 태그를 붙이세요
"""

# Writer 에이전트가 사용할 도구들
@tool
def search_web(query: str) -> str:
    """웹에서 최신 정보를 검색합니다."""
    # 실제 구현에서는 검색 API 연동
    return f"'{query}'에 대한 검색 결과..."

@tool
def get_template(content_type: str) -> str:
    """콘텐츠 유형에 맞는 템플릿을 가져옵니다."""
    templates = {
        "blog": "# 제목\n## 서론\n## 본론\n## 결론",
        "report": "# 보고서\n## 요약\n## 분석\n## 권고사항",
        "code": "# 코드 설명\n## 목적\n## 구현\n## 사용법"
    }
    return templates.get(content_type, "기본 템플릿")

writer_tools = [search_web, get_template]

# Writer 에이전트 프롬프트 구성
writer_prompt = ChatPromptTemplate.from_messages([
    ("system", WRITER_SYSTEM_PROMPT),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad")
])

# Writer 에이전트 생성
writer_agent = create_openai_tools_agent(
    llm=writer_llm,
    tools=writer_tools,
    prompt=writer_prompt
)

writer_executor = AgentExecutor(
    agent=writer_agent,
    tools=writer_tools,
    verbose=True,
    max_iterations=5
)
코드 보면 알겠지만 Writer 에이전트는 temperature를 0.7로 설정해서 창의성을 좀 살려줬어. 그리고 웹 검색이나 템플릿 가져오기 같은 도구들을 활용할 수 있게 해줬고.
여기서 중요한 포인트가 있어. Writer 에이전트는 자기 결과물이 완벽하다고 생각하면 안 돼. 항상 "이건 초안(Draft)이야, 검토받아야 해"라는 마인드셋을 갖도록 프롬프트를 설계해야 해. 그래서 [DRAFT_COMPLETE] 태그 같은 걸 붙이게 하는 거야.
| 활용 분야 | Writer 에이전트 역할 | 주요 도구 |
|---|---|---|
| 📝 콘텐츠 마케팅 | 블로그 포스트, SNS 카피 생성 | 웹 검색, 트렌드 분석 API |
| 💻 소프트웨어 개발 | 코드 작성, 문서화 | 코드 실행기, GitHub API |
| 📊 데이터 분석 | 분석 보고서 작성 | 데이터베이스, 시각화 도구 |
| 📧 비즈니스 커뮤니케이션 | 이메일, 제안서 작성 | CRM 시스템, 템플릿 DB |
| 🎓 교육 콘텐츠 | 강의 자료, 퀴즈 생성 | 교육 DB, 난이도 조절 도구 |
자 이제 진짜 핵심이야. Reviewer 에이전트는 이 시스템에서 가장 중요한 역할을 해. 왜냐고? Writer가 아무리 잘 써도 오류가 있을 수 있고, Publisher가 아무리 잘 배포해도 내용이 잘못됐으면 말짱 도루묵이잖아ㅋㅋ
Reviewer 에이전트는 Writer가 만든 결과물을 다각도로 검토하고 피드백을 제공하는 역할이야. 단순히 "좋아요/나빠요"가 아니라 구체적인 개선 방향을 제시해야 해.
Reviewer 에이전트가 뭘 봐야 하는지 구체적으로 알아보자. 그냥 "좋은지 나쁜지" 판단하는 게 아니라 체계적인 루브릭(Rubric)을 가지고 평가해야 해:
완성도 요구사항이 모두 충족됐는지 확인
논리 일관성 내용의 흐름과 구조가 맞는지
가독성 대상 독자가 이해하기 쉬운지
보안 검토 민감한 정보 노출이나 위험 요소 없는지
규정 준수 법적/윤리적 기준을 충족하는지
스타일 일관성 브랜드 가이드라인이나 스타일 가이드 준수
최신성 정보가 최신 상태인지 (특히 기술 문서)
from pydantic import BaseModel
from typing import Literal, List
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

# 리뷰 결과 스키마 정의
class ReviewResult(BaseModel):
    status: Literal["APPROVED", "REVISION_NEEDED", "REJECTED"]
    score: float  # 0.0 ~ 1.0
    issues: List[str]  # 발견된 문제점들
    suggestions: List[str]  # 개선 제안사항들
    critical_errors: List[str]  # 치명적 오류 (있으면 REJECTED)

# Reviewer 에이전트용 LLM (낮은 temperature로 일관성 확보)
reviewer_llm = ChatOpenAI(
    model="gpt-4o",
    temperature=0.1  # 일관된 평가를 위해 낮게 설정
).with_structured_output(ReviewResult)

REVIEWER_SYSTEM_PROMPT = """
당신은 엄격하고 공정한 콘텐츠 검토 에이전트입니다.
주어진 콘텐츠를 다음 기준으로 평가하세요:

평가 기준:
1. 사실 정확성 (30점): 정보의 정확성과 출처 신뢰성
2. 완성도 (25점): 요구사항 충족 여부
3. 논리 일관성 (20점): 내용의 흐름과 구조
4. 가독성 (15점): 명확성과 이해도
5. 규정 준수 (10점): 법적/윤리적 기준

판정 기준:
- APPROVED: 점수 0.8 이상, 치명적 오류 없음
- REVISION_NEEDED: 점수 0.5~0.8, 수정 가능한 문제 있음
- REJECTED: 점수 0.5 미만 또는 치명적 오류 존재

반드시 구체적인 피드백을 제공하세요.
"""

reviewer_prompt = ChatPromptTemplate.from_messages([
    ("system", REVIEWER_SYSTEM_PROMPT),
    ("human", """
검토 대상 콘텐츠:
{content}

원본 요구사항:
{requirements}

위 콘텐츠를 평가하고 구조화된 피드백을 제공하세요.
""")
])

# Reviewer 체인 구성
reviewer_chain = reviewer_prompt | reviewer_llm

# 실제 리뷰 실행
def review_content(content: str, requirements: str) -> ReviewResult:
    result = reviewer_chain.invoke({
        "content": content,
        "requirements": requirements
    })
    return result
여기서 중요한 포인트! Reviewer 에이전트는 temperature를 0.1로 낮게 설정했어. 왜냐면 평가는 일관성이 중요하거든. Writer는 창의적이어야 하니까 temperature를 높이고, Reviewer는 객관적이어야 하니까 낮추는 거야. 이게 진짜 중요한 설계 포인트야 👀
또 with_structured_output(ReviewResult)를 써서 리뷰 결과를 구조화된 형태로 받아. 그래야 Publisher나 오케스트레이터가 이 결과를 파싱해서 다음 행동을 결정할 수 있거든.
Writer가 만들고, Reviewer가 검토했으면 이제 Publisher 에이전트가 등장할 차례야! Publisher는 검토 완료된 콘텐츠를 실제 목적지에 배포하는 역할이야.
근데 Publisher가 단순히 "업로드 버튼 누르는 애"라고 생각하면 오산이야ㅋㅋ Publisher는 생각보다 훨씬 많은 일을 해:
2. 메타데이터 추가 - SEO 태그, 카테고리, 태그, 작성일 등 메타정보 자동 생성
3. 배포 채널 선택 - 블로그, SNS, 이메일, API 등 적절한 채널로 라우팅
4. 스케줄링 - 최적의 발행 시간 계산 및 예약 발행
5. 배포 후 모니터링 - 배포 성공 여부 확인 및 오류 처리
6. 버전 관리 - 이전 버전 백업 및 변경 이력 기록
from typing import Dict, Any, List
from enum import Enum
import asyncio

class PublishChannel(Enum):
    BLOG = "blog"
    GITHUB = "github"
    SLACK = "slack"
    EMAIL = "email"
    DATABASE = "database"
    API = "api"

class PublisherAgent:
    def __init__(self, llm, available_channels: List[PublishChannel]):
        self.llm = llm
        self.available_channels = available_channels
        self.publish_history = []

    async def prepare_content(
        self,
        content: str,
        target_channel: PublishChannel
    ) -> Dict[str, Any]:
        """채널에 맞게 콘텐츠 포맷 변환"""

        format_prompts = {
            PublishChannel.BLOG: "HTML 형식으로 변환, SEO 메타태그 추가",
            PublishChannel.GITHUB: "마크다운 형식 유지, README 구조 적용",
            PublishChannel.SLACK: "Slack Block Kit 형식으로 변환",
            PublishChannel.EMAIL: "HTML 이메일 템플릿 적용",
        }

        prompt = format_prompts.get(target_channel, "원본 형식 유지")

        # LLM으로 포맷 변환
        formatted = await self.llm.ainvoke(
            f"다음 콘텐츠를 {prompt}:\n\n{content}"
        )

        return {
            "content": formatted.content,
            "channel": target_channel.value,
            "metadata": self._generate_metadata(content, target_channel)
        }

    def _generate_metadata(
        self,
        content: str,
        channel: PublishChannel
    ) -> Dict:
        """메타데이터 자동 생성"""
        import datetime
        return {
            "published_at": datetime.datetime.now().isoformat(),
            "channel": channel.value,
            "version": len(self.publish_history) + 1,
            "word_count": len(content.split()),
            "status": "published"
        }

    async def publish(
        self,
        content: str,
        channels: List[PublishChannel],
        schedule_time: str = None
    ) -> Dict[str, Any]:
        """실제 배포 실행"""

        results = {}

        # 여러 채널에 동시 배포 (비동기 처리)
        tasks = []
        for channel in channels:
            if channel in self.available_channels:
                task = self._publish_to_channel(content, channel)
                tasks.append((channel, task))

        # 병렬 실행
        for channel, task in tasks:
            try:
                result = await task
                results[channel.value] = {
                    "status": "success",
                    "result": result
                }
            except Exception as e:
                results[channel.value] = {
                    "status": "failed",
                    "error": str(e)
                }

        # 배포 이력 기록
        self.publish_history.append({
            "channels": [c.value for c in channels],
            "results": results
        })

        return results

    async def _publish_to_channel(
        self,
        content: str,
        channel: PublishChannel
    ) -> str:
        """채널별 실제 배포 로직"""
        prepared = await self.prepare_content(content, channel)

        # 실제 구현에서는 각 채널 API 호출
        channel_apis = {
            PublishChannel.BLOG: self._post_to_blog,
            PublishChannel.GITHUB: self._commit_to_github,
            PublishChannel.SLACK: self._send_to_slack,
        }

        api_func = channel_apis.get(channel)
        if api_func:
            return await api_func(prepared)

        return f"{channel.value}에 배포 완료"
Publisher 에이전트의 핵심은 비동기(async) 처리야. 여러 채널에 동시에 배포할 때 순차적으로 하면 너무 느리거든. asyncio를 활용해서 병렬로 처리하면 훨씬 빠르게 배포할 수 있어.
그리고 배포 이력을 publish_history에 기록하는 것도 중요해. 나중에 "언제 어디에 배포했는지" 추적할 수 있어야 하거든. 이게 없으면 나중에 문제 생겼을 때 디버깅이 진짜 힘들어짐ㅋㅋ
Writer, Reviewer, Publisher 세 에이전트가 있는데, 이들을 누가 조율하냐고? 바로 오케스트레이터(Orchestrator)야!
오케스트레이터는 전체 워크플로우를 관리하고, 각 에이전트 간의 통신을 조율하고, 상태를 추적하는 역할이야. 마치 오케스트라의 지휘자처럼 각 파트가 제때 제 역할을 하도록 이끄는 거지.
요즘 멀티 에이전트 시스템 구현할 때 가장 많이 쓰이는 게 LangGraph야. LangGraph는 에이전트 워크플로우를 상태 기계(State Machine) 형태로 정의할 수 있게 해줘서 복잡한 분기 로직도 깔끔하게 처리할 수 있어:
from langgraph.graph import StateGraph, END
from typing import TypedDict, Annotated
import operator

# 전체 워크플로우 상태 정의
class WorkflowState(TypedDict):
    # 입력
    task: str
    requirements: str

    # 중간 결과물
    draft: str
    review_result: dict

    # 제어 변수
    iteration_count: int
    max_iterations: int

    # 최종 결과
    final_content: str
    publish_results: dict

    # 메시지 히스토리
    messages: Annotated[list, operator.add]

# 각 노드 함수 정의
def writer_node(state: WorkflowState) -> WorkflowState:
    """Writer 에이전트 실행"""

    # 첫 번째 실행인지, 수정 요청인지 확인
    if state["iteration_count"] == 0:
        prompt = f"""
        작업: {state['task']}
        요구사항: {state['requirements']}

        위 내용을 바탕으로 고품질 초안을 작성하세요.
        """
    else:
        # 이전 리뷰 피드백 반영
        feedback = state["review_result"].get("suggestions", [])
        issues = state["review_result"].get("issues", [])

        prompt = f"""
        이전 초안: {state['draft']}

        발견된 문제점: {issues}
        개선 제안: {feedback}

        위 피드백을 반영하여 초안을 개선하세요.
        """

    # Writer 에이전트 실행
    result = writer_executor.invoke({"input": prompt})

    return {
        **state,
        "draft": result["output"],
        "iteration_count": state["iteration_count"] + 1,
        "messages": [f"[Writer] 초안 생성 완료 (반복 {state['iteration_count'] + 1}회)"]
    }

def reviewer_node(state: WorkflowState) -> WorkflowState:
    """Reviewer 에이전트 실행"""

    review = review_content(
        content=state["draft"],
        requirements=state["requirements"]
    )

    return {
        **state,
        "review_result": review.dict(),
        "messages": [f"[Reviewer] 검토 완료: {review.status} (점수: {review.score:.2f})"]
    }

def publisher_node(state: WorkflowState) -> WorkflowState:
    """Publisher 에이전트 실행"""

    import asyncio
    publisher = PublisherAgent(
        llm=ChatOpenAI(model="gpt-4o"),
        available_channels=[PublishChannel.BLOG, PublishChannel.DATABASE]
    )

    results = asyncio.run(publisher.publish(
        content=state["draft"],
        channels=[PublishChannel.BLOG, PublishChannel.DATABASE]
    ))

    return {
        **state,
        "final_content": state["draft"],
        "publish_results": results,
        "messages": [f"[Publisher] 배포 완료: {list(results.keys())}"]
    }

# 라우팅 로직 (핵심!)
def should_continue(state: WorkflowState) -> str:
    """리뷰 결과에 따라 다음 단계 결정"""

    review = state["review_result"]
    status = review.get("status")
    iteration = state["iteration_count"]
    max_iter = state["max_iterations"]

    if status == "APPROVED":
        return "publish"  # 승인 → 배포
    elif status == "REJECTED":
        return "end"  # 거절 → 종료 (사람 개입 필요)
    elif iteration >= max_iter:
        return "end"  # 최대 반복 초과 → 종료
    else:
        return "revise"  # 수정 필요 → Writer로 돌아가기

# LangGraph 워크플로우 구성
workflow = StateGraph(WorkflowState)

# 노드 추가
workflow.add_node("writer", writer_node)
workflow.add_node("reviewer", reviewer_node)
workflow.add_node("publisher", publisher_node)

# 엣지 연결
workflow.set_entry_point("writer")
workflow.add_edge("writer", "reviewer")

# 조건부 엣지 (핵심 분기 로직)
workflow.add_conditional_edges(
    "reviewer",
    should_continue,
    {
        "publish": "publisher",
        "revise": "writer",
        "end": END
    }
)
workflow.add_edge("publisher", END)

# 컴파일
app = workflow.compile()

# 실행
result = app.invoke({
    "task": "AI 에이전트 협업에 관한 기술 블로그 포스트 작성",
    "requirements": "1000자 이상, 코드 예시 포함, 초보자도 이해 가능",
    "draft": "",
    "review_result": {},
    "iteration_count": 0,
    "max_iterations": 3,
    "final_content": "",
    "publish_results": {},
    "messages": []
})
LangGraph의 핵심은 조건부 엣지(Conditional Edges)야. should_continue 함수가 리뷰 결과에 따라 다음 노드를 동적으로 결정해. 승인이면 Publisher로, 수정 필요면 Writer로 돌아가고, 거절이면 종료하는 거지.
이 패턴이 바로 Human-in-the-Loop 설계와도 연결돼. REJECTED 상태일 때 사람이 개입해서 방향을 재설정할 수 있도록 설계하는 거야.
이론은 충분히 봤으니까 이제 실제로 어디서 이 모델이 쓰이는지 알아보자. 생각보다 훨씬 다양한 분야에서 활용되고 있어서 놀랄 수도 있어ㅋㅋ
Writer 에이전트: JWT 기반 인증 코드 작성, 단위 테스트 코드 생성
Reviewer 에이전트: 보안 취약점 검토(SQL 인젝션, XSS 등), 코드 품질 분석, 테스트 커버리지 확인
Publisher 에이전트: GitHub PR 생성, CI/CD 파이프라인 트리거, 문서 자동 업데이트
결과: 개발자는 최종 PR만 리뷰하면 됨. 반복적인 코드 리뷰 시간 70% 단축!
Writer 에이전트: 키워드 분석 후 SEO 최적화된 블로그 포스트 초안 작성
Reviewer 에이전트: 사실 정확성 확인, 브랜드 톤앤매너 체크, 표절 검사, SEO 점수 평가
Publisher 에이전트: WordPress/Notion 자동 업로드, SNS 자동 공유, 이메일 뉴스레터 발송
결과: 콘텐츠 제작 시간 80% 단축, 일관된 품질 유지
Writer 에이전트: DB에서 데이터 쿼리, 통계 분석, 시각화 차트 생성, 인사이트 도출
Reviewer 에이전트: 수치 정확성 검증, 분석 방법론 적절성 확인, 결론의 논리적 타당성 검토
Publisher 에이전트: PDF 보고서 생성, 이메일 자동 발송, 대시보드 업데이트
결과: 매주 수동으로 하던 보고서 작업이 완전 자동화!
Writer 에이전트: 학습 목표 설정, 단계별 커리큘럼 작성, 예제 코드 생성, 퀴즈 문제 출제
Reviewer 에이전트: 난이도 적절성 검토, 내용 정확성 확인, 학습 흐름 검토, 중복 내용 제거
Publisher 에이전트: LMS 플랫폼 자동 업로드, 수강생 알림 발송, 강의 자료 PDF 변환
결과: 강사는 최종 검토만 하면 되니까 강의 준비 시간이 대폭 줄어들어!
Reviewer를 하나만 쓰는 게 아니라 여러 개를 병렬로 돌리는 패턴이야. 각 Reviewer가 다른 관점에서 검토하는 거지:
# 멀티 Reviewer 패턴
class MultiReviewerSystem:
    def __init__(self):
        # 각 전문 분야별 Reviewer
        self.reviewers = {
            "factual": FactualReviewer(),      # 사실 정확성 전문
            "security": SecurityReviewer(),    # 보안 전문
            "style": StyleReviewer(),          # 스타일/가독성 전문
            "seo": SEOReviewer(),              # SEO 최적화 전문
        }

    async def parallel_review(self, content: str) -> dict:
        """모든 Reviewer를 병렬로 실행"""
        import asyncio

        tasks = {
            name: reviewer.review(content)
            for name, reviewer in self.reviewers.items()
        }

        results = await asyncio.gather(*tasks.values())

        # 결과 통합
        combined_result = {
            name: result
            for name, result in zip(tasks.keys(), results)
        }

        # 최종 판정: 모든 Reviewer가 통과해야 APPROVED
        all_approved = all(
            r.status == "APPROVED"
            for r in combined_result.values()
        )

        return {
            "final_status": "APPROVED" if all_approved else "REVISION_NEEDED",
            "detailed_reviews": combined_result,
            "aggregated_issues": self._aggregate_issues(combined_result)
        }

    def _aggregate_issues(self, reviews: dict) -> list:
        """모든 리뷰의 이슈를 통합"""
        all_issues = []
        for reviewer_name, review in reviews.items():
            for issue in review.issues:
                all_issues.append(f"[{reviewer_name}] {issue}")
        return all_issues
복잡한 콘텐츠를 만들 때 Writer를 계층적으로 구성하는 패턴이야. 예를 들어 긴 보고서를 만들 때:
↓
섹션 Writer 1 → 서론 작성
섹션 Writer 2 → 본론 1 작성
섹션 Writer 3 → 본론 2 작성
섹션 Writer 4 → 결론 작성
↓
통합 Writer → 각 섹션을 합쳐서 일관성 있는 전체 문서 완성
↓
Reviewer → 전체 문서 검토
↓
Publisher → 배포
이 패턴을 쓰면 병렬 처리가 가능해서 속도가 훨씬 빨라져. 섹션 Writer들이 동시에 각자 담당 섹션을 쓰는 거니까!
Writer가 이전 리뷰 피드백을 기억하고 다음 작업에 반영하는 패턴이야. 이게 없으면 같은 실수를 계속 반복하게 돼:
from langchain.memory import ConversationSummaryMemory
from langchain_openai import ChatOpenAI

class WriterWithMemory:
    def __init__(self):
        self.llm = ChatOpenAI(model="gpt-4o", temperature=0.7)

        # 피드백 메모리 - 이전 리뷰 내용을 요약해서 기억
        self.feedback_memory = ConversationSummaryMemory(
            llm=ChatOpenAI(model="gpt-4o-mini"),
            memory_key="feedback_history",
            return_messages=True
        )

        # 스타일 가이드 메모리 - 승인된 콘텐츠의 패턴 학습
        self.style_memory = []

    def write(self, task: str) -> str:
        # 이전 피드백 히스토리 가져오기
        history = self.feedback_memory.load_memory_variables({})

        # 승인된 스타일 패턴 참고
        style_examples = "\n".join(self.style_memory[-3:])  # 최근 3개

        prompt = f"""
        작업: {task}

        이전 피드백 히스토리:
        {history.get('feedback_history', '없음')}

        승인된 콘텐츠 스타일 예시:
        {style_examples if style_examples else '없음'}

        위 내용을 참고하여 이전 실수를 반복하지 않도록 주의하며 작성하세요.
        """

        result = self.llm.invoke(prompt)
        return result.content

    def update_memory(self, draft: str, review: dict):
        """리뷰 결과를 메모리에 저장"""
        feedback_text = f"작성한 내용에 대한 피드백: {review['issues']}"
        self.feedback_memory.save_context(
            {"input": draft[:200]},  # 초안 요약
            {"output": feedback_text}
        )

        # 승인된 경우 스타일 메모리에 추가
        if review["status"] == "APPROVED":
            self.style_memory.append(draft[:500])  # 승인된 스타일 저장
시스템 만들었으면 잘 돌아가는지 확인해야겠지? 멀티 에이전트 시스템의 성능을 측정하는 핵심 지표들을 알아보자:
import time
import logging
from dataclasses import dataclass, field
from typing import List, Optional
from datetime import datetime

@dataclass
class AgentMetrics:
    """에이전트 성능 지표"""
    agent_name: str
    start_time: float = field(default_factory=time.time)
    end_time: Optional[float] = None
    success: bool = False
    error_message: Optional[str] = None
    token_usage: int = 0

    @property
    def duration(self) -> float:
        if self.end_time:
            return self.end_time - self.start_time
        return 0

class WorkflowMonitor:
    """전체 워크플로우 모니터링"""

    def __init__(self):
        self.sessions = {}
        self.logger = logging.getLogger("WorkflowMonitor")

    def start_session(self, session_id: str, task: str):
        self.sessions[session_id] = {
            "task": task,
            "start_time": datetime.now().isoformat(),
            "metrics": [],
            "iteration_count": 0,
            "final_status": None
        }
        self.logger.info(f"세션 시작: {session_id}")

    def record_agent_run(
        self,
        session_id: str,
        agent_name: str,
        duration: float,
        success: bool,
        token_usage: int = 0
    ):
        if session_id not in self.sessions:
            return

        self.sessions[session_id]["metrics"].append({
            "agent": agent_name,
            "duration": duration,
            "success": success,
            "token_usage": token_usage,
            "timestamp": datetime.now().isoformat()
        })

        if agent_name == "writer":
            self.sessions[session_id]["iteration_count"] += 1

        self.logger.info(
            f"[{session_id}] {agent_name} 완료: "
            f"{'성공' if success else '실패'}, "
            f"{duration:.2f}초, {token_usage}토큰"
        )

    def end_session(self, session_id: str, final_status: str):
        if session_id not in self.sessions:
            return

        session = self.sessions[session_id]
        session["final_status"] = final_status
        session["end_time"] = datetime.now().isoformat()

        # 성능 요약 계산
        total_duration = sum(m["duration"] for m in session["metrics"])
        total_tokens = sum(m["token_usage"] for m in session["metrics"])

        summary = {
            "session_id": session_id,
            "final_status": final_status,
            "total_duration": total_duration,
            "total_tokens": total_tokens,
            "iteration_count": session["iteration_count"],
            "approved": final_status == "APPROVED"
        }

        self.logger.info(f"세션 완료: {summary}")
        return summary

    def get_aggregate_stats(self) -> dict:
        """전체 세션 통계"""
        completed = [
            s for s in self.sessions.values()
            if s.get("final_status")
        ]

        if not completed:
            return {}

        approval_rate = sum(
            1 for s in completed
            if s["final_status"] == "APPROVED"
        ) / len(completed)

        avg_iterations = sum(
            s["iteration_count"] for s in completed
        ) / len(completed)

        return {
            "total_sessions": len(completed),
            "approval_rate": f"{approval_rate:.1%}",
            "avg_iterations": f"{avg_iterations:.1f}",
            "success_rate": f"{approval_rate:.1%}"
        }

# 사용 예시
monitor = WorkflowMonitor()
monitor.start_session("session_001", "블로그 포스트 작성")
# ... 에이전트 실행 ...
monitor.record_agent_run("session_001", "writer", 12.3, True, 850)
monitor.record_agent_run("session_001", "reviewer", 8.7, True, 420)
monitor.record_agent_run("session_001", "publisher", 3.2, True, 150)
stats = monitor.end_session("session_001", "APPROVED")
print(monitor.get_aggregate_stats())
이 모델이 좋다고 해서 막 갖다 쓰면 안 돼. 실제로 구현하다 보면 여러 함정들이 있거든. 미리 알고 피해가자ㅋㅋ
원인: Reviewer의 기준이 너무 높거나, Writer가 피드백을 제대로 반영 못 하거나, 두 에이전트의 기준이 서로 충돌할 때
해결책:
1.
max_iterations 반드시 설정 (보통 3~5회)2. 반복 횟수가 늘어날수록 Reviewer 기준을 점진적으로 낮추는 "관용 증가" 로직 추가
3. 특정 횟수 이상이면 Human-in-the-Loop으로 사람 개입 요청
원인: 각 에이전트가 전체 컨텍스트를 계속 주고받으면서 토큰이 기하급수적으로 증가
해결책:
1. 에이전트 간 전달 시 전체 내용 대신 요약본만 전달
2. Writer는 GPT-4o, Reviewer는 GPT-4o-mini 등 역할에 맞는 모델 선택
3. 캐싱(Caching) 활용 - 같은 내용 반복 처리 방지
4. 토큰 사용량 모니터링 및 알림 설정
원인: 에이전트 간 공유되는 컨텍스트가 부족하거나 형식이 맞지 않음
해결책:
1. 구조화된 메시지 형식(JSON Schema) 사용
2. 공유 상태(Shared State) 객체에 모든 중요 정보 저장
3. 각 에이전트가 이전 단계의 결정 이유를 볼 수 있도록 설계
원인: 장애 처리(Error Handling) 로직 부재
해결책:
1. 각 에이전트에 재시도(Retry) 로직 추가
2. 타임아웃(Timeout) 설정
3. 폴백(Fallback) 에이전트 준비
4. 체크포인트(Checkpoint) 저장으로 중간 결과 보존
Writer + Reviewer + Publisher 모델을 구현할 때 쓸 수 있는 프레임워크들을 비교해볼게. 각각 장단점이 있으니까 상황에 맞게 골라야 해:
| 프레임워크 | 장점 | 단점 | 추천 상황 |
|---|---|---|---|
| LangGraph | 상태 관리 강력, 복잡한 분기 처리 용이, 시각화 지원 | 러닝커브 있음, LangChain 의존성 | 복잡한 워크플로우, 프로덕션 환경 |
| AutoGen | 에이전트 간 대화 자연스러움, Microsoft 지원 | 비결정적 동작, 디버깅 어려움 | 대화형 협업, 연구/프로토타입 |
| CrewAI | 역할 기반 설계 직관적, 빠른 프로토타이핑 | 커스터마이징 제한, 복잡한 로직 구현 어려움 | 빠른 MVP, 간단한 파이프라인 |
| 직접 구현 | 완전한 제어권, 최적화 가능 | 개발 시간 많이 필요, 유지보수 부담 | 특수한 요구사항, 성능 최적화 필요 |
| Semantic Kernel | 엔터프라이즈 친화적, .NET/Python 지원 | 상대적으로 생태계 작음 | 엔터프라이즈 환경, Azure 연동 |
빠른 프로토타이핑을 원한다면 CrewAI가 진짜 편해. 코드 보면 얼마나 직관적인지 알 수 있어:
from crewai import Agent, Task, Crew, Process
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o", temperature=0.7)

# Writer 에이전트 정의
writer = Agent(
    role="콘텐츠 작성 전문가",
    goal="고품질의 정확하고 매력적인 콘텐츠를 작성한다",
    backstory="""
    당신은 10년 경력의 전문 작가입니다.
    다양한 분야의 기술 문서와 마케팅 콘텐츠를 작성해왔으며,
    독자의 눈높이에 맞는 명확한 글쓰기로 유명합니다.
    """,
    llm=llm,
    verbose=True
)

# Reviewer 에이전트 정의
reviewer = Agent(
    role="콘텐츠 품질 검토 전문가",
    goal="콘텐츠의 정확성, 완성도, 품질을 엄격하게 검토한다",
    backstory="""
    당신은 출판사 편집장 출신의 품질 관리 전문가입니다.
    사실 확인, 논리적 일관성, 가독성을 꼼꼼하게 검토하며
    구체적이고 실행 가능한 피드백을 제공합니다.
    """,
    llm=ChatOpenAI(model="gpt-4o", temperature=0.1),
    verbose=True
)

# Publisher 에이전트 정의
publisher = Agent(
    role="콘텐츠 배포 전문가",
    goal="검토 완료된 콘텐츠를 최적의 형태로 배포한다",
    backstory="""
    당신은 디지털 마케팅 전문가로, 다양한 플랫폼에
    콘텐츠를 최적화하여 배포하는 전문가입니다.
    SEO, 포맷 변환, 멀티채널 배포에 능숙합니다.
    """,
    llm=ChatOpenAI(model="gpt-4o-mini", temperature=0.3),
    verbose=True
)

# 태스크 정의
write_task = Task(
    description="""
    주제: {topic}
    요구사항: {requirements}

    위 주제로 고품질 콘텐츠를 작성하세요.
    반드시 사실에 기반하고, 구조적으로 작성하세요.
    """,
    agent=writer,
    expected_output="완성된 콘텐츠 초안 (마크다운 형식)"
)

review_task = Task(
    description="""
    Writer가 작성한 콘텐츠를 검토하세요.

    검토 항목:
    1. 사실 정확성
    2. 논리적 일관성
    3. 완성도
    4. 가독성

    문제가 있으면 구체적인 수정 사항을 제시하고,
    문제가 없으면 APPROVED 판정을 내리세요.
    """,
    agent=reviewer,
    expected_output="검토 결과 보고서 (상태, 점수, 피드백 포함)"
)

publish_task = Task(
    description="""
    검토 완료된 콘텐츠를 배포 준비하세요.

    작업:
    1. HTML 형식으로 변환
    2. SEO 메타태그 추가
    3. 소셜 미디어용 요약본 생성
    4. 배포 체크리스트 완성
    """,
    agent=publisher,
    expected_output="배포 준비 완료된 콘텐츠 패키지"
)

# Crew 구성 및 실행
crew = Crew(
    agents=[writer, reviewer, publisher],
    tasks=[write_task, review_task, publish_task],
    process=Process.sequential,  # 순차 처리
    verbose=True
)

result = crew.kickoff(inputs={
    "topic": "AI 에이전트 협업 시스템의 미래",
    "requirements": "1500자 이상, 기술적 정확성, 초보자 친화적"
})

print(result)
CrewAI 코드 보면 진짜 직관적이지 않아? 에이전트를 사람처럼 정의하고(role, goal, backstory), 태스크를 순서대로 연결하면 끝이야. 복잡한 상태 관리 없이도 기본적인 Writer + Reviewer + Publisher 파이프라인을 빠르게 만들 수 있어.
물론 프로덕션 환경에서는 LangGraph 같은 더 강력한 도구가 필요하지만, 아이디어 검증 단계에서는 CrewAI가 최고야 👍
Writer + Reviewer + Publisher 모델은 지금도 강력하지만, 앞으로 더 발전할 여지가 엄청나게 많아. 어떤 방향으로 진화할지 살펴보자:
예를 들어 "이번 달에 Reviewer가 가장 많이 지적한 문제가 뭔지 분석해서, Writer의 시스템 프롬프트를 자동으로 개선해줘"라는 메타 에이전트가 등장하는 거지.
Writer 에이전트: 텍스트 + 이미지 생성
Reviewer 에이전트: 텍스트 정확성 + 이미지 적절성 + 접근성 검토
Publisher 에이전트: 다양한 미디어 형식으로 변환 및 배포
이미 GPT-4o, Claude 3.5 같은 모델들이 멀티모달을 지원하고 있어서 이 방향은 이미 시작됐다고 볼 수 있어.
"의학 논문 검토에 특화된 Reviewer 에이전트 빌려드립니다" 같은 식으로 특정 도메인에 특화된 에이전트를 구독하거나 API로 사용하는 생태계가 형성될 거야. 이미 일부 스타트업들이 이 방향으로 움직이고 있어.
마치 구글 독스에서 여러 사람이 동시에 편집하듯이, Writer가 쓰는 동안 Reviewer가 실시간으로 피드백하고, Publisher가 배포 준비를 동시에 하는 방식이지. 이렇게 되면 처리 시간이 극적으로 줄어들 거야.
자, 이제 직접 Writer + Reviewer + Publisher 시스템을 만들어보고 싶다면 이 체크리스트를 참고해봐:
자, 여기까지 Writer + Reviewer + Publisher 모델에 대해서 진짜 깊게 파봤어. 마지막으로 이 모델의 진짜 가치가 뭔지 정리해볼게.
이 모델의 핵심은 단순히 "AI 세 개 쓰는 것"이 아니야. 인간이 팀으로 일하는 방식의 지혜를 AI 시스템에 적용한 것이야.
생각해봐. 좋은 글이나 코드가 나오려면:
이 세 역할이 모두 필요하잖아. AI도 마찬가지야.
그리고 이 모델은 단순히 효율성만 높이는 게 아니야. AI 시스템의 신뢰성과 안전성도 높여줘. Reviewer 에이전트가 있으면 Writer가 만든 잘못된 정보나 위험한 콘텐츠를 걸러낼 수 있거든.
앞으로 AI 자동화 시스템을 설계할 때 "하나의 AI가 다 해줬으면 좋겠다"는 생각보다는 "어떤 역할들이 필요하고, 어떻게 협업하게 할까?"라는 관점으로 접근해봐. 그게 훨씬 더 강력하고 안정적인 시스템을 만드는 길이야 💪
AI 에이전트 협업의 세계는 이제 막 시작됐어. Writer + Reviewer + Publisher는 그 시작점 중 하나일 뿐이고, 앞으로 더 다양하고 창의적인 에이전트 협업 패턴들이 등장할 거야. 그 흐름을 미리 이해하고 있는 너는 이미 한발 앞서 있는 거야 😎
Reviewer 에이전트 = 객관적 평가, 낮은 temperature, 구조화된 피드백
Publisher 에이전트 = 포맷 변환, 비동기 처리, 멀티채널 배포
오케스트레이터 = 상태 관리, 조건부 라우팅, 루프 제어
이 네 가지가 조화롭게 작동할 때 진짜 강력한 AI 자동화 시스템이 완성돼!
관련 키워드

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.