
Ver3.5 A/B 테스트 설계와 통계적 유의성 검증 방법론 — 데이터로 승부 보는 실전 가이드 🎯
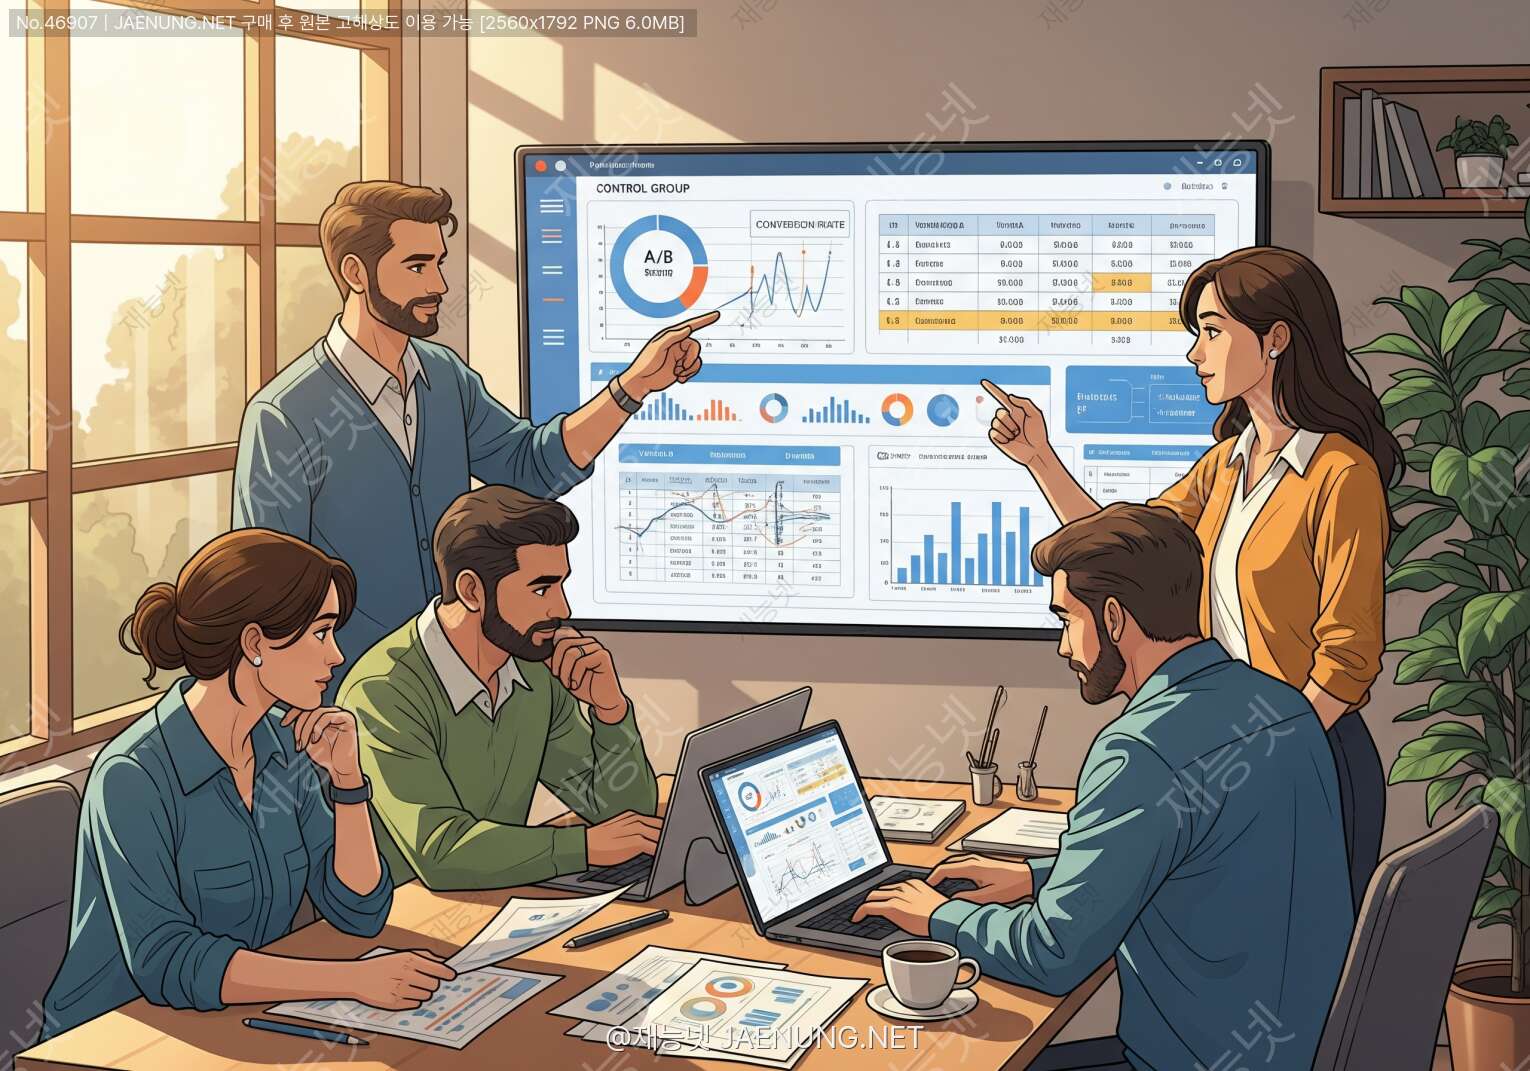
A/B 테스트 설계와 통계적 유의성 검증 방법론 — 데이터로 승부 보는 실전 가이드 🎯
✨ "느낌으로 결정하지 말고, 데이터로 증명하자!" — A/B 테스트의 처음부터 끝까지, 친구처럼 쉽고 재미있게 파헤쳐 봅니다.
야, 솔직히 말해봐. 🤔
버튼 색깔 바꾸면 클릭률이 올라갈 것 같다는 느낌으로 결정한 적 있지 않아?
아니면 상사가 "파란색이 더 좋아 보이는데?" 한마디에 디자인이 뒤집어진 경험?
그런 시대는 이제 끝났어. 🚀
A/B 테스트는 그 "느낌"을 "사실"로 바꿔주는 마법 같은 도구야.
그리고 통계적 유의성 검증은 그 마법이 진짜인지 가짜인지 판별해주는 리트머스 시험지고.
오늘은 A/B 테스트를 제대로 설계하고, 결과를 통계적으로 검증하는 방법을 처음부터 끝까지 같이 파헤쳐 볼 거야.
어렵게 느껴질 수 있는 통계 개념들도 최대한 쉽게 풀어줄 테니까 걱정 마! 😎
🧪 A/B 테스트가 뭔데? 기초부터 탄탄하게
A/B 테스트는 두 가지 버전(A와 B)을 동시에 실험해서 어느 쪽이 더 효과적인지 데이터로 비교하는 방법이야.
마케팅, UX 디자인, 제품 개발, 이메일 캠페인 등 거의 모든 분야에서 쓰이고 있어.
예를 들어볼게:
A 그룹 (기존): "구매하기" 버튼이 회색
B 그룹 (변형): "구매하기" 버튼이 주황색
→ 두 그룹에 각각 사용자를 랜덤 배정하고, 클릭률(CTR)을 비교!
→ B 그룹의 클릭률이 통계적으로 유의미하게 높다면? 주황색 버튼 채택! 🎉
핵심은 딱 하나의 변수만 바꾸는 것이야.
버튼 색깔도 바꾸고, 문구도 바꾸고, 위치도 바꾸면... 뭐가 효과가 있었는지 알 수가 없잖아?
이걸 통제된 실험(Controlled Experiment)이라고 해.
📐 A/B 테스트 설계 — 실험 전에 이것만큼은 꼭!
A/B 테스트는 그냥 "A랑 B 만들어서 돌리면 되지 뭐~" 하면 절대 안 돼. 😅
제대로 설계하지 않으면 결과가 나와도 믿을 수가 없거든.
설계 단계에서 챙겨야 할 핵심 요소들을 하나씩 살펴보자!
1️⃣ 가설 설정 (Hypothesis)
모든 실험은 명확한 가설에서 시작해야 해.
"뭔가 좋아질 것 같아"가 아니라, 구체적으로 뭘 바꾸면 어떤 지표가 얼마나 변할 것인지를 미리 정해야 해.
"결제 페이지의 CTA 버튼 색상을 회색에서 주황색으로 변경하면,
결제 완료율이 현재 3.2%에서 4.0% 이상으로 증가할 것이다."
❌ 나쁜 가설 예시
"버튼 색깔 바꾸면 더 잘 팔릴 것 같다."
가설은 귀무가설(H₀)과 대립가설(H₁)로 나눠서 설정해야 해.
이건 나중에 통계 검증에서 엄청 중요하게 쓰이니까 기억해둬!
2️⃣ 핵심 지표 선정 (Primary Metric)
실험에서 측정할 주요 지표(Primary Metric)를 딱 하나 정해야 해.
지표가 너무 많으면 "이것도 좋아지고 저것도 좋아졌는데 이건 나빠졌어..." 하면서 결론을 못 내리게 돼.
이걸 다중 비교 문제(Multiple Comparison Problem)라고 하는데, 나중에 자세히 설명할게.
| 분야 | 주요 지표 예시 |
|---|---|
| 이커머스 | 구매 전환율, 평균 주문 금액 |
| SaaS | 회원가입 완료율, 무료→유료 전환율 |
| 미디어 | 클릭률(CTR), 페이지 체류 시간 |
| 앱 | DAU, 리텐션율, 세션 길이 |
| 이메일 | 오픈율, 클릭률, 수신 거부율 |
3️⃣ 표본 크기 계산 (Sample Size Calculation)
이게 진짜 중요한데 많은 사람들이 놓치는 부분이야! 😤
"얼마나 많은 사람에게 실험해야 하나?"를 미리 계산해야 해.
너무 적으면 결과를 믿을 수 없고, 너무 많으면 시간과 비용 낭비야.
표본 크기는 다음 4가지 요소에 의해 결정돼:
보통 0.05(5%)를 사용해. "거짓 양성(False Positive)을 얼마나 허용할 것인가"를 의미해.
보통 0.80(80%)을 사용해. "진짜 효과가 있을 때 이를 감지할 확률"이야.
현재 A 버전의 전환율. 예: 3.2%
감지하고 싶은 최소한의 변화량. 예: 0.8%p 증가 (3.2% → 4.0%)
표본 크기 공식은 이렇게 생겼어:
p₁ = 0.032, p₂ = 0.040, α = 0.05, 검정력 = 80%
n ≈ (1.96 + 0.84)² × [0.032×0.968 + 0.040×0.960] / (0.032 - 0.040)²
n ≈ 7.84 × [0.03098 + 0.03840] / 0.000064
n ≈ 7.84 × 0.06938 / 0.000064
n ≈ 약 8,497명 (각 그룹당)
→ 총 약 17,000명 이상이 필요해!
이걸 피킹(Peeking) 또는 선택적 중단(Optional Stopping)이라고 하는데, 거짓 양성률이 폭발적으로 증가해. 🚨
4️⃣ 랜덤 배정 (Randomization)
사용자를 A/B 그룹에 배정할 때 완전한 랜덤이 보장되어야 해.
만약 오전에 접속한 사람은 A, 오후에 접속한 사람은 B로 배정하면?
오전/오후 사용자의 특성 차이가 결과에 영향을 줄 수 있어. 이걸 교란 변수(Confounding Variable)라고 해.
해시 기반 배정: 사용자 ID를 해시 함수에 넣어서 그룹 결정 (가장 많이 씀)
쿠키 기반 배정: 비로그인 사용자에게 쿠키로 그룹 기억
세션 기반 배정: 세션마다 랜덤 배정 (단, 같은 사용자가 두 버전 볼 수 있어서 비추)
5️⃣ 실험 기간 설정
실험 기간은 최소 1~2주 이상을 권장해.
왜냐고? 요일 효과(주중 vs 주말), 시간대 효과, 신기효과(Novelty Effect) 등을 걸러내야 하거든.
새로운 버전(B)이 처음엔 신기해서 클릭률이 높아지지만, 시간이 지나면 원래대로 돌아오는 현상.
실험 초반 데이터만 보면 B가 엄청 좋아 보이지만 사실이 아닐 수 있어!
📊 통계적 유의성 검증 — 진짜 효과인지 우연인지 판별하기
자, 이제 실험을 돌렸어. 결과가 나왔어.
B 그룹의 전환율이 A보다 높게 나왔어. 그런데... 이게 진짜 효과일까, 아니면 그냥 운이 좋았던 걸까? 🎰
이걸 판별하는 게 바로 통계적 유의성 검증이야!
🔬 p-value 완전 정복
p-value는 아마 통계에서 가장 많이 오해받는 개념일 거야.
제대로 이해해보자!
"귀무가설(H₀)이 참이라고 가정했을 때, 현재 관찰된 결과 또는 그보다 더 극단적인 결과가 나올 확률"
쉽게 말하면: "A와 B가 사실 차이가 없는데, 이 정도 차이가 우연히 나올 확률"
→ p = 0.03이면? "A와 B가 차이 없다고 가정할 때, 이런 결과가 나올 확률이 3%야."
→ 3%면 충분히 낮으니까 "아, 차이가 없다는 가정이 틀렸나 보다!" → 귀무가설 기각!
- ⚠️ p-value에 대한 흔한 오해들
- ❌ "p = 0.03이면 B가 A보다 97% 확률로 더 좋다" → 틀림!
- ❌ "p-value가 낮을수록 효과가 크다" → 틀림! (표본이 크면 작은 차이도 p가 낮게 나와)
- ❌ "p > 0.05면 차이가 없다" → 틀림! (차이가 없다는 증거가 아니라, 증거가 불충분한 것)
📐 검정 방법 선택하기
어떤 통계 검정을 쓸지는 데이터 유형에 따라 달라져:
| 지표 유형 | 검정 방법 | 사용 예시 |
|---|---|---|
| 비율 (전환율) | 카이제곱 검정, Z-검정 | 클릭률, 구매율 |
| 연속형 (평균) | t-검정 (독립표본) | 평균 주문금액, 체류시간 |
| 비정규 분포 | Mann-Whitney U 검정 | 수익, 세션 수 |
| 3개 이상 그룹 | ANOVA | A/B/C/D 테스트 |
🔢 Z-검정 실전 계산 (비율 비교)
전환율 비교에서 가장 많이 쓰는 Z-검정을 직접 계산해보자!
📏 신뢰구간 (Confidence Interval) 해석
신뢰구간은 p-value보다 훨씬 더 많은 정보를 줘.
"효과가 있냐 없냐"뿐만 아니라 "효과가 얼마나 클 것인가"의 범위를 알려주거든.
95% CI = [+0.38%p, +1.42%p]라면?
→ 최악의 경우(+0.38%p)에도 비즈니스적으로 의미 있는 개선인가?
→ 만약 그렇다면 → B 채택!
→ 최악의 경우가 너무 작다면 → 더 큰 표본으로 재실험 고려
⚠️ A/B 테스트의 함정들 — 이것만 피해도 반은 성공
A/B 테스트를 망치는 실수들이 생각보다 엄청 많아.
실제 현업에서 자주 발생하는 함정들을 정리해봤어. 😤
🚨 함정 1: 다중 비교 문제 (Multiple Testing Problem)
지표를 10개 동시에 보면서 "이 중에 하나라도 유의미하면 성공!"이라고 하면 안 돼.
α = 0.05로 검정을 10번 하면, 아무 효과가 없어도 적어도 하나가 유의미하게 나올 확률이 얼마인지 알아?
검정 횟수(k)로 유의수준을 나눠서 사용
α_보정 = α / k = 0.05 / 10 = 0.005
→ 각 검정에서 p < 0.005일 때만 유의미하다고 판단!
(단, 너무 보수적이라는 단점이 있어. FDR 보정도 대안으로 많이 씀)
🚨 함정 2: 샘플 오염 (Sample Pollution)
A 그룹에 배정된 사용자가 B 버전도 보게 되는 상황이야.
예를 들어 같은 기기를 여러 사람이 쓰거나, 쿠키를 삭제하거나, 로그인/비로그인 상태가 섞이면 발생해.
실제 실험 전에 A와 A (동일한 버전)를 비교하는 테스트를 먼저 해봐.
만약 A/A 테스트에서 유의미한 차이가 나온다면? → 랜덤 배정이나 측정 시스템에 문제가 있는 거야!
🚨 함정 3: 신기효과 vs 지속효과 혼동
새로운 UI나 기능이 처음엔 신기해서 사람들이 더 많이 클릭하지만,
시간이 지나면 원래 수준으로 돌아오는 경우가 있어.
이걸 신기효과(Novelty Effect)라고 해.
반대로 처음엔 낯설어서 성과가 낮지만 시간이 지나면 좋아지는 학습효과(Learning Effect)도 있어.
그래서 실험 기간을 충분히 길게 가져가는 게 중요해!
🚨 함정 4: 피킹 (Peeking)
실험 중간에 계속 결과를 들여다보면서 "오, 유의미해졌다!" 싶을 때 실험을 멈추는 행동이야.
이게 왜 문제냐면...
순차적 검정(Sequential Testing): 중간 점검을 허용하되, 각 점검마다 더 엄격한 기준 적용
베이지안 A/B 테스트: 언제든 멈춰도 되는 베이지안 접근법 사용
미리 정한 표본 크기 도달 후 단 한 번만 검정: 가장 단순하고 안전한 방법
🚨 함정 5: 세그먼트 낚시 (Segment Fishing)
전체 결과가 유의미하지 않으면 "그럼 20대 여성만 보면 어때? 아이폰 사용자만 보면?"
이렇게 계속 쪼개다 보면 어딘가에서 유의미한 결과가 나오게 돼.
이건 다중 비교 문제의 변형이야. 사전에 분석할 세그먼트를 미리 정해두는 게 원칙이야!
🎓 고급 기법들 — 한 단계 더 나아가기
🔵 베이지안 A/B 테스트
전통적인 빈도주의(Frequentist) 방법 외에 베이지안(Bayesian) 접근법도 많이 쓰여.
베이지안 방법의 핵심은 사전 지식(Prior)을 반영해서 확률을 업데이트하는 거야.
빈도주의: "p < 0.05면 귀무가설 기각" → 예/아니오 이진 결론
베이지안: "B가 A보다 좋을 확률이 95%야" → 확률적 결론
베이지안의 장점:
✅ 언제든 실험을 멈춰도 해석이 유효해
✅ "B가 A보다 좋을 확률"을 직관적으로 표현 가능
✅ 사전 지식 활용 가능
베이지안의 단점:
❌ 사전 분포(Prior) 설정이 주관적일 수 있어
❌ 계산이 복잡해 (MCMC 등)
🔵 멀티암드 밴딧 (Multi-Armed Bandit)
전통적인 A/B 테스트는 실험 기간 동안 트래픽을 50:50으로 고정해.
근데 만약 B가 명백히 더 좋아 보이는데도 계속 50%를 A에 보내야 한다면? 손해잖아!
멀티암드 밴딧은 실험하면서 동시에 최적화도 해.
성과가 좋은 버전에 점점 더 많은 트래픽을 보내면서 탐색(Exploration)과 활용(Exploitation)을 균형 있게 해.
ε-Greedy: ε 확률로 랜덤 탐색, (1-ε) 확률로 최고 성과 버전 선택
UCB (Upper Confidence Bound): 불확실성이 높은 버전에 더 많이 탐색
Thompson Sampling: 베이지안 기반, 각 버전의 사후 분포에서 샘플링
→ 뉴스피드, 광고 최적화, 추천 시스템에서 많이 쓰여!
🔵 CUPED (Controlled-experiment Using Pre-Experiment Data)
Microsoft에서 개발한 방법으로, 실험 전 데이터를 활용해서 분산을 줄이는 기법이야.
분산이 줄어들면 같은 표본 크기로도 더 작은 효과를 감지할 수 있어.
Airbnb, Netflix, Booking.com 등 대형 테크 기업들이 많이 사용해.
🛠️ 실전 A/B 테스트 프로세스 — 처음부터 끝까지
📋 결과 보고서 작성 가이드
실험이 끝나면 결과를 명확하게 문서화해야 해.
재능넷 같은 플랫폼에서 데이터 분석 서비스를 제공하는 분들이라면 특히 이 부분이 중요해!
클라이언트나 팀원들이 이해하기 쉬운 보고서를 작성하는 게 핵심이야.
1. 실험 개요: 가설, 변경 내용, 기간, 대상 사용자
2. 표본 정보: 각 그룹 표본 크기, 배정 방법
3. 주요 결과: 각 그룹의 지표값, 절대적/상대적 차이
4. 통계 검증: p-value, 신뢰구간, 검정력
5. 효과 크기: 실질적 의미 평가
6. 세그먼트 분석: 사전에 정의된 세그먼트별 결과
7. 결론 및 권고사항: 채택/기각 이유, 다음 단계
🔧 실무에서 쓰는 도구들
A/B 테스트를 직접 구현하거나 분석할 때 쓸 수 있는 도구들을 소개할게!
| 도구 | 유형 | 특징 |
|---|---|---|
| Google Optimize | 플랫폼 | 무료, GA 연동 (2023년 종료) |
| Optimizely | 플랫폼 | 엔터프라이즈급, 강력한 기능 |
| VWO | 플랫폼 | 히트맵, 세션 녹화 포함 |
| AB Tasty | 플랫폼 | AI 기반 개인화 지원 |
| Python (scipy) | 코드 | 커스텀 분석, 무료 |
| R | 코드 | 통계 분석 특화 |
Python으로 간단하게 Z-검정 하는 코드도 보여줄게:
from scipy import stats
import numpy as np

# 실험 데이터
n_A = 10000  # A 그룹 표본 수
conv_A = 320  # A 그룹 전환 수
n_B = 10000  # B 그룹 표본 수
conv_B = 410  # B 그룹 전환 수

# 전환율 계산
p_A = conv_A / n_A  # 0.032
p_B = conv_B / n_B  # 0.041

# 풀링된 비율
p_pool = (conv_A + conv_B) / (n_A + n_B)

# 표준 오차
se = np.sqrt(p_pool * (1 - p_pool) * (1/n_A + 1/n_B))

# Z 통계량
z_stat = (p_B - p_A) / se

# p-value (단측 검정)
p_value = 1 - stats.norm.cdf(z_stat)

# 95% 신뢰구간
ci_low = (p_B - p_A) - 1.96 * se
ci_high = (p_B - p_A) + 1.96 * se

print(f"Z 통계량: {z_stat:.4f}")
print(f"p-value: {p_value:.4f}")
print(f"95% CI: [{ci_low:.4f}, {ci_high:.4f}]")
print(f"결론: {'유의미함' if p_value < 0.05 else '유의미하지 않음'}")
💡 실무 팁 모음 — 현장에서 바로 쓰는 것들
□ 가설이 명확하게 정의되었는가?
□ 주요 지표(Primary Metric)가 하나로 정해졌는가?
□ 표본 크기가 사전에 계산되었는가?
□ 실험 기간이 정해졌는가? (최소 1주 이상)
□ 랜덤 배정 방법이 검증되었는가?
□ A/A 테스트로 시스템이 검증되었는가?
□ 분석할 세그먼트가 사전에 정의되었는가?
표본이 매우 크면 아주 작은 차이도 통계적으로 유의미하게 나와.
예: 100만 명 실험에서 전환율이 3.200%에서 3.201%로 증가 → p < 0.05일 수 있어.
근데 이게 비즈니스적으로 의미 있는 차이야? 🤔
→ 항상 최소 감지 효과(MDE)를 사전에 정하고,
→ 통계적 유의성과 함께 실용적 의미를 함께 평가해야 해!
"유의미하지 않음"이 "효과 없음"을 의미하지 않아!
표본이 부족했을 수도 있고, MDE 설정이 너무 작았을 수도 있어.
→ 이런 경우엔 "결론을 내리기에 증거가 불충분하다"고 솔직하게 보고하는 게 맞아.
A/B 테스트는 한 번의 이벤트가 아니라 지속적인 문화야.
Amazon, Google, Netflix는 하루에도 수백 개의 실험을 동시에 돌려.
작은 팀이라도 "데이터로 결정하는 문화"를 만들어가는 게 중요해!
재능넷에서 데이터 분석이나 A/B 테스트 설계 서비스를 찾는다면,
이런 실험 문화 구축까지 도와줄 수 있는 전문가를 찾아보는 것도 좋은 방법이야! 🎯
📚 마무리 — A/B 테스트 마스터가 되는 길
자, 오늘 엄청 많은 내용을 다뤘어! 🎉
핵심만 다시 정리해볼게:
설계 단계: 명확한 가설 → 지표 선정 → 표본 크기 계산 → 랜덤 배정
실행 단계: A/A 테스트 → 충분한 기간 → 피킹 금지
분석 단계: p-value + 신뢰구간 + 효과 크기 종합 판단
함정 회피: 다중 비교 보정, 세그먼트 낚시 금지, 신기효과 주의
고급 기법: 베이지안 테스트, 멀티암드 밴딧, CUPED
A/B 테스트는 처음엔 복잡해 보이지만, 한 번 제대로 이해하면
"느낌"이 아닌 "데이터"로 결정하는 강력한 무기가 돼.
특히 통계적 유의성 검증은 단순히 p-value 하나만 보는 게 아니라,
신뢰구간, 효과 크기, 실용적 의미까지 종합적으로 판단해야 한다는 걸 꼭 기억해!
이제 다음에 누군가 "그냥 느낌으로 결정하자"고 하면?
자신 있게 "A/B 테스트 해봅시다!" 라고 말할 수 있을 거야. 😎

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.



아직 댓글이 없습니다.