
Ver3.5 클러스터링과 분류 알고리즘을 활용한 패턴 인식 완전 정복 🧩
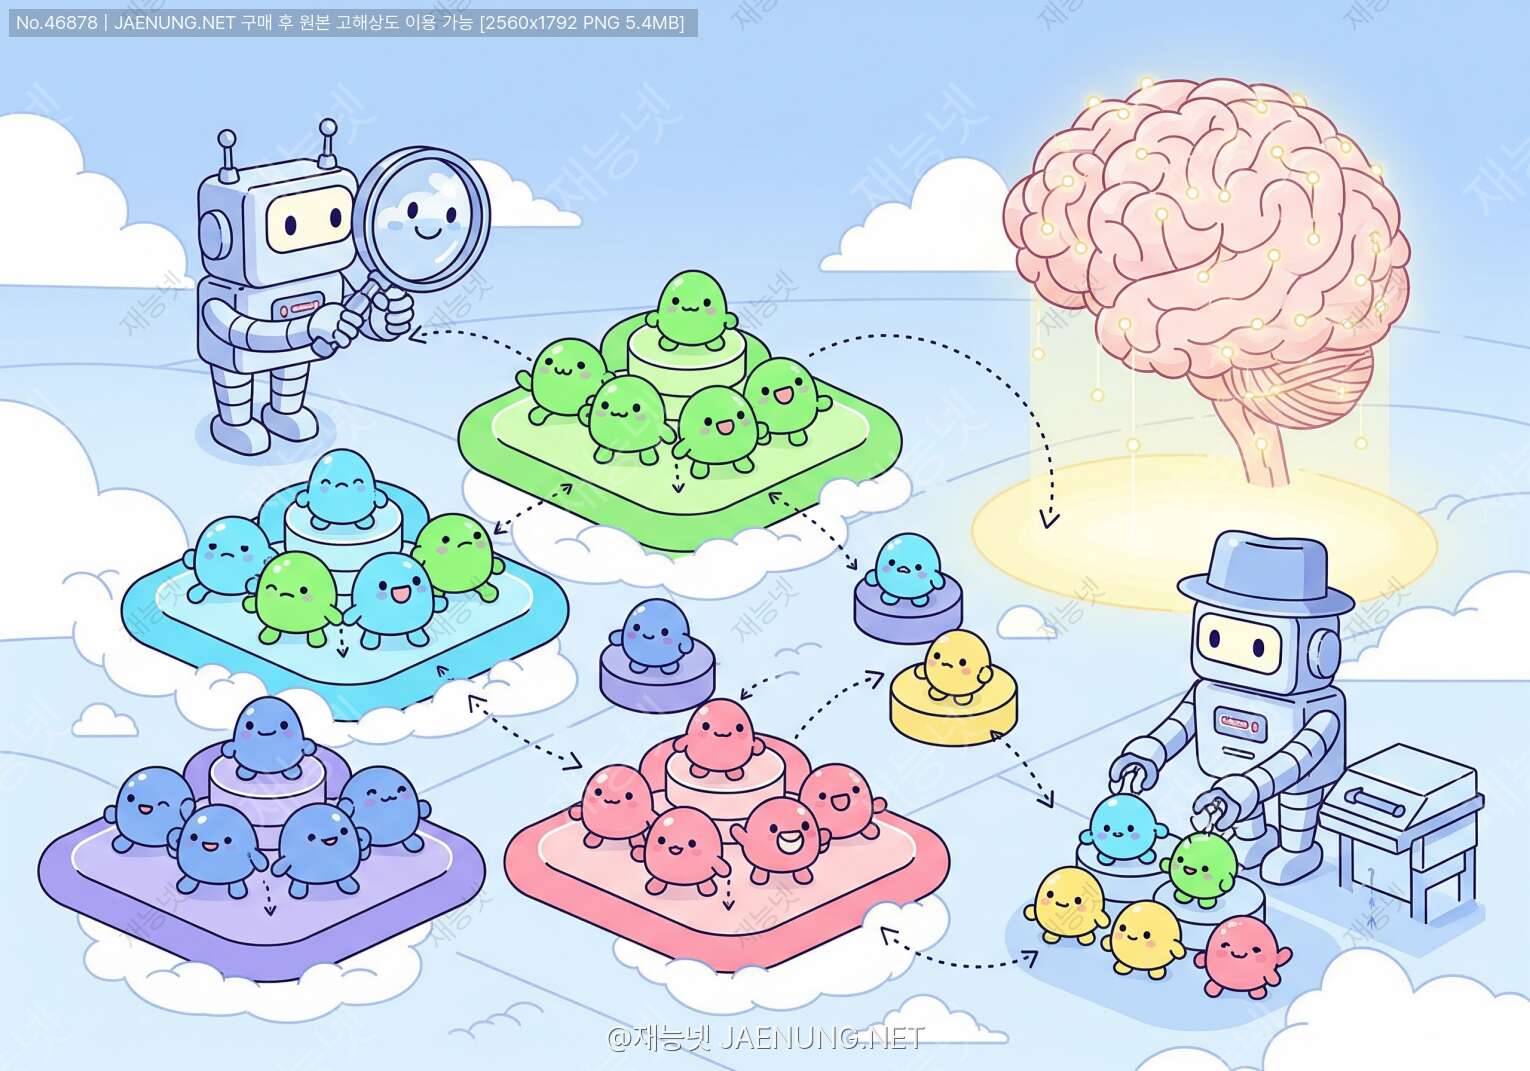
클러스터링과 분류 알고리즘을 활용한 패턴 인식 완전 정복 🧩
데이터 속 숨겨진 패턴을 찾아내는 여정 — K-Means부터 랜덤 포레스트까지, 친구처럼 쉽게 풀어드립니다 🌟
야, 솔직히 말해봐. 📣
"클러스터링"이라는 단어 처음 들었을 때 뭔가 복잡하고 어려운 느낌 들지 않았어?
근데 사실 알고 보면 우리 일상에서 이미 엄청 많이 쓰이고 있는 개념이야.
넷플릭스가 "당신이 좋아할 것 같은 영화"를 추천해주는 것도, 스팸 메일을 자동으로 걸러내는 것도, 병원에서 환자 데이터를 분석해서 질병 패턴을 찾아내는 것도 — 전부 클러스터링과 분류 알고리즘의 힘이야. 🎯
이 글에서는 그 핵심 개념들을 처음 보는 사람도 이해할 수 있게, 그리고 이미 알고 있는 사람도 "아, 이런 관점도 있구나!" 할 수 있게 풀어볼 거야.
커피 한 잔 들고 편하게 읽어봐. ☕
🔍 패턴 인식, 도대체 뭘 인식한다는 거야?
패턴 인식(Pattern Recognition)은 말 그대로 데이터 속에서 반복되는 규칙이나 구조를 찾아내는 것이야.
인간은 태어날 때부터 패턴 인식을 엄청 잘해. 얼굴을 보면 누군지 알고, 음악을 들으면 장르를 구분하고, 글씨를 보면 읽을 수 있잖아.
근데 컴퓨터한테 이걸 시키려면? 🤔
그냥 "이게 고양이야"라고 말해줘도 컴퓨터는 모르거든. 수학적으로 정의된 알고리즘이 필요해.
그게 바로 머신러닝 기반의 패턴 인식 알고리즘들이야.
① 이 데이터들은 어떻게 그룹으로 묶을 수 있을까? → 클러스터링
② 이 새로운 데이터는 어느 카테고리에 속할까? → 분류(Classification)
③ 이 패턴은 앞으로 어떻게 변할까? → 예측(Prediction)
오늘 우리가 집중할 건 ①번과 ②번이야.
클러스터링과 분류 — 이 두 가지가 패턴 인식의 양대 산맥이거든. 🏔️
🫧 클러스터링: "비슷한 애들끼리 뭉쳐!"
클러스터링(Clustering)은 레이블(정답)이 없는 데이터를 비슷한 특성끼리 자동으로 그룹화하는 기법이야.
이걸 비지도 학습(Unsupervised Learning)이라고 해.
쉽게 비유하면, 처음 보는 사람들이 잔뜩 있는 파티에서 "저 사람들은 왠지 비슷해 보이는데?" 하고 자연스럽게 그룹을 나누는 것과 같아. 🎉
아무도 "이 사람은 A그룹, 저 사람은 B그룹"이라고 알려주지 않았는데도!
📌 클러스터링의 핵심 개념: 거리와 유사도
클러스터링 알고리즘의 핵심은 "얼마나 비슷한가"를 수학적으로 측정하는 거야.
가장 많이 쓰이는 방법들을 살펴보자.
| 거리/유사도 측정법 | 설명 | 주요 사용처 |
|---|---|---|
| 유클리드 거리 | 두 점 사이의 직선 거리 (피타고라스 정리) | K-Means, 일반적인 수치 데이터 |
| 맨해튼 거리 | 격자 형태로 이동하는 거리 (가로+세로) | 고차원 데이터, 이상치에 강함 |
| 코사인 유사도 | 벡터 간 각도로 유사성 측정 | 텍스트 분석, 추천 시스템 |
| 자카드 유사도 | 두 집합의 교집합/합집합 비율 | 이진 데이터, 문서 유사도 |
🎯 K-Means 클러스터링: 가장 유명한 친구
클러스터링 알고리즘 중에서 가장 널리 쓰이는 건 단연 K-Means야.
알고리즘 이름에서 K는 클러스터(그룹)의 개수, Means는 평균을 뜻해.
Step 1. K개의 중심점(Centroid)을 랜덤하게 초기화
Step 2. 각 데이터 포인트를 가장 가까운 중심점에 할당
Step 3. 각 클러스터의 평균값으로 중심점 업데이트
Step 4. 중심점이 더 이상 변하지 않을 때까지 Step 2~3 반복
K-Means의 장점은 빠르고 구현이 쉽다는 거야.
하지만 단점도 있어. K값(클러스터 개수)을 미리 정해야 하고, 원형이 아닌 복잡한 모양의 클러스터는 잘 못 찾아. 😅
K를 1부터 늘려가면서 클러스터 내 분산(WCSS)을 계산해봐.
그래프가 팔꿈치처럼 꺾이는 지점이 최적의 K야!
예를 들어 K=3에서 급격히 꺾인다면 → 클러스터 3개가 최적!
🌊 DBSCAN: 밀도 기반의 스마트한 클러스터링
K-Means가 "거리"를 기준으로 한다면, DBSCAN(Density-Based Spatial Clustering of Applications with Noise)은 "밀도"를 기준으로 해.
쉽게 말하면, 사람들이 빽빽하게 모여있는 곳을 하나의 클러스터로 보고, 혼자 떨어져 있는 건 노이즈(이상치)로 처리하는 거야. 🏙️
ε (epsilon): 이웃을 탐색할 반경
MinPts: 클러스터를 형성하기 위한 최소 포인트 수
🔴 핵심 포인트: ε 내에 MinPts 이상 존재
🟡 경계 포인트: 핵심 포인트 근처에 있지만 조건 미충족
⚫ 노이즈: 어느 클러스터에도 속하지 않음
DBSCAN의 가장 큰 장점은 K값을 미리 정하지 않아도 되고, 불규칙한 모양의 클러스터도 잘 찾아낸다는 거야.
또한 이상치(Outlier)를 자동으로 감지해줘서 실제 데이터 분석에서 엄청 유용해! 💪
🌳 계층적 클러스터링: 트리처럼 쌓아가기
계층적 클러스터링(Hierarchical Clustering)은 데이터를 덴드로그램(Dendrogram)이라는 트리 구조로 표현해.
크게 두 가지 방식이 있어.
| 방식 | 설명 | 특징 |
|---|---|---|
| 병합형 (Agglomerative) | 각 데이터를 개별 클러스터로 시작해서 점점 합쳐나감 (Bottom-up) | 가장 많이 사용, 직관적 |
| 분할형 (Divisive) | 전체를 하나의 클러스터로 시작해서 점점 나눔 (Top-down) | 계산 비용이 높음 |
계층적 클러스터링의 장점은 K값을 미리 정하지 않아도 되고, 덴드로그램을 보면서 어느 수준에서 클러스터를 자를지 시각적으로 판단할 수 있다는 거야. 🎨
🏷️ 분류 알고리즘: "이건 어느 카테고리야?"
분류(Classification)는 레이블이 있는 데이터를 학습해서 새로운 데이터가 어느 카테고리에 속하는지 예측하는 거야.
이걸 지도 학습(Supervised Learning)이라고 해.
예를 들어, 수천 개의 이메일에 "스팸/정상" 레이블을 붙여서 학습시키면, 새로운 이메일이 왔을 때 스팸인지 아닌지 자동으로 판단할 수 있어. 📧
🌲 결정 트리 (Decision Tree)
결정 트리는 질문을 연속으로 던져서 결론에 도달하는 알고리즘이야.
마치 스무고개 게임처럼! 🎮
결정 트리의 핵심은 어떤 기준으로 데이터를 나눌까야.
이때 사용하는 지표가 바로 정보 이득(Information Gain)과 지니 불순도(Gini Impurity)야.
Gini = 1 - Σ(pᵢ)²여기서 pᵢ는 각 클래스의 비율이야.
값이 0에 가까울수록 순수한 클러스터(한 클래스만 있음), 0.5에 가까울수록 불순한 클러스터야.
결정 트리는 지니 불순도를 최소화하는 방향으로 분기점을 선택해!
🌲🌲🌲 랜덤 포레스트: 결정 트리의 앙상블
결정 트리 하나는 과적합(Overfitting)에 취약해. 훈련 데이터에는 완벽하게 맞지만 새로운 데이터에는 형편없는 경우가 많거든.
그래서 나온 게 랜덤 포레스트(Random Forest)야!
수백 개의 결정 트리를 만들어서 다수결 투표로 최종 결론을 내리는 방식이야. 🗳️
① 배깅(Bagging): 훈련 데이터를 랜덤하게 샘플링해서 각 트리에 사용
② 특성 랜덤 선택: 각 분기점에서 전체 특성 중 일부만 랜덤하게 선택
이 두 가지 랜덤성 덕분에 각 트리가 서로 다른 패턴을 학습하고, 앙상블하면 훨씬 강력해져!
📏 SVM: 경계선을 최대화하는 알고리즘
SVM(Support Vector Machine)은 두 클래스 사이의 마진(Margin)을 최대화하는 결정 경계를 찾는 알고리즘이야.
마진이란 결정 경계와 가장 가까운 데이터 포인트들(서포트 벡터) 사이의 거리야.
이 마진을 최대화하면 새로운 데이터에 대한 일반화 성능이 높아져! 📐
SVM은 특히 고차원 데이터에서 강력한 성능을 발휘해.
또한 커널 트릭(Kernel Trick)을 사용하면 선형으로 분리되지 않는 데이터도 처리할 수 있어.
커널 함수가 데이터를 더 높은 차원으로 변환해서 선형 분리가 가능하게 만들어주거든. 🚀
🧠 K-최근접 이웃 (K-NN)
K-NN(K-Nearest Neighbors)은 가장 직관적인 분류 알고리즘이야.
새로운 데이터가 들어오면 가장 가까운 K개의 이웃을 찾아서 다수결로 분류하는 거야.
"유유상종"이라는 말처럼, 주변에 어떤 친구들이 있는지 보고 판단하는 거지. 👥
K-NN은 학습 단계가 없고 예측할 때마다 전체 데이터와 거리를 계산해야 해.
데이터가 많아질수록 예측 속도가 느려지는 단점이 있어.
또한 K값 선택이 중요한데, K가 너무 작으면 노이즈에 민감하고, 너무 크면 경계가 흐릿해져.
📊 나이브 베이즈 (Naive Bayes)
나이브 베이즈는 베이즈 정리를 기반으로 한 확률적 분류 알고리즘이야.
"나이브(Naive)"라는 이름이 붙은 이유는 모든 특성이 서로 독립적이라는 순진한(naive) 가정을 하기 때문이야.
P(클래스|데이터) = P(데이터|클래스) × P(클래스) / P(데이터)쉽게 말하면: "이 데이터가 주어졌을 때 각 클래스일 확률"을 계산해서 가장 높은 클래스로 분류해!
스팸 필터링에서 특히 강력한 성능을 발휘하고, 텍스트 분류에 많이 쓰여.
⚖️ 클러스터링 vs 분류: 언제 뭘 써야 해?
이제 각 알고리즘의 특성을 이해했으니, 실제로 어떤 상황에서 뭘 써야 하는지 정리해보자! 🎯
| 구분 | 클러스터링 | 분류 |
|---|---|---|
| 학습 방식 | 비지도 학습 (레이블 없음) | 지도 학습 (레이블 있음) |
| 목적 | 숨겨진 그룹 구조 발견 | 새 데이터의 카테고리 예측 |
| 결과물 | 클러스터 그룹 할당 | 클래스 레이블 예측 |
| 평가 방법 | 실루엣 점수, 엘보우 방법 | 정확도, F1 점수, AUC-ROC |
| 주요 알고리즘 | K-Means, DBSCAN, 계층적 | 결정 트리, SVM, K-NN, 나이브 베이즈 |
| 활용 예시 | 고객 세분화, 이상 탐지 | 스팸 필터, 질병 진단 |
많은 경우 클러스터링과 분류를 함께 사용해!
① 먼저 클러스터링으로 데이터의 구조를 파악하고
② 클러스터 결과를 레이블로 활용해서 분류 모델을 학습시키는 방식이야.
이걸 반지도 학습(Semi-supervised Learning)이라고 해!
📏 모델 평가: 잘 만들었는지 어떻게 알아?
알고리즘을 돌렸다고 끝이 아니야. 얼마나 잘 작동하는지 평가해야 해.
평가 방법을 모르면 좋은 모델인지 나쁜 모델인지 판단할 수 없거든. 🔬
📊 분류 모델 평가 지표
분류 모델 평가의 핵심은 혼동 행렬(Confusion Matrix)이야.
정밀도(Precision)가 중요한 경우: 스팸 필터 (정상 메일을 스팸으로 잘못 분류하면 안 됨)
재현율(Recall)이 중요한 경우: 암 진단 (실제 암 환자를 정상으로 잘못 분류하면 안 됨)
F1 점수: 정밀도와 재현율의 조화 평균 — 둘 다 중요할 때 사용!
🫧 클러스터링 모델 평가 지표
클러스터링은 정답 레이블이 없어서 평가가 더 까다로워.
대표적인 평가 지표를 알아보자.
| 평가 지표 | 설명 | 범위 |
|---|---|---|
| 실루엣 점수 | 같은 클러스터 내 응집도 vs 다른 클러스터와의 분리도 측정 | -1 ~ 1 (높을수록 좋음) |
| Davies-Bouldin 지수 | 클러스터 간 분리도와 클러스터 내 분산의 비율 | 낮을수록 좋음 |
| WCSS | 클러스터 내 분산의 합 (엘보우 방법에 사용) | 낮을수록 좋음 |
| Calinski-Harabasz 지수 | 클러스터 간 분산 / 클러스터 내 분산 | 높을수록 좋음 |
🌍 실제 세계에서의 활용 사례
이론은 충분히 봤으니, 이제 실제로 어디에 쓰이는지 살펴보자! 🎯
알고 보면 우리 주변 곳곳에 이 알고리즘들이 숨어있어.
🛒 고객 세분화 (Customer Segmentation) 실전 예시
마케팅에서 가장 많이 쓰이는 클러스터링 활용 사례야.
RFM 분석이라고 들어봤어? 🤔
R (Recency): 마지막 구매가 얼마나 최근인가?
F (Frequency): 얼마나 자주 구매하는가?
M (Monetary): 얼마나 많이 구매하는가?
이 3가지 지표로 고객 데이터를 K-Means로 클러스터링하면:
🔴 VIP 고객 / 🟡 잠재 고객 / 🟢 이탈 위험 고객 / ⚫ 휴면 고객
으로 자동 분류돼서 맞춤 마케팅 전략을 세울 수 있어!
실제로 재능넷 같은 플랫폼에서도 이런 분석을 통해 사용자 행동 패턴을 파악하고, 어떤 재능 카테고리가 인기 있는지, 어떤 사용자 그룹이 어떤 서비스를 선호하는지 분석할 수 있어. 📈
🔭 차원 축소: 패턴 인식의 숨은 조력자
실제 데이터는 수백, 수천 개의 특성(Feature)을 가지고 있어.
이렇게 고차원 데이터를 그대로 클러스터링하거나 분류하면 차원의 저주(Curse of Dimensionality)에 빠질 수 있어. 😱
차원이 높아질수록 데이터가 희박해지고, 거리 측정이 의미를 잃어버리거든.
그래서 차원 축소(Dimensionality Reduction)가 필요해!
📐 PCA (주성분 분석)
PCA(Principal Component Analysis)는 데이터의 분산을 최대한 보존하면서 차원을 줄이는 기법이야.
고차원 데이터를 2D나 3D로 압축해서 시각화하거나, 클러스터링/분류 전처리로 많이 써.
① 데이터의 공분산 행렬 계산
② 고유값(Eigenvalue)과 고유벡터(Eigenvector) 추출
③ 가장 큰 고유값에 해당하는 고유벡터(주성분) 선택
④ 선택된 주성분으로 데이터 투영(Projection)
결과: 원래 100개의 특성 → 2~3개의 주성분으로 압축!
🗺️ t-SNE: 시각화의 왕
t-SNE(t-distributed Stochastic Neighbor Embedding)는 고차원 데이터를 2D/3D로 시각화하는 데 특화된 기법이야.
PCA와 달리 비선형 관계도 잘 표현해줘서, 클러스터 구조를 눈으로 확인할 때 최고야! 👁️
딥러닝 모델의 임베딩 벡터를 시각화할 때 자주 쓰여.
t-SNE는 시각화 목적으로만 사용해야 해.
t-SNE 결과의 클러스터 크기나 거리는 실제 의미가 없을 수 있어.
또한 계산 비용이 높아서 대용량 데이터에는 UMAP을 대신 사용하는 추세야.
💻 실제로 어떻게 구현해? Python 코드 맛보기
이론만 알면 뭐해, 실제로 써봐야지! 🐍
Python의 scikit-learn 라이브러리를 사용하면 이 모든 알고리즘을 몇 줄로 구현할 수 있어.
🫧 K-Means 클러스터링 구현
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
import numpy as np

# 데이터 전처리 (스케일링은 필수!)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# K-Means 모델 생성 및 학습
kmeans = KMeans(
    n_clusters=3,      # 클러스터 개수
    init='k-means++',  # 스마트한 초기화 방법
    n_init=10,         # 다른 초기값으로 10번 시도
    max_iter=300,      # 최대 반복 횟수
    random_state=42
)
kmeans.fit(X_scaled)

# 결과 확인
labels = kmeans.labels_          # 각 데이터의 클러스터 번호
centers = kmeans.cluster_centers_ # 클러스터 중심점
inertia = kmeans.inertia_         # WCSS 값 (엘보우 방법용)

print(f"클러스터 레이블: {labels}")
print(f"WCSS: {inertia:.2f}")
🌲 랜덤 포레스트 분류 구현
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix

# 훈련/테스트 데이터 분리
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 랜덤 포레스트 모델
rf_model = RandomForestClassifier(
    n_estimators=100,    # 트리 개수
    max_depth=None,      # 트리 최대 깊이 (None=제한 없음)
    min_samples_split=2, # 분기를 위한 최소 샘플 수
    random_state=42,
    n_jobs=-1            # 모든 CPU 코어 사용
)

# 학습 및 예측
rf_model.fit(X_train, y_train)
y_pred = rf_model.predict(X_test)

# 성능 평가
print(classification_report(y_test, y_pred))
print("혼동 행렬:")
print(confusion_matrix(y_test, y_pred))

# 특성 중요도 확인
feature_importance = rf_model.feature_importances_
print(f"가장 중요한 특성: {feature_names[feature_importance.argmax()]}")
📏 엘보우 방법으로 최적 K 찾기
import matplotlib.pyplot as plt

wcss_values = []
k_range = range(1, 11)

for k in k_range:
    kmeans = KMeans(n_clusters=k, random_state=42, n_init=10)
    kmeans.fit(X_scaled)
    wcss_values.append(kmeans.inertia_)

# 그래프로 시각화
plt.figure(figsize=(10, 6))
plt.plot(k_range, wcss_values, 'bo-', linewidth=2, markersize=8)
plt.xlabel('클러스터 개수 (K)')
plt.ylabel('WCSS (클러스터 내 분산)')
plt.title('엘보우 방법으로 최적 K 찾기')
plt.xticks(k_range)
plt.grid(True, alpha=0.3)
plt.show()
# 그래프가 꺾이는 지점 = 최적 K!모든 알고리즘이
fit(), predict(), transform()이라는 일관된 인터페이스를 가져.그래서 한 알고리즘을 배우면 다른 알고리즘도 쉽게 쓸 수 있어!
또한
Pipeline을 사용하면 전처리 → 모델 학습을 한 번에 처리할 수 있어.
🎭 앙상블 학습: 혼자보다 함께가 강하다
여러 모델을 결합해서 더 강력한 예측을 만드는 앙상블(Ensemble) 학습은 현대 머신러닝에서 빠질 수 없는 개념이야. 🤝
같은 알고리즘을 여러 번 학습시켜서 평균/다수결로 결합
대표 알고리즘: 랜덤 포레스트
장점: 분산 감소, 과적합 방지
특징: 병렬 학습 가능
이전 모델의 오류를 다음 모델이 보완하는 순차적 학습
대표 알고리즘: XGBoost, LightGBM
장점: 편향 감소, 높은 정확도
특징: 순차 학습 (느림)
여러 모델의 예측값을 새로운 모델의 입력으로 사용
대표 알고리즘: 메타 학습기
장점: 다양한 모델의 장점 결합
특징: 구현 복잡, 높은 성능
특히 XGBoost와 LightGBM은 Kaggle 같은 데이터 사이언스 대회에서 압도적인 성능을 보여주는 알고리즘이야.
그래디언트 부스팅 기반으로 결정 트리를 순차적으로 학습시키는데, 속도와 성능 모두 뛰어나. ⚡
⚠️ 과적합 vs 과소적합: 모델의 두 가지 함정
아무리 좋은 알고리즘도 잘못 사용하면 쓸모없어.
가장 흔한 두 가지 함정을 알아보자. 🕳️
| 문제 | 원인 | 해결책 |
|---|---|---|
| 과소적합 | 모델이 너무 단순함, 특성 부족 | 더 복잡한 모델 사용, 특성 추가, 규제 완화 |
| 과적합 | 모델이 너무 복잡함, 데이터 부족 | 규제(L1/L2), 드롭아웃, 교차 검증, 데이터 증강 |
① 교차 검증(Cross-Validation): 데이터를 여러 폴드로 나눠서 검증
② L1 규제(Lasso): 불필요한 특성의 가중치를 0으로 만들어 특성 선택 효과
③ L2 규제(Ridge): 가중치를 작게 유지해서 모델 복잡도 제한
④ 조기 종료(Early Stopping): 검증 손실이 증가하면 학습 중단
⑤ 드롭아웃(Dropout): 신경망에서 랜덤하게 노드를 비활성화
🧹 데이터 전처리: 알고리즘보다 더 중요한 것
머신러닝 실무에서 가장 많은 시간을 쓰는 건 알고리즘 선택이 아니야.
바로 데이터 전처리(Data Preprocessing)야! 🧹
"Garbage in, Garbage out" — 쓰레기 데이터를 넣으면 쓰레기 결과가 나와.
아무리 좋은 알고리즘도 데이터가 엉망이면 소용없어.
평균/중앙값으로 대체
최빈값으로 대체 (범주형)
KNN 기반 대체
해당 행/열 제거
StandardScaler: 평균 0, 표준편차 1
MinMaxScaler: 0~1 범위로 변환
RobustScaler: 이상치에 강함
Log 변환: 왜도 감소
Label Encoding: 순서 있는 범주형
One-Hot Encoding: 순서 없는 범주형
Target Encoding: 고카디널리티
Embedding: 딥러닝용
K-Means는 거리 기반 알고리즘이야.
만약 키(cm)와 몸무게(kg) 데이터를 스케일링 없이 쓰면, 값의 범위가 다르기 때문에 키가 클러스터링에 훨씬 더 큰 영향을 미쳐.
StandardScaler로 스케일링하면 모든 특성이 동등한 영향력을 가지게 돼!
🚀 최신 트렌드: 패턴 인식의 미래
전통적인 클러스터링과 분류 알고리즘을 넘어서, 최근에는 어떤 방향으로 발전하고 있는지 살펴보자! 🌟
🧠 딥러닝 기반 패턴 인식
전통적인 머신러닝 알고리즘의 한계를 뛰어넘는 딥러닝이 패턴 인식에 혁명을 일으키고 있어.
| 딥러닝 모델 | 주요 활용 | 특징 |
|---|---|---|
| CNN (합성곱 신경망) | 이미지 분류, 객체 탐지 | 공간적 패턴 자동 추출 |
| RNN/LSTM | 시계열 분류, 텍스트 분류 | 순서 정보 처리 |
| Transformer/BERT | 자연어 처리, 문서 분류 | 어텐션 메커니즘 |
| 오토인코더 | 이상 탐지, 차원 축소 | 비지도 학습 가능 |
| GAN | 데이터 증강, 패턴 생성 | 생성 모델 |
🌐 자기지도 학습 (Self-Supervised Learning)
레이블 없이도 강력한 표현을 학습하는 자기지도 학습이 주목받고 있어.
대표적으로 Contrastive Learning은 비슷한 데이터는 가깝게, 다른 데이터는 멀게 임베딩을 학습해.
이렇게 학습된 임베딩을 클러스터링이나 분류에 활용하면 레이블이 적어도 높은 성능을 낼 수 있어! 🎯
🤖 AutoML: 알고리즘 선택도 자동화
AutoML(Automated Machine Learning)은 데이터를 넣으면 최적의 알고리즘과 하이퍼파라미터를 자동으로 찾아주는 기술이야.
Google의 AutoML, H2O.ai, Auto-sklearn 등이 대표적이야.
이제 전문 지식 없이도 강력한 패턴 인식 모델을 만들 수 있는 시대가 오고 있어.
하지만 기본 원리를 이해하는 것은 여전히 중요해! 💪
① 설명 가능한 AI (XAI): 왜 이런 분류를 했는지 설명 가능한 모델
② 연합 학습 (Federated Learning): 데이터를 공유하지 않고 분산 학습
③ Few-Shot Learning: 적은 데이터로도 새로운 패턴 학습
④ 멀티모달 학습: 텍스트+이미지+음성을 함께 처리하는 패턴 인식
🎯 실무에서 바로 쓰는 알고리즘 선택 가이드
이론은 다 알겠는데, 실제로 어떤 알고리즘을 써야 할지 모르겠다고?
상황별 선택 가이드를 정리해줄게! 🗺️
그리고 한 가지 더! 알고리즘을 선택할 때 해석 가능성(Interpretability)도 중요하게 고려해야 해.
의료나 금융 분야에서는 "왜 이런 결정을 내렸는지" 설명할 수 있어야 하거든.
이런 경우엔 블랙박스 모델보다 결정 트리나 로지스틱 회귀 같은 해석 가능한 모델이 더 적합해. 🏥
① 항상 단순한 모델부터 시작해서 복잡도를 높여가
② 교차 검증으로 모델 성능을 신뢰성 있게 평가해
③ 특성 중요도를 확인해서 불필요한 특성을 제거해
④ 도메인 지식을 활용해서 의미 있는 특성을 만들어
⑤ 데이터 전처리에 전체 시간의 60~80%를 투자해도 아깝지 않아!
🎓 마무리: 패턴 인식의 여정을 시작하며
자, 여기까지 클러스터링과 분류 알고리즘을 활용한 패턴 인식에 대해 정말 많은 내용을 다뤘어! 🎉
K-Means부터 DBSCAN, 결정 트리, 랜덤 포레스트, SVM, 나이브 베이즈까지...
처음엔 복잡해 보였지만, 각각의 알고리즘이 어떤 문제를 어떻게 해결하는지 이해하면 생각보다 직관적이지 않아? 😊
중요한 건 어떤 알고리즘이 최고다는 게 없다는 거야.
데이터의 특성, 문제의 성격, 필요한 해석 가능성, 계산 자원 등을 종합적으로 고려해서 최적의 선택을 해야 해.
🫧 클러스터링: 레이블 없이 비슷한 데이터끼리 그룹화 (비지도 학습)
→ K-Means (거리 기반), DBSCAN (밀도 기반), 계층적 클러스터링
🏷️ 분류: 레이블 있는 데이터로 학습해서 새 데이터 분류 (지도 학습)
→ 결정 트리, 랜덤 포레스트, SVM, K-NN, 나이브 베이즈
📏 모델 평가: 정확도, F1 점수, 실루엣 점수, 혼동 행렬
🧹 데이터 전처리: 알고리즘보다 더 중요한 기초 작업
🚀 최신 트렌드: 딥러닝, AutoML, 자기지도 학습, XAI
패턴 인식과 머신러닝을 더 깊이 공부하고 싶다면, 직접 데이터를 가지고 실습해보는 게 최고야.
Kaggle 같은 플랫폼에서 공개 데이터셋으로 연습하거나, 재능넷에서 데이터 분석 전문가에게 멘토링을 받는 것도 좋은 방법이야! 📊
이론을 알고 실습을 하면 실력이 배로 늘거든. 화이팅! 💪🔥

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.



아직 댓글이 없습니다.