
Ver3.5 NoSQL의 세계: 키-값, 문서, 칼럼, 그래프 중 당신의 선택은? 🗝️
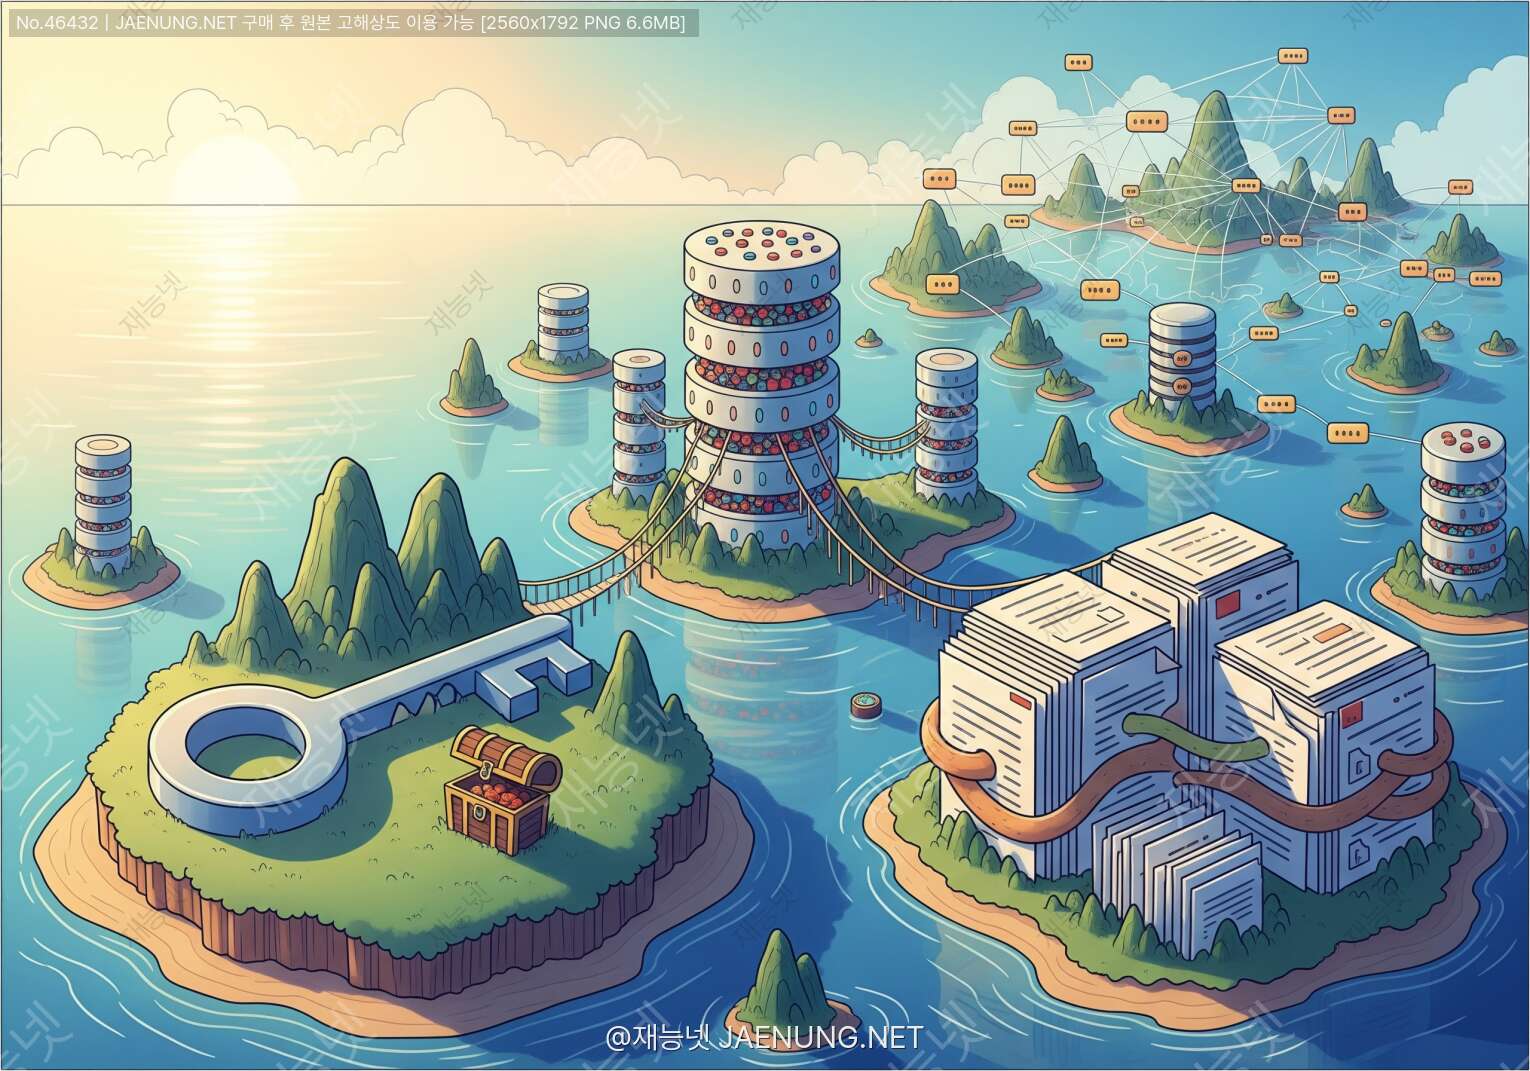
NoSQL의 세계: 키-값, 문서, 칼럼, 그래프 중 당신의 선택은? 🗝️
데이터베이스 선택의 기로에서 — 진짜 쓸 수 있는 NoSQL 완전 정복 가이드
야 솔직히 말해서 처음 NoSQL 들었을 때 "SQL 아닌 거? 그냥 SQL 쓰면 안 돼?" 이런 생각 했던 사람 손 🙋 나만 그랬던 거 아니잖아ㅋㅋㅋ
근데 막상 파고들면 진짜 신세계임. 데이터 구조가 다양해지고, 서비스 규모가 커지면서 기존 관계형 DB(RDBMS)만으로는 한계가 오는 순간이 반드시 찾아오거든. 그 순간 NoSQL이 구원투수로 등판하는 거야 ⚾
이 글에서는 NoSQL의 4대 유형인 키-값(Key-Value), 문서(Document), 칼럼(Column-Family), 그래프(Graph) 데이터베이스를 완전 뜯어보고, 각각 언제 어디서 써야 하는지 팩트 기반으로 정리해줄게. 개발자라면 북마크 필수 🔖
🤔 NoSQL이 뭔데 이렇게 난리야?
먼저 기본부터 짚고 가자. NoSQL은 "Not Only SQL"의 약자야. "SQL 아님"이 아니라 "SQL만이 아님"이라는 뜻이거든. 이 차이가 은근히 중요해 🧐
2000년대 중반, 구글·아마존·페이스북 같은 빅테크들이 폭발적인 데이터 증가를 경험하면서 기존 RDBMS의 한계를 체감하기 시작했어.
전통적인 관계형 DB는 수직 확장(Scale-Up)에 의존하는데, 서버 한 대를 더 좋게 만드는 데는 물리적 한계가 있잖아. 반면 NoSQL은 수평 확장(Scale-Out)이 기본 설계 철학이라 서버를 여러 대 추가하는 방식으로 무한에 가깝게 확장 가능해.
RDBMS의 특징을 잠깐 복습하면:
Atomicity 원자성 Consistency 일관성 Isolation 격리성 Durability 지속성
이 특성들은 데이터 무결성을 완벽하게 보장해주지만, 대규모 분산 환경에서는 성능 병목의 원인이 되기도 해.
반면 NoSQL은 CAP 이론을 기반으로 설계돼. CAP 이론이 뭐냐면:
일관성
모든 노드가 같은 데이터
가용성
항상 응답 가능
분할 내성
네트워크 분리 허용
CAP 이론에 따르면 분산 시스템에서 이 세 가지를 동시에 모두 만족하는 건 불가능해. 그래서 NoSQL DB들은 각자 어떤 두 가지를 선택할지 결정하고 설계된 거야. 이게 NoSQL 유형별로 특성이 다른 이유 중 하나야 💡
자, 이제 본격적으로 4가지 유형을 파헤쳐보자 🔍
🗝️ 키-값(Key-Value) 데이터베이스
가장 단순하지만 가장 빠른 녀석
키-값 DB는 NoSQL 중에서 구조가 제일 단순해. 말 그대로 키(Key)와 값(Value)의 쌍으로 데이터를 저장하는 방식이야. 마치 사전처럼 단어(키)를 찾으면 그 뜻(값)이 나오는 구조 📖
"user:1001" → {"name": "김개발", "age": 28, "level": "senior"}"session:abc123" → {"userId": 1001, "loginTime": "2024-01-15T09:00:00"}"cache:product:5" → {"name": "노트북", "price": 1200000}값(Value)은 문자열, 숫자, JSON, 바이너리 등 거의 모든 형태가 가능해. 키만 알면 O(1) 시간복잡도로 즉시 조회가 가능하기 때문에 속도가 압도적이야 ⚡
대표 DB: Redis 🔴
키-값 DB 하면 단연 Redis(Remote Dictionary Server)가 1등이지. 2009년 살바토레 산필리포가 만든 오픈소스 인메모리 데이터 구조 저장소야.
① 인메모리(In-Memory) 저장
데이터를 RAM에 저장하기 때문에 디스크 I/O가 없어. 초당 수십만 건의 읽기/쓰기가 가능해. 실제로 Redis는 초당 100만 건 이상의 요청을 처리할 수 있어 🚀
② 다양한 데이터 타입 지원
단순 문자열 외에도 List, Set, Sorted Set, Hash, Bitmap, HyperLogLog, Stream 등 다양한 자료구조를 지원해.
③ 영속성(Persistence) 옵션
RDB(스냅샷)와 AOF(Append Only File) 방식으로 디스크에 데이터를 저장해서 서버 재시작 후에도 데이터 복구 가능.
④ Pub/Sub 메시징
메시지 브로커 기능도 있어서 실시간 채팅, 알림 시스템에도 활용돼.
Redis 기본 명령어 맛보기:
# 문자열 저장/조회
SET user:1001:name "김개발"
GET user:1001:name
# → "김개발"

# 만료 시간 설정 (세션 관리에 유용)
SET session:abc123 "user_data" EX 3600  # 1시간 후 자동 삭제

# 해시 저장 (객체 저장에 유용)
HSET user:1001 name "김개발" age 28 level "senior"
HGET user:1001 name
# → "김개발"

# 리스트 (최근 방문 기록 등)
LPUSH recent:user:1001 "product:5" "product:12" "product:3"
LRANGE recent:user:1001 0 4  # 최근 5개 조회

# Sorted Set (랭킹 시스템)
ZADD leaderboard 9850 "user:1001"
ZADD leaderboard 9200 "user:1002"
ZREVRANK leaderboard "user:1001"  # 순위 조회
키-값 DB가 빛나는 순간 ✨
① 세션 관리 — 로그인 세션 저장, 만료 시간 설정이 간편해서 완전 찰떡
② 캐싱(Caching) — DB 쿼리 결과를 Redis에 캐싱하면 응답 속도가 10~100배 빨라짐
③ 실시간 랭킹 — 게임 리더보드, 인기 상품 순위 등 Sorted Set으로 구현
④ 분산 락(Distributed Lock) — 마이크로서비스 환경에서 동시성 제어
⑤ 속도 제한(Rate Limiting) — API 호출 횟수 제한 구현
⑥ 실시간 채팅/알림 — Pub/Sub 기능 활용
복잡한 쿼리 불가 — 키를 알아야만 조회 가능. "나이가 25~30세인 사용자 전체 조회" 같은 범위 검색이 어려워.
관계 표현 어려움 — 테이블 간 JOIN 같은 관계형 연산 불가.
메모리 비용 — 인메모리 방식이라 대용량 데이터 저장 시 비용이 높아.
Amazon DynamoDB도 빼놓을 수 없지 ☁️
AWS의 완전 관리형 키-값 + 문서 DB야. 서버리스 환경에서 자동 확장이 되고, 초당 수백만 건의 요청도 처리 가능해. 넷플릭스, 에어비앤비 같은 대형 서비스들이 실제로 쓰고 있어. 키-값 구조에 문서형의 유연성을 더한 하이브리드 성격이라 실용적이야 👍
📄 문서형(Document) 데이터베이스
JSON을 그대로 저장한다고? 개발자 친화적 끝판왕
문서형 DB는 데이터를 JSON(또는 BSON, XML) 형태의 문서(Document)로 저장해. 각 문서는 자체적인 구조를 가질 수 있어서 스키마가 유연해. 같은 컬렉션 안에 있는 문서들이 서로 다른 필드를 가져도 돼 😮
// 사용자 문서 1{ "_id": ObjectId("..."), "name": "김개발", "email": "dev@example.com", "skills": ["JavaScript", "Python", "MongoDB"], "address": { "city": "서울", "district": "강남구" }, "projects": [ {"name": "쇼핑몰", "role": "백엔드", "year": 2023}, {"name": "채팅앱", "role": "풀스택", "year": 2024} ]}// 사용자 문서 2 (다른 필드 구조도 OK!){ "_id": ObjectId("..."), "name": "이디자인", "portfolio_url": "https://design.example.com", "tools": ["Figma", "Photoshop"], "experience_years": 5}
RDBMS였다면 users 테이블, skills 테이블, projects 테이블, addresses 테이블을 따로 만들고 JOIN으로 연결해야 했을 데이터를 하나의 문서에 다 담을 수 있어. 이게 문서형 DB의 핵심 강점이야 💪
대표 DB: MongoDB 🍃
2009년 출시된 MongoDB는 현재 가장 인기 있는 NoSQL DB야. DB-Engines 랭킹에서 꾸준히 상위권을 유지하고 있어. 이름의 "Mongo"는 "humongous(거대한)"에서 따온 거야 ㅋㅋㅋ 이름부터 스케일이 다르지?
RDBMS: 데이터베이스 → MongoDB: 데이터베이스
RDBMS: 테이블 → MongoDB: 컬렉션(Collection)
RDBMS: 행(Row) → MongoDB: 문서(Document)
RDBMS: 열(Column) → MongoDB: 필드(Field)
RDBMS: JOIN → MongoDB: $lookup (또는 임베딩)
RDBMS: 인덱스 → MongoDB: 인덱스
MongoDB 기본 쿼리 맛보기:
// 문서 삽입
db.users.insertOne({
  name: "박서버",
  age: 30,
  skills: ["Node.js", "MongoDB"],
  active: true
})

// 조회 (SQL의 SELECT * WHERE와 유사)
db.users.find({ age: { $gte: 25, $lte: 35 } })

// 배열 필드 검색 (이게 진짜 편함!)
db.users.find({ skills: "MongoDB" })

// 집계 파이프라인 (강력한 데이터 분석)
db.orders.aggregate([
  { $match: { status: "completed" } },
  { $group: { _id: "$userId", totalAmount: { $sum: "$amount" } } },
  { $sort: { totalAmount: -1 } },
  { $limit: 10 }
])

// 업데이트
db.users.updateOne(
  { name: "박서버" },
  { $push: { skills: "Docker" } }  // 배열에 요소 추가
)
문서형 DB가 빛나는 순간 ✨
① 스키마가 자주 바뀌는 서비스 — 스타트업처럼 빠르게 피벗하는 환경에서 스키마 변경 없이 필드 추가 가능
② 계층적 데이터 — 카테고리-서브카테고리-상품 같은 트리 구조 데이터
③ 콘텐츠 관리 시스템(CMS) — 블로그, 뉴스 등 각 콘텐츠마다 다른 메타데이터
④ 이커머스 상품 카탈로그 — 전자제품, 의류, 식품 등 상품마다 속성이 다름
⑤ 사용자 프로필 — 다양한 SNS 연동, 설정 등 유연한 구조 필요
⑥ 실시간 분석 — MongoDB Atlas의 집계 파이프라인으로 복잡한 분석 가능
복잡한 JOIN 성능 — $lookup으로 JOIN이 가능하지만 RDBMS보다 성능이 떨어질 수 있어.
트랜잭션 복잡성 — MongoDB 4.0부터 멀티 문서 트랜잭션을 지원하지만 RDBMS만큼 성숙하지 않아.
데이터 중복 — 임베딩 방식으로 데이터를 저장하면 중복이 발생할 수 있어.
Firebase Firestore도 알아두자 🔥
구글의 Firebase Firestore는 문서형 NoSQL DB야. 실시간 동기화 기능이 내장되어 있어서 클라이언트에서 데이터 변경을 즉시 감지할 수 있어. 모바일 앱 개발에서 특히 강력해. 재능넷 같은 플랫폼에서 실시간 알림이나 채팅 기능을 구현할 때 Firestore가 좋은 선택이 될 수 있어 👍
📊 칼럼형(Column-Family) 데이터베이스
빅데이터의 세계에서 살아남는 방법
칼럼형 DB는 이름 때문에 헷갈리는 경우가 많아. "칼럼 지향 DB"라고도 하는데, 일반 RDBMS처럼 행(Row) 단위로 저장하는 게 아니라 칼럼(Column) 단위로 데이터를 저장해. 근데 NoSQL의 칼럼형은 정확히는 칼럼 패밀리(Column Family) 구조야 🤔
행 지향 (RDBMS)
디스크에 저장: [id=1, name=김개발, age=28] [id=2, name=이서버, age=32] ...
→ 특정 행 전체를 읽을 때 빠름 (OLTP에 적합)
칼럼 지향 (Column DB)
디스크에 저장: [id: 1,2,3...] [name: 김개발,이서버...] [age: 28,32...]
→ 특정 칼럼 전체를 읽을 때 빠름 (OLAP, 분석에 적합)
→ 같은 타입의 데이터가 연속 저장되어 압축률도 높음
칼럼형 NoSQL DB의 핵심 개념은 행 키(Row Key)를 기준으로 칼럼 패밀리들이 묶이는 구조야. 각 행마다 다른 칼럼을 가질 수 있어서 희소 데이터(Sparse Data)를 효율적으로 저장할 수 있어 💡
대표 DB: Apache Cassandra 👁️
Cassandra는 2008년 페이스북이 개발해서 오픈소스로 공개한 분산 데이터베이스야. 현재는 Apache 재단에서 관리하고 있어. 넷플릭스, 애플, 인스타그램 등이 실제로 사용하는 검증된 DB야.
① 마스터리스(Masterless) 아키텍처
모든 노드가 동등한 역할을 해. 단일 장애점(SPOF)이 없어서 고가용성이 탁월해. 노드 하나가 죽어도 서비스는 계속 돼 💪
② 선형적 확장성
노드를 추가할수록 성능이 선형적으로 증가해. 노드 2배 = 처리량 2배. 이론적으로 무한 확장 가능.
③ 쓰기 성능 최적화
쓰기 작업이 읽기보다 훨씬 빠름. 로그 구조 병합 트리(LSM Tree)를 사용해서 쓰기가 항상 순차적으로 이루어져.
④ 튜너블 일관성(Tunable Consistency)
일관성 수준을 ONE, QUORUM, ALL 등으로 조절 가능. 성능과 일관성 사이의 트레이드오프를 직접 제어할 수 있어.
Cassandra의 CQL(Cassandra Query Language) 맛보기:
-- 키스페이스(데이터베이스) 생성
CREATE KEYSPACE my_app
WITH replication = {
  'class': 'NetworkTopologyStrategy',
  'datacenter1': 3  -- 복제본 3개
};

-- 테이블 생성 (파티션 키 설계가 핵심!)
CREATE TABLE user_events (
  user_id UUID,
  event_time TIMESTAMP,
  event_type TEXT,
  event_data TEXT,
  PRIMARY KEY (user_id, event_time)  -- user_id: 파티션키, event_time: 클러스터링키
) WITH CLUSTERING ORDER BY (event_time DESC);

-- 데이터 삽입
INSERT INTO user_events (user_id, event_time, event_type, event_data)
VALUES (uuid(), toTimestamp(now()), 'LOGIN', '{"ip": "192.168.1.1"}');

-- 조회 (파티션 키 기반 조회가 핵심!)
SELECT * FROM user_events
WHERE user_id = 550e8400-e29b-41d4-a716-446655440000
AND event_time >= '2024-01-01'
LIMIT 100;Cassandra는 RDBMS와 설계 철학이 완전히 달라. RDBMS는 데이터 정규화 후 쿼리를 작성하지만, Cassandra는 먼저 어떤 쿼리를 할지 결정하고 그에 맞게 테이블을 설계해야 해.
파티션 키를 잘못 설계하면 "핫스팟(Hot Spot)" 문제가 생겨서 특정 노드에만 부하가 집중될 수 있어. 이게 Cassandra 학습 곡선이 높은 이유야.
Apache HBase도 알아두자 🐘
HBase는 Hadoop 생태계 위에서 동작하는 칼럼형 DB야. Google의 Bigtable 논문을 기반으로 만들어졌어. HDFS(Hadoop Distributed File System) 위에서 동작하기 때문에 Hadoop 기반 빅데이터 파이프라인과 잘 통합돼. 페이스북이 메시지 저장에 HBase를 사용했던 것으로 유명해.
칼럼형 DB가 빛나는 순간 ✨
① IoT 시계열 데이터 — 센서에서 초당 수천 건씩 들어오는 데이터 저장
② 로그 수집/분석 — 서버 로그, 앱 이벤트 로그 대용량 저장
③ 추천 시스템 데이터 — 사용자 행동 이력 저장 (클릭, 구매, 조회)
④ 금융 거래 이력 — 시간 순서로 쌓이는 대용량 트랜잭션 데이터
⑤ 메시지/채팅 이력 — 대화 내용의 시간순 저장
⑥ 글로벌 분산 서비스 — 여러 데이터센터에 걸친 분산 저장 필요 시
높은 학습 곡선 — 파티션 키, 클러스터링 키 설계를 잘못하면 성능이 오히려 나빠질 수 있어.
복잡한 쿼리 제한 — 파티션 키 없이 임의 칼럼으로 조회하는 게 어려워. 보조 인덱스는 성능 비용이 높아.
운영 복잡성 — 클러스터 관리, 컴팩션(Compaction) 등 운영 지식이 필요해.
🕸️ 그래프(Graph) 데이터베이스
관계가 데이터다 — 연결의 철학
그래프 DB는 4가지 NoSQL 유형 중 가장 독특한 녀석이야. 데이터를 노드(Node)와 엣지(Edge, 관계)로 표현해. 수학의 그래프 이론을 데이터베이스에 적용한 거야 🧮
노드(Node) — 엔티티(사람, 상품, 장소 등). 속성(Properties)을 가질 수 있어.
예: (사람 {이름: "김개발", 나이: 28})
엣지(Edge/Relationship) — 노드 간의 관계. 방향과 속성을 가질 수 있어.
예: (김개발)-[친구이다 {since: 2020}]->(이서버)
속성(Property) — 노드와 엣지가 가지는 키-값 데이터.
레이블(Label) — 노드의 타입을 구분하는 태그.
예: :사람, :상품, :회사
그래프 DB가 진짜 빛나는 건 다단계 관계 탐색이야. "김개발의 친구의 친구의 친구 중 서울에 사는 사람"을 RDBMS로 구현하면 복잡한 재귀 JOIN이 필요하지만, 그래프 DB에서는 자연스럽게 표현돼 🔍
대표 DB: Neo4j 🔵
2007년 출시된 Neo4j는 그래프 DB의 절대 강자야. 자체 쿼리 언어인 Cypher를 사용하는데, 그래프 구조를 ASCII 아트처럼 직관적으로 표현할 수 있어서 가독성이 좋아.
Cypher 쿼리 맛보기:
// 노드 생성
CREATE (kim:사람 {이름: "김개발", 나이: 28, 도시: "서울"})
CREATE (lee:사람 {이름: "이서버", 나이: 32, 도시: "부산"})
CREATE (park:사람 {이름: "박프론트", 나이: 26, 도시: "서울"})

// 관계 생성
MATCH (a:사람 {이름: "김개발"}), (b:사람 {이름: "이서버"})
CREATE (a)-[:친구이다 {since: 2020}]->(b)

// 친구의 친구 찾기 (2단계 관계 탐색)
MATCH (me:사람 {이름: "김개발"})-[:친구이다*2]->(fof:사람)
WHERE NOT (me)-[:친구이다]->(fof) AND me <> fof
RETURN fof.이름, fof.도시

// 최단 경로 찾기
MATCH path = shortestPath(
  (a:사람 {이름: "김개발"})-[:친구이다*]-(b:사람 {이름: "박프론트"})
)
RETURN path, length(path)

// 공통 친구 찾기
MATCH (a:사람 {이름: "김개발"})-[:친구이다]->(공통:사람)
      <-[:친구이다]-(b:사람 {이름: "이서버"})
RETURN 공통.이름소셜 네트워크에서 "5단계 이내의 지인 찾기" 쿼리 기준 (데이터: 100만 명):
RDBMS (MySQL): 수십 초 ~ 수 분 (재귀 JOIN 필요)
Neo4j: 수 밀리초 ~ 수 초
관계가 깊어질수록 그래프 DB의 성능 우위가 기하급수적으로 커져. 이게 그래프 DB를 쓰는 핵심 이유야.
그래프 DB가 빛나는 순간 ✨
① 소셜 네트워크 — 팔로우/팔로워, 친구 추천, 공통 친구 찾기
② 추천 시스템 — "이 상품을 산 사람들이 함께 산 상품" 협업 필터링
③ 사기 탐지(Fraud Detection) — 금융 거래의 이상 패턴, 계좌 간 연결 관계 분석
④ 지식 그래프(Knowledge Graph) — 구글의 Knowledge Panel, 위키피디아 연결
⑤ 네트워크/IT 인프라 관리 — 서버, 서비스, 의존성 관계 시각화
⑥ 공급망 관리 — 제조-유통-판매 복잡한 관계 추적
⑦ 의료 데이터 — 질병-증상-약물 간의 복잡한 관계 분석
대용량 단순 데이터에는 비효율 — 관계가 단순한 데이터는 오히려 RDBMS가 나아.
상대적으로 작은 생태계 — RDBMS나 MongoDB에 비해 커뮤니티와 도구가 적어.
수평 확장의 어려움 — 그래프 데이터를 여러 서버에 분산하는 게 다른 DB보다 복잡해.
Amazon Neptune도 알아두자 ☁️
AWS의 완전 관리형 그래프 DB야. Gremlin과 SPARQL, openCypher를 지원해서 다양한 그래프 쿼리 언어를 쓸 수 있어. 클라우드 환경에서 그래프 DB를 쓰고 싶다면 Neptune이 좋은 선택이야.
⚖️ 4가지 NoSQL 유형 완전 비교
어떤 상황에서 뭘 써야 해?
이제 4가지를 다 알았으니 비교해보자. 이게 진짜 핵심이야 🎯
| 구분 | 키-값 | 문서형 | 칼럼형 | 그래프 |
|---|---|---|---|---|
| 데이터 모델 | 키-값 쌍 | JSON 문서 | 행+칼럼 패밀리 | 노드+엣지 |
| 쿼리 방식 | 키 기반 | 필드 기반 | 파티션키 기반 | 관계 탐색 |
| 확장성 | 매우 높음 | 높음 | 매우 높음 | 중간 |
| 쓰기 성능 | 최고 | 높음 | 매우 높음 | 중간 |
| 읽기 성능 | 최고(단순) | 높음 | 높음(분석) | 최고(관계) |
| 스키마 유연성 | 최고 | 매우 높음 | 중간 | 높음 |
| 학습 곡선 | 낮음 | 낮음 | 높음 | 중간 |
| 대표 DB | Redis, DynamoDB | MongoDB, Firestore | Cassandra, HBase | Neo4j, Neptune |
실제 서비스 시나리오별 선택 가이드 🗺️
상품 카탈로그 → MongoDB (상품마다 다른 속성, 유연한 스키마)
장바구니/세션 → Redis (빠른 읽기/쓰기, 만료 시간 설정)
주문 이력 → RDBMS 또는 Cassandra (트랜잭션 또는 대용량 이력)
상품 추천 → Neo4j (구매 패턴 기반 관계 분석)
사용자 프로필 → MongoDB (다양한 프로필 정보)
피드 캐싱 → Redis (타임라인 빠른 로딩)
팔로우/친구 관계 → Neo4j (관계 탐색, 친구 추천)
활동 로그 → Cassandra (대용량 이벤트 저장)
실시간 센서 데이터 → Cassandra (초당 수만 건 쓰기)
디바이스 상태 캐시 → Redis (최신 상태 빠른 조회)
디바이스 메타데이터 → MongoDB (다양한 디바이스 속성)
디바이스 네트워크 관계 → Neo4j (토폴로지 분석)
🥊 NoSQL vs RDBMS — 진짜 언제 뭘 써야 해?
NoSQL이 좋다고 무조건 RDBMS를 버리는 건 진짜 큰 실수야. 각자 잘하는 게 다르거든 🤝
복잡한 트랜잭션 필요
강한 데이터 일관성 필수
복잡한 JOIN 쿼리 많음
스키마가 안정적
금융/의료/회계 시스템
대용량 데이터 처리
빠른 읽기/쓰기 필요
스키마 변경이 잦음
수평 확장 필요
실시간/빅데이터 서비스
실수 1: "NoSQL이 트렌디하니까 무조건 써야지"
→ 트랜잭션이 중요한 결제 시스템에 MongoDB만 쓰다가 데이터 정합성 문제 발생. RDBMS가 맞는 케이스야.
실수 2: "Redis는 캐시니까 메인 DB로 쓰면 안 되겠지"
→ Redis도 영속성 설정하면 메인 DB로 쓸 수 있어. 단, 메모리 비용과 데이터 크기를 고려해야 해.
실수 3: "MongoDB 쓰면 스키마 설계 안 해도 되겠지"
→ 스키마 없이 마구 넣다 보면 나중에 데이터 정리가 지옥이 돼. 유연하다는 게 설계를 안 해도 된다는 뜻이 아니야.
실수 4: "Cassandra 쓰면 다 빠르겠지"
→ 파티션 키 설계를 잘못하면 오히려 RDBMS보다 느려질 수 있어. 쿼리 패턴 분석이 선행되어야 해.
🏢 실제 기업들은 어떻게 쓰고 있어?
Cassandra 시청 이력, 사용자 활동 로그 (하루 수조 건의 이벤트)
Redis 세션 관리, 실시간 추천 캐싱
EVCache (Redis 기반) 자체 개발 분산 캐시 시스템
넷플릭스는 전 세계 2억 명 이상의 사용자 데이터를 처리하기 위해 Cassandra 클러스터를 수백 개 운영 중이야.
Cassandra 사용자 피드, 미디어 메타데이터
Redis 팔로워 목록, 피드 캐싱, 카운터
PostgreSQL 핵심 사용자 데이터 (RDBMS와 병행)
인스타그램은 초당 수천 건의 사진 업로드를 처리하기 위해 NoSQL을 적극 활용해.
DynamoDB 쇼핑 카트, 세션, 주문 상태
ElastiCache (Redis) 상품 캐싱, 세션
Neptune 상품 추천 그래프
아마존은 DynamoDB를 직접 개발한 회사야. 블랙프라이데이 같은 트래픽 폭증 상황에서도 안정적으로 동작해.
Voldemort (자체 키-값 DB) 사용자 프로필 데이터
Espresso (자체 문서 DB) 멤버 프로필, 연결 데이터
그래프 DB 1촌/2촌/3촌 연결 관계
링크드인은 "당신이 알 수도 있는 사람" 기능을 그래프 DB 기반으로 구현해. 수억 명의 직업 네트워크를 실시간으로 탐색하는 거야.
이처럼 글로벌 대형 서비스들은 단일 DB가 아닌 여러 NoSQL과 RDBMS를 조합해서 사용해. 각 데이터의 특성과 접근 패턴에 맞는 최적의 DB를 선택하는 게 핵심이야 🎯
🌱 NoSQL 입문자를 위한 학습 로드맵
NoSQL 공부 어디서부터 시작해야 할지 막막하지? 단계별로 정리해줄게 📚
구조가 가장 단순하고, 설치도 쉬워. Docker로 5분 만에 로컬 환경 세팅 가능. 캐싱 개념을 이해하면서 NoSQL의 기본 철학을 익히기 좋아.
MongoDB Atlas(클라우드 무료 티어)로 바로 시작 가능. Node.js + Mongoose 조합으로 실제 CRUD 앱을 만들어봐. 스키마 설계 연습이 중요해.
NoSQL을 제대로 쓰려면 분산 시스템의 기본 개념이 필요해. 일관성 vs 가용성 트레이드오프를 이해하면 DB 선택이 훨씬 명확해져.
관심 분야에 따라 선택해. 빅데이터/IoT 쪽이면 Cassandra, 소셜/추천 시스템이면 Neo4j. 각 DB의 공식 문서가 정말 잘 되어 있어.
이론만으론 한계가 있어. 사이드 프로젝트나 재능넷 같은 플랫폼에서 실제 서비스를 만들면서 적용해봐야 진짜 실력이 늘어. 데이터 모델링 연습이 핵심이야.
공식 문서
Redis: redis.io/docs
MongoDB: docs.mongodb.com
Cassandra: cassandra.apache.org/doc
Neo4j: neo4j.com/docs
책
"NoSQL Distilled" — Martin Fowler, Pramod Sadalage
"Designing Data-Intensive Applications" — Martin Kleppmann (강추!)
실습 환경
Docker Compose로 여러 DB를 한 번에 띄워서 비교 실습하는 게 최고야.
🔮 NoSQL의 최신 트렌드
하나의 DB가 여러 모델을 지원하는 트렌드야. ArangoDB는 문서형 + 그래프 + 키-값을 하나의 DB에서 지원해. FaunaDB는 문서형 + 관계형 + 그래프를 통합했어. 복잡한 폴리글랏 아키텍처를 단순화할 수 있어.
DynamoDB On-Demand, MongoDB Atlas Serverless, Firestore 등 사용량 기반 과금 모델이 대세가 되고 있어. 인프라 관리 없이 DB를 쓸 수 있어서 스타트업과 소규모 팀에 특히 유리해.
AI/ML 붐과 함께 벡터 데이터베이스가 새로운 NoSQL 카테고리로 주목받고 있어. Pinecone, Weaviate, Milvus, Qdrant 등이 대표적이야.
텍스트나 이미지를 벡터(숫자 배열)로 변환해서 저장하고, 유사도 기반 검색을 초고속으로 수행해. ChatGPT 같은 LLM에 외부 지식을 연결하는 RAG(Retrieval-Augmented Generation) 아키텍처에서 핵심 역할을 해.
기존 NoSQL DB들도 벡터 검색 기능을 추가하는 추세야. MongoDB Atlas Vector Search, Redis Vector Similarity Search 등이 이미 출시됐어.
Google Spanner, CockroachDB, TiDB 같은 NewSQL DB들은 RDBMS의 ACID 트랜잭션과 NoSQL의 수평 확장성을 동시에 제공해. "SQL의 편의성 + NoSQL의 확장성"이라는 두 마리 토끼를 잡으려는 시도야.
🎯 최종 정리 — 당신의 선택은?
자, 이제 NoSQL 4대 유형을 다 파헤쳤어. 마지막으로 한 줄 요약으로 정리해줄게 ✍️
→ 속도가 생명. 캐시, 세션, 실시간 카운터. "빠르게 저장하고 빠르게 꺼내야 할 때"
→ 유연성이 생명. 다양한 구조의 데이터, 빠른 개발 속도. "JSON을 그대로 저장하고 싶을 때"
→ 확장성이 생명. 대용량 시계열 데이터, 로그, IoT. "초당 수만 건씩 쏟아지는 데이터를 처리할 때"
→ 관계가 생명. 소셜 네트워크, 추천, 사기 탐지. "데이터 간의 연결 관계를 탐색해야 할 때"
결국 NoSQL은 "어떤 게 최고야?"가 아니라 "내 문제에 맞는 도구가 뭐야?"의 관점으로 접근해야 해. 각 유형의 강점과 한계를 이해하고, 실제 데이터 접근 패턴을 분석해서 선택하는 게 진짜 실력이야 💪
개발 공부를 하면서 이런 기술적 지식을 쌓고 싶다면, 재능넷에서 DB/서버 전문가들의 강의나 멘토링을 찾아보는 것도 좋은 방법이야. 이론과 실무 경험을 가진 개발자들에게 직접 배우면 학습 속도가 훨씬 빨라지거든 🚀
🗝️ NoSQL 선택의 황금 법칙
"데이터 모델과 접근 패턴을 먼저 분석하고,
그에 맞는 DB를 선택하라.
기술 트렌드가 아닌 문제 해결이 기준이다."
키-값: 속도 문서: 유연성 칼럼: 확장성 그래프: 관계

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.







아직 댓글이 없습니다.