
Ver3.5 파티셔닝(Partitioning)과 샤딩(Sharding)의 차이와 활용 — 데이터 폭증 시대, 내 DB는 살아남을 수 있을까?
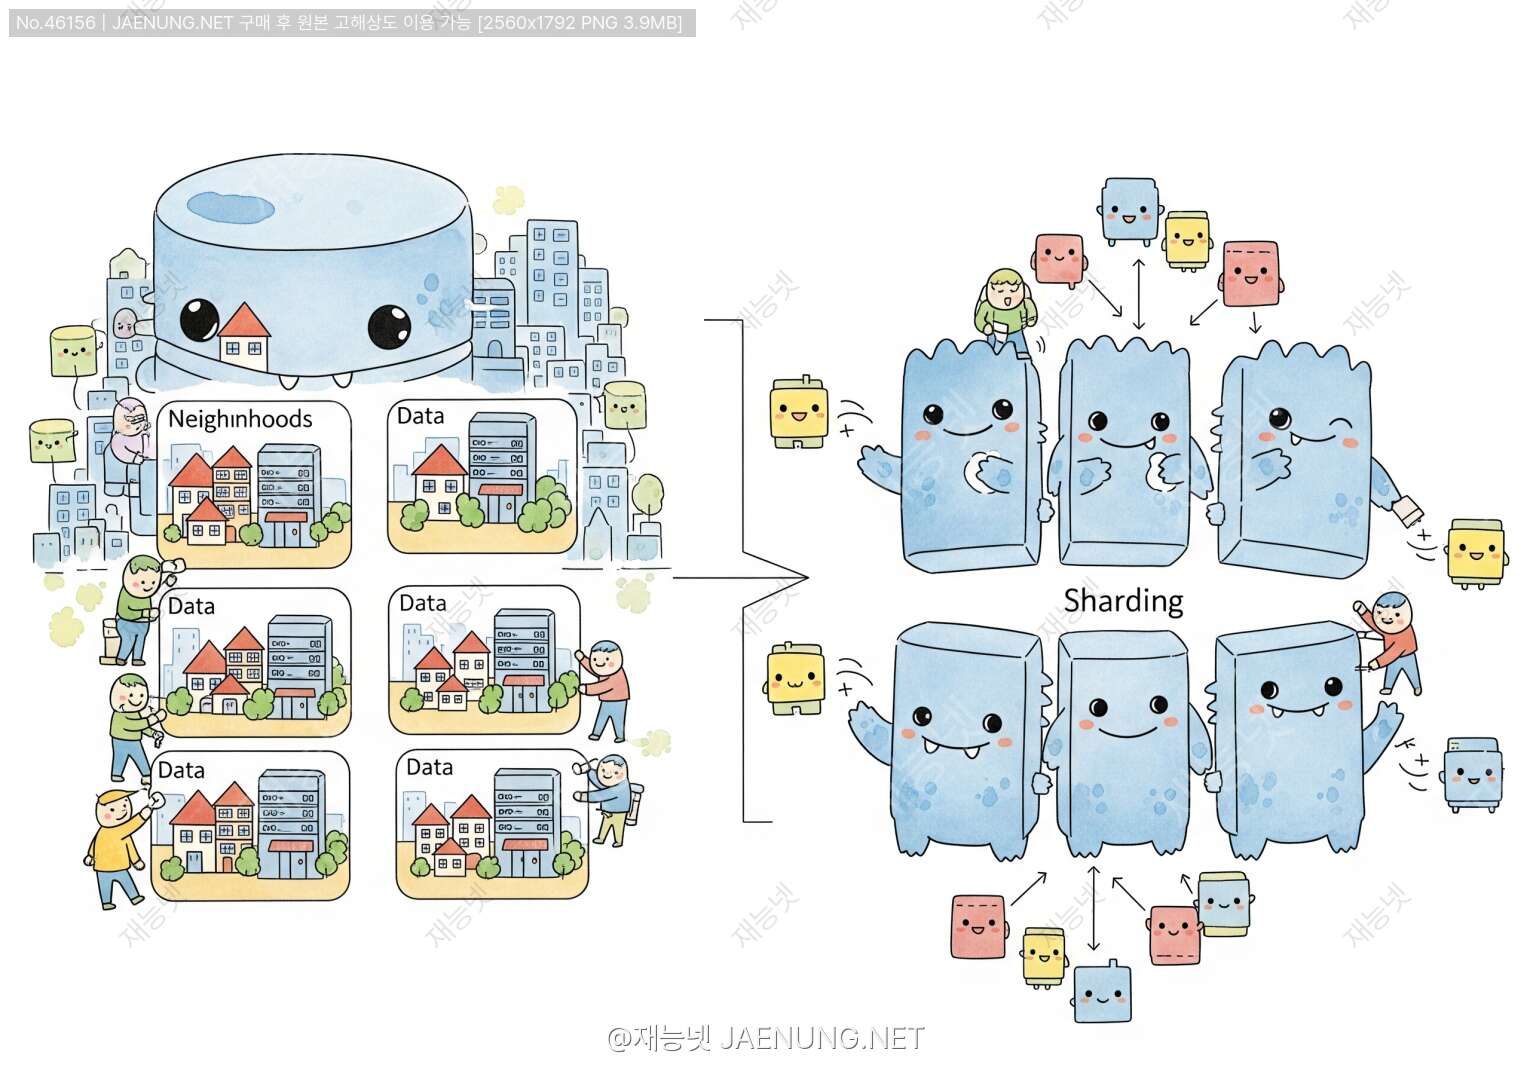
파티셔닝(Partitioning)과 샤딩(Sharding)의 차이와 활용 — 데이터 폭증 시대, 내 DB는 살아남을 수 있을까?
📦 데이터가 폭발적으로 늘어나는 시대, 파티셔닝이랑 샤딩 헷갈리면 진짜 큰일남ㅋㅋ 이 글 하나로 완전 정리해드림!
🚀 들어가며 — 데이터가 너무 많아서 DB가 터질 것 같아요
요즘 서비스 운영하다 보면 진짜 데이터가 장난 아니게 쌓이잖아요?
유저 로그, 주문 내역, 클릭 이벤트, 채팅 메시지... 하루에도 수백만 건씩 쌓이는데
처음엔 그냥 MySQL 하나로 버티다가 어느 순간 쿼리가 30초씩 걸리기 시작하면 😱
그때부터 진짜 공부 시작하게 되는 거 알죠?ㅋㅋㅋ
그 공부의 첫 번째 관문이 바로 파티셔닝(Partitioning)과 샤딩(Sharding)이에요.
이 두 개념, 비슷해 보이지만 완전히 다른 레벨의 이야기거든요.
오늘 이 글에서 진짜 제대로, 팩트 위주로 싹 정리해드릴게요. 레츠고~ 🔥
파티셔닝 = 하나의 DB 서버 안에서 테이블을 쪼개는 것
샤딩 = 여러 DB 서버에 걸쳐서 데이터를 분산하는 것
같은 "쪼갠다"는 개념이지만 스케일이 완전 다름!
📦 파티셔닝(Partitioning)이란? — 하나의 테이블을 조각조각
파티셔닝은 하나의 DB 서버 안에서 거대한 테이블을 여러 개의 작은 조각(파티션)으로 나누는 기술이에요.
물리적으로는 분리되어 있지만, 논리적으로는 여전히 하나의 테이블처럼 보이는 게 핵심이에요!
쉽게 말하면 서랍장 하나에 칸막이 쳐서 정리하는 느낌? 🗂️
파티셔닝의 주요 목적
파티셔닝을 쓰는 이유는 크게 세 가지예요:
① 쿼리 성능 향상
수억 건의 데이터가 있는 테이블에서 WHERE 조건으로 특정 범위만 조회할 때,
파티셔닝이 되어 있으면 해당 파티션만 스캔하면 되니까 훨씬 빠름!
이걸 파티션 프루닝(Partition Pruning)이라고 해요.
② 관리 편의성
오래된 데이터 삭제할 때 파티션 단위로 DROP하면 DELETE 쿼리보다 훨씬 빠르고 효율적이에요.
예를 들어 3년 전 로그 데이터 파티션 통째로 날리기 ✂️
③ 가용성 향상
특정 파티션에 문제가 생겨도 다른 파티션은 정상 동작할 수 있어요.
파티셔닝의 종류 4가지
가장 많이 쓰이는 방식! 날짜, 숫자 범위로 파티션을 나눠요.
예: 2023년 데이터 → 파티션1, 2024년 데이터 → 파티션2
-- MySQL 예시
CREATE TABLE orders (
    order_id INT,
    order_date DATE,
    amount DECIMAL(10,2)
)
PARTITION BY RANGE (YEAR(order_date)) (
    PARTITION p2022 VALUES LESS THAN (2023),
    PARTITION p2023 VALUES LESS THAN (2024),
    PARTITION p2024 VALUES LESS THAN (2025),
    PARTITION p_future VALUES LESS THAN MAXVALUE
);특정 값의 목록으로 파티션을 나눠요. 지역, 카테고리 같은 이산적인 값에 적합!
예: 서울 데이터 → 파티션1, 부산 데이터 → 파티션2
-- MySQL 예시
CREATE TABLE sales (
    sale_id INT,
    region VARCHAR(20),
    amount DECIMAL(10,2)
)
PARTITION BY LIST COLUMNS(region) (
    PARTITION p_seoul VALUES IN ('서울', '경기'),
    PARTITION p_busan VALUES IN ('부산', '경남'),
    PARTITION p_other VALUES IN ('대구', '인천', '광주')
);해시 함수를 이용해서 데이터를 균등하게 분산해요.
어떤 파티션에 들어갈지 예측하기 어렵지만, 데이터가 고르게 퍼지는 게 장점!
-- MySQL 예시
CREATE TABLE user_logs (
    log_id INT,
    user_id INT,
    action VARCHAR(50)
)
PARTITION BY HASH(user_id)
PARTITIONS 8;해시 파티셔닝과 비슷하지만, MySQL이 자체적으로 해시 함수를 관리해요.
PRIMARY KEY나 UNIQUE KEY를 기반으로 파티셔닝할 때 사용!
-- MySQL 예시
CREATE TABLE sessions (
    session_id VARCHAR(64),
    user_id INT,
    created_at DATETIME,
    PRIMARY KEY (session_id)
)
PARTITION BY KEY(session_id)
PARTITIONS 4;시계열 데이터(로그, 주문 내역 등)는 범위 파티셔닝이 거의 국룰이에요.
날짜 기준으로 파티션 나누면 오래된 데이터 정리도 쉽고, 최신 데이터 조회도 빠름!
근데 파티션 키가 WHERE 절에 없으면 파티션 프루닝이 안 되니까 주의해야 해요 ⚠️
🌐 샤딩(Sharding)이란? — 서버를 여러 대로 늘려버리기
샤딩은 파티셔닝보다 훨씬 큰 스케일의 이야기예요.
여러 대의 DB 서버에 데이터를 분산해서 저장하는 방식이에요.
각각의 서버를 샤드(Shard)라고 부르고, 각 샤드는 전체 데이터의 일부만 가지고 있어요.
이건 서랍장 하나에 칸막이 치는 게 아니라, 서랍장 자체를 여러 개 사는 거임ㅋㅋㅋ 🗄️🗄️🗄️
샤딩은 수평 확장(Horizontal Scaling)의 핵심 전략이에요.
서버 한 대의 성능을 올리는 수직 확장(Scale-Up)은 한계가 있잖아요?
그래서 서버를 여러 대 추가해서 부하를 나누는 게 샤딩의 핵심 철학이에요!
샤딩의 주요 방식
특정 값의 범위에 따라 어느 샤드에 저장할지 결정해요.
예: user_id 1~100만 → 샤드1, 101만~200만 → 샤드2
장점: 구현이 단순하고 범위 쿼리에 유리
단점: 데이터가 특정 범위에 몰리면 핫스팟(Hotspot) 문제 발생 😓
(신규 가입자가 계속 마지막 샤드에만 몰리는 현상)
샤딩 키에 해시 함수를 적용해서 어느 샤드에 저장할지 결정해요.
예: hash(user_id) % 4 → 0이면 샤드1, 1이면 샤드2...
장점: 데이터가 균등하게 분산됨
단점: 샤드 수가 바뀌면 리샤딩(Resharding)이 필요해서 운영이 복잡해짐 😅
별도의 룩업 테이블(Lookup Table)을 두고, 어떤 데이터가 어느 샤드에 있는지 기록해요.
장점: 유연하게 샤드를 추가하거나 데이터를 이동할 수 있음
단점: 룩업 테이블 자체가 병목이 될 수 있고, 관리 포인트가 늘어남
사용자의 지역에 따라 샤드를 나눠요.
예: 한국 유저 → 서울 DB 서버, 미국 유저 → 버지니아 DB 서버
장점: 지연 시간(Latency) 최소화, 데이터 주권 규정 준수에 유리
단점: 지역 간 데이터 조인이 어려움
샤딩을 도입하면 분산 트랜잭션이 엄청 복잡해져요.
여러 샤드에 걸친 JOIN 쿼리도 어렵고, 데이터 일관성 유지도 쉽지 않아요.
그래서 샤딩은 "정말 필요할 때" 도입하는 게 맞아요. 오버엔지니어링 주의! 🚨
⚖️ 파티셔닝 vs 샤딩 — 핵심 차이점 완전 정리
자 이제 두 개념을 나란히 놓고 비교해볼게요.
이 표 하나면 면접에서도 자신 있게 설명할 수 있음ㅋㅋㅋ 💪
| 구분 | 파티셔닝 (Partitioning) | 샤딩 (Sharding) |
|---|---|---|
| 범위 | 단일 DB 서버 내부 | 여러 DB 서버에 걸침 |
| 목적 | 쿼리 성능 향상, 관리 편의성 | 수평 확장, 부하 분산 |
| 투명성 | 애플리케이션에 투명 (DB가 알아서) | 애플리케이션이 샤드 인식 필요 |
| 복잡도 | 상대적으로 낮음 | 높음 (분산 트랜잭션, 조인 등) |
| 확장성 | 서버 한 대 한계 내에서만 | 이론상 무한 확장 가능 |
| 장애 격리 | 서버 전체 장애 시 모두 영향 | 특정 샤드 장애 시 일부만 영향 |
| JOIN 쿼리 | 파티션 간 JOIN 가능 | 샤드 간 JOIN 매우 어려움 |
| 트랜잭션 | 일반 트랜잭션 그대로 사용 | 분산 트랜잭션 필요 (복잡) |
| 도입 시점 | 데이터 수백만~수천만 건 | 데이터 수억 건 이상, 단일 서버 한계 |
| 대표 사례 | MySQL Partitioning, PostgreSQL | MongoDB Sharding, Vitess, Cassandra |
단일 서버로 충분 시계열 데이터 범위 쿼리 많음
오래된 데이터 정기 삭제 JOIN 쿼리 필요
데이터가 수천만 건 수준이고, 서버 한 대로 감당 가능하다면 파티셔닝으로 충분해요!
수억 건 이상 데이터 단일 서버 한계 도달
글로벌 서비스 초고속 쓰기 처리
고가용성 필수
단일 서버의 CPU, 메모리, 디스크가 한계에 달했을 때 샤딩을 고려해야 해요!
🏗️ 수직 파티셔닝 vs 수평 파티셔닝 — 파티셔닝도 종류가 있어요
파티셔닝 안에서도 또 나뉘어요. 이거 모르면 반쪽짜리 지식임ㅋㅋ
수직 파티셔닝과 수평 파티셔닝으로 나뉘는데, 완전히 다른 개념이에요!
수평 파티셔닝 (Horizontal Partitioning)
행(Row) 단위로 데이터를 나누는 방식이에요.
같은 컬럼 구조를 유지하면서 데이터를 여러 파티션에 분산해요.
우리가 앞에서 배운 범위, 리스트, 해시 파티셔닝이 모두 수평 파티셔닝이에요!
원본 테이블: users (user_id, name, email, created_at) — 1000만 행
→ 파티션1: user_id 1~250만 (250만 행)
→ 파티션2: user_id 250만~500만 (250만 행)
→ 파티션3: user_id 500만~750만 (250만 행)
→ 파티션4: user_id 750만~1000만 (250만 행)
각 파티션은 동일한 컬럼 구조를 가짐!
수직 파티셔닝 (Vertical Partitioning)
열(Column) 단위로 데이터를 나누는 방식이에요.
자주 쓰는 컬럼과 잘 안 쓰는 컬럼을 분리해서 성능을 높여요.
이건 사실 정규화(Normalization)와 개념이 겹치기도 해요!
원본 테이블: products (product_id, name, price, description, image_data, spec_detail)
→ 자주 조회되는 컬럼: products_main (product_id, name, price)
→ 가끔 조회되는 컬럼: products_detail (product_id, description, image_data, spec_detail)
상품 목록 조회 시엔 products_main만 읽으면 되니까 훨씬 빠름!
image_data 같은 큰 데이터가 있을 때 특히 효과적이에요 🖼️
샤딩은 수평 파티셔닝을 여러 서버에 걸쳐서 하는 거예요.
그래서 샤딩을 "수평 파티셔닝의 분산 버전"이라고 이해하면 딱 맞아요!
파티셔닝 ⊂ 샤딩의 개념적 관계라고 볼 수 있어요.
🔧 실제 DB별 파티셔닝/샤딩 구현 방법
이론만 알면 뭐해요, 실제로 어떻게 쓰는지 알아야죠!
주요 DB별로 파티셔닝과 샤딩 구현 방법을 살펴볼게요 🛠️
MySQL — 파티셔닝
MySQL 5.1부터 파티셔닝을 지원해요. 가장 많이 쓰이는 방식이에요!
-- 기존 테이블에 파티셔닝 추가
ALTER TABLE user_activities
PARTITION BY RANGE (UNIX_TIMESTAMP(created_at)) (
    PARTITION p202301 VALUES LESS THAN (UNIX_TIMESTAMP('2023-02-01')),
    PARTITION p202302 VALUES LESS THAN (UNIX_TIMESTAMP('2023-03-01')),
    PARTITION p202303 VALUES LESS THAN (UNIX_TIMESTAMP('2023-04-01')),
    PARTITION p_future VALUES LESS THAN MAXVALUE
);

-- 파티션 정보 확인
SELECT PARTITION_NAME, TABLE_ROWS
FROM INFORMATION_SCHEMA.PARTITIONS
WHERE TABLE_NAME = 'user_activities';

-- 오래된 파티션 삭제 (초고속!)
ALTER TABLE user_activities DROP PARTITION p202301;

-- 새 파티션 추가
ALTER TABLE user_activities
REORGANIZE PARTITION p_future INTO (
    PARTITION p202304 VALUES LESS THAN (UNIX_TIMESTAMP('2023-05-01')),
    PARTITION p_future VALUES LESS THAN MAXVALUE
);
PostgreSQL — 파티셔닝
PostgreSQL 10부터 선언적 파티셔닝(Declarative Partitioning)을 지원해요.
MySQL보다 더 유연하고 강력한 파티셔닝 기능을 제공해요!
-- 부모 테이블 생성 (파티션 테이블)
CREATE TABLE orders (
    order_id BIGSERIAL,
    customer_id INT,
    order_date DATE NOT NULL,
    amount DECIMAL(12,2)
) PARTITION BY RANGE (order_date);

-- 자식 파티션 생성
CREATE TABLE orders_2023_q1
    PARTITION OF orders
    FOR VALUES FROM ('2023-01-01') TO ('2023-04-01');

CREATE TABLE orders_2023_q2
    PARTITION OF orders
    FOR VALUES FROM ('2023-04-01') TO ('2023-07-01');

CREATE TABLE orders_2023_q3
    PARTITION OF orders
    FOR VALUES FROM ('2023-07-01') TO ('2023-10-01');

CREATE TABLE orders_2023_q4
    PARTITION OF orders
    FOR VALUES FROM ('2023-10-01') TO ('2024-01-01');

-- 인덱스는 각 파티션에 자동 적용됨
CREATE INDEX ON orders (order_date);

-- 쿼리 실행 시 파티션 프루닝 자동 적용
EXPLAIN SELECT * FROM orders
WHERE order_date BETWEEN '2023-04-01' AND '2023-06-30';
MongoDB — 샤딩
MongoDB는 샤딩을 기본 기능으로 지원해요.
mongos(샤드 라우터), Config Server, Shard로 구성돼요!
// mongos에서 샤딩 설정
// 1. 샤딩 활성화
sh.enableSharding("myDatabase")

// 2. 컬렉션에 샤딩 적용 (해시 기반)
sh.shardCollection(
    "myDatabase.users",
    { "user_id": "hashed" }
)

// 3. 범위 기반 샤딩
sh.shardCollection(
    "myDatabase.orders",
    { "order_date": 1 }
)

// 4. 샤드 상태 확인
sh.status()

// 5. 청크 분포 확인
db.adminCommand({ listShards: 1 })
Vitess — MySQL 샤딩 솔루션
Vitess는 YouTube가 개발한 MySQL 샤딩 미들웨어예요.
현재 CNCF(Cloud Native Computing Foundation) 프로젝트로 운영 중이에요.
Slack, Pinterest, GitHub 등 대형 서비스에서 사용 중이에요!
-- Vitess VSchema 설정 예시
{
  "sharded": true,
  "vindexes": {
    "hash": {
      "type": "hash"
    }
  },
  "tables": {
    "users": {
      "column_vindexes": [
        {
          "column": "user_id",
          "name": "hash"
        }
      ]
    }
  }
}

-- 애플리케이션은 일반 MySQL 쿼리 그대로 사용
-- Vitess가 알아서 적절한 샤드로 라우팅해줌!
SELECT * FROM users WHERE user_id = 12345;Vitess를 쓰면 애플리케이션 코드를 거의 수정하지 않고도 MySQL 샤딩을 구현할 수 있어요.
일반 MySQL 쿼리를 그대로 쓰면 Vitess가 알아서 샤드 라우팅을 해줘요.
샤딩의 복잡성을 미들웨어 레이어에서 처리해주는 거죠! 🎉
🌟 실제 서비스 사례 — 대형 서비스들은 어떻게 했을까?
이론 공부도 좋지만, 실제 사례를 보면 훨씬 와닿잖아요?
유명한 서비스들이 어떻게 파티셔닝/샤딩을 활용했는지 살펴볼게요 👀
📸 Instagram — 샤딩으로 수십억 사진 처리
Instagram은 초기에 PostgreSQL을 사용했는데, 사용자가 폭발적으로 늘면서 샤딩이 필요해졌어요.
그들이 선택한 방식은 논리적 샤딩(Logical Sharding)이에요.
핵심 아이디어: 샤드 ID를 ID 자체에 인코딩하는 방식!
Instagram의 ID는 64비트로 구성되어 있어요:
[41비트: 타임스탬프] + [13비트: 논리 샤드 ID] + [10비트: 시퀀스]
이렇게 하면 ID만 보고도 어느 샤드에 있는지 바로 알 수 있어요!
별도의 룩업 테이블 없이도 O(1)으로 샤드를 찾을 수 있는 거죠 🚀
💬 Discord — 수조 건의 메시지 처리
Discord는 처음에 MongoDB를 썼다가 Cassandra로 마이그레이션했어요.
그 후 ScyllaDB로 또 마이그레이션... 데이터 규모가 커지면서 계속 진화한 거예요.
Discord의 메시지 데이터는 channel_id + message_id를 복합 파티션 키로 사용해요.
같은 채널의 메시지는 같은 파티션에 저장되어 빠른 조회가 가능하고,
채널별로 데이터가 분산되어 부하도 균등하게 나눠져요.
🛒 Shopify — Vitess로 MySQL 샤딩
Shopify는 수백만 개의 쇼핑몰을 운영하는 플랫폼이에요.
각 쇼핑몰(Shop)을 기준으로 샤딩을 구현했어요.
Shopify의 샤딩 전략: Shop ID 기반 샤딩
같은 쇼핑몰의 모든 데이터(주문, 상품, 고객)는 같은 샤드에 저장돼요.
이렇게 하면 쇼핑몰 내부 쿼리에서 크로스-샤드 조인이 발생하지 않아요!
🎵 Spotify — 파티셔닝으로 재생 기록 관리
Spotify는 수억 명의 사용자 재생 기록을 관리해야 해요.
날짜 기반 범위 파티셔닝을 사용해서 오래된 데이터를 효율적으로 관리해요.
최근 데이터는 자주 조회되고, 오래된 데이터는 아카이빙하는 패턴에 딱 맞는 전략이에요!
이런 DB 설계나 샤딩 전략에 대해 더 깊이 배우고 싶다면,
재능넷에서 DB 전문가들의 강의나 컨설팅을 찾아볼 수 있어요.
실무 경험이 풍부한 개발자들이 직접 알려주는 노하우는 책에서 못 배우는 것들이 많거든요! 😊
⚡ 샤딩의 핵심 문제들 — 이것만 알면 실무에서 안 당함
샤딩이 만능처럼 보이지만, 실제로 도입하면 골치 아픈 문제들이 한가득이에요.
미리 알고 대비하면 훨씬 덜 고생할 수 있어요! 😤
🔥 문제 1: 핫스팟(Hotspot) 문제
특정 샤드에 트래픽이 몰리는 현상이에요.
범위 기반 샤딩에서 자주 발생해요.
user_id 범위로 샤딩했는데, 신규 가입자가 계속 늘어나면
가장 높은 user_id 범위를 담당하는 샤드에만 쓰기 요청이 몰려요!
해결 방법:
① 해시 기반 샤딩으로 전환 (균등 분산)
② 복합 샤딩 키 사용 (user_id + 날짜 등)
③ 핫스팟 샤드를 추가로 분할 (리샤딩)
🔄 문제 2: 리샤딩(Resharding) 문제
샤드 수를 변경해야 할 때 발생하는 문제예요.
해시 기반 샤딩에서 특히 심각해요.
샤드 4개로 운영 중인데 트래픽이 늘어서 8개로 늘리려면?
hash(user_id) % 4 → hash(user_id) % 8 로 바꾸면
기존 데이터의 절반이 다른 샤드로 이동해야 해요! 😱
해결 방법:
① 일관된 해싱(Consistent Hashing) 사용
→ 샤드 수가 바뀌어도 최소한의 데이터만 이동
② 처음부터 샤드를 충분히 많이 만들어두기 (논리적 샤드)
③ 점진적 마이그레이션 전략 수립
// 일관된 해싱(Consistent Hashing) 개념 코드
// 가상 노드(Virtual Node)를 사용해서 균등 분산

class ConsistentHash {
    constructor(replicas = 150) {
        this.replicas = replicas;  // 가상 노드 수
        this.ring = new Map();     // 해시 링
        this.sortedKeys = [];
    }

    addNode(node) {
        for (let i = 0; i < this.replicas; i++) {
            const hash = this.hash(`${node}:${i}`);
            this.ring.set(hash, node);
            this.sortedKeys.push(hash);
        }
        this.sortedKeys.sort((a, b) => a - b);
    }

    getNode(key) {
        const hash = this.hash(key);
        // 해시 링에서 시계 방향으로 가장 가까운 노드 찾기
        for (const k of this.sortedKeys) {
            if (hash <= k) return this.ring.get(k);
        }
        return this.ring.get(this.sortedKeys[0]);
    }

    hash(key) {
        // 실제로는 MD5, SHA-1 등 사용
        let h = 0;
        for (let c of key) h = (h * 31 + c.charCodeAt(0)) & 0xFFFFFFFF;
        return h;
    }
}

const ch = new ConsistentHash();
ch.addNode('shard-1');
ch.addNode('shard-2');
ch.addNode('shard-3');

console.log(ch.getNode('user:12345'));  // → 'shard-2'
console.log(ch.getNode('user:67890'));  // → 'shard-1'
🔗 문제 3: 크로스-샤드 쿼리 문제
여러 샤드에 걸친 JOIN이나 집계 쿼리가 필요할 때 발생해요.
이게 샤딩의 가장 큰 단점 중 하나예요!
"전체 사용자 중 오늘 가입한 사람 수"를 구하려면?
모든 샤드에 쿼리를 날리고 결과를 합산해야 해요.
해결 방법:
① 크로스-샤드 쿼리가 필요한 데이터는 별도 집계 테이블 유지
② 데이터 웨어하우스(DW)나 OLAP 시스템 활용
③ Apache Spark, Presto 같은 분산 쿼리 엔진 사용
④ 애플리케이션 레이어에서 Fan-out 쿼리 후 머지
💰 문제 4: 분산 트랜잭션 문제
여러 샤드에 걸친 트랜잭션이 필요할 때 발생해요.
ACID 보장이 매우 어려워져요!
A 유저(샤드1)가 B 유저(샤드3)에게 포인트를 전송하는 경우
→ 샤드1에서 차감 + 샤드3에서 증가가 원자적으로 이루어져야 함!
해결 방법:
① 2PC(2-Phase Commit): 성능 저하 있지만 강한 일관성
② Saga 패턴: 보상 트랜잭션으로 최종 일관성 보장
③ 설계 단계에서 크로스-샤드 트랜잭션 최소화
④ 같은 샤드에 있어야 하는 데이터는 같은 샤드 키 사용
샤딩은 복잡성을 엄청나게 높여요. 도입 전에 이런 것들을 먼저 시도해보세요:
1️⃣ 쿼리 최적화 및 인덱스 튜닝
2️⃣ 읽기 복제본(Read Replica) 추가
3️⃣ 캐싱 레이어(Redis, Memcached) 도입
4️⃣ 파티셔닝 적용
5️⃣ 수직 확장(Scale-Up)
이것들로도 안 될 때 샤딩을 고려하세요!
🎯 파티셔닝 + 샤딩 함께 쓰기 — 최강 조합
파티셔닝과 샤딩은 서로 배타적인 게 아니에요!
각 샤드 내부에서 파티셔닝을 적용하면 더 강력한 성능을 낼 수 있어요.
이걸 복합 파티셔닝(Composite Partitioning)이라고도 해요 🔥
전체 데이터 → 4개 샤드로 분산 (user_id 기반 해시 샤딩)
각 샤드 내부 → 날짜 기반 범위 파티셔닝
샤드1 (user_id 해시 0번)
├── 파티션 2022 (2022년 데이터)
├── 파티션 2023 (2023년 데이터)
└── 파티션 2024 (2024년 데이터)
샤드2 (user_id 해시 1번)
├── 파티션 2022
├── 파티션 2023
└── 파티션 2024
이렇게 하면 특정 사용자의 특정 기간 데이터를 조회할 때
① 해당 샤드로 라우팅 (샤딩 효과)
② 해당 연도 파티션만 스캔 (파티셔닝 효과)
두 가지 최적화가 동시에 적용돼요! 🚀
Cassandra의 파티셔닝 + 클러스터링
Cassandra는 이 개념을 아주 잘 구현한 DB예요.
파티션 키(Partition Key)로 어느 노드에 저장할지 결정하고,
클러스터링 키(Clustering Key)로 파티션 내부 정렬을 결정해요!
-- Cassandra CQL 예시
CREATE TABLE user_messages (
    user_id UUID,           -- 파티션 키: 어느 노드에 저장할지
    message_date DATE,      -- 클러스터링 키: 파티션 내 정렬
    message_id TIMEUUID,    -- 클러스터링 키: 시간순 정렬
    content TEXT,
    PRIMARY KEY ((user_id, message_date), message_id)
) WITH CLUSTERING ORDER BY (message_id DESC);

-- 특정 사용자의 특정 날짜 메시지 조회 (초고속!)
SELECT * FROM user_messages
WHERE user_id = ? AND message_date = '2024-01-15'
LIMIT 50;
Cassandra에서 (user_id, message_date)가 복합 파티션 키예요.
같은 사용자의 같은 날짜 메시지는 같은 노드에 저장되어 빠른 조회가 가능하고,
다른 사용자는 다른 노드에 분산되어 부하가 균등하게 나눠져요!
📊 성능 비교 — 실제로 얼마나 빨라질까?
"이론은 알겠는데 실제로 얼마나 빨라져요?" 라고 물어보시는 분들을 위해!
일반적인 성능 개선 수치를 공유할게요 (환경마다 다를 수 있어요!)
| 시나리오 | 적용 전 | 적용 후 | 개선율 |
|---|---|---|---|
| 1억 건 테이블 범위 쿼리 (파티셔닝 적용) |
15~30초 | 0.1~0.5초 | 30~300배 ⬆️ |
| 오래된 데이터 삭제 (파티션 DROP vs DELETE) |
수십 분~수 시간 | 수 초 | 수백 배 ⬆️ |
| 초당 쓰기 처리량 (샤딩 4개 적용) |
5,000 TPS | 18,000~20,000 TPS | 약 4배 ⬆️ |
| 읽기 처리량 (샤딩 8개 적용) |
10,000 QPS | 70,000~80,000 QPS | 약 7~8배 ⬆️ |
| 단일 레코드 조회 (샤딩 + 인덱스) |
50~200ms | 1~5ms | 10~200배 ⬆️ |
위 수치는 일반적인 참고값이에요. 실제 성능은 하드웨어 스펙, 데이터 특성,
쿼리 패턴, 인덱스 설계 등에 따라 크게 달라져요.
반드시 본인 환경에서 벤치마크 테스트를 해보세요! 📊
🛡️ 파티셔닝/샤딩 설계 시 체크리스트
실제로 파티셔닝이나 샤딩을 도입할 때 반드시 확인해야 할 것들이에요.
이 체크리스트 하나면 실수를 많이 줄일 수 있어요! ✅
- ☑️ 파티션 키 선택: WHERE 절에 자주 등장하는 컬럼인가?
- ☑️ 파티션 수: 너무 많으면 오버헤드, 너무 적으면 효과 없음 (보통 10~100개)
- ☑️ 파티션 프루닝 확인: EXPLAIN으로 파티션 프루닝이 실제로 작동하는지 확인
- ☑️ 인덱스 전략: 파티션 키가 인덱스에 포함되어 있는가?
- ☑️ 파티션 유지보수 계획: 새 파티션 추가, 오래된 파티션 삭제 자동화
- ☑️ 파티션 간 데이터 불균형 모니터링
- ☑️ 파티션 키 변경 불가: 한번 설정하면 바꾸기 매우 어려움!
- ☑️ 외래키 제약: MySQL에서 파티션 테이블은 외래키 사용 불가
- ☑️ 샤딩 키 선택: 데이터 분산이 균등한가? 핫스팟 위험은 없는가?
- ☑️ 크로스-샤드 쿼리 최소화: 설계 단계에서 크로스-샤드 쿼리 최대한 제거
- ☑️ 분산 트랜잭션 처리 방안 수립
- ☑️ 샤드 라우팅 로직 구현 (미들웨어 or 애플리케이션)
- ☑️ 리샤딩 전략 수립: 나중에 샤드 추가 시 어떻게 할 것인가?
- ☑️ 모니터링 체계: 각 샤드별 부하, 데이터 분포 모니터링
- ☑️ 백업/복구 전략: 각 샤드별 독립적인 백업 필요
- ☑️ 글로벌 ID 생성 전략: 샤드 간 중복 없는 고유 ID 생성 방법
- ☑️ 장애 대응 계획: 특정 샤드 장애 시 서비스 영향 범위와 복구 방법
좋은 샤딩 키는 다음 세 가지를 만족해야 해요:
① 높은 카디널리티 — 값의 종류가 많아야 균등 분산 가능
② 균등한 분포 — 특정 값에 데이터가 몰리지 않아야 함
③ 쿼리 패턴과 일치 — 자주 쓰는 쿼리의 WHERE 조건과 일치해야 함
🔮 최신 트렌드 — 클라우드 시대의 파티셔닝/샤딩
요즘은 클라우드 DB 서비스들이 파티셔닝/샤딩을 자동으로 처리해줘서
개발자가 직접 구현할 일이 줄어들고 있어요.
하지만 원리를 모르면 설정도 못 하고 트러블슈팅도 못 하니까 알아야 해요! 😤
☁️ 클라우드 DB의 자동 샤딩
파티션 키 기반으로 자동 샤딩을 처리해요.
파티션 키를 잘 설계하면 DynamoDB가 알아서 데이터를 분산해요.
단, 핫 파티션 문제는 여전히 개발자가 신경 써야 해요!
Google Cloud Spanner
전 세계적으로 분산된 관계형 DB예요.
자동 샤딩 + 강한 일관성 + 글로벌 분산을 동시에 제공해요.
비용이 비싸지만 글로벌 서비스에는 최강의 선택!
Azure Cosmos DB
파티션 키 기반 자동 샤딩을 지원해요.
멀티 모델(문서, 그래프, 키-값 등)을 지원하는 게 특징이에요.
PlanetScale
Vitess 기반의 MySQL 호환 클라우드 DB예요.
자동 샤딩 + 스키마 변경 무중단 배포를 지원해요.
GitHub이 사용하는 DB로 유명해요!
🆕 NewSQL — 샤딩을 내장한 새로운 DB들
전통적인 RDBMS의 ACID 보장 + NoSQL의 수평 확장성을 동시에 제공하는
NewSQL 계열 DB들이 주목받고 있어요!
PostgreSQL 호환 분산 SQL DB예요.
자동 샤딩, 자동 리밸런싱, 강한 일관성을 제공해요.
이름처럼 바퀴벌레처럼 죽지 않는 고가용성이 특징 🪳
TiDB
MySQL 호환 분산 SQL DB예요. (PingCAP 개발)
OLTP + OLAP를 동시에 처리하는 HTAP 아키텍처가 특징이에요.
국내 대형 서비스들도 점점 도입하는 추세!
YugabyteDB
PostgreSQL 호환 분산 SQL DB예요.
지역 기반 분산과 강한 일관성을 동시에 제공해요.
파티셔닝/샤딩 설계나 마이그레이션이 필요하다면
재능넷에서 DB 아키텍처 전문가를 찾아보세요!
실무 경험이 풍부한 전문가들이 여러분의 서비스에 맞는 최적의 전략을 제안해드릴 거예요 🎯
📝 마무리 — 핵심 정리
자 이제 파티셔닝과 샤딩에 대해 완전히 정리됐죠?ㅋㅋㅋ
마지막으로 핵심 내용을 한 번 더 정리해드릴게요!
- ✅ 단일 DB 서버 내에서 테이블을 물리적으로 분할
- ✅ 종류: 범위, 리스트, 해시, 키 파티셔닝
- ✅ 방향: 수평(행 분할) vs 수직(열 분할)
- ✅ 장점: 쿼리 성능 향상, 관리 편의성, 구현 단순
- ✅ 단점: 서버 한 대 한계 내에서만 확장 가능
- ✅ 적합한 상황: 시계열 데이터, 수천만~수억 건, 범위 쿼리 많음
- ✅ 여러 DB 서버에 데이터를 분산 저장
- ✅ 종류: 범위, 해시, 디렉토리, 지역 기반 샤딩
- ✅ 장점: 이론상 무한 수평 확장, 고가용성
- ✅ 단점: 복잡성 증가, 크로스-샤드 쿼리 어려움, 분산 트랜잭션
- ✅ 적합한 상황: 수억 건 이상, 단일 서버 한계 도달, 글로벌 서비스
- ✅ 주의: 오버엔지니어링 금지! 정말 필요할 때만 도입
파티셔닝과 샤딩은 "데이터를 쪼갠다"는 공통점이 있지만,
파티셔닝은 서버 내부 최적화, 샤딩은 서버 간 분산이에요.
대부분의 서비스는 파티셔닝만으로도 충분하고,
샤딩은 정말 단일 서버의 한계에 부딪혔을 때 도입하는 게 맞아요.
그리고 두 기술은 함께 사용할 수 있어서, 샤딩된 각 샤드에 파티셔닝을 적용하면 최강 조합이 돼요! 🚀

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.







아직 댓글이 없습니다.