
Ver3.5 K-means vs DBSCAN
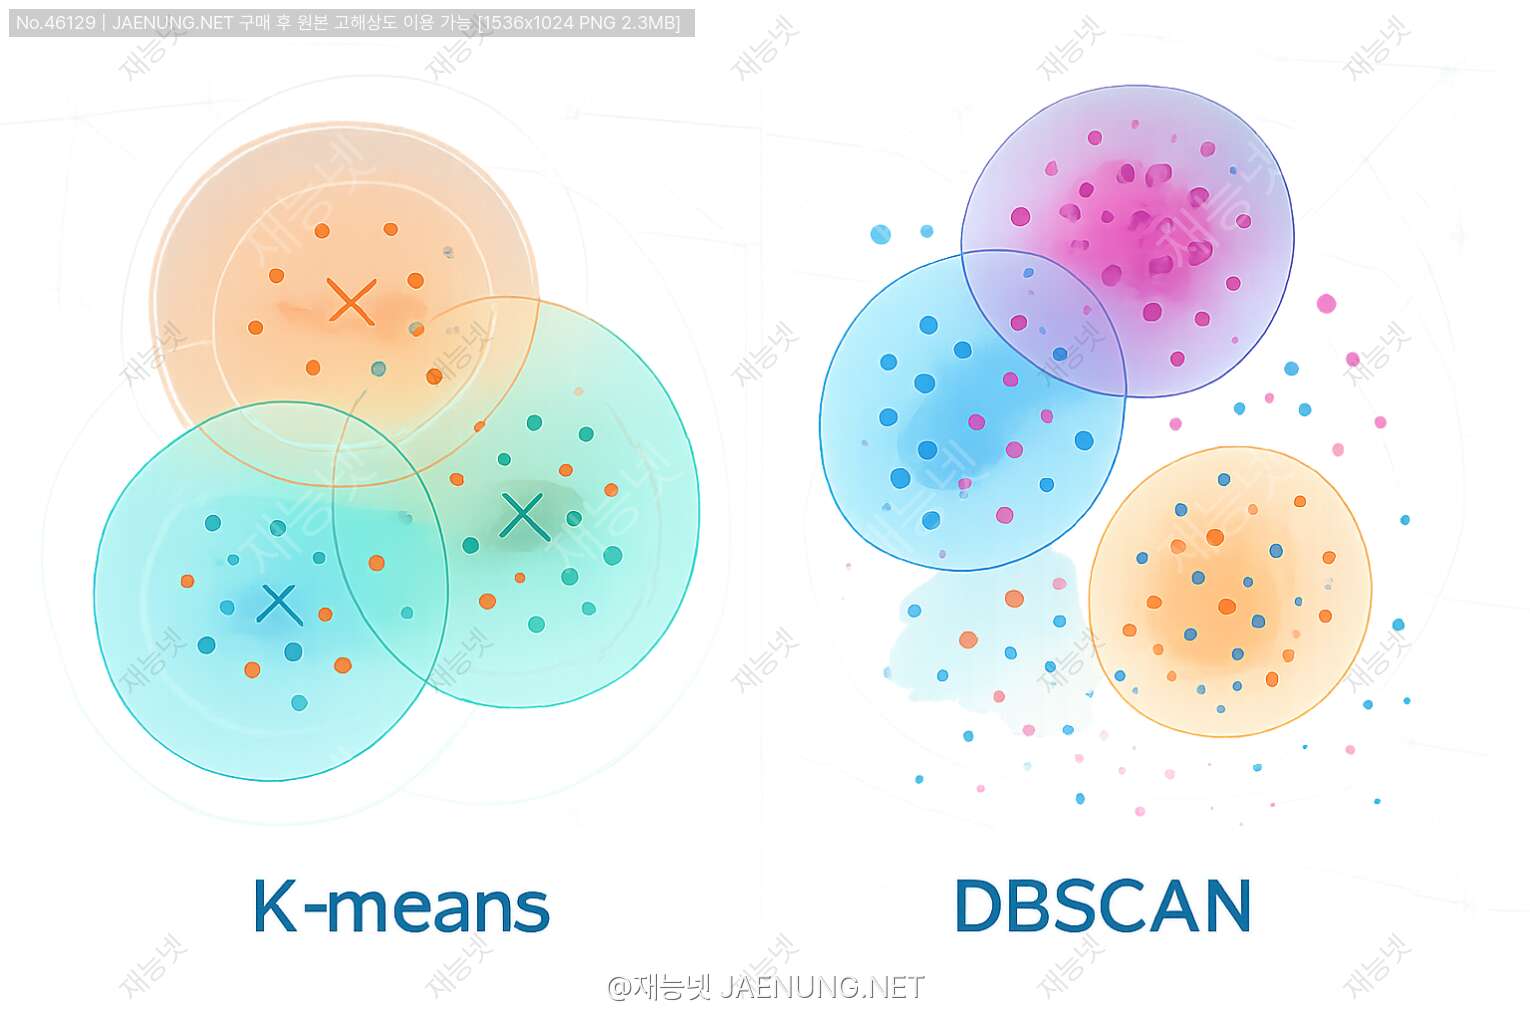
K-means vs DBSCAN
클러스터링 알고리즘 특성 완전 정복 🔍
어떤 상황에서 뭘 써야 하는지, 이제 헷갈리지 말자!
야 솔직히 말해서 ㅋㅋㅋ 머신러닝 공부하다 보면 클러스터링 파트에서 K-means랑 DBSCAN 이 두 녀석 때문에 멘탈 나가는 사람 엄청 많잖아요 😅
"둘 다 클러스터링 아니야? 그냥 아무거나 쓰면 되는 거 아님?" 이러다가 나중에 프로젝트에서 완전 박살나는 거 실화임 ㅠㅠ
오늘은 이 두 알고리즘을 진짜 제대로, 근데 재미있게 뜯어볼 거예요.
개념부터 수식, 실전 적용까지 — 다 끝나고 나면 "아 이래서 다른 거구나!" 하고 무릎 탁 치게 될 거임 🙌
클러스터링(Clustering)은 비지도 학습(Unsupervised Learning)의 대표 주자예요.
쉽게 말하면 — 라벨(정답) 없이 데이터를 알아서 비슷한 것끼리 묶어주는 기술이에요 🎯
예를 들어 고객 데이터가 10만 개 있는데, 누가 VIP인지 누가 이탈 위험인지 라벨이 없다고 해봐요.
클러스터링을 쓰면 "이 그룹은 구매 패턴이 비슷하네", "저 그룹은 접속 빈도가 낮네" 이런 식으로 자동으로 그룹을 만들어줘요.
클러스터링 알고리즘은 종류가 엄청 많은데, 그 중에서 가장 많이 쓰이고 가장 많이 비교되는 게 바로 K-means와 DBSCAN이에요.
클러스터링의 목표: 같은 클러스터 내 데이터는 최대한 유사하게, 다른 클러스터 간 데이터는 최대한 다르게 묶는 것!
K-means는 1957년에 Stuart Lloyd가 처음 제안하고, 1967년 James MacQueen이 "K-means"라는 이름을 붙인 역사 깊은 알고리즘이에요.
지금도 전 세계에서 가장 많이 쓰이는 클러스터링 알고리즘 중 하나임 ㅋㅋㅋ 이유가 있겠죠?
K-means의 핵심 아이디어는 "각 데이터 포인트를 가장 가까운 중심점(Centroid)에 배정하고, 중심점을 반복적으로 업데이트"하는 거예요.
Step 2. 각 데이터 포인트를 가장 가까운 중심점에 배정 (클러스터 형성)
Step 3. 각 클러스터의 평균값으로 중심점 업데이트
Step 4. 중심점이 더 이상 변하지 않을 때까지 Step 2~3 반복
Step 5. 수렴(Convergence) 완료 → 최종 클러스터 확정
K-means가 최소화하려는 목적함수(Objective Function)는 WCSS(Within-Cluster Sum of Squares)예요:
J = Σ(k=1 to K) Σ(x ∈ Ck) ||x - μk||²

여기서:
  K  = 클러스터 수
  Ck = k번째 클러스터
  μk = k번째 클러스터의 중심점(평균)
  x  = 데이터 포인트
  ||x - μk||² = 유클리드 거리의 제곱
즉, 각 데이터 포인트와 자기 클러스터 중심점 사이의 거리 제곱합을 최소화하는 거예요.
이게 작을수록 클러스터가 촘촘하게 잘 묶인 거임 👍
기본 K-means는 초기 중심점을 랜덤으로 잡아서 결과가 들쭉날쭉할 수 있어요.
그래서 2007년 Arthur & Vassilvitskii가 K-means++를 제안했는데, 초기 중심점을 서로 멀리 떨어지도록 확률적으로 선택해서 훨씬 안정적인 결과를 냄 ㅎㅎ
scikit-learn에서 기본값이 K-means++인 이유가 바로 이거예요!
from sklearn.cluster import KMeans

# K-means++ 사용 (init='k-means++' 가 기본값)
kmeans = KMeans(n_clusters=3, init='k-means++', n_init=10, random_state=42)
kmeans.fit(X)

labels = kmeans.labels_          # 각 데이터의 클러스터 번호
centers = kmeans.cluster_centers_ # 중심점 좌표
inertia = kmeans.inertia_ # WCSS 값K-means의 가장 큰 고민 중 하나가 "K를 몇으로 설정하냐"예요.
이때 쓰는 대표적인 방법이 엘보우 메서드(Elbow Method)임!
K가 늘어날수록 WCSS는 줄어드는데, 어느 순간 급격히 줄다가 완만해지는 지점이 생겨요.
그 꺾이는 지점(팔꿈치처럼 생겼다고 해서 Elbow!)이 최적의 K값이에요.
단점: 꺾이는 지점이 명확하지 않을 때도 많아서 주관적 판단이 필요함 ㅠ
엘보우 메서드 외에도 실루엣 계수(Silhouette Score)도 많이 써요.
실루엣 계수는 -1~1 사이 값으로, 1에 가까울수록 클러스터링이 잘 된 거예요.
from sklearn.metrics import silhouette_score

# 실루엣 계수 계산
score = silhouette_score(X, kmeans.labels_)
print(f"실루엣 계수: {score:.4f}")
# 0.7 이상이면 꽤 좋은 클러스터링!✔ 계산 속도가 빠름 (대용량 데이터 OK)
✔ 시간복잡도: O(n·K·I·d)
(n=데이터수, K=클러스터수,
I=반복횟수, d=차원)
✔ 결과 해석이 쉬움
✔ 메모리 효율적
✗ 구형(원형) 클러스터만 잘 찾음
✗ 이상치(Outlier)에 취약
✗ 초기 중심점에 따라 결과 달라짐
✗ 클러스터 크기/밀도 차이 크면 성능 저하
✗ 고차원 데이터에서 성능 저하
DBSCAN은 Density-Based Spatial Clustering of Applications with Noise의 약자예요.
1996년 Martin Ester, Hans-Peter Kriegel 등이 KDD 컨퍼런스에서 발표한 알고리즘으로, 발표 당시 엄청난 주목을 받았고 2014년에 KDD Test of Time Award까지 받은 레전드 논문임 ㅋㅋㅋ 👑
K-means와 완전히 다른 철학으로 접근해요.
K-means가 "중심점 기반"이라면, DBSCAN은 "밀도(Density) 기반"이에요.
"데이터가 빽빽하게 모여있는 곳이 클러스터다!" 라는 아이디어죠.
즉, 두 점 사이의 거리가 ε 이하면 서로 이웃 관계!
2. MinPts — 최소 이웃 수
반경 ε 안에 MinPts개 이상의 점이 있어야 "핵심 포인트(Core Point)"가 돼요.
3. 세 가지 포인트 유형
🔴 핵심 포인트(Core Point): ε 반경 안에 MinPts개 이상의 이웃이 있는 점
🟡 경계 포인트(Border Point): 핵심 포인트의 이웃이지만 자신은 핵심 포인트가 아닌 점
⚫ 노이즈 포인트(Noise Point): 핵심 포인트도 경계 포인트도 아닌 점 (이상치!)
Step 2. p의 ε-이웃(Neighborhood)을 조회
Step 3-A. 이웃 수 ≥ MinPts → p는 핵심 포인트! 새 클러스터 시작
이웃들을 재귀적으로 탐색하며 클러스터 확장
Step 3-B. 이웃 수 < MinPts → 일단 노이즈로 표시 (나중에 바뀔 수 있음)
Step 4. 모든 점을 방문할 때까지 반복
핵심 포인트 조건:
  |Nε(p)| ≥ MinPts

여기서:
  Nε(p) = {q ∈ D | dist(p, q) ≤ ε}  (p의 ε-이웃 집합)
  |Nε(p)| = 이웃 집합의 크기

밀도 직접 도달 가능(Directly Density-Reachable):
  q는 p에서 직접 밀도 도달 가능
  ↔ q ∈ Nε(p) AND |Nε(p)| ≥ MinPts

밀도 도달 가능(Density-Reachable):
  p1, p2, ..., pn 체인이 존재하여
  각 pi+1이 pi에서 직접 밀도 도달 가능

밀도 연결(Density-Connected):
p와 q가 어떤 점 o에서 모두 밀도 도달 가능그래프에서 급격히 꺾이는 지점의 거리값을 ε로 설정하면 좋아요!
(k = MinPts - 1 로 설정)
💡 MinPts 설정 방법
일반적으로 MinPts ≥ 데이터 차원 수 + 1 을 권장해요.
2D 데이터면 MinPts = 4, 고차원이면 더 크게 설정!
from sklearn.cluster import DBSCAN
import numpy as np

# DBSCAN 적용
dbscan = DBSCAN(eps=0.5, min_samples=5, metric='euclidean')
dbscan.fit(X)

labels = dbscan.labels_
# -1은 노이즈 포인트!

n_clusters = len(set(labels)) - (1 if -1 in labels else 0)
n_noise = list(labels).count(-1)

print(f"클러스터 수: {n_clusters}")
print(f"노이즈 포인트 수: {n_noise}")

# 핵심 포인트 인덱스
core_samples = dbscan.core_sample_indices_✔ 임의 형태 클러스터 탐지 가능
✔ 노이즈·이상치 자동 분리
✔ 클러스터 수 자동 결정
✔ 밀도 차이 있는 데이터에 강함
✔ 비볼록(Non-convex) 형태 OK
✗ 밀도가 다른 클러스터 처리 어려움
✗ 고차원 데이터에서 성능 저하
(차원의 저주 문제)
✗ 대용량 데이터에서 느릴 수 있음
(공간 인덱스 없으면 O(n²))
✗ 경계 포인트 배정이 비결정적
자 이제 본격적으로 두 알고리즘을 맞대결 시켜볼게요 ㅋㅋㅋ
어떤 상황에서 뭘 써야 하는지 이 섹션 읽고 나면 완전히 감 잡을 수 있을 거예요 💪
| 비교 항목 | K-means | DBSCAN |
|---|---|---|
| 알고리즘 유형 | 중심점 기반 (Centroid-based) | 밀도 기반 (Density-based) |
| 클러스터 수 | 사전 지정 필요 (K값) | 자동 결정 |
| 클러스터 형태 | 구형(원형)에 최적화 | 임의 형태 가능 |
| 이상치 처리 | 클러스터에 강제 배정 | 노이즈로 자동 분리 |
| 파라미터 | K (클러스터 수) | ε, MinPts |
| 시간복잡도 | O(n·K·I·d) | O(n log n) ~ O(n²) |
| 대용량 데이터 | 매우 빠름 ✅ | 공간 인덱스 필요 |
| 고차원 데이터 | 어느 정도 가능 | 차원의 저주 취약 |
| 결과 재현성 | 초기값에 따라 다름 | 결정적 (동일 결과) |
| 클러스터 밀도 차이 | 처리 어려움 | 처리 어려움 |
| 대표 사용 사례 | 고객 세분화, 이미지 압축 | 지리 데이터, 이상 탐지 |
K-means와 DBSCAN의 가장 큰 차이는 클러스터 형태에 있어요.
K-means는 내부적으로 유클리드 거리를 사용하기 때문에 구형(볼록한 형태) 클러스터를 가정해요.
반면 DBSCAN은 밀도 기반이라 달팽이 모양, 반달 모양, 링 모양 등 어떤 형태든 찾아낼 수 있어요!
K-means (K=2): 완전히 실패! 원의 중심에서 거리 기반으로 나누니까 반반 잘라버림 ✗
DBSCAN: 완벽하게 성공! 밀도 기반으로 안쪽 원과 바깥쪽 원을 정확히 분리 ✓
고객을 VIP / 일반 / 이탈 위험 등으로 분류할 때 K-means가 딱이에요.
클러스터 수(K)를 비즈니스 목적에 맞게 설정할 수 있고, 결과 해석도 쉬워요.
2. 이미지 압축 (Image Compression)
이미지의 픽셀 색상값을 K-means로 클러스터링해서 K개의 대표 색상만 남기는 방식이에요.
K=16이면 16가지 색상만으로 이미지를 표현 → 파일 크기 대폭 감소!
3. 문서 클러스터링
TF-IDF 벡터로 변환한 문서들을 K-means로 묶어서 주제별 분류 가능.
뉴스 기사 자동 분류, 논문 주제 분류 등에 활용돼요.
4. 추천 시스템
비슷한 취향의 사용자를 K-means로 묶고, 같은 클러스터 내 사용자가 좋아하는 아이템을 추천!
도시 형태가 원형이 아니고 불규칙하니까 DBSCAN이 훨씬 자연스러운 결과를 냄.
Uber, Lyft 같은 차량 공유 서비스에서 수요 밀집 지역 파악에 실제로 사용해요!
2. 이상 탐지 (Anomaly Detection)
네트워크 트래픽 데이터에서 정상 패턴 클러스터를 찾고, 노이즈로 분류된 포인트를 이상 트래픽으로 탐지.
사이버 보안, 금융 사기 탐지에 활용돼요.
3. 천문학 데이터
별의 분포, 은하 클러스터 탐지에 DBSCAN이 사용돼요.
우주 데이터는 형태가 매우 불규칙하고 노이즈(배경 별)가 많아서 DBSCAN이 딱!
4. 생물정보학
유전자 발현 데이터, 단백질 구조 분석에서 불규칙한 형태의 클러스터를 찾을 때 사용.
재능넷(https://www.jaenung.net)에서 데이터 사이언스 전문가의 도움을 받아보는 것도 좋은 방법이에요!
실제 데이터에 맞는 알고리즘 선택부터 파라미터 튜닝까지 전문가와 함께하면 훨씬 효율적이에요 😊
속도가 훨씬 빠르고 메모리 효율적! 대용량 데이터에 추천.
정확도는 약간 낮지만 실용적으로 많이 씀.
🔹 K-medoids (PAM)
중심점을 평균값이 아닌 실제 데이터 포인트(medoid)로 설정해요.
이상치에 더 강건(Robust)하고, 유클리드 거리 외 다른 거리 척도도 사용 가능.
단점은 K-means보다 느림 (O(n²)).
🔹 Fuzzy C-means
각 데이터 포인트가 여러 클러스터에 소속 확률을 가지는 소프트 클러스터링.
"이 데이터는 클러스터 A에 70%, 클러스터 B에 30% 속한다" 이런 식!
의료 이미지 분석에서 많이 사용돼요.
계층적 클러스터링과 DBSCAN을 결합해서 다양한 밀도의 클러스터를 찾아낼 수 있어요.
ε 파라미터 없이 MinPts만 설정하면 되니까 훨씬 편함!
현재 실무에서 DBSCAN보다 HDBSCAN을 더 많이 쓰는 추세예요 ㅋㅋ
🔹 OPTICS (Ordering Points To Identify the Clustering Structure)
DBSCAN의 ε 파라미터 민감도 문제를 해결한 알고리즘.
다양한 밀도의 클러스터를 계층적으로 탐지할 수 있어요.
결과를 Reachability Plot으로 시각화해서 클러스터 구조를 직관적으로 파악 가능.
🔹 ST-DBSCAN (Spatio-Temporal DBSCAN)
공간(Spatial) + 시간(Temporal) 차원을 모두 고려한 DBSCAN 확장판.
GPS 궤적 데이터, 소셜 미디어 체크인 데이터 분석에 활용돼요.
# HDBSCAN 사용 예시 (pip install hdbscan 필요)
import hdbscan

clusterer = hdbscan.HDBSCAN(min_cluster_size=5, min_samples=3)
clusterer.fit(X)

labels = clusterer.labels_
probabilities = clusterer.probabilities_  # 각 포인트의 클러스터 소속 확률!

# scikit-learn의 OPTICS
from sklearn.cluster import OPTICS

optics = OPTICS(min_samples=5, xi=0.05, min_cluster_size=0.05)
optics.fit(X)
labels = optics.labels_클러스터링은 비지도 학습이라 정답 라벨이 없는 경우가 많아요.
그래서 성능 평가가 지도 학습보다 훨씬 까다로움 ㅠㅠ
크게 내부 평가 지표와 외부 평가 지표로 나뉘어요.
s(i) = (b(i) - a(i)) / max(a(i), b(i))a(i): 같은 클러스터 내 다른 점들과의 평균 거리 (응집도)
b(i): 가장 가까운 다른 클러스터 점들과의 평균 거리 (분리도)
범위: -1 ~ 1, 높을수록 좋음 (0.7 이상이면 우수)
2. Davies-Bouldin Index (DBI)
클러스터 내 분산과 클러스터 간 거리의 비율.
낮을수록 좋은 클러스터링! (0에 가까울수록 우수)
3. Calinski-Harabasz Index (분산비 기준)
클러스터 간 분산 / 클러스터 내 분산의 비율.
높을수록 좋음! 계산이 빠르고 대용량 데이터에 적합.
범위: -1 ~ 1, 1이 완벽한 일치, 0은 랜덤 수준
2. Normalized Mutual Information (NMI)
실제 라벨과 예측 클러스터 간의 상호 정보량.
범위: 0 ~ 1, 1이 완벽한 일치
3. Fowlkes-Mallows Index (FMI)
정밀도와 재현율의 기하 평균.
범위: 0 ~ 1, 높을수록 좋음
from sklearn.metrics import (
    silhouette_score,
    davies_bouldin_score,
    calinski_harabasz_score,
    adjusted_rand_score,
    normalized_mutual_info_score
)

# 내부 평가 (라벨 없이)
sil = silhouette_score(X, labels)
dbi = davies_bouldin_score(X, labels)
chi = calinski_harabasz_score(X, labels)

print(f"실루엣 계수: {sil:.4f} (높을수록 좋음)")
print(f"Davies-Bouldin: {dbi:.4f} (낮을수록 좋음)")
print(f"Calinski-Harabasz: {chi:.4f} (높을수록 좋음)")

# 외부 평가 (정답 라벨 있을 때)
ari = adjusted_rand_score(true_labels, pred_labels)
nmi = normalized_mutual_info_score(true_labels, pred_labels)
print(f"ARI: {ari:.4f}")
print(f"NMI: {nmi:.4f}")자 이제 진짜 실전에서 어떻게 선택할지 정리해볼게요.
이거 보고 나면 "K-means 쓸까 DBSCAN 쓸까" 고민 끝남 ㅋㅋㅋ 😎
→ NO: DBSCAN 또는 HDBSCAN 고려
🤔 Q2. 데이터에 이상치(Outlier)가 많나요?
→ YES: DBSCAN (노이즈 자동 분리)
→ NO: K-means도 OK
🤔 Q3. 클러스터 형태가 불규칙한가요?
→ YES: DBSCAN (임의 형태 탐지)
→ NO (구형): K-means가 더 빠르고 효율적
🤔 Q4. 데이터 크기가 매우 큰가요? (100만 건 이상)
→ YES: K-means 또는 Mini-Batch K-means
→ NO: 둘 다 가능
🤔 Q5. 고차원 데이터인가요? (차원 수 > 50)
→ YES: 차원 축소(PCA 등) 후 K-means 권장
→ NO: 둘 다 가능
import numpy as np
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.cluster import KMeans, DBSCAN
from sklearn.metrics import silhouette_score

# 1. 데이터 전처리 (스케일링은 필수!)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 2. 고차원이면 PCA로 차원 축소
pca = PCA(n_components=0.95)  # 분산의 95% 보존
X_reduced = pca.fit_transform(X_scaled)

# 3-A. K-means: 엘보우 메서드로 K 결정
inertias = []
sil_scores = []
K_range = range(2, 11)

for k in K_range:
    km = KMeans(n_clusters=k, init='k-means++', n_init=10, random_state=42)
    km.fit(X_reduced)
    inertias.append(km.inertia_)
    sil_scores.append(silhouette_score(X_reduced, km.labels_))

best_k = K_range[np.argmax(sil_scores)]
print(f"최적 K: {best_k}, 실루엣 계수: {max(sil_scores):.4f}")

# 3-B. DBSCAN: k-distance 그래프로 ε 결정
from sklearn.neighbors import NearestNeighbors

k = 5  # MinPts - 1
nbrs = NearestNeighbors(n_neighbors=k).fit(X_reduced)
distances, _ = nbrs.kneighbors(X_reduced)
distances = np.sort(distances[:, k-1], axis=0)
# distances를 플롯해서 꺾이는 지점 찾기 → ε 결정

dbscan = DBSCAN(eps=0.5, min_samples=5)
db_labels = dbscan.fit_predict(X_reduced)
n_clusters = len(set(db_labels)) - (1 if -1 in db_labels else 0)
n_noise = list(db_labels).count(-1)
print(f"DBSCAN 클러스터 수: {n_clusters}, 노이즈: {n_noise}개")반드시
StandardScaler 또는 MinMaxScaler로 정규화 후 사용하세요.정규화 안 하면 단위가 큰 특성이 클러스터링을 지배해버려서 완전 엉망이 됨 ㅠㅠ
클러스터링 알고리즘을 공부하다 보면 반드시 마주치는 개념이에요.
특히 DBSCAN에서 고차원 데이터 처리가 어려운 이유가 바로 이거예요!
같은 양의 데이터라도 점점 더 희소(Sparse)해지는 현상이에요.
구체적 예시:
1D 공간에서 [0,1] 구간에 100개 점 → 평균 간격 0.01
2D 공간에서 [0,1]² 에 100개 점 → 평균 간격 0.1
10D 공간에서 [0,1]¹⁰에 100개 점 → 평균 간격 0.63 (!!)
고차원에서는 모든 점들이 서로 비슷한 거리에 있게 되어서
"가깝다/멀다"의 구분이 의미 없어져요.
DBSCAN의 ε-이웃 개념이 무너지는 거죠!
해결책:
✔ PCA, t-SNE, UMAP 등으로 차원 축소 후 클러스터링
✔ 특성 선택(Feature Selection)으로 중요한 특성만 사용
✔ 코사인 유사도 등 고차원에 적합한 거리 척도 사용
클러스터링 분야도 딥러닝의 영향을 받아서 엄청나게 발전하고 있어요!
재능넷에서 데이터 사이언스 관련 재능을 찾아보면 이런 최신 기술을 다루는 전문가들도 많이 있더라고요 😊
DEC(Deep Embedded Clustering), IDEC 등이 대표적이에요.
이미지, 텍스트 등 비정형 데이터 클러스터링에 강력함!
🔹 그래프 클러스터링 (Graph Clustering)
데이터를 그래프로 표현하고 커뮤니티 탐지 알고리즘으로 클러스터링.
소셜 네트워크 분석, 지식 그래프에 활용.
GNN(Graph Neural Network) 기반 클러스터링도 활발히 연구 중!
🔹 대조 학습 기반 클러스터링 (Contrastive Clustering)
자기지도 학습(Self-supervised Learning)의 대조 학습을 클러스터링에 적용.
라벨 없이도 강력한 표현 학습이 가능해서 주목받고 있어요.
🔹 UMAP + HDBSCAN 파이프라인
현재 실무에서 가장 핫한 조합! 🔥
UMAP으로 고차원 데이터를 2~3차원으로 압축 → HDBSCAN으로 클러스터링
BERTopic(토픽 모델링), scRNA-seq(단세포 RNA 분석) 등에서 표준 파이프라인으로 자리잡음.
# UMAP + HDBSCAN 파이프라인 (현재 가장 핫한 조합!)
# pip install umap-learn hdbscan

import umap
import hdbscan

# 1. UMAP으로 차원 축소
reducer = umap.UMAP(n_components=2, n_neighbors=15, min_dist=0.1, random_state=42)
embedding = reducer.fit_transform(X_scaled)

# 2. HDBSCAN으로 클러스터링
clusterer = hdbscan.HDBSCAN(
    min_cluster_size=15,
    min_samples=5,
    cluster_selection_epsilon=0.5,
    prediction_data=True
)
clusterer.fit(embedding)

labels = clusterer.labels_
soft_clusters = hdbscan.all_points_membership_vectors(clusterer)
# soft_clusters: 각 포인트의 클러스터 소속 확률 벡터!- ✔ 중심점(Centroid) 기반 클러스터링
- ✔ K값 사전 지정 필수 (엘보우 메서드, 실루엣 계수로 결정)
- ✔ 구형 클러스터에 최적화, 이상치에 취약
- ✔ 빠른 속도 O(n·K·I·d), 대용량 데이터 OK
- ✔ 목적함수: WCSS 최소화
- ✔ 추천 사용처: 고객 세분화, 이미지 압축, 문서 분류
- ✔ 개선 버전: K-means++, Mini-Batch K-means
- ✔ 밀도(Density) 기반 클러스터링
- ✔ K값 불필요, ε과 MinPts만 설정
- ✔ 임의 형태 클러스터 탐지 가능
- ✔ 노이즈/이상치 자동 분리 (라벨 = -1)
- ✔ 세 가지 포인트: 핵심 / 경계 / 노이즈
- ✔ 추천 사용처: 지리 데이터, 이상 탐지, 불규칙 형태 데이터
- ✔ 개선 버전: HDBSCAN, OPTICS
데이터의 특성을 먼저 파악하고, 그에 맞는 알고리즘을 선택하는 게 핵심이에요.
"데이터가 구형으로 잘 분리되고 K를 알면 → K-means"
"형태가 불규칙하고 이상치가 많으면 → DBSCAN/HDBSCAN"
그리고 요즘 실무에서는 UMAP + HDBSCAN 조합이 대세라는 것도 기억해두세요! 🔥
어떤 알고리즘이든 데이터 전처리(스케일링)는 필수 중의 필수임 ㅋㅋㅋ

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.