

Ver3.0 실험 설계와 통제변수 관리를 통한 인과관계 분석
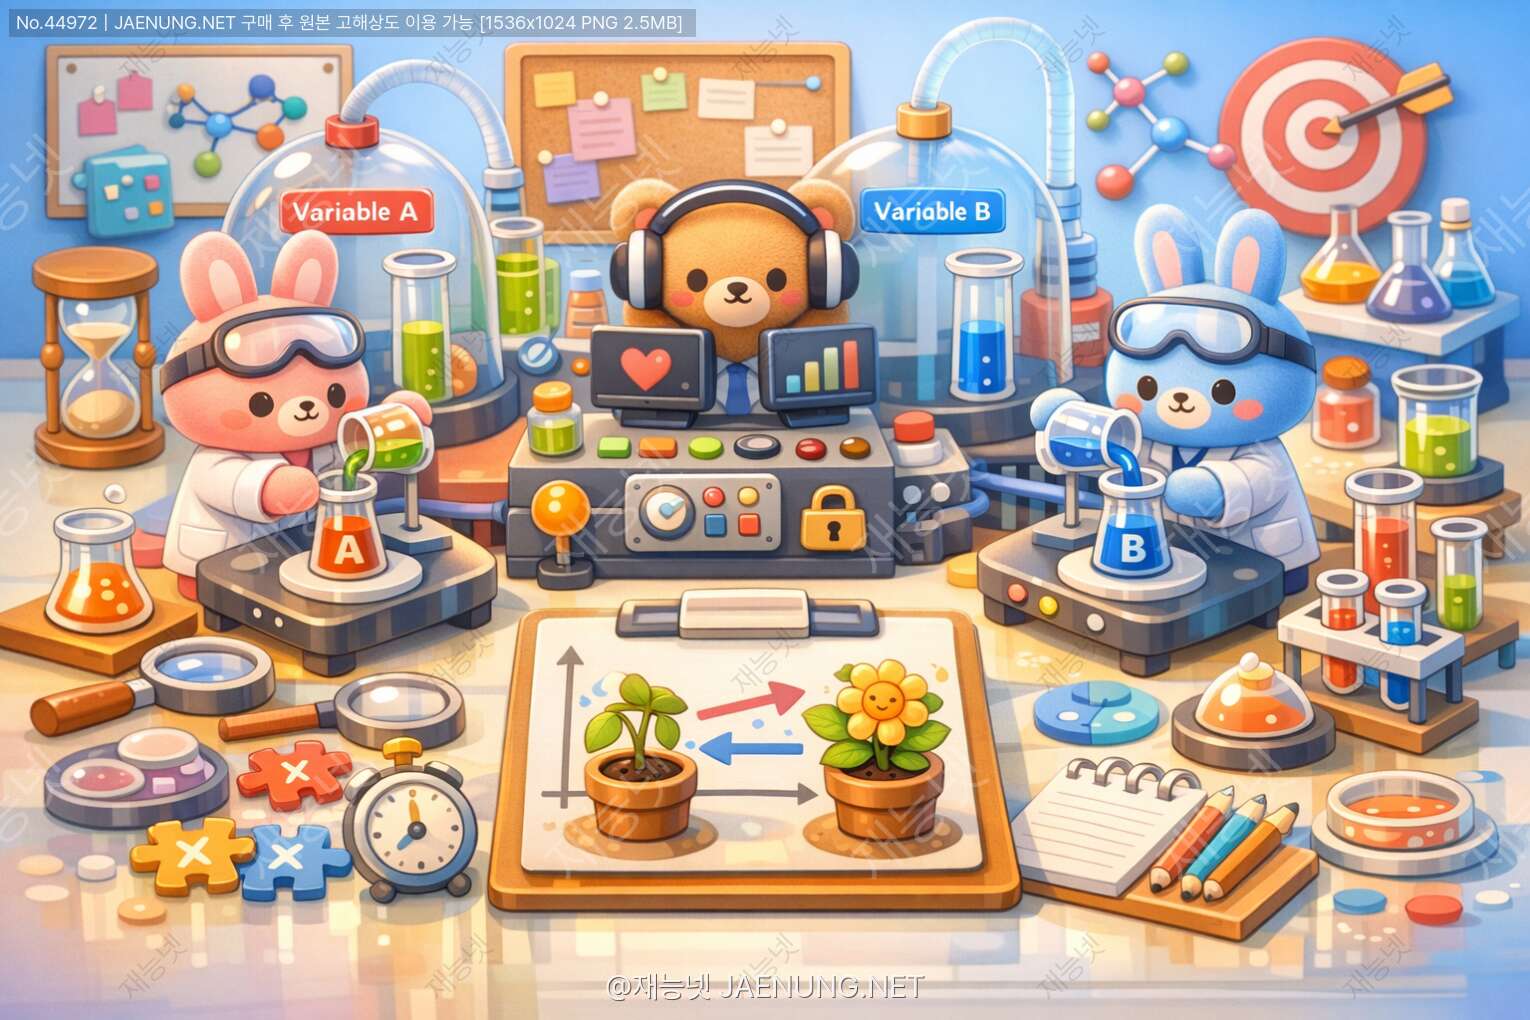
실험 설계와 통제변수 관리를 통한 인과관계 분석
데이터 분석의 핵심, 진짜 원인을 찾아내는 과학적 방법론 🔬✨
요즘 데이터 분석이 대세잖아요? 근데 솔직히 말해서 데이터만 많이 모으면 뭐하나요 ㅋㅋㅋ 진짜 중요한 건 그 데이터에서 인과관계를 제대로 찾아내는 거거든요! 😎
예를 들어볼게요. "아이스크림 판매량이 늘어나면 익사 사고가 증가한다"는 데이터가 있다고 쳐봅시다. 그럼 아이스크림이 익사를 유발하나요? 당연히 아니죠 ㅋㅋㅋ 둘 다 여름이라는 제3의 변수 때문에 동시에 증가하는 거예요. 이게 바로 상관관계와 인과관계의 차이입니다! 🍦🏊♂️
오늘은 이런 함정에 빠지지 않고, 진짜 원인과 결과를 찾아내는 실험 설계와 통제변수 관리에 대해 깊이 파헤쳐볼게요. 재능넷에서 데이터 분석 재능을 공유하시는 분들이나, 통계 분석을 배우고 싶은 분들에게 완전 꿀팁이 될 거예요! 💪
🎯 인과관계 분석이 뭐길래 이렇게 중요한가요?
인과관계 분석은 단순히 "A와 B가 함께 움직인다"는 걸 넘어서, "A가 B를 일으킨다"는 걸 증명하는 과정이에요. 이게 왜 중요하냐고요? 🤔
비즈니스 세계에서 생각해보면 완전 명확해져요. 마케팅 캠페인을 진행했더니 매출이 올랐다고 칩시다. 근데 그게 정말 캠페인 때문일까요? 아니면 그냥 시즌 효과? 경쟁사가 망해서? 날씨가 좋아서? ㅋㅋㅋ 진짜 원인을 모르면 다음에 뭘 해야 할지 알 수가 없잖아요! 💸
💡 핵심 포인트: 상관관계는 "함께 움직임"을 의미하지만, 인과관계는 "하나가 다른 하나를 일으킴"을 의미합니다. 의사결정을 위해서는 반드시 인과관계를 파악해야 해요!
📊 상관관계 vs 인과관계 - 제대로 구분하기
많은 사람들이 이 둘을 헷갈려하는데요, 완전 다른 개념이에요! 실제 사례로 비교해볼게요:
상관관계의 예시:
• 키가 큰 사람일수록 신발 사이즈가 크다 → 둘 다 유전적 요인의 결과
• 커피 소비량과 논문 생산성이 비례한다 → 둘 다 학업 강도의 결과일 수 있음
• 소방차 출동 횟수와 화재 피해액이 비례한다 → 화재 규모라는 공통 원인
인과관계의 예시:
• 백신 접종이 질병 발생률을 낮춘다 → 직접적 인과관계
• 가격 인상이 수요를 감소시킨다 → 경제학적 인과관계
• 운동이 심혈관 건강을 개선한다 → 생리학적 인과관계
🎓 전문가 팁: 인과관계를 주장하려면 세 가지 조건이 필요해요!
1️⃣ 시간적 선후관계: 원인이 결과보다 먼저 발생
2️⃣ 공변성: 원인이 변하면 결과도 변함
3️⃣ 비허위성: 제3의 변수로 설명되지 않음
🔬 실험 설계의 기본 원리
자, 이제 본격적으로 실험 설계에 대해 알아볼까요? 실험 설계는 인과관계를 밝히기 위한 가장 강력한 도구예요. 근데 아무렇게나 실험하면 안 되고, 과학적인 원칙을 따라야 해요! 🧪
🎲 무작위 배정(Randomization)의 마법
무작위 배정은 실험 설계의 골든 스탠다드예요! 왜냐고요? 참가자들을 무작위로 실험군과 대조군에 배정하면, 우리가 모르는 모든 변수들이 두 그룹에 균등하게 분포되거든요. 완전 신기하죠? ㅋㅋㅋ
예를 들어볼게요. 새로운 학습 앱의 효과를 테스트한다고 칩시다:
❌ 잘못된 방법:
"앱을 쓰고 싶은 사람들은 실험군, 안 쓰고 싶은 사람들은 대조군"
→ 이러면 원래 학습 동기가 높은 사람들이 실험군에 몰려요! 결과가 왜곡되죠.
✅ 올바른 방법:
동전 던지기나 난수표를 사용해서 완전히 무작위로 배정
→ 학습 동기, 기존 실력, 나이, 성별 등 모든 요인이 두 그룹에 비슷하게 분포돼요!
💻 실무 적용 팁: 온라인 A/B 테스트를 할 때도 무작위 배정이 핵심이에요! 사용자 ID의 해시값을 이용하거나, 세션 기반 무작위 배정을 사용하면 됩니다. 재능넷 같은 플랫폼에서 새 기능을 테스트할 때도 이 방법을 쓰면 정확한 효과를 측정할 수 있어요! 🚀
🎭 실험군과 대조군 설정하기
실험군(Treatment Group)과 대조군(Control Group)의 개념은 완전 직관적이에요:
실험군: 우리가 테스트하고 싶은 처치(treatment)를 받는 그룹
대조군: 처치를 받지 않거나, 기존 방식을 유지하는 그룹
근데 여기서 중요한 게 있어요! 대조군도 "뭔가 받는다"는 느낌을 줘야 할 때가 있어요. 이게 바로 플라시보 효과를 통제하는 방법이죠! 💊
| 실험 유형 | 실험군 | 대조군 | 목적 |
|---|---|---|---|
| 신약 임상시험 | 실제 약물 투여 | 플라시보(가짜약) 투여 | 심리적 효과 제거 |
| 교육 프로그램 | 새로운 교수법 적용 | 기존 교수법 유지 | 순수 효과 측정 |
| 웹사이트 디자인 | 새 디자인 노출 | 기존 디자인 유지 | 전환율 비교 |
| 마케팅 캠페인 | 캠페인 노출 | 캠페인 미노출 | ROI 측정 |
🔍 맹검법(Blinding) - 편향을 막는 비밀 무기
맹검법은 진짜 꿀팁이에요! 실험 참가자나 연구자가 누가 실험군이고 대조군인지 모르게 하는 거죠. 왜 이게 중요하냐고요? 🤷♂️
단일 맹검(Single-blind):
참가자만 자신이 어느 그룹인지 몰라요. 연구자는 알고 있고요.
→ 참가자의 기대 효과는 제거되지만, 연구자의 편향은 남아있을 수 있어요.
이중 맹검(Double-blind):
참가자도 모르고, 직접 실험을 진행하는 연구자도 몰라요! 완전 최강이죠 ㅋㅋㅋ
→ 모든 종류의 편향을 최소화할 수 있어요. 의학 연구에서 표준으로 사용돼요.
삼중 맹검(Triple-blind):
참가자, 연구자, 데이터 분석가까지 모두 몰라요!
→ 분석 단계에서의 편향까지 제거. 진짜 완벽주의자들의 선택! 😎
⚠️ 주의사항: 맹검법이 항상 가능한 건 아니에요! 예를 들어 운동 프로그램의 효과를 테스트한다면, 참가자가 자신이 운동하는지 안 하는지 당연히 알 수밖에 없죠 ㅋㅋㅋ 이럴 때는 다른 통제 방법을 함께 사용해야 해요!
🎛️ 통제변수 관리 - 진짜 고수의 영역
자, 이제 진짜 핵심 중의 핵심! 통제변수 관리에 대해 알아볼게요. 솔직히 이거 제대로 하는 사람이 진짜 데이터 분석 고수예요! 🏆
통제변수(Control Variable)는 독립변수도 아니고 종속변수도 아닌데, 결과에 영향을 줄 수 있는 모든 변수들을 말해요. 이것들을 제대로 관리하지 않으면, 우리가 찾은 인과관계가 가짜일 수 있어요! 😱
🎯 통제변수 식별하기
먼저 어떤 변수들을 통제해야 하는지 찾아야겠죠? 이게 생각보다 어려워요. 체계적으로 접근해봅시다:
1. 이론적 접근:
기존 연구나 이론을 바탕으로 영향을 줄 수 있는 변수들을 리스트업해요.
예: 학습 효과 연구 → 기존 학업 성취도, 학습 동기, 가정환경, 교사 질 등
2. 경험적 접근:
파일럿 스터디나 탐색적 데이터 분석을 통해 실제로 상관관계가 있는 변수들을 찾아요.
예: 상관분석, 회귀분석 등을 통한 변수 선택
3. 전문가 자문:
해당 분야 전문가들의 의견을 듣는 거죠. 재능넷에서 통계 전문가를 찾아 자문을 구하는 것도 좋은 방법이에요! 👨🏫
🛠️ 통제변수 관리 기법들
통제변수를 식별했다면, 이제 어떻게 관리할지 결정해야 해요. 여러 가지 방법이 있는데, 상황에 따라 적절한 방법을 선택하면 돼요! 💡
1️⃣ 물리적 통제 (Physical Control)
가장 직접적인 방법이에요. 변수를 아예 일정하게 고정시켜버리는 거죠!
예시:
• 실험실 온도를 항상 22°C로 유지
• 모든 참가자에게 동일한 시간대에 테스트 진행
• 같은 장비, 같은 재료 사용
장점: 완벽하게 통제 가능, 결과 해석이 명확
단점: 현실성이 떨어질 수 있음, 일반화 가능성 제한 ㅠㅠ
2️⃣ 통계적 통제 (Statistical Control)
이건 진짜 많이 쓰이는 방법이에요! 데이터 분석 단계에서 통제변수의 영향을 수학적으로 제거하는 거죠. 완전 스마트하죠? 🧠
주요 기법:
• 공변량 분석(ANCOVA):
통제변수를 공변량으로 설정해서 그 영향을 제거한 후 집단 간 차이를 비교해요.
예: 학습 프로그램 효과를 볼 때, 사전 학업 성취도를 공변량으로 처리
• 다중 회귀분석:
여러 통제변수를 모델에 포함시켜서 독립변수의 순수 효과를 추정해요.
예: 매출 = β₀ + β₁(광고비) + β₂(시즌) + β₃(경쟁사수) + ε
• 성향점수 매칭(Propensity Score Matching):
무작위 배정이 불가능할 때, 통계적으로 비슷한 특성을 가진 개체들을 매칭시켜요.
완전 고급 기법이에요! 😎
📊 실전 코드 예시 (Python):
import statsmodels.api as sm
from statsmodels.formula.api import ols

# ANCOVA 예시
model = ols('성적 ~ 프로그램 + 사전성적 + 학습동기', data=df).fit()
print(model.summary())

# 다중 회귀분석
X = df[['광고비', '시즌더미', '경쟁사수']]
X = sm.add_constant(X)
y = df['매출']
model = sm.OLS(y, X).fit()
print(model.summary())
3️⃣ 매칭 (Matching)
실험군과 대조군을 통제변수 측면에서 최대한 비슷하게 만드는 방법이에요. 쌍둥이를 찾는 것처럼요! 👯♀️
개별 매칭:
실험군의 각 개체마다 통제변수 값이 비슷한 대조군 개체를 찾아서 쌍을 만들어요.
예: 30세 남성 대졸자 → 비슷한 30세 남성 대졸자와 매칭
빈도 매칭:
전체 분포가 비슷하도록 매칭해요. 개별적으로는 안 맞아도 전체적으로는 비슷하게!
예: 실험군에 30대가 40%면, 대조군도 30대를 40%로 맞춤
4️⃣ 블록화 (Blocking)
통제변수를 기준으로 블록을 만들고, 각 블록 내에서 무작위 배정을 하는 방법이에요. 완전 효율적이죠! 🎯
예시:
성별이라는 통제변수가 있다면:
• 남성 블록: 남성들만 모아서 무작위로 실험군/대조군 배정
• 여성 블록: 여성들만 모아서 무작위로 실험군/대조군 배정
이렇게 하면 성별의 영향을 자동으로 통제하면서도 무작위성을 유지할 수 있어요! 완전 꿀팁 ㅋㅋㅋ
🎓 고급 팁: 여러 통제변수가 있을 때는 라틴 스퀘어 디자인(Latin Square Design)이나 그레코-라틴 스퀘어(Greco-Latin Square) 같은 고급 실험 설계를 사용할 수 있어요. 이건 여러 변수를 동시에 효율적으로 통제하는 방법이에요!
📐 실험 설계의 주요 유형들
실험 설계에도 여러 가지 타입이 있어요! 상황과 목적에 따라 적절한 디자인을 선택하는 게 중요하죠. 하나씩 살펴볼까요? 🔍
🎲 완전 무작위 설계 (Completely Randomized Design, CRD)
가장 기본적이고 심플한 디자인이에요. 모든 참가자를 완전히 무작위로 처치 집단에 배정하는 거죠!
특징:
• 가장 간단하고 이해하기 쉬움
• 통계적 분석도 비교적 단순
• 참가자가 동질적일 때 효과적
적용 예시:
새로운 웹사이트 디자인 테스트 - 방문자를 무작위로 A안/B안에 노출
한계:
참가자들의 특성이 다양하면 집단 간 차이가 커질 수 있어요. 그럼 실험 오차가 증가하죠 ㅠㅠ
🧱 무작위 블록 설계 (Randomized Block Design, RBD)
아까 말한 블록화를 적용한 디자인이에요! 중요한 통제변수를 기준으로 블록을 만들고, 각 블록 내에서 무작위 배정을 해요.
특징:
• 블록 내 동질성이 높아서 실험 오차 감소
• 통제변수의 영향을 효과적으로 제거
• CRD보다 통계적 검정력이 높음 💪
적용 예시:
농업 실험 - 토양 비옥도별로 블록을 나누고, 각 블록에서 비료 처치를 무작위 배정
교육 실험 - 학년별로 블록을 나누고, 각 학년에서 교수법을 무작위 배정
분석 방법:
이원 분산분석(Two-way ANOVA)을 사용해요. 처치 효과와 블록 효과를 동시에 분석하죠!
| 설계 유형 | 복잡도 | 통제력 | 적용 상황 |
|---|---|---|---|
| 완전 무작위 설계 | 낮음 ⭐ | 보통 ⭐⭐ | 동질적 집단, 단순 비교 |
| 무작위 블록 설계 | 보통 ⭐⭐ | 높음 ⭐⭐⭐ | 중요한 통제변수 1개 |
| 라틴 스퀘어 설계 | 높음 ⭐⭐⭐ | 매우 높음 ⭐⭐⭐⭐ | 통제변수 2개 |
| 요인 설계 | 매우 높음 ⭐⭐⭐⭐ | 최고 ⭐⭐⭐⭐⭐ | 여러 독립변수의 상호작용 |
🎯 요인 설계 (Factorial Design)
이건 진짜 파워풀한 디자인이에요! 여러 개의 독립변수를 동시에 테스트하고, 그들 간의 상호작용 효과까지 분석할 수 있거든요! 🚀
2×2 요인 설계 예시:
독립변수 A: 광고 유형 (이미지 vs 동영상)
독립변수 B: 메시지 톤 (감성적 vs 이성적)
이렇게 하면 4가지 조합이 나오죠:
1. 이미지 + 감성적
2. 이미지 + 이성적
3. 동영상 + 감성적
4. 동영상 + 이성적
분석할 수 있는 것들:
• 광고 유형의 주효과 (Main Effect)
• 메시지 톤의 주효과
• 광고 유형과 메시지 톤의 상호작용 효과 (Interaction Effect) ← 이게 핵심!
상호작용 효과가 뭐냐고요? 예를 들어 "이미지 광고는 감성적 메시지와 잘 맞지만, 동영상 광고는 이성적 메시지와 더 잘 맞는다" 같은 걸 발견할 수 있어요! 완전 인사이트 폭발이죠 ㅋㅋㅋ 💡
💼 비즈니스 활용: 재능넷 같은 플랫폼에서 마케팅 전략을 최적화할 때 요인 설계가 완전 유용해요! 예를 들어 "할인율 × 배너 위치 × 시간대"를 동시에 테스트해서 최적의 조합을 찾을 수 있죠. 한 번에 여러 변수를 테스트하니까 시간도 절약되고 효율적이에요!
🔄 반복측정 설계 (Repeated Measures Design)
동일한 참가자를 대상으로 여러 번 측정하는 디자인이에요. 각 참가자가 자신의 통제집단이 되는 셈이죠! 완전 효율적이에요 👍
장점:
• 개인차를 완벽하게 통제 (같은 사람이니까!)
• 필요한 참가자 수가 적음 (경제적!)
• 통계적 검정력이 높음
단점:
• 순서 효과(Order Effect): 먼저 받은 처치가 나중 처치에 영향
• 연습 효과(Practice Effect): 반복하면서 익숙해짐
• 피로 효과(Fatigue Effect): 지쳐서 나중 측정이 부정확
해결책:
역균형화(Counterbalancing)를 사용해요! 참가자를 여러 그룹으로 나눠서 처치 순서를 다르게 하는 거죠.
예: 그룹1은 A→B→C 순서, 그룹2는 B→C→A 순서, 그룹3은 C→A→B 순서
🎪 준실험 설계 - 현실의 제약을 극복하기
이상적인 세계에서는 항상 완벽한 무작위 배정이 가능하겠죠? 근데 현실은 그렇지 않아요 ㅠㅠ 윤리적 문제, 실용적 제약, 비용 문제 등으로 무작위 배정이 불가능한 경우가 많거든요. 이럴 때 사용하는 게 준실험 설계(Quasi-Experimental Design)예요! 🎭
📊 비동등 통제집단 설계
무작위 배정 없이 기존에 존재하는 집단들을 사용하는 방법이에요.
예시:
• A학교와 B학교를 비교 (학교를 무작위로 배정할 수는 없으니까!)
• 서울 지역과 부산 지역을 비교
• 기존 고객과 신규 고객을 비교
문제점:
두 집단이 원래부터 다를 수 있어요! 이게 선택 편향(Selection Bias)이죠.
해결 방법:
• 사전 측정을 통해 집단의 동질성 확인
• 통계적 통제 기법 활용 (공변량 분석, 성향점수 매칭 등)
• 차이의 차이(Difference-in-Differences, DID) 분석 사용
⏱️ 시계열 설계 (Time Series Design)
처치 전후로 여러 번 측정해서 변화 패턴을 분석하는 방법이에요. 완전 직관적이죠? 📈
단순 시계열:
O₁ O₂ O₃ O₄ X O₅ O₆ O₇ O₈
(O = 관찰, X = 처치)
처치 전에 4번, 처치 후에 4번 측정해서 변화를 봐요. 만약 처치 후에 갑자기 패턴이 바뀌면 인과관계를 추론할 수 있죠!
장점:
• 역사적 사건의 영향을 어느 정도 통제 가능
• 추세를 파악할 수 있음
• 대조군이 없어도 가능
실제 활용 예시:
• 새로운 정책 시행 전후 범죄율 변화
• 마케팅 캠페인 전후 매출 추이
• 시스템 업데이트 전후 사용자 활동 패턴
📈 DID(차이의 차이) 분석 핵심:
처치집단과 통제집단의 변화량 차이를 비교하는 방법이에요!
DID = (처치집단 사후 - 처치집단 사전) - (통제집단 사후 - 통제집단 사전)
이렇게 하면 시간에 따른 자연스러운 변화를 제거하고, 순수한 처치 효과만 추출할 수 있어요! 경제학에서 완전 많이 쓰는 방법이죠 😎
🔀 회귀 불연속 설계 (Regression Discontinuity Design, RDD)
이건 진짜 똑똑한 방법이에요! 특정 기준점(cutoff)을 중심으로 처치 여부가 결정될 때 사용해요.
예시:
• 시험 점수 70점 이상이면 장학금 지급 → 69점과 71점 학생을 비교
• 소득 일정 수준 이하면 복지 혜택 → 기준선 근처 사람들을 비교
• 나이 만 65세 이상이면 노인 할인 → 64세와 66세를 비교
핵심 아이디어:
기준점 바로 위와 바로 아래는 거의 비슷한 사람들이잖아요? 69점과 71점 학생이 본질적으로 다를 이유가 없죠! 그래서 이들을 비교하면 인과관계를 추론할 수 있어요! 완전 천재적이죠 ㅋㅋㅋ 🧠
⚠️ 내적 타당도와 외적 타당도
실험 설계에서 완전 중요한 개념 두 가지! 내적 타당도(Internal Validity)와 외적 타당도(External Validity)예요. 이 둘의 균형을 맞추는 게 진짜 어려운 일이죠 😅
🎯 내적 타당도 - 인과관계의 확실성
"우리가 관찰한 효과가 정말로 독립변수 때문인가?"를 묻는 거예요. 내적 타당도가 높다는 건 다른 설명 가능성을 모두 배제했다는 뜻이죠!
내적 타당도를 위협하는 요인들:
1️⃣ 역사(History)
실험 중에 예상치 못한 사건이 발생하는 경우예요.
예: 교육 프로그램 효과를 측정하는데, 중간에 코로나19 팬데믹이 터짐 ㅠㅠ
대응: 통제집단 사용, 짧은 실험 기간 설정
2️⃣ 성숙(Maturation)
참가자들이 시간이 지나면서 자연스럽게 변하는 거예요.
예: 아이들 대상 실험 → 시간이 지나면 당연히 성장하고 발달함
대응: 통제집단과 비교, 짧은 실험 기간
3️⃣ 검사(Testing)
사전 검사 자체가 사후 검사에 영향을 주는 경우예요.
예: 같은 시험을 두 번 보면 두 번째는 당연히 더 잘 봄 ㅋㅋㅋ
대응: 솔로몬 4집단 설계 사용, 다른 형태의 검사 도구 사용
4️⃣ 도구(Instrumentation)
측정 도구나 관찰자가 변하는 경우예요.
예: 평가자가 피곤해져서 나중에는 대충 평가함
대응: 표준화된 측정 도구, 평가자 훈련, 맹검법
5️⃣ 통계적 회귀(Statistical Regression)
극단적인 점수는 다음 측정에서 평균으로 회귀하는 경향이 있어요.
예: 성적이 매우 낮은 학생들만 선발 → 다음 시험에서는 자연스럽게 좀 올라감
대응: 무작위 배정, 통제집단 사용
6️⃣ 선택(Selection)
집단 구성이 원래부터 다른 경우예요.
예: 자원자만 실험군에 배정 → 동기가 높은 사람들만 모임
대응: 무작위 배정! 이게 최고예요 💯
7️⃣ 탈락(Attrition/Mortality)
참가자들이 중도에 빠져나가는 경우예요. 특히 특정 유형의 사람들이 더 많이 탈락하면 문제죠!
예: 힘든 운동 프로그램 → 체력이 약한 사람들이 먼저 포기
대응: 탈락률 최소화 노력, ITT(Intention-to-Treat) 분석
⚠️ 중요: 이런 위협 요인들은 혼자 오는 게 아니라 여러 개가 동시에 작용할 수 있어요! 그래서 실험 설계 단계에서 미리미리 대비해야 해요. 사후약방문은 소용없어요 ㅠㅠ
🌍 외적 타당도 - 일반화 가능성
"우리 실험 결과를 다른 상황, 다른 사람, 다른 시간에도 적용할 수 있나?"를 묻는 거예요. 실험실에서만 작동하는 결과는 의미가 없잖아요? 🤷♀️
외적 타당도를 위협하는 요인들:
1️⃣ 표본의 대표성
대학생만 대상으로 한 연구 결과를 전체 인구에 일반화할 수 있을까요? 글쎄요 ㅋㅋㅋ
해결: 다양한 표본 사용, 층화 표집, 가중치 적용
2️⃣ 인위적인 실험 환경
실험실은 현실과 달라요! 통제된 환경에서의 결과가 실제 세계에서도 나타날까요?
해결: 현장 실험(Field Experiment), 자연스러운 환경 조성
3️⃣ 호손 효과(Hawthorne Effect)
"내가 관찰받고 있다"는 사실 자체가 행동을 변화시켜요!
예: 생산성 연구 → 조명을 밝게 해도 어둡게 해도 생산성이 올라감 ㅋㅋㅋ 왜? 관심받아서!
해결: 자연스러운 관찰, 참가자가 관찰받는 줄 모르게 하기
4️⃣ 처치의 다중성
실험에서는 하나의 처치만 받지만, 현실에서는 여러 요인이 동시에 작용해요.
해결: 요인 설계 사용, 복합적인 처치 테스트
🎭 내적 vs 외적 타당도의 트레이드오프:
안타깝게도 이 둘은 종종 상충관계에 있어요! 내적 타당도를 높이려고 통제를 강화하면 인위적이 되어서 외적 타당도가 떨어지고, 외적 타당도를 높이려고 현실적으로 만들면 통제가 어려워져서 내적 타당도가 떨어져요 😭
해결책: 여러 연구를 조합하는 거예요! 내적 타당도가 높은 실험실 연구와 외적 타당도가 높은 현장 연구를 함께 수행하면 완벽하죠! 💪
📊 표본 크기 결정 - 얼마나 많은 데이터가 필요한가?
"몇 명을 대상으로 실험해야 하나요?" 이거 진짜 많이 받는 질문이에요! 너무 적으면 효과를 못 찾고, 너무 많으면 시간과 비용 낭비죠. 적절한 표본 크기를 결정하는 건 과학이자 예술이에요! 🎨
🔢 통계적 검정력(Statistical Power) 이해하기
표본 크기를 결정하려면 먼저 통계적 검정력을 이해해야 해요. 이건 "실제로 효과가 있을 때, 그걸 제대로 찾아낼 확률"이에요!
4가지 가능한 상황:
1️⃣ 올바른 긍정(True Positive): 효과가 있고, 우리가 찾아냄 ✅
2️⃣ 올바른 부정(True Negative): 효과가 없고, 우리가 없다고 결론 ✅
3️⃣ 제1종 오류(Type I Error, α): 효과가 없는데, 있다고 잘못 판단 ❌
4️⃣ 제2종 오류(Type II Error, β): 효과가 있는데, 못 찾음 ❌
검정력 = 1 - β
보통 0.8 (80%) 이상을 목표로 해요!
🎯 표본 크기에 영향을 주는 4가지 요인:
1️⃣ 효과 크기(Effect Size): 찾고자 하는 효과가 클수록 적은 표본으로도 가능
2️⃣ 유의수준(α): 보통 0.05 사용. 더 엄격하게 하면 표본이 더 필요
3️⃣ 검정력(1-β): 높은 검정력을 원하면 더 많은 표본 필요
4️⃣ 변동성(Variability): 데이터의 분산이 클수록 더 많은 표본 필요
💻 표본 크기 계산 실전
이론은 알겠고, 실제로 어떻게 계산하냐고요? 여러 방법이 있어요!
방법 1: 공식 사용
두 집단 평균 비교의 경우:
n = 2 × (Zα + Zβ)² × σ² / δ²

여기서:
n = 각 집단의 표본 크기
Zα = 유의수준에 해당하는 Z값 (α=0.05면 1.96)
Zβ = 검정력에 해당하는 Z값 (검정력 0.8이면 0.84)
σ = 표준편차
δ = 탐지하고 싶은 최소 차이
방법 2: 통계 소프트웨어 사용
솔직히 손으로 계산하는 사람은 거의 없어요 ㅋㅋㅋ 소프트웨어를 쓰죠!
# Python 예시
from statsmodels.stats.power import TTestIndPower

analysis = TTestIndPower()
sample_size = analysis.solve_power(
    effect_size=0.5,  # Cohen's d
    alpha=0.05,
    power=0.8,
    alternative='two-sided'
)
print(f"필요한 표본 크기: {sample_size:.0f}명")

# R 예시
library(pwr)
pwr.t.test(d=0.5, sig.level=0.05, power=0.8, type="two.sample")
📏 효과 크기(Effect Size) 이해하기
효과 크기는 "얼마나 큰 차이를 찾고 싶은가"를 나타내요. 통계적 유의성과는 다른 개념이에요!
Cohen's d (평균 차이용):
• 작은 효과: d = 0.2
• 중간 효과: d = 0.5
• 큰 효과: d = 0.8
예시로 이해하기:
새로운 학습법으로 평균 점수가 70점에서 75점으로 올랐다고 칩시다. 표준편차가 10점이면:
d = (75 - 70) / 10 = 0.5 (중간 효과)
만약 표준편차가 5점이면:
d = (75 - 70) / 5 = 1.0 (큰 효과!)
같은 5점 차이라도 변동성에 따라 효과 크기가 달라지는 거죠! 🎯
| 효과 크기 | Cohen's d | 필요 표본 (각 집단) | 실제 의미 |
|---|---|---|---|
| 매우 작음 | 0.2 | ~393명 | 거의 차이 없음 |
| 작음 | 0.3 | ~175명 | 미묘한 차이 |
| 중간 | 0.5 | ~64명 | 눈에 띄는 차이 |
| 큼 | 0.8 | ~26명 | 명확한 차이 |
| 매우 큼 | 1.2 | ~12명 | 극적인 차이 |
💡 실무 팁: 파일럿 스터디를 먼저 해보세요! 소규모로 예비 실험을 하면 효과 크기와 변동성을 추정할 수 있어요. 그럼 본 실험의 표본 크기를 더 정확하게 계산할 수 있죠! 재능넷에서 통계 컨설팅 전문가를 찾아 도움받는 것도 좋은 방법이에요! 👨🔬
🎨 실험 설계 실전 사례 연구
이론만 배우면 재미없죠? 실제 사례를 통해 어떻게 적용되는지 봅시다! 다양한 분야의 예시를 준비했어요 🚀
🛒 사례 1: 이커머스 A/B 테스트
상황: 온라인 쇼핑몰에서 "장바구니에 담기" 버튼의 색상이 구매 전환율에 영향을 주는지 테스트
실험 설계:
• 독립변수: 버튼 색상 (파란색 vs 주황색)
• 종속변수: 구매 전환율 (%)
• 통제변수: 시간대, 요일, 상품 카테고리, 사용자 디바이스, 트래픽 소스
• 설계 유형: 완전 무작위 설계
• 표본: 각 그룹 10,000명 (검정력 분석 결과)
통제변수 관리:
• 무작위 배정: 사용자 ID의 해시값 기반
• 시간 통제: 동일 기간에 동시 진행
• 세션 고정: 한 사용자는 계속 같은 버전 노출
• AA 테스트 선행: 시스템이 제대로 작동하는지 확인
결과:
주황색 버튼이 파란색보다 전환율 12% 향상! (p < 0.001)
효과 크기: 0.23 (작은 효과지만 비즈니스적으로는 큰 의미!)
추가 분석:
세그먼트별로 나눠봤더니:
• 모바일: 주황색이 15% 더 좋음
• 데스크톱: 차이 없음
→ 모바일에서만 주황색 버튼 적용 결정! 💰
🏥 사례 2: 신약 임상시험
상황: 새로운 고혈압 치료제의 효과와 안전성 검증
실험 설계:
• 독립변수: 약물 투여 (신약 vs 플라시보 vs 기존약)
• 종속변수: 수축기 혈압 감소량, 부작용 발생률
• 통제변수: 연령, 성별, 초기 혈압, BMI, 흡연 여부, 기저질환
• 설계 유형: 무작위 블록 설계 (연령대별 블록화) + 이중 맹검
• 표본: 각 그룹 150명 (총 450명)
통제변수 관리:
• 블록화: 40세 미만 / 40-60세 / 60세 이상으로 나눔
• 각 블록 내에서 무작위 배정
• 이중 맹검: 환자도 의사도 누가 어떤 약을 받는지 모름
• 플라시보 사용: 심리적 효과 제거
• 표준화된 측정: 같은 시간, 같은 방법으로 혈압 측정
• 순응도 모니터링: 약을 제대로 복용하는지 확인
통계 분석:
• 일차 분석: ANCOVA (초기 혈압을 공변량으로)
• 이차 분석: 연령대별 하위집단 분석
• 안전성 분석: 카이제곱 검정 (부작용 발생률)
결과:
신약이 플라시보보다 평균 15mmHg 더 낮춤 (p < 0.001)
기존약과는 비슷한 효과, 하지만 부작용은 30% 적음!
→ FDA 승인 신청 진행 🎉
📱 사례 3: 모바일 앱 푸시 알림 최적화
상황: 푸시 알림의 메시지 유형과 발송 시간이 앱 재방문율에 미치는 영향
실험 설계:
• 독립변수 1: 메시지 유형 (개인화 vs 일반)
• 독립변수 2: 발송 시간 (오전 9시 vs 오후 6시)
• 종속변수: 24시간 내 앱 재방문율
• 통제변수: 사용자 활동 수준, 가입 기간, 연령대, OS 버전
• 설계 유형: 2×2 요인 설계
• 표본: 각 조건당 5,000명 (총 20,000명)
4가지 실험 조건:
1. 개인화 메시지 + 오전 9시
2. 개인화 메시지 + 오후 6시
3. 일반 메시지 + 오전 9시
4. 일반 메시지 + 오후 6시
통제변수 관리:
• 층화 무작위 배정: 활동 수준별로 층화 후 무작위 배정
• 동일 기간 진행: 모든 조건을 같은 주에 테스트
• 제외 기준: 최근 7일간 푸시 받은 사용자 제외
• 통계적 통제: 로지스틱 회귀분석에 통제변수 포함
결과 (재방문율):
• 개인화 + 오전: 28%
• 개인화 + 오후: 35% ⭐ (최고!)
• 일반 + 오전: 18%
• 일반 + 오후: 22%
상호작용 효과 발견!
개인화 메시지는 오후에 보낼 때 효과가 극대화됨!
일반 메시지는 시간대 영향을 덜 받음.
→ 개인화 메시지를 오후 6시에 발송하는 전략 채택! 📲
🎓 사례 4: 교육 프로그램 효과 검증
상황: 새로운 온라인 수학 학습 프로그램이 학업 성취도를 향상시키는지 검증
실험 설계:
• 독립변수: 학습 프로그램 (새 프로그램 vs 기존 방식)
• 종속변수: 수학 성적 (100점 만점)
• 통제변수: 사전 성적, 학습 동기, 가정 소득 수준, 부모 학력
• 설계 유형: 무작위 블록 설계 (학교별 블록화) + 사전-사후 측정
• 표본: 10개 학교, 각 학교당 실험군 30명, 대조군 30명 (총 600명)
통제변수 관리:
• 학교별 블록화: 학교 간 차이 통제
• 각 학교 내에서 무작위 배정
• 사전 성적 측정: ANCOVA에서 공변량으로 사용
• 학습 시간 통제: 두 집단 모두 주당 5시간 학습
• 교사 효과 통제: 같은 교사가 두 집단 모두 담당
• 학습 동기 측정: 설문조사로 측정 후 통계적 통제
분석 방법:
• 주 분석: 위계적 선형 모델(HLM) - 학생이 학교에 중첩된 구조
• 보조 분석: ANCOVA (사전 성적, 학습 동기를 공변량으로)
• 효과 크기: Cohen's d 계산
결과:
새 프로그램 집단: 평균 75점 → 82점 (7점 향상)
기존 방식 집단: 평균 74점 → 77점 (3점 향상)
순수 프로그램 효과: 4점 (p = 0.003, d = 0.45)
추가 발견:
• 사전 성적이 낮은 학생들에게 효과가 더 큼 (6점 향상)
• 학습 동기가 높은 학생들은 어떤 방식이든 잘함
→ 학습 부진 학생들을 위한 보충 프로그램으로 활용 결정! 📚
🎯 실전 팁 - 실험 설계 체크리스트:
✅ 연구 질문이 명확한가?
✅ 독립변수와 종속변수가 명확히 정의되었는가?
✅ 통제해야 할 변수들을 모두 식별했는가?
✅ 적절한 실험 설계 유형을 선택했는가?
✅ 표본 크기가 충분한가? (검정력 분석 완료)
✅ 무작위 배정이 가능한가? 불가능하다면 대안은?
✅ 맹검법 적용이 가능한가?
✅ 측정 도구가 신뢰롭고 타당한가?
✅ 윤리적 문제는 없는가?
✅ 데이터 분석 계획이 수립되었는가?
이 체크리스트를 실험 전에 꼭 확인하세요! 🎓
🚨 흔한 실수와 함정 피하기
실험 설계와 분석에서 많은 사람들이 빠지는 함정들이 있어요. 이걸 미리 알고 있으면 피할 수 있죠! 하나씩 살펴봅시다 😎
❌ 실수 1: HARKing (Hypothesizing After Results are Known)
결과를 보고 나서 가설을 만드는 거예요. 완전 사기죠! ㅋㅋㅋ
예시:
실험 전: "A가 B보다 좋을 것이다"
결과: A가 더 나쁨
논문에서: "우리는 A가 B보다 나쁠 것이라고 예측했다" ← 거짓말!
왜 문제인가?
• 통계적 추론의 논리를 왜곡
• 재현 가능성 저하
• 과학적 정직성 훼손
해결책:
• 사전 등록(Pre-registration): 실험 전에 가설과 분석 계획을 공개 등록
• 탐색적 분석과 확증적 분석을 명확히 구분
• "예상치 못한 발견"으로 정직하게 보고
❌ 실수 2: p-해킹 (p-hacking)
유의한 결과가 나올 때까지 여러 방법을 시도하는 거예요. 완전 위험해요! 🚫
p-해킹의 다양한 형태:
• 여러 종속변수를 측정하고 유의한 것만 보고
• 데이터를 보면서 표본 크기 결정 ("아, 이제 유의하네!")
• 이상치를 임의로 제거
• 여러 통제변수 조합을 시도
• 하위집단 분석을 무분별하게 수행
왜 문제인가?
• 제1종 오류율이 실제로는 5%가 아니라 훨씬 높아짐
• 거짓 양성 결과 양산
• 재현 위기(Replication Crisis)의 주범
해결책:
• 사전에 분석 계획 수립
• 다중 비교 보정 (Bonferroni, FDR 등)
• 탐색적 분석은 탐색적이라고 명시
• 모든 분석 결과 보고 (유의하지 않은 것도!)
⚠️ 실제 사례: 한 연구에서 20개의 다른 분석을 시도하면, 우연히라도 하나는 p < 0.05가 나올 확률이 64%나 돼요! 이게 p-해킹의 위험성이에요. 그래서 사전 등록이 중요한 거죠!
❌ 실수 3: 표본 크기 무시
"일단 데이터 모으고 보자!" 이러면 안 돼요 ㅋㅋㅋ
너무 작은 표본:
• 검정력 부족 → 진짜 효과를 못 찾음
• 불안정한 추정치
• 재현 불가능
너무 큰 표본:
• 시간과 비용 낭비
• 실용적으로 의미 없는 작은 효과도 유의하게 나옴
• 윤리적 문제 (불필요한 참가자 동원)
해결책:
• 실험 전에 검정력 분석 수행
• 효과 크기를 현실적으로 설정
• 파일럿 스터디로 변동성 추정
❌ 실수 4: 상관관계를 인과관계로 착각
이거 진짜 많이 하는 실수예요! 오늘 글의 핵심 주제이기도 하고요 😅
흔한 착각들:
• "커피를 많이 마시는 사람이 생산성이 높다 → 커피가 생산성을 높인다"
실제로는: 바쁜 사람들이 커피를 많이 마심
• "게임을 많이 하는 아이들이 폭력적이다 → 게임이 폭력성을 유발한다"
실제로는: 원래 폭력적인 성향의 아이들이 폭력적인 게임을 선호
• "유기농 식품을 먹는 사람들이 건강하다 → 유기농이 건강에 좋다"
실제로는: 건강에 관심 많은 사람들이 유기농을 선택
해결책:
• 제3의 변수 고려
• 역인과관계 가능성 검토
• 가능하면 실험 설계 사용
• 불가능하면 준실험 설계나 고급 통계 기법 활용
❌ 실수 5: 통제변수 과다 또는 과소
통제변수를 너무 많이 넣어도, 너무 적게 넣어도 문제예요!
과다 통제의 문제:
• 매개변수를 통제하면 인과관계가 사라짐
• 과적합(Overfitting) 위험
• 해석이 복잡해짐
예시:
"교육이 소득에 미치는 영향"을 연구하는데, "직업"을 통제변수로 넣으면?
→ 교육이 소득에 영향을 주는 경로가 직업을 통해서인데, 그걸 막아버림!
과소 통제의 문제:
• 교란변수의 영향을 받음
• 편향된 추정치
• 허위 인과관계 발견
해결책:
• DAG(Directed Acyclic Graph)를 그려서 인과 구조 파악
• 이론적 근거에 기반한 변수 선택
• 민감도 분석 수행
❌ 실수 6: 다중공선성 무시
통제변수들끼리 너무 상관관계가 높으면 문제가 생겨요!
증상:
• 회귀계수의 표준오차가 비정상적으로 큼
• 계수의 부호가 이론과 반대로 나옴
• 변수를 추가/제거할 때 계수가 크게 변함
진단 방법:
• VIF(Variance Inflation Factor) 계산
• VIF > 10이면 심각한 다중공선성
• 상관행렬 확인
해결책:
• 상관관계가 높은 변수 중 하나 제거
• 주성분 분석(PCA)으로 차원 축소
• Ridge 회귀 같은 정규화 기법 사용
🎓 전문가의 조언: 실수를 완전히 피할 수는 없어요. 중요한 건 실수를 인정하고 투명하게 보고하는 거예요! "이런 한계가 있다", "이 부분은 확실하지 않다"고 솔직하게 말하는 게 오히려 신뢰를 높여요. 완벽한 연구는 없어요! 🙂
🔮 고급 기법과 최신 트렌드
기본을 넘어서 좀 더 고급 기법들을 알아볼까요? 최신 트렌드도 함께 살펴봅시다! 🚀
🎯 인과추론의 최신 접근법
1️⃣ 도구변수(Instrumental Variable, IV) 분석
무작위 배정이 불가능할 때 사용하는 완전 똑똑한 방법이에요!
핵심 아이디어:
독립변수에는 영향을 주지만, 종속변수에는 독립변수를 통해서만 영향을 주는 "도구변수"를 찾는 거예요.
유명한 예시:
"교육이 소득에 미치는 영향" 연구
• 문제: 능력이라는 교란변수 (능력 높으면 교육도 많이 받고 소득도 높음)
• 도구변수: 출생 분기 (의무교육 시작 시점과 관련)
• 논리: 출생 분기는 교육 연수에 영향을 주지만, 능력과는 무관
조건:
• 관련성(Relevance): 도구변수가 독립변수와 상관관계
• 외생성(Exogeneity): 도구변수가 오차항과 무관
• 배제제약(Exclusion Restriction): 도구변수가 종속변수에 직접 영향 없음
완전 까다롭지만, 제대로 하면 강력해요! 💪
2️⃣ 회귀 불연속 설계(RDD)의 확장
아까 소개한 RDD의 고급 버전들이 있어요!
Sharp RDD:
기준점에서 처치 확률이 0에서 1로 완전히 바뀜
예: 시험 70점 이상이면 100% 장학금, 미만이면 0%
Fuzzy RDD:
기준점에서 처치 확률이 변하지만 완전히는 아님
예: 70점 이상이면 장학금 받을 확률이 높지만, 일부는 못 받고 일부는 70점 미만인데도 받음
Multi-cutoff RDD:
여러 개의 기준점이 있는 경우
예: 소득 구간별로 다른 세율 적용
Geographic RDD:
지리적 경계를 기준점으로 사용
예: 주 경계선을 기준으로 정책 효과 비교
3️⃣ 합성 통제법(Synthetic Control Method)
단 하나의 처치 단위만 있을 때 사용하는 방법이에요! 완전 신기하죠? 🤯
상황:
캘리포니아에서만 새로운 정책을 시행. 다른 주들은 시행 안 함.
캘리포니아의 변화가 정책 때문인지 어떻게 알 수 있을까?
해결책:
다른 주들을 적절히 가중평균해서 "합성 캘리포니아"를 만들어요!
정책 시행 전에는 실제 캘리포니아와 비슷하게 움직이도록 가중치를 조정.
정책 시행 후에 실제 캘리포니아와 합성 캘리포니아의 차이를 봐요!
장점:
• 단일 사례 연구 가능
• 투명한 비교 대상 구성
• 시각적으로 직관적
경제학, 정책 평가에서 완전 핫한 방법이에요! 🔥
🤖 머신러닝과 인과추론의 만남
최근에는 머신러닝 기법을 인과추론에 활용하는 연구가 활발해요!
1. Causal Forest (인과 랜덤 포레스트)
개인별로 다른 처치 효과를 추정해요!
"이 사람에게는 효과가 크고, 저 사람에게는 작다"를 알 수 있죠.
→ 개인화된 의사결정 가능! 🎯
2. Double Machine Learning (이중 머신러닝)
머신러닝으로 교란변수를 통제하면서도 인과효과를 편향 없이 추정!
전통적 방법보다 유연하고 강력해요.
3. Causal Discovery (인과 발견)
데이터에서 자동으로 인과 구조를 찾아내는 알고리즘!
아직 발전 중이지만, 미래가 기대되는 분야예요. 🚀
💡 실무 적용: 재능넷 같은 플랫폼에서 개인화 추천을 할 때, Causal Forest를 사용하면 "이 사용자에게는 이 재능이 효과적일 것"을 예측할 수 있어요! 단순 상관관계 기반 추천보다 훨씬 정교하죠. 데이터 과학의 미래는 인과추론과 머신러닝의 결합에 있어요! 🤖
📊 베이지안 접근법
전통적인 빈도주의 통계와는 다른 패러다임이에요!
핵심 차이:
• 빈도주의: "데이터가 주어졌을 때, 가설이 참일 확률"을 계산 못 함
• 베이지안: "데이터가 주어졌을 때, 가설이 참일 확률"을 직접 계산!
장점:
• 사전 지식을 체계적으로 통합
• 불확실성을 확률로 직접 표현
• 작은 표본에서도 안정적
• 순차적 분석 가능
단점:
• 계산이 복잡 (MCMC 등 필요)
• 사전 분포 선택의 주관성
• 해석이 어려울 수 있음
활용 분야:
• A/B 테스트의 베이지안 버전
• 임상시험의 적응적 설계
• 온라인 실험의 실시간 의사결정
🌐 네트워크 실험
소셜 네트워크나 플랫폼에서는 개인들이 독립적이지 않아요! 친구의 처치가 나에게도 영향을 줄 수 있죠. 이게 간섭(Interference)이에요.
문제:
전통적인 실험 설계는 SUTVA(Stable Unit Treatment Value Assumption)를 가정해요.
"한 개체의 처치가 다른 개체에 영향을 주지 않는다"
근데 네트워크에서는 이게 깨져요! 😱
해결책:
• 클러스터 무작위 배정: 네트워크 전체를 단위로
• 이중 무작위 배정: 개인과 네트워크 모두 무작위화
• 네트워크 효과 모델링: 간섭을 명시적으로 모델에 포함
활용:
• 소셜 미디어 실험
• 바이럴 마케팅 효과 측정
• 전염병 확산 연구
💼 실무에서의 적용 - 비즈니스 의사결정
이론은 충분히 배웠으니, 이제 실제 비즈니스에서 어떻게 활용하는지 봅시다! 💼
🎯 A/B 테스트 마스터하기
A/B 테스트는 가장 흔하게 사용되는 실험 방법이에요. 근데 제대로 하는 사람은 의외로 적어요! ㅋㅋㅋ
A/B 테스트 체크리스트:
1️⃣ 실험 전 준비
명확한 가설 설정:
❌ "새 디자인이 더 나을 것이다"
✅ "새 디자인이 클릭률을 10% 이상 향상시킬 것이다"
성공 지표 정의:
• 주 지표(Primary Metric): 가장 중요한 하나
• 보조 지표(Secondary Metrics): 추가로 모니터링할 것들
• 가드레일 지표(Guardrail Metrics): 나빠지면 안 되는 것들
표본 크기 계산:
• 최소 탐지 가능 효과(MDE) 설정
• 검정력 0.8, 유의수준 0.05 기준
• 실험 기간 산정
2️⃣ 실험 중 모니터링
AA 테스트:
실험 시스템이 제대로 작동하는지 확인
두 그룹에 같은 것을 보여줬는데 차이가 나면 문제!
SRM(Sample Ratio Mismatch) 체크:
실험군과 대조군의 비율이 예상과 다르면 문제!
예: 50:50으로 배정했는데 실제로는 48:52
조기 종료 금지:
"오! 유의하네?" 하고 바로 종료하면 안 돼요!
계획한 표본 크기까지 진행해야 해요.
3️⃣ 실험 후 분석
전체 분석:
• 주 지표의 통계적 유의성 검정
• 효과 크기와 신뢰구간 계산
• 보조 지표들 확인
세그먼트 분석:
• 플랫폼별 (모바일 vs 데스크톱)
• 사용자 유형별 (신규 vs 기존)
• 지역별, 시간대별 등
⚠️ 주의: 세그먼트 분석은 탐색적이에요! 다중 비교 문제를 고려해야 해요.
🎓 고급 A/B 테스트 기법:
• Multi-Armed Bandit: 탐색과 활용의 균형. 좋은 옵션에 더 많은 트래픽 할당
• Sequential Testing: 데이터를 보면서 조기 종료 가능하게 설계
• Multi-variate Testing: 여러 요소를 동시에 테스트
• Interleaving: 검색 결과 같은 곳에서 두 알고리즘을 섞어서 보여줌
📈 마케팅 캠페인 효과 측정
마케팅에서 인과관계 분석은 완전 중요해요! ROI를 정확히 측정해야 하니까요. 💰
문제:
광고를 본 사람들이 구매를 많이 했다. 근데 그게 광고 때문일까요?
아니면 원래 살 사람들이 광고를 본 걸까요? (역인과관계)
해결책 1: 무작위 실험
• 지역을 무작위로 나눠서 일부 지역에만 광고
• 사용자를 무작위로 나눠서 일부에게만 광고 노출
• 시간을 무작위로 나눠서 특정 기간에만 광고
해결책 2: 준실험 설계
무작위 배정이 불가능할 때:
• DID: 광고 지역과 비광고 지역의 변화량 차이 비교
• 성향점수 매칭: 광고를 본 사람과 비슷한 특성의 안 본 사람 찾기
• RDD: 광고 타겟팅 기준점 근처 사람들 비교
해결책 3: 인과 모델링
• 구조방정식 모델(SEM)
• 매개 분석: 광고 → 브랜드 인지도 → 구매
• 조절 분석: 광고 효과가 연령대별로 다른지
🏢 조직 내 실험 문화 만들기
실험 설계를 잘 아는 것도 중요하지만, 조직에서 실제로 실행하는 게 더 중요해요!
실험 문화의 핵심 요소:
1. 실패를 학습으로 보기
"이 실험은 실패했다" ❌
"이 아이디어가 효과 없다는 걸 배웠다" ✅
2. 데이터 기반 의사결정
"내 생각엔..." ❌
"데이터에 따르면..." ✅
3. 작게 시작하기
처음부터 완벽한 실험을 하려고 하지 마세요!
작은 실험부터 시작해서 점차 발전시켜요.
4. 실험 인프라 구축
• A/B 테스트 플랫폼
• 데이터 파이프라인
• 대시보드와 모니터링
• 분석 도구와 템플릿
5. 교육과 공유
• 정기적인 워크샵
• 실험 결과 공유 세션
• 베스트 프랙티스 문서화
• 멘토링 프로그램
🌟 성공 사례: 넷플릭스, 구글, 아마존 같은 회사들은 연간 수천 개의 실험을 진행해요! 작은 개선들이 모여서 큰 경쟁 우위가 되는 거죠. 여러분 회사도 실험 문화를 만들어보세요! 재능넷에서 데이터 분석 전문가를 찾아 컨설팅을 받는 것도 좋은 시작이 될 수 있어요! 🚀
🎓 학습 리소스와 다음 단계
여기까지 읽으셨다면 정말 대단해요! 👏 이제 더 깊이 공부하고 싶으신 분들을 위한 리소스를 소개할게요.
📚 추천 도서
입문자용:
• "Naked Statistics" - Charles Wheelan (통계의 직관적 이해)
• "The Book of Why" - Judea Pearl (인과관계의 철학과 과학)
• "Trustworthy Online Controlled Experiments" - Kohavi et al. (A/B 테스트 바이블)
중급자용:
• "Causal Inference: The Mixtape" - Scott Cunningham (경제학적 접근)
• "Design and Analysis of Experiments" - Montgomery (실험 설계 교과서)
• "Statistical Rethinking" - Richard McElreath (베이지안 접근)
고급자용:
• "Mostly Harmless Econometrics" - Angrist & Pischke (계량경제학)
• "Causal Inference in Statistics" - Pearl, Glymour, Jewell (인과추론 이론)
• "Elements of Causal Inference" - Peters et al. (머신러닝과 인과추론)
💻 온라인 강의와 코스
무료 리소스:
• Coursera: "Design and Interpretation of Clinical Trials" (Johns Hopkins)
• edX: "Causal Diagrams" (Harvard)
• YouTube: StatQuest, 3Blue1Brown (시각적 설명)
유료 코스:
• DataCamp: "A/B Testing in Python"
• Udacity: "A/B Testing by Google"
• LinkedIn Learning: "Statistics Foundations" 시리즈
🛠️ 실습 도구와 라이브러리
Python:
• statsmodels: 통계 모델링
• scipy.stats: 통계 검정
• causalml: 인과 머신러닝
• dowhy: 인과추론 프레임워크
• pymc3: 베이지안 분석
R:
• lme4: 혼합효과 모델
• lavaan: 구조방정식 모델
• MatchIt: 매칭 기법
• CausalImpact: 인과 영향 분석
상용 도구:
• Optimizely: A/B 테스트 플랫폼
• Google Optimize: 무료 A/B 테스트
• Mixpanel: 제품 분석
• Amplitude: 행동 분석
🌐 커뮤니티와 네트워킹
온라인 커뮤니티:
• Reddit: r/statistics, r/datascience
• Stack Exchange: Cross Validated
• Twitter: #causalinference, #ABtesting
학회와 컨퍼런스:
• JSM (Joint Statistical Meetings)
• KDD (Knowledge Discovery and Data Mining)
• ICML (International Conference on Machine Learning)
국내 커뮤니티:
• 데이터 사이언스 코리아
• 통계학회
• 각종 밋업과 스터디 그룹
🎯 실전 프로젝트 아이디어:
1. 개인 블로그나 웹사이트에서 A/B 테스트 진행
2. 공개 데이터셋으로 인과추론 연습 (Kaggle 등)
3. 회사에서 작은 실험 제안하고 진행
4. 논문 재현(Replication) 프로젝트
5. 오픈소스 기여 (통계 라이브러리 등)
실제로 해보는 게 가장 중요해요! 이론만 아는 것과 실제로 하는 건 완전 다르거든요 😊
🎬 마무리하며
와... 여기까지 오시느라 수고 많으셨어요! 👏👏👏
실험 설계와 통제변수 관리를 통한 인과관계 분석, 처음에는 어렵게 느껴질 수 있어요. 근데 핵심 원리는 사실 단순해요:
1. 명확한 질문을 던지기
"A가 B를 일으키는가?"
2. 다른 가능성들을 체계적으로 제거하기
무작위 배정, 통제변수 관리, 적절한 실험 설계
3. 데이터로 답하기
통계적 검정, 효과 크기, 신뢰구간
4. 겸손하게 해석하기
한계 인정, 대안 설명 고려, 재현 가능성 확보
이 네 가지만 기억하세요! 🎯
데이터 분석의 세계는 계속 발전하고 있어요. 새로운 기법들이 나오고, 도구들이 발전하고, 우리의 이해도 깊어지고 있죠. 완벽한 분석은 없어요. 하지만 더 나은 분석을 위해 노력하는 건 가능해요! 💪
여러분이 이 글을 통해 인과관계 분석의 중요성을 이해하고, 실제로 적용할 수 있는 기초를 다졌기를 바라요. 궁금한 점이 있거나 더 깊이 배우고 싶다면, 재능넷에서 통계 전문가들을 찾아보세요! 함께 배우고 성장하는 게 가장 빠른 길이니까요 😊
데이터로 세상을 이해하고, 더 나은 의사결정을 하는 여러분의 여정을 응원합니다! 🎉✨
Remember: 상관관계는 인과관계가 아니에요. 하지만 올바른 실험 설계와 통제변수 관리를 통해, 우리는 진짜 원인을 찾아낼 수 있어요! 🔬🎯
🌟 이 글이 도움이 되셨나요? 🌟
실험 설계와 데이터 분석, 함께 공부하고 성장해요!
질문이나 피드백은 언제든 환영입니다! 💬
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.






댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.