
Ver3.0 MongoDB Aggregation Pipeline 실전 활용
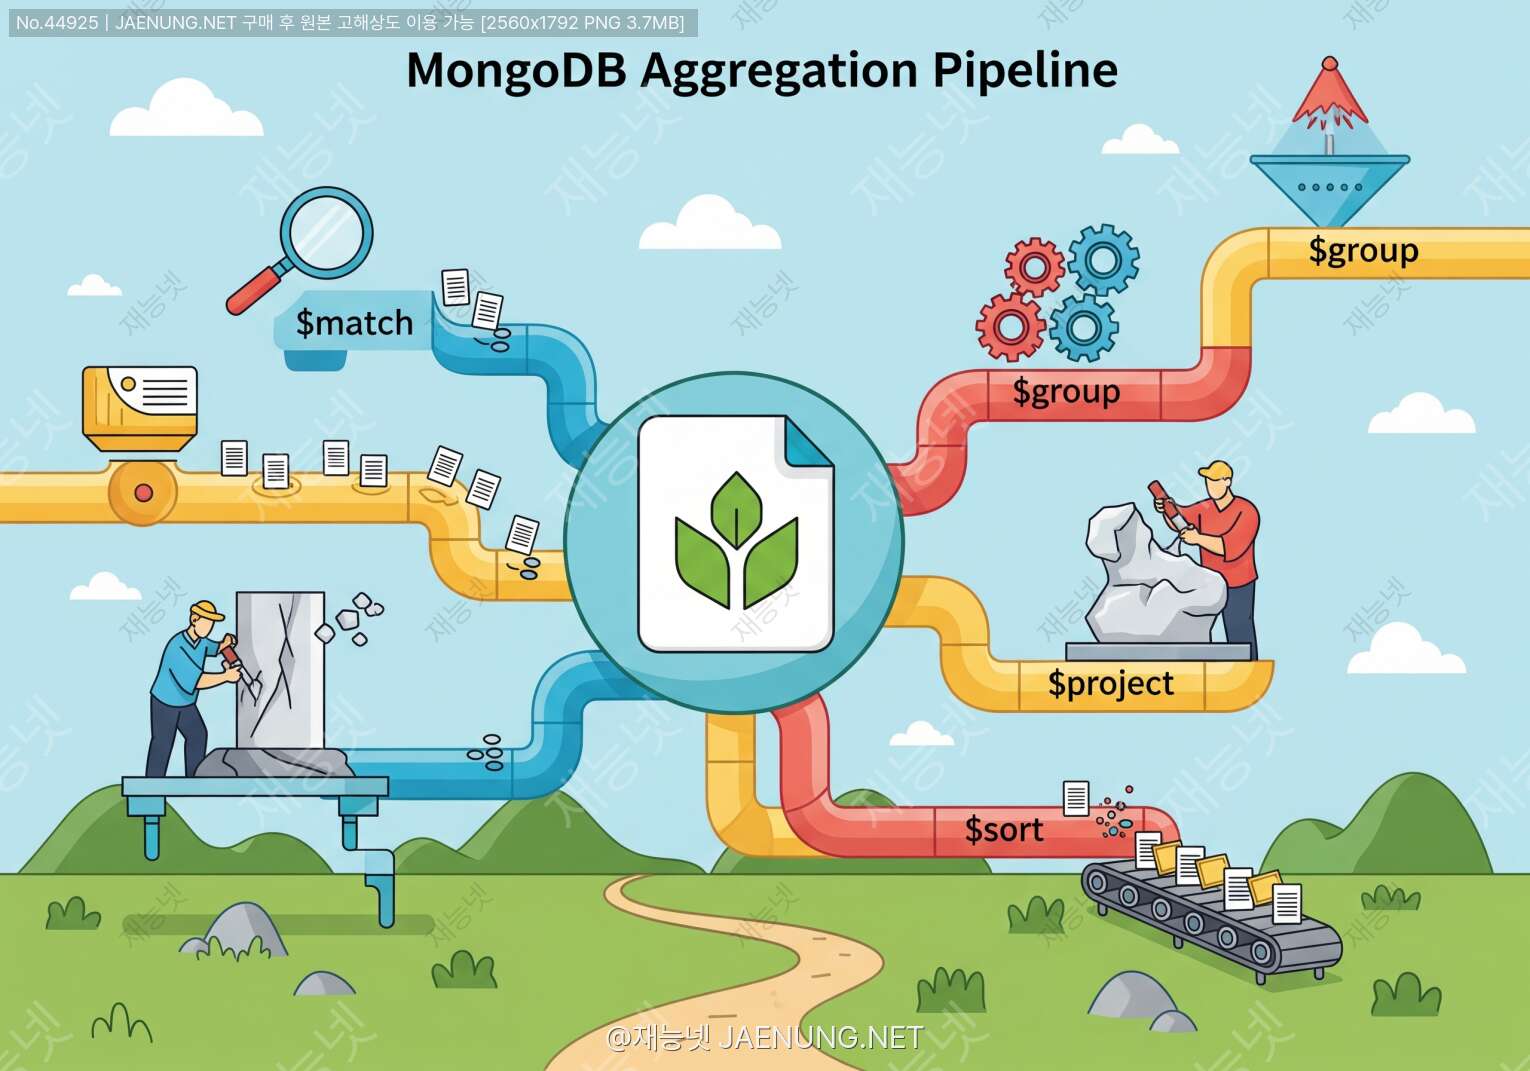
MongoDB Aggregation Pipeline 실전 활용
데이터 처리의 끝판왕, 이제 제대로 파헤쳐보자 🚀
🎯 Aggregation Pipeline이 뭔데?
MongoDB 쓰다보면 진짜 자주 마주치는 게 바로 Aggregation Pipeline이야 ㅋㅋㅋ 단순 조회로는 해결 안 되는 복잡한 데이터 처리가 필요할 때, 이 친구가 진가를 발휘하거든?
쉽게 말하면 데이터를 여러 단계(stage)로 나눠서 처리하는 파이프라인 구조야. 마치 공장 컨베이어 벨트처럼 데이터가 각 단계를 거치면서 변환되고 가공되는 거지 ⚙️
💡 핵심 개념
Aggregation Pipeline = 여러 개의 stage를 순차적으로 연결한 데이터 처리 파이프라인
각 stage는 입력 문서를 받아서 처리한 후 다음 stage로 전달
마지막 stage의 결과가 최종 출력이 됨
🔥 왜 Aggregation Pipeline을 써야 하는가?
솔직히 말해서 find()만으로도 왠만한 건 다 되잖아? 근데 실무에서는 그게 안 통해 ㅋㅋㅋ 진짜 복잡한 비즈니스 로직이 들어가면 find()로는 한계가 명확하거든.
🎪 실전 시나리오 예시
재능넷 같은 플랫폼에서 "최근 3개월간 카테고리별 거래 금액 TOP 10"을 뽑아야 한다고 생각해봐.
이걸 find()로 하려면?
1. 전체 데이터 조회
2. 애플리케이션 레벨에서 날짜 필터링
3. 카테고리별로 그룹화
4. 금액 합산
5. 정렬
6. 상위 10개 추출
와... 생각만 해도 코드 지저분해지고 성능도 구림 😱
근데 Aggregation Pipeline 쓰면? 한 방에 DB 레벨에서 처리 끝! 성능도 훨씬 좋고 코드도 깔끔해져.
✨ Aggregation Pipeline의 장점
1. 서버 사이드 처리: DB 엔진이 직접 처리하니까 네트워크 트래픽 감소
2. 인덱스 활용: 초반 stage에서 인덱스 타면 성능 폭발적 향상
3. 메모리 효율: 스트리밍 방식으로 처리되어 대용량 데이터도 OK
4. 코드 가독성: 선언적 방식이라 의도가 명확함
5. 유지보수: 로직이 한 곳에 모여있어 관리 편함
⚡ 핵심 Stage 완전 정복
자, 이제 본격적으로 각 stage들을 파헤쳐보자! 실무에서 진짜 많이 쓰는 것들 위주로 정리했어 📚
1️⃣ $match - 필터링의 기본
SQL의 WHERE절이랑 똑같다고 보면 돼. 조건에 맞는 문서만 다음 stage로 넘기는 거지.
db.orders.aggregate([
  {
    $match: {
      status: "completed",
      orderDate: {
        $gte: ISODate("2024-01-01"),
        $lt: ISODate("2024-04-01")
      },
      totalAmount: { $gte: 10000 }
    }
  }
])
⚠️ 성능 팁
$match는 가능하면 파이프라인 맨 앞에 배치해! 왜냐면 인덱스를 탈 수 있거든. 데이터를 먼저 줄여놓고 시작하는 게 무조건 유리함 ㅇㅇ
2️⃣ $group - 그룹화와 집계
이게 진짜 핵심이야! SQL의 GROUP BY랑 비슷한데 훨씬 강력함 ㅋㅋㅋ
db.sales.aggregate([
  {
    $group: {
      _id: "$category",  // 그룹화 기준
      totalSales: { $sum: "$amount" },  // 합계
      avgPrice: { $avg: "$price" },  // 평균
      count: { $sum: 1 },  // 개수
      maxAmount: { $max: "$amount" },  // 최대값
      minAmount: { $min: "$amount" }  // 최소값
    }
  }
])
$group에서 쓸 수 있는 accumulator 연산자들이 진짜 많은데, 자주 쓰는 것들만 정리하면:
| 연산자 | 기능 | 예시 |
|---|---|---|
| $sum | 합계 계산 | { $sum: "$quantity" } |
| $avg | 평균 계산 | { $avg: "$price" } |
| $max / $min | 최대/최소값 | { $max: "$score" } |
| $push | 배열에 값 추가 | { $push: "$item" } |
| $addToSet | 중복 제거 배열 | { $addToSet: "$tag" } |
| $first / $last | 첫/마지막 값 | { $first: "$date" } |
3️⃣ $project - 필드 선택과 변환
필요한 필드만 골라내거나, 새로운 필드를 만들거나, 기존 필드를 변환할 때 씀!
db.users.aggregate([
  {
    $project: {
      _id: 0,  // _id 제외
      username: 1,  // username 포함
      fullName: {  // 새 필드 생성
        $concat: ["$firstName", " ", "$lastName"]
      },
      age: {  // 계산된 필드
        $subtract: [
          { $year: new Date() },
          { $year: "$birthDate" }
        ]
      },
      isAdult: {  // 조건부 필드
        $gte: ["$age", 18]
      }
    }
  }
])
4️⃣ $sort - 정렬
말 그대로 정렬! 1은 오름차순, -1은 내림차순이야.
db.products.aggregate([
  {
    $sort: {
      category: 1,  // 카테고리 오름차순
      price: -1,    // 가격 내림차순
      name: 1       // 이름 오름차순
    }
  }
])
💡 정렬 최적화 팁
$sort를 $limit와 함께 쓰면 MongoDB가 내부적으로 최적화를 해줘. 전체 정렬 안 하고 상위 N개만 추적하는 방식으로 동작함!
5️⃣ $limit & $skip - 페이징
페이징 처리할 때 필수! 근데 $skip은 성능 이슈가 있어서 주의해야 함.
// 페이지당 20개씩, 3페이지 조회
db.posts.aggregate([
  { $match: { published: true } },
  { $sort: { createdAt: -1 } },
  { $skip: 40 },  // (3-1) * 20
  { $limit: 20 }
])
⚠️ $skip 성능 주의
$skip은 앞의 문서들을 실제로 다 읽고 건너뛰는 거라 숫자가 커질수록 느려짐 ㅠㅠ
대용량 데이터에서는 cursor 기반 페이징을 고려해봐!
6️⃣ $lookup - 조인 연산
MongoDB는 NoSQL이지만 조인이 필요할 때가 있잖아? 그럴 때 쓰는 게 $lookup!
db.orders.aggregate([
  {
    $lookup: {
      from: "users",           // 조인할 컬렉션
      localField: "userId",    // 현재 컬렉션의 필드
      foreignField: "_id",     // 대상 컬렉션의 필드
      as: "userInfo"          // 결과를 담을 필드명
    }
  }
])
더 복잡한 조인이 필요하면 pipeline 방식도 있어:
db.orders.aggregate([
  {
    $lookup: {
      from: "products",
      let: { productId: "$productId", qty: "$quantity" },
      pipeline: [
        {
          $match: {
            $expr: {
              $and: [
                { $eq: ["$_id", "$$productId"] },
                { $gte: ["$stock", "$$qty"] }
              ]
            }
          }
        },
        { $project: { name: 1, price: 1 } }
      ],
      as: "productDetails"
    }
  }
])
7️⃣ $unwind - 배열 펼치기
배열 필드를 개별 문서로 펼칠 때 사용! 배열 요소마다 문서가 하나씩 생성됨.
// 원본 문서
{
  _id: 1,
  name: "홍길동",
  hobbies: ["독서", "운동", "코딩"]
}

// $unwind 적용
db.users.aggregate([
  { $unwind: "$hobbies" }
])

// 결과
{ _id: 1, name: "홍길동", hobbies: "독서" }
{ _id: 1, name: "홍길동", hobbies: "운동" }
{ _id: 1, name: "홍길동", hobbies: "코딩" }
8️⃣ $addFields - 필드 추가
$project랑 비슷한데, 기존 필드는 그대로 두고 새 필드만 추가할 때 편함!
db.sales.aggregate([
  {
    $addFields: {
      totalPrice: {
        $multiply: ["$quantity", "$unitPrice"]
      },
      discountedPrice: {
        $multiply: [
          { $multiply: ["$quantity", "$unitPrice"] },
          { $subtract: [1, "$discountRate"] }
        ]
      }
    }
  }
])
🎨 실전 예제로 마스터하기
이론만 보면 재미없잖아 ㅋㅋㅋ 실제로 어떻게 쓰는지 예제로 확인해보자!
📊 예제 1: 카테고리별 매출 분석
재능넷 같은 플랫폼에서 카테고리별로 매출을 분석하는 상황을 가정해보자.
db.transactions.aggregate([
  // 1단계: 완료된 거래만 필터링
  {
    $match: {
      status: "completed",
      completedAt: {
        $gte: ISODate("2024-01-01"),
        $lt: ISODate("2024-04-01")
      }
    }
  },

  // 2단계: 카테고리별로 그룹화하고 집계
  {
    $group: {
      _id: "$category",
      totalRevenue: { $sum: "$amount" },
      transactionCount: { $sum: 1 },
      avgAmount: { $avg: "$amount" },
      maxAmount: { $max: "$amount" }
    }
  },

  // 3단계: 매출액 기준 내림차순 정렬
  {
    $sort: { totalRevenue: -1 }
  },

  // 4단계: 필드명 정리 및 추가 계산
  {
    $project: {
      _id: 0,
      category: "$_id",
      totalRevenue: 1,
      transactionCount: 1,
      avgAmount: { $round: ["$avgAmount", 2] },
      maxAmount: 1,
      revenuePerTransaction: {
        $round: [
          { $divide: ["$totalRevenue", "$transactionCount"] },
          2
        ]
      }
    }
  },

  // 5단계: 상위 10개만 추출
  {
    $limit: 10
  }
])
이렇게 하면 한 번의 쿼리로 복잡한 분석이 끝남! 애플리케이션 코드는 결과만 받아서 보여주면 돼 🎉
🔍 예제 2: 사용자별 활동 통계
사용자들의 활동 패턴을 분석하는 복잡한 쿼리를 만들어보자.
db.activities.aggregate([
  // 1단계: 최근 30일 데이터만
  {
    $match: {
      timestamp: {
        $gte: new Date(Date.now() - 30 * 24 * 60 * 60 * 1000)
      }
    }
  },

  // 2단계: 사용자별로 그룹화
  {
    $group: {
      _id: "$userId",
      totalActivities: { $sum: 1 },
      activityTypes: { $addToSet: "$type" },
      firstActivity: { $min: "$timestamp" },
      lastActivity: { $max: "$timestamp" },
      totalDuration: { $sum: "$duration" }
    }
  },

  // 3단계: 사용자 정보 조인
  {
    $lookup: {
      from: "users",
      localField: "_id",
      foreignField: "_id",
      as: "userInfo"
    }
  },

  // 4단계: 배열 펼치기
  {
    $unwind: "$userInfo"
  },

  // 5단계: 추가 계산 및 필드 정리
  {
    $addFields: {
      avgDuration: {
        $divide: ["$totalDuration", "$totalActivities"]
      },
      activeDays: {
        $divide: [
          {
            $subtract: ["$lastActivity", "$firstActivity"]
          },
          86400000  // 밀리초를 일수로 변환
        ]
      },
      activityScore: {
        $multiply: [
          "$totalActivities",
          { $size: "$activityTypes" }
        ]
      }
    }
  },

  // 6단계: 최종 결과 형태 정리
  {
    $project: {
      _id: 0,
      userId: "$_id",
      username: "$userInfo.username",
      email: "$userInfo.email",
      totalActivities: 1,
      activityTypes: 1,
      avgDuration: { $round: ["$avgDuration", 2] },
      activeDays: { $round: ["$activeDays", 1] },
      activityScore: 1,
      engagementLevel: {
        $switch: {
          branches: [
            { case: { $gte: ["$activityScore", 100] }, then: "매우 활발" },
            { case: { $gte: ["$activityScore", 50] }, then: "활발" },
            { case: { $gte: ["$activityScore", 20] }, then: "보통" }
          ],
          default: "저조"
        }
      }
    }
  },

  // 7단계: 활동 점수 기준 정렬
  {
    $sort: { activityScore: -1 }
  }
])
와... 복잡해 보이지? 근데 이게 실무에서 진짜 많이 쓰는 패턴이야 ㅋㅋㅋ
📈 예제 3: 시계열 데이터 집계
날짜별, 시간대별 통계를 내는 것도 자주 하는 작업이지!
db.pageViews.aggregate([
  // 1단계: 기간 필터링
  {
    $match: {
      timestamp: {
        $gte: ISODate("2024-01-01"),
        $lt: ISODate("2024-02-01")
      }
    }
  },

  // 2단계: 날짜/시간 정보 추출
  {
    $addFields: {
      date: { $dateToString: { format: "%Y-%m-%d", date: "$timestamp" } },
      hour: { $hour: "$timestamp" },
      dayOfWeek: { $dayOfWeek: "$timestamp" }
    }
  },

  // 3단계: 날짜별로 그룹화
  {
    $group: {
      _id: {
        date: "$date",
        hour: "$hour"
      },
      pageViews: { $sum: 1 },
      uniqueUsers: { $addToSet: "$userId" },
      avgDuration: { $avg: "$duration" },
      bounceRate: {
        $avg: {
          $cond: [{ $eq: ["$pageCount", 1] }, 1, 0]
        }
      }
    }
  },

  // 4단계: 고유 사용자 수 계산
  {
    $addFields: {
      uniqueUserCount: { $size: "$uniqueUsers" }
    }
  },

  // 5단계: 결과 정리
  {
    $project: {
      _id: 0,
      date: "$_id.date",
      hour: "$_id.hour",
      pageViews: 1,
      uniqueUserCount: 1,
      avgDuration: { $round: ["$avgDuration", 2] },
      bounceRate: { $round: [{ $multiply: ["$bounceRate", 100] }, 2] }
    }
  },

  // 6단계: 날짜와 시간 기준 정렬
  {
    $sort: { date: 1, hour: 1 }
  }
])🚀 성능 최적화 꿀팁
Aggregation Pipeline 잘 쓰는 것도 중요하지만, 성능까지 챙겨야 진짜 고수지 ㅋㅋㅋ
1. 인덱스 활용 극대화 ⚡
$match와 $sort를 파이프라인 초반에 배치하면 인덱스를 탈 수 있어. 특히 $match는 무조건 맨 앞에!
// 좋은 예 - 인덱스 활용 가능
db.orders.aggregate([
  { $match: { status: "completed" } },  // 인덱스 사용
  { $sort: { orderDate: -1 } },         // 인덱스 사용
  { $group: { ... } }
])

// 나쁜 예 - 인덱스 활용 불가
db.orders.aggregate([
  { $group: { ... } },
  { $match: { status: "completed" } },  // 너무 늦음
  { $sort: { orderDate: -1 } }
])
2. 데이터 크기 조기 축소 📉
필요한 필드만 일찍 선택하고, 불필요한 데이터는 빨리 걸러내!
db.users.aggregate([
  { $match: { active: true } },  // 먼저 필터링
  { $project: {                  // 필요한 필드만
      username: 1,
      email: 1,
      lastLogin: 1
    }
  },
  { $sort: { lastLogin: -1 } },
  { $limit: 100 }
])
3. $lookup 최적화 🔗
조인은 비용이 비싸! 꼭 필요한 경우만 쓰고, pipeline 방식으로 필터링을 추가해서 조인되는 데이터를 줄여!
db.orders.aggregate([
  { $match: { status: "pending" } },
  {
    $lookup: {
      from: "users",
      let: { userId: "$userId" },
      pipeline: [
        { $match: { $expr: { $eq: ["$_id", "$$userId"] } } },
        { $project: { username: 1, email: 1 } }  // 필요한 필드만
      ],
      as: "user"
    }
  }
])
4. allowDiskUse 옵션 활용 💾
대용량 데이터 처리 시 메모리 부족 에러가 날 수 있어. 이럴 땐 디스크 사용을 허용!
db.bigCollection.aggregate(
  [
    { $match: { ... } },
    { $group: { ... } },
    { $sort: { ... } }
  ],
  { allowDiskUse: true }  // 디스크 사용 허용
)
⚠️ 주의사항
allowDiskUse를 켜면 성능이 떨어질 수 있어. 근본적으로는 쿼리 최적화나 인덱스 추가를 먼저 고려해야 함!
5. explain()으로 실행 계획 확인 🔍
쿼리가 어떻게 실행되는지 확인하는 습관을 들여!
db.orders.explain("executionStats").aggregate([
  { $match: { status: "completed" } },
  { $group: { _id: "$category", total: { $sum: "$amount" } } }
])

// 확인할 포인트:
// - totalDocsExamined: 검사한 문서 수
// - executionTimeMillis: 실행 시간
// - indexesUsed: 사용된 인덱스
💡 성능 체크리스트
✅ $match를 파이프라인 초반에 배치했는가?
✅ 인덱스가 제대로 적용되고 있는가?
✅ 불필요한 필드를 일찍 제거했는가?
✅ $lookup 사용을 최소화했는가?
✅ 대용량 데이터 처리 시 allowDiskUse를 고려했는가?
✅ explain()으로 실행 계획을 확인했는가?
🎯 고급 테크닉
기본은 마스터했으니 이제 좀 더 심화된 내용으로 가보자! 실무에서 진짜 차별화되는 부분들이야 🔥
🧮 $facet - 다중 집계 동시 실행
한 번의 쿼리로 여러 가지 집계를 동시에 실행할 수 있어! 대시보드 만들 때 진짜 유용함 ㅋㅋㅋ
db.products.aggregate([
  {
    $facet: {
      // 카테고리별 통계
      "byCategory": [
        { $group: { _id: "$category", count: { $sum: 1 } } },
        { $sort: { count: -1 } }
      ],

      // 가격대별 분포
      "byPriceRange": [
        {
          $bucket: {
            groupBy: "$price",
            boundaries: [0, 10000, 50000, 100000, 500000],
            default: "500000+",
            output: { count: { $sum: 1 }, avgPrice: { $avg: "$price" } }
          }
        }
      ],

      // 전체 통계
      "overall": [
        {
          $group: {
            _id: null,
            totalProducts: { $sum: 1 },
            avgPrice: { $avg: "$price" },
            maxPrice: { $max: "$price" },
            minPrice: { $min: "$price" }
          }
        }
      ]
    }
  }
])
결과가 객체 형태로 나와서 각 집계 결과를 바로 사용할 수 있어!
🪣 $bucket - 데이터 버킷팅
데이터를 구간별로 나눠서 분석할 때 완전 편함!
db.users.aggregate([
  {
    $bucket: {
      groupBy: "$age",
      boundaries: [0, 20, 30, 40, 50, 60, 100],
      default: "기타",
      output: {
        count: { $sum: 1 },
        users: { $push: "$username" },
        avgAge: { $avg: "$age" }
      }
    }
  }
])
🔄 $graphLookup - 재귀 조회
계층 구조나 그래프 데이터를 다룰 때 쓰는 고급 기능! 조직도, 카테고리 트리 같은 거 처리할 때 완전 꿀 🍯
// 직원의 모든 하위 직원 찾기
db.employees.aggregate([
  {
    $match: { name: "김팀장" }
  },
  {
    $graphLookup: {
      from: "employees",
      startWith: "$_id",
      connectFromField: "_id",
      connectToField: "managerId",
      as: "subordinates",
      maxDepth: 5,
      depthField: "level"
    }
  }
])
🎲 $sample - 랜덤 샘플링
대용량 데이터에서 무작위로 샘플 추출할 때 유용해!
// 랜덤으로 100개 문서 추출
db.products.aggregate([
  { $sample: { size: 100 } }
])

// 조건 필터링 후 샘플링
db.products.aggregate([
  { $match: { inStock: true } },
  { $sample: { size: 50 } }
])
🔀 $redact - 조건부 필드 제거
문서 레벨이 아니라 필드 레벨에서 조건부로 데이터를 숨길 수 있어. 권한 관리할 때 좋음!
db.documents.aggregate([
  {
    $redact: {
      $cond: {
        if: { $eq: ["$accessLevel", "public"] },
        then: "$$DESCEND",  // 하위 필드 계속 검사
        else: "$$PRUNE"     // 해당 필드 제거
      }
    }
  }
])
📊 $setWindowFields - 윈도우 함수
MongoDB 5.0부터 추가된 기능! SQL의 윈도우 함수처럼 쓸 수 있어서 진짜 강력함 ㅋㅋㅋ
db.sales.aggregate([
  {
    $setWindowFields: {
      partitionBy: "$category",
      sortBy: { date: 1 },
      output: {
        // 누적 합계
        cumulativeSum: {
          $sum: "$amount",
          window: {
            documents: ["unbounded", "current"]
          }
        },
        // 이동 평균 (최근 7일)
        movingAvg: {
          $avg: "$amount",
          window: {
            documents: [-6, 0]
          }
        },
        // 순위
        rank: {
          $rank: {}
        }
      }
    }
  }
])
이거 진짜 게임체인저임! 시계열 분석이나 순위 계산할 때 완전 편해짐 🎯
🐛 자주 하는 실수와 해결법
실무에서 진짜 많이 겪는 문제들 정리해봤어. 나도 다 겪어본 것들이라 ㅋㅋㅋ
❌ 실수 1: $match를 너무 늦게 사용
문제: 전체 데이터를 다 처리한 후에 필터링
해결: $match를 가능한 한 파이프라인 초반에 배치
// 나쁜 예
db.orders.aggregate([
  { $lookup: { ... } },  // 전체 조인
  { $unwind: "$items" },
  { $match: { status: "completed" } }  // 너무 늦음!
])

// 좋은 예
db.orders.aggregate([
  { $match: { status: "completed" } },  // 먼저 필터링!
  { $lookup: { ... } },
  { $unwind: "$items" }
])
❌ 실수 2: $unwind 후 데이터 폭발
문제: 배열 크기가 큰 필드를 unwind하면 문서 수가 폭발적으로 증가
해결: preserveNullAndEmptyArrays 옵션 활용하거나, 꼭 필요한 경우만 unwind
// 안전한 unwind
db.orders.aggregate([
  {
    $unwind: {
      path: "$items",
      preserveNullAndEmptyArrays: true  // 빈 배열도 보존
    }
  }
])
❌ 실수 3: 메모리 제한 초과
문제: 100MB 메모리 제한에 걸림
해결: allowDiskUse 옵션 사용 또는 쿼리 최적화
// 메모리 제한 회피
db.bigData.aggregate(
  [ ... ],
  { allowDiskUse: true, maxTimeMS: 60000 }
)
❌ 실수 4: $lookup에서 인덱스 미활용
문제: 조인 시 인덱스를 타지 않아 느림
해결: foreignField에 인덱스 생성, pipeline 방식으로 최적화
// 인덱스 생성
db.users.createIndex({ _id: 1 })

// 최적화된 lookup
db.orders.aggregate([
  {
    $lookup: {
      from: "users",
      let: { userId: "$userId" },
      pipeline: [
        { $match: { $expr: { $eq: ["$_id", "$$userId"] } } },
        { $project: { username: 1 } }  // 필요한 필드만
      ],
      as: "user"
    }
  }
])
❌ 실수 5: $group 후 정렬 누락
문제: 그룹화 결과의 순서가 보장되지 않음
해결: 항상 $sort 추가
db.sales.aggregate([
  { $group: { _id: "$category", total: { $sum: "$amount" } } },
  { $sort: { total: -1 } }  // 정렬 필수!
])
✨ 디버깅 팁
1. 각 stage별로 결과를 확인하면서 단계적으로 구축
2. $out이나 $merge로 중간 결과를 임시 컬렉션에 저장
3. explain()으로 실행 계획 분석
4. MongoDB Compass의 Aggregation Builder 활용
💼 실무 활용 시나리오
이론은 충분히 봤으니, 이제 실제 비즈니스 상황에서 어떻게 활용하는지 보자!
📱 시나리오 1: 실시간 대시보드 데이터
관리자 대시보드에 필요한 여러 통계를 한 번에 가져오는 쿼리!
db.transactions.aggregate([
  // 오늘 데이터만
  {
    $match: {
      createdAt: {
        $gte: new Date(new Date().setHours(0, 0, 0, 0))
      }
    }
  },

  // 다중 집계
  {
    $facet: {
      // 전체 요약
      summary: [
        {
          $group: {
            _id: null,
            totalRevenue: { $sum: "$amount" },
            totalTransactions: { $sum: 1 },
            avgTransaction: { $avg: "$amount" }
          }
        }
      ],

      // 시간대별 트렌드
      hourlyTrend: [
        {
          $group: {
            _id: { $hour: "$createdAt" },
            revenue: { $sum: "$amount" },
            count: { $sum: 1 }
          }
        },
        { $sort: { _id: 1 } }
      ],

      // 카테고리별 TOP 5
      topCategories: [
        {
          $group: {
            _id: "$category",
            revenue: { $sum: "$amount" },
            count: { $sum: 1 }
          }
        },
        { $sort: { revenue: -1 } },
        { $limit: 5 }
      ],

      // 최근 거래
      recentTransactions: [
        { $sort: { createdAt: -1 } },
        { $limit: 10 },
        {
          $lookup: {
            from: "users",
            localField: "userId",
            foreignField: "_id",
            as: "user"
          }
        },
        { $unwind: "$user" },
        {
          $project: {
            amount: 1,
            category: 1,
            createdAt: 1,
            username: "$user.username"
          }
        }
      ]
    }
  }
])
이렇게 하면 한 번의 쿼리로 대시보드에 필요한 모든 데이터를 가져올 수 있어! API 호출도 줄고 성능도 좋아짐 🚀
🎯 시나리오 2: 추천 시스템 데이터
사용자 행동 기반으로 추천 아이템을 뽑아내는 쿼리!
db.userActivities.aggregate([
  // 1. 특정 사용자의 최근 활동
  {
    $match: {
      userId: ObjectId("..."),
      timestamp: {
        $gte: new Date(Date.now() - 30 * 24 * 60 * 60 * 1000)
      }
    }
  },

  // 2. 관심 카테고리 추출
  {
    $group: {
      _id: "$category",
      interactionCount: { $sum: 1 },
      lastInteraction: { $max: "$timestamp" }
    }
  },

  // 3. 관심도 점수 계산
  {
    $addFields: {
      interestScore: {
        $multiply: [
          "$interactionCount",
          {
            $divide: [
              { $subtract: [new Date(), "$lastInteraction"] },
              86400000  // 최신성 반영
            ]
          }
        ]
      }
    }
  },

  // 4. 상위 관심 카테고리
  { $sort: { interestScore: -1 } },
  { $limit: 3 },

  // 5. 해당 카테고리의 인기 아이템 조회
  {
    $lookup: {
      from: "items",
      let: { category: "$_id" },
      pipeline: [
        { $match: { $expr: { $eq: ["$category", "$$category"] } } },
        { $sort: { popularity: -1, rating: -1 } },
        { $limit: 5 }
      ],
      as: "recommendedItems"
    }
  },

  // 6. 결과 정리
  {
    $project: {
      category: "$_id",
      interestScore: 1,
      recommendedItems: {
        $map: {
          input: "$recommendedItems",
          as: "item",
          in: {
            id: "$$item._id",
            name: "$$item.name",
            price: "$$item.price",
            rating: "$$item.rating"
          }
        }
      }
    }
  }
])
📊 시나리오 3: 코호트 분석
가입 시기별 사용자 리텐션을 분석하는 쿼리! 마케팅 팀이 완전 좋아함 ㅋㅋㅋ
db.users.aggregate([
  // 1. 가입 월 추출
  {
    $addFields: {
      cohortMonth: {
        $dateToString: {
          format: "%Y-%m",
          date: "$createdAt"
        }
      }
    }
  },

  // 2. 활동 데이터 조인
  {
    $lookup: {
      from: "activities",
      localField: "_id",
      foreignField: "userId",
      as: "activities"
    }
  },

  // 3. 활동 데이터 펼치기
  { $unwind: "$activities" },

  // 4. 활동 월 추출
  {
    $addFields: {
      activityMonth: {
        $dateToString: {
          format: "%Y-%m",
          date: "$activities.timestamp"
        }
      }
    }
  },

  // 5. 코호트별 월별 활성 사용자 수
  {
    $group: {
      _id: {
        cohort: "$cohortMonth",
        activity: "$activityMonth"
      },
      activeUsers: { $addToSet: "$_id" }
    }
  },

  // 6. 활성 사용자 수 계산
  {
    $addFields: {
      activeUserCount: { $size: "$activeUsers" }
    }
  },

  // 7. 코호트별 초기 사용자 수 조회
  {
    $lookup: {
      from: "users",
      let: { cohort: "$_id.cohort" },
      pipeline: [
        {
          $match: {
            $expr: {
              $eq: [
                { $dateToString: { format: "%Y-%m", date: "$createdAt" } },
                "$$cohort"
              ]
            }
          }
        },
        { $count: "total" }
      ],
      as: "cohortSize"
    }
  },

  // 8. 리텐션율 계산
  {
    $addFields: {
      retentionRate: {
        $multiply: [
          {
            $divide: [
              "$activeUserCount",
              { $arrayElemAt: ["$cohortSize.total", 0] }
            ]
          },
          100
        ]
      }
    }
  },

  // 9. 결과 정리
  {
    $project: {
      _id: 0,
      cohort: "$_id.cohort",
      activityMonth: "$_id.activity",
      activeUsers: "$activeUserCount",
      retentionRate: { $round: ["$retentionRate", 2] }
    }
  },

  // 10. 정렬
  {
    $sort: {
      cohort: 1,
      activityMonth: 1
    }
  }
])
복잡해 보이지? 근데 이런 분석이 비즈니스 의사결정에 진짜 중요하거든 📈
🛠️ 개발 환경별 활용법
각 언어/프레임워크에서 어떻게 쓰는지도 알아야지!
🟢 Node.js (Mongoose)
const Order = require('./models/Order');

// 기본 사용
const result = await Order.aggregate([
  { $match: { status: 'completed' } },
  { $group: { _id: '$category', total: { $sum: '$amount' } } },
  { $sort: { total: -1 } }
]);

// 타입 안전성을 위한 방법
const pipeline = [
  { $match: { status: 'completed' } },
  { $group: { _id: '$category', total: { $sum: '$amount' } } }
];

const result = await Order.aggregate(pipeline).exec();

// 페이징 처리
const page = 1;
const limit = 20;

const result = await Order.aggregate([
  { $match: { status: 'completed' } },
  { $sort: { createdAt: -1 } },
  { $skip: (page - 1) * limit },
  { $limit: limit }
]);
🐍 Python (PyMongo)
from pymongo import MongoClient
from datetime import datetime, timedelta

client = MongoClient('mongodb://localhost:27017/')
db = client['mydb']

# 기본 사용
pipeline = [
    {'$match': {'status': 'completed'}},
    {'$group': {'_id': '$category', 'total': {'$sum': '$amount'}}},
    {'$sort': {'total': -1}}
]

result = list(db.orders.aggregate(pipeline))

# allowDiskUse 옵션
result = list(db.orders.aggregate(
    pipeline,
    allowDiskUse=True,
    maxTimeMS=60000
))

# 날짜 필터링
start_date = datetime.now() - timedelta(days=30)
pipeline = [
    {'$match': {
        'createdAt': {'$gte': start_date}
    }},
    {'$group': {
        '_id': {'$dateToString': {'format': '%Y-%m-%d', 'date': '$createdAt'}},
        'count': {'$sum': 1}
    }}
]

result = list(db.orders.aggregate(pipeline))
☕ Java (Spring Data MongoDB)
import org.springframework.data.mongodb.core.aggregation.*;
import static org.springframework.data.mongodb.core.aggregation.Aggregation.*;

@Service
public class OrderService {
    @Autowired
    private MongoTemplate mongoTemplate;

    public List<CategoryStats> getCategoryStats() {
        Aggregation aggregation = newAggregation(
            match(Criteria.where("status").is("completed")),
            group("category")
                .sum("amount").as("total")
                .count().as("count"),
            sort(Sort.Direction.DESC, "total"),
            limit(10)
        );

        AggregationResults<CategoryStats> results =
            mongoTemplate.aggregate(aggregation, "orders", CategoryStats.class);

        return results.getMappedResults();
    }

    // 복잡한 파이프라인
    public List<Document> getComplexStats() {
        List<Document> pipeline = Arrays.asList(
            new Document("$match", new Document("status", "completed")),
            new Document("$group", new Document("_id", "$category")
                .append("total", new Document("$sum", "$amount"))),
            new Document("$sort", new Document("total", -1))
        );

        return mongoTemplate.getCollection("orders")
            .aggregate(pipeline)
            .into(new ArrayList<>());
    }
}
🔷 TypeScript (NestJS)
import { Injectable } from '@nestjs/common';
import { InjectModel } from '@nestjs/mongoose';
import { Model } from 'mongoose';
import { Order } from './schemas/order.schema';

@Injectable()
export class OrderService {
  constructor(
    @InjectModel(Order.name) private orderModel: Model<Order>
  ) {}

  async getCategoryStats(): Promise<any[]> {
    return this.orderModel.aggregate([
      { $match: { status: 'completed' } },
      {
        $group: {
          _id: '$category',
          total: { $sum: '$amount' },
          count: { $sum: 1 }
        }
      },
      { $sort: { total: -1 } }
    ]).exec();
  }

  // 타입 안전한 방법
  async getTypedStats(): Promise<CategoryStats[]> {
    interface CategoryStats {
      _id: string;
      total: number;
      count: number;
    }

    return this.orderModel.aggregate<CategoryStats>([
      { $match: { status: 'completed' } },
      { $group: { _id: '$category', total: { $sum: '$amount' } } }
    ]).exec();
  }
}
💡 프레임워크별 팁
Node.js: lean() 옵션으로 성능 향상 가능
Python: cursor를 사용해 메모리 효율적으로 처리
Java: TypedAggregation으로 타입 안전성 확보
TypeScript: 제네릭으로 결과 타입 명시
🎓 학습 로드맵
Aggregation Pipeline 마스터하려면 이 순서로 공부하는 게 좋아!
📚 추천 학습 자료
공식 문서: MongoDB Aggregation 공식 문서 (필독!)
실습: MongoDB University의 무료 강좌
책: "MongoDB: The Definitive Guide"
커뮤니티: Stack Overflow, MongoDB Community Forums
실전: 재능넷 같은 플랫폼에서 실제 프로젝트 경험 쌓기
🎬 마무리하며
와... 여기까지 읽었으면 진짜 대단한 거야 ㅋㅋㅋ Aggregation Pipeline은 처음엔 어렵게 느껴질 수 있는데, 막상 써보면 진짜 강력하다는 걸 알게 될 거야 💪
🎯 핵심 정리
1. Aggregation Pipeline은 여러 stage를 연결한 데이터 처리 파이프라인
2. $match는 가능한 한 초반에, 인덱스 활용이 핵심
3. $group으로 강력한 집계 연산 수행
4. $lookup으로 컬렉션 간 조인 가능
5. 성능 최적화는 필수, explain()으로 항상 확인
6. 실무에서는 복잡한 비즈니스 로직을 DB 레벨에서 처리
7. 각 프레임워크별 특성을 이해하고 활용
MongoDB를 쓰면서 Aggregation Pipeline을 제대로 활용하지 못하는 건 진짜 아까운 일이야. 복잡한 데이터 처리를 애플리케이션 레벨에서 하느라 고생하지 말고, DB가 해줄 수 있는 건 DB에게 맡기자!
실무에서 막히는 부분 있으면 공식 문서 보고, 커뮤니티에 물어보고, 직접 실험해보면서 배워나가면 돼. 처음엔 복잡해 보여도 패턴이 보이기 시작하면 금방 익숙해질 거야 🚀
✨ 다음 단계
이제 직접 프로젝트에 적용해봐! 간단한 통계 쿼리부터 시작해서 점점 복잡한 분석으로 확장해나가는 거지. 실전 경험이 최고의 선생님이야 ㅇㅇ
그리고 혹시 DB나 서버 관련해서 더 깊이 공부하고 싶거나, 실무 프로젝트에 적용하면서 멘토링이 필요하다면 재능넷에서 전문가들의 도움을 받아보는 것도 좋은 방법이야. 혼자 삽질하는 것보다 경험 많은 사람한테 배우는 게 훨씬 빠르거든 ㅋㅋㅋ
자, 이제 당신도 Aggregation Pipeline 마스터! 실무에서 멋진 쿼리 작성해보자구 🎉
Happy Aggregating! 🚀
데이터 처리의 진정한 재미를 느껴보세요

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.







아직 댓글이 없습니다.