
Ver3.0 🤖 Python + LlamaIndex로 문서 기반 Q&A 개발하기
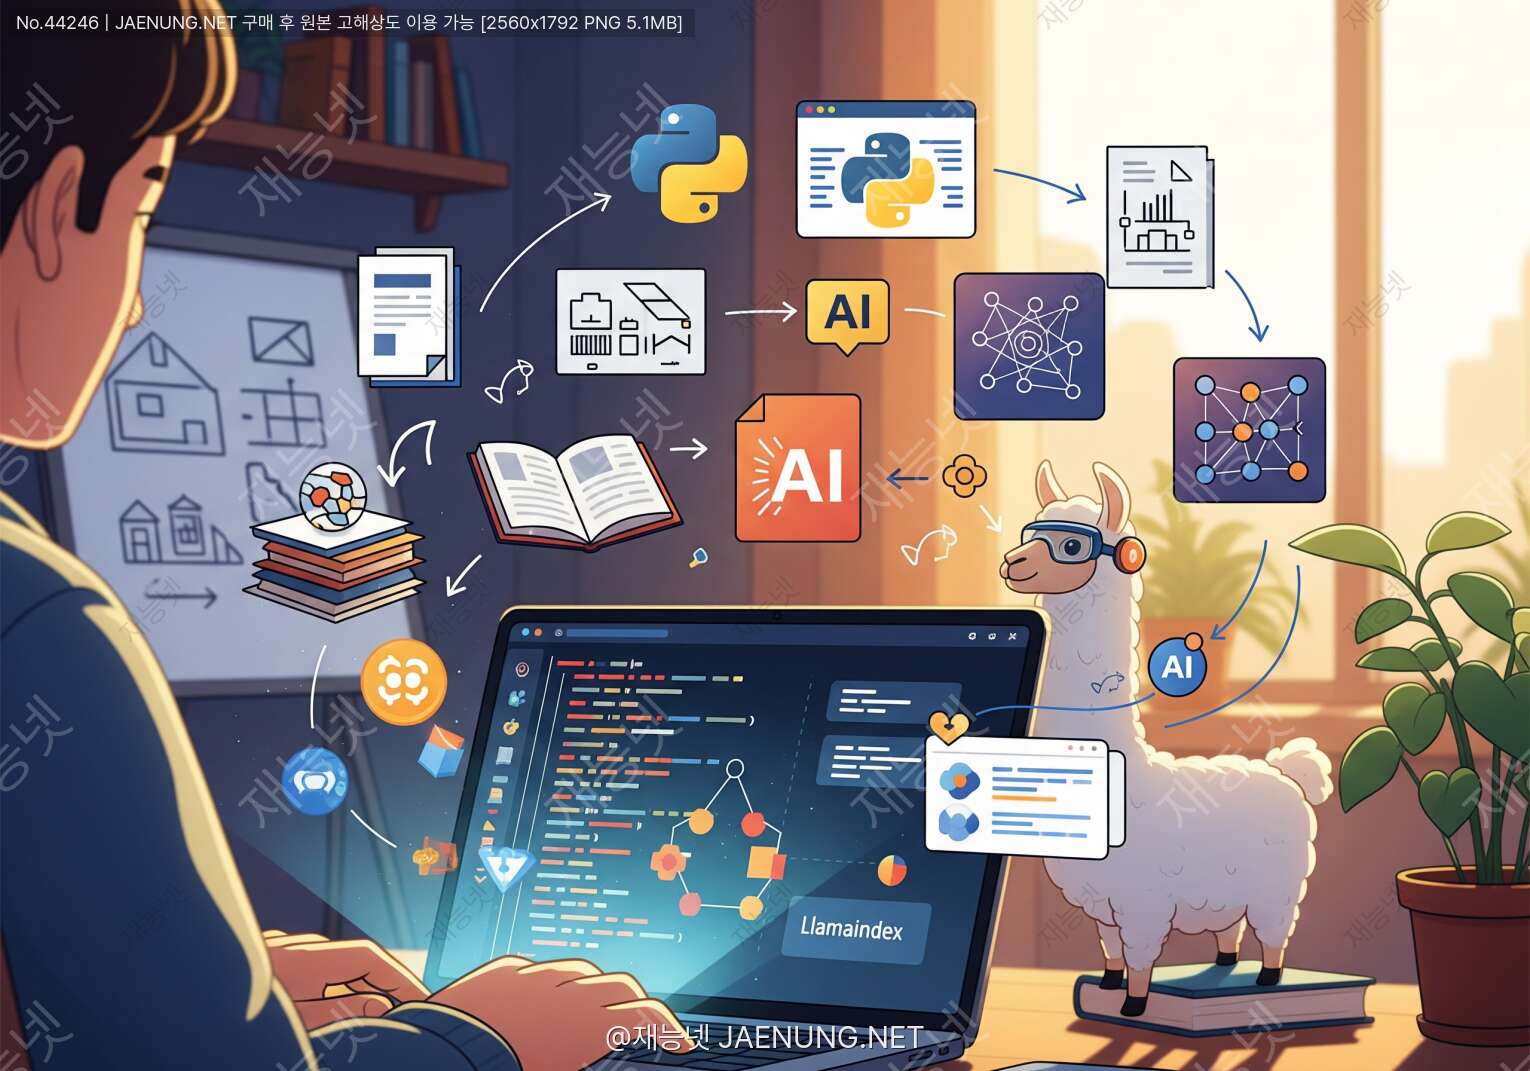
🤖 Python + LlamaIndex로 문서 기반 Q&A 개발하기
AI가 내 문서를 읽고 척척 답변해주는 시스템 만들기 ㅋㅋㅋ
요즘 ChatGPT 쓰다보면 진짜 신기하잖아요? 질문하면 바로바로 답변해주고 ㅋㅋㅋ 근데 생각해보면 우리 회사 문서나 개인 자료들은 ChatGPT가 모르잖아요? 🤔
"아 우리 회사 매뉴얼 1000페이지 되는데 이거 AI한테 학습시켜서 직원들이 물어보면 바로 답변해주게 할 수 없나?"
이런 생각 한번쯤 해보셨죠? 오늘은 바로 그걸 만드는 방법을 알려드릴게요! Python이랑 LlamaIndex라는 라이브러리 쓰면 생각보다 간단하게 구현 가능합니다 💪
LlamaIndex는 LLM(Large Language Model) 기반 애플리케이션을 만들 때 문서 데이터를 쉽게 연결해주는 프레임워크예요. 쉽게 말하면 GPT 같은 AI 모델이 우리 문서를 읽고 이해할 수 있게 도와주는 도구라고 보시면 됩니다 ㅎㅎ
예전에는 이런 시스템 만들려면 진짜 복잡했거든요? 문서 파싱하고, 벡터 임베딩 만들고, 검색 알고리즘 구현하고... 머리 아프죠 😵
근데 LlamaIndex 쓰면 이 모든 과정이 몇 줄의 코드로 해결됩니다! 진짜루요 ㅋㅋㅋ
자 이제 본격적으로 시작해볼까요? 먼저 필요한 라이브러리들을 설치해야 합니다. Python 3.8 이상 버전이면 됩니다!
터미널이나 명령 프롬프트에서 다음 명령어를 실행하세요:
pip install llama-index
pip install openai
pip install pypdf
pip install python-docx
이렇게 하면 LlamaIndex 본체와 문서 처리에 필요한 라이브러리들이 한방에 설치됩니다 👍
LlamaIndex는 기본적으로 OpenAI의 GPT 모델을 사용해요. 그래서 OpenAI API 키가 필요합니다.
OpenAI 웹사이트(platform.openai.com)에서 계정 만들고 API 키 발급받으시면 돼요. 유료긴 한데 테스트용으로는 몇 달러면 충분합니다 ㅋㅋ
이제 진짜 코드를 작성해볼 시간이에요! 가장 기본적인 형태부터 시작해봅시다 🚀
import os
from llama_index import VectorStoreIndex, SimpleDirectoryReader, ServiceContext
from llama_index.llms import OpenAI

# OpenAI API 키 설정
os.environ["OPENAI_API_KEY"] = "your-api-key-here"

# 문서 로드 (documents 폴더에 있는 모든 파일)
documents = SimpleDirectoryReader("documents").load_data()

# LLM 설정 (GPT-3.5-turbo 사용)
llm = OpenAI(model="gpt-3.5-turbo", temperature=0.1)
service_context = ServiceContext.from_defaults(llm=llm)

# 인덱스 생성
index = VectorStoreIndex.from_documents(
    documents,
    service_context=service_context
)

# 쿼리 엔진 생성
query_engine = index.as_query_engine()

# 질문하기!
response = query_engine.query("이 문서의 주요 내용은 뭐야?")
print(response)
와 이게 끝이에요 ㅋㅋㅋ 진짜 간단하죠? 이 코드만으로도 문서를 읽고 질문에 답변하는 AI 시스템이 완성됩니다!
2. VectorStoreIndex: 문서를 벡터로 변환해서 검색 가능한 인덱스를 만들어요. 이게 핵심이에요 🎯
3. query_engine: 실제로 질문을 받아서 답변을 생성하는 엔진입니다. 관련 문서 부분을 찾아서 GPT에게 전달해줘요.
기본 코드는 봤으니 이제 좀 더 실전에서 쓸 수 있게 업그레이드해봅시다! 성능도 올리고 기능도 추가하고 ㅎㅎ
문서를 너무 작게 쪼개면 맥락이 끊기고, 너무 크게 하면 검색 정확도가 떨어져요. 적절한 밸런스가 중요합니다!
from llama_index.node_parser import SimpleNodeParser

# 노드 파서 설정
node_parser = SimpleNodeParser.from_defaults(
    chunk_size=1024,  # 청크 크기 (토큰 단위)
    chunk_overlap=20  # 청크 간 겹침 (맥락 유지)
)

service_context = ServiceContext.from_defaults(
    llm=llm,
    node_parser=node_parser
)chunk_size는 보통 512~2048 사이가 적당해요. 문서 특성에 따라 조정하면 됩니다 👌
기본 OpenAI 임베딩 말고 다른 모델도 사용할 수 있어요. 비용 절감이나 성능 향상을 위해!
from llama_index.embeddings import HuggingFaceEmbedding

# 한국어에 강한 임베딩 모델 사용
embed_model = HuggingFaceEmbedding(
    model_name="jhgan/ko-sroberta-multitask"
)

service_context = ServiceContext.from_defaults(
    llm=llm,
    embed_model=embed_model
)
한국어 문서 다룰 때는 한국어 특화 모델 쓰는 게 훨씬 좋아요! 정확도가 확 올라갑니다 🚀
문서에 메타데이터를 추가하면 검색 정확도가 더 올라가요. 날짜, 카테고리, 작성자 같은 정보들이요!
from llama_index import Document

# 메타데이터와 함께 문서 생성
documents = [
    Document(
        text="제품 A의 가격은 50,000원입니다.",
        metadata={
            "category": "가격정보",
            "product": "제품A",
            "date": "2024-01-15"
        }
    ),
    Document(
        text="제품 A는 파란색과 빨간색이 있습니다.",
        metadata={
            "category": "상품정보",
            "product": "제품A",
            "date": "2024-01-15"
        }
    )
]

index = VectorStoreIndex.from_documents(documents)

# 메타데이터 필터링과 함께 검색
from llama_index.vector_stores import MetadataFilters, ExactMatchFilter

filters = MetadataFilters(
    filters=[ExactMatchFilter(key="category", value="가격정보")]
)

query_engine = index.as_query_engine(filters=filters)
response = query_engine.query("제품 A 가격 알려줘")
이렇게 하면 특정 카테고리 문서만 검색할 수 있어서 답변 정확도가 훨씬 높아집니다! 실무에서 진짜 유용해요 💯
매번 문서 인덱싱하면 시간도 오래 걸리고 API 비용도 많이 나가요. 한 번 만든 인덱스는 저장해뒀다가 재사용하는 게 좋습니다!
# 인덱스를 디스크에 저장
index.storage_context.persist(persist_dir="./storage")

print("인덱스 저장 완료! ✅")
이렇게 하면 storage 폴더에 인덱스가 저장됩니다. 다음에 다시 쓸 수 있어요!
from llama_index import StorageContext, load_index_from_storage

# 저장된 인덱스 로드
storage_context = StorageContext.from_defaults(
    persist_dir="./storage"
)
index = load_index_from_storage(storage_context)

# 바로 사용 가능!
query_engine = index.as_query_engine()
response = query_engine.query("질문 내용")
로딩 속도가 엄청 빠르죠? 몇 초면 끝나요 ㅋㅋㅋ 이게 진짜 실전 팁입니다 🎯
이제 배운 걸 다 합쳐서 실제로 쓸 수 있는 시스템을 만들어봅시다! 회사 매뉴얼 Q&A 봇을 만들어볼게요 🤖
import os
from llama_index import (
    VectorStoreIndex,
    SimpleDirectoryReader,
    ServiceContext,
    StorageContext,
    load_index_from_storage
)
from llama_index.llms import OpenAI
from llama_index.node_parser import SimpleNodeParser
from pathlib import Path

class ManualQABot:
    def __init__(self, documents_path, storage_path="./storage"):
        self.documents_path = documents_path
        self.storage_path = storage_path
        self.index = None
        self.query_engine = None

        # OpenAI API 키 설정
        os.environ["OPENAI_API_KEY"] = "your-api-key"

        # LLM 및 서비스 컨텍스트 설정
        llm = OpenAI(model="gpt-3.5-turbo", temperature=0.1)
        node_parser = SimpleNodeParser.from_defaults(
            chunk_size=1024,
            chunk_overlap=20
        )
        self.service_context = ServiceContext.from_defaults(
            llm=llm,
            node_parser=node_parser
        )

    def build_index(self):
        """문서에서 인덱스 생성"""
        print("📚 문서 로딩 중...")
        documents = SimpleDirectoryReader(self.documents_path).load_data()
        print(f"✅ {len(documents)}개 문서 로드 완료!")

        print("🔨 인덱스 생성 중...")
        self.index = VectorStoreIndex.from_documents(
            documents,
            service_context=self.service_context
        )
        print("✅ 인덱스 생성 완료!")

        # 인덱스 저장
        self.index.storage_context.persist(persist_dir=self.storage_path)
        print(f"💾 인덱스 저장 완료: {self.storage_path}")

        self.query_engine = self.index.as_query_engine()

    def load_index(self):
        """저장된 인덱스 로드"""
        if not Path(self.storage_path).exists():
            print("❌ 저장된 인덱스가 없습니다. build_index()를 먼저 실행하세요.")
            return False

        print("📂 저장된 인덱스 로딩 중...")
        storage_context = StorageContext.from_defaults(
            persist_dir=self.storage_path
        )
        self.index = load_index_from_storage(
            storage_context,
            service_context=self.service_context
        )
        self.query_engine = self.index.as_query_engine()
        print("✅ 인덱스 로드 완료!")
        return True

    def ask(self, question):
        """질문하고 답변 받기"""
        if self.query_engine is None:
            print("❌ 인덱스가 로드되지 않았습니다.")
            return None

        print(f"\n❓ 질문: {question}")
        print("🤔 답변 생성 중...")

        response = self.query_engine.query(question)

        print(f"\n💬 답변:\n{response}\n")
        print("-" * 50)

        return response

    def chat_loop(self):
        """대화형 루프"""
        print("\n🤖 회사 매뉴얼 Q&A 봇입니다!")
        print("질문을 입력하세요. (종료: 'quit' 또는 'exit')\n")

        while True:
            question = input("👤 질문: ").strip()

            if question.lower() in ['quit', 'exit', '종료']:
                print("👋 봇을 종료합니다. 안녕히 가세요!")
                break

            if not question:
                continue

            self.ask(question)

# 사용 예제
if __name__ == "__main__":
    # 봇 초기화
    bot = ManualQABot(documents_path="./company_manuals")

    # 처음 실행: 인덱스 생성
    # bot.build_index()

    # 이후 실행: 저장된 인덱스 로드
    if bot.load_index():
        # 대화형 모드 시작
        bot.chat_loop()
    else:
        # 인덱스가 없으면 생성
        bot.build_index()
        bot.chat_loop()
와 이제 진짜 완성도 있는 시스템이 됐죠? 이 코드는 실제 회사에서 바로 쓸 수 있는 수준이에요! 🎉
• 인덱스 캐싱: 한 번 만들면 계속 재사용 가능
• 대화형 인터페이스: 사용자가 편하게 질문할 수 있어요
• 에러 처리: 예외 상황도 잘 처리됩니다
• 확장 가능: 기능 추가하기 쉬운 구조예요
실제로 운영하다 보면 성능 이슈가 생길 수 있어요. 특히 문서가 많거나 사용자가 많을 때요! 몇 가지 최적화 방법을 알려드릴게요 ⚡
문서가 많아지면 메모리 부족 문제가 생길 수 있어요. 이럴 때는 전문 벡터 데이터베이스를 사용하세요!
from llama_index.vector_stores import ChromaVectorStore
from llama_index.storage.storage_context import StorageContext
import chromadb

# Chroma DB 초기화
chroma_client = chromadb.PersistentClient(path="./chroma_db")
chroma_collection = chroma_client.get_or_create_collection("company_docs")

# 벡터 스토어 설정
vector_store = ChromaVectorStore(chroma_collection=chroma_collection)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

# 인덱스 생성 (벡터 DB 사용)
index = VectorStoreIndex.from_documents(
    documents,
    storage_context=storage_context
)
Chroma 말고도 Pinecone, Weaviate, Qdrant 같은 벡터 DB들도 있어요. 각각 장단점이 있으니 프로젝트에 맞게 선택하시면 됩니다!
답변 생성 속도를 높이는 방법들이에요:
# 1. 검색 결과 개수 제한
query_engine = index.as_query_engine(
    similarity_top_k=3  # 상위 3개만 검색 (기본값: 2)
)

# 2. 스트리밍 응답 사용
query_engine = index.as_query_engine(
    streaming=True
)
response = query_engine.query("질문")
for text in response.response_gen:
    print(text, end="", flush=True)

# 3. 더 빠른 모델 사용
llm = OpenAI(model="gpt-3.5-turbo")  # gpt-4보다 빠름
스트리밍 응답은 ChatGPT처럼 글자가 하나씩 나타나는 효과예요. 사용자 경험이 훨씬 좋아집니다 ㅎㅎ
기본 Q&A 시스템은 만들었으니 이제 더 멋진 기능들을 추가해봅시다! 실전에서 진짜 유용한 것들이에요 😎
벡터 검색과 키워드 검색을 함께 사용하면 정확도가 더 올라가요!
from llama_index.retrievers import VectorIndexRetriever, BM25Retriever
from llama_index.query_engine import RetrieverQueryEngine

# 벡터 검색 리트리버
vector_retriever = VectorIndexRetriever(
    index=index,
    similarity_top_k=5
)

# BM25 키워드 검색 리트리버
bm25_retriever = BM25Retriever.from_defaults(
    docstore=index.docstore,
    similarity_top_k=5
)

# 하이브리드 검색 엔진
from llama_index.retrievers import QueryFusionRetriever

retriever = QueryFusionRetriever(
    [vector_retriever, bm25_retriever],
    similarity_top_k=5,
    num_queries=1
)

query_engine = RetrieverQueryEngine(retriever=retriever)
이렇게 하면 의미적 유사성과 키워드 매칭을 동시에 고려해서 더 정확한 답변을 줄 수 있어요! 특히 전문 용어가 많은 문서에서 효과적입니다 🎯
이전 대화 내용을 기억하게 만들면 더 자연스러운 대화가 가능해요!
from llama_index.memory import ChatMemoryBuffer

# 메모리 버퍼 생성 (최근 10개 메시지 기억)
memory = ChatMemoryBuffer.from_defaults(token_limit=3000)

# 채팅 엔진 생성
chat_engine = index.as_chat_engine(
    chat_mode="context",
    memory=memory,
    system_prompt=(
        "당신은 회사 매뉴얼 전문가입니다. "
        "친절하고 정확하게 답변해주세요."
    )
)

# 대화하기
response1 = chat_engine.chat("제품 A의 가격이 얼마야?")
print(response1)

# 이전 대화 기억함!
response2 = chat_engine.chat("그럼 할인은 있어?")  # "제품 A"를 기억
print(response2)
와 이제 진짜 ChatGPT처럼 대화가 되죠? ㅋㅋㅋ 사용자 경험이 완전 달라집니다!
답변이 어느 문서에서 나왔는지 보여주면 신뢰도가 올라가요!
query_engine = index.as_query_engine(
    response_mode="compact",
    verbose=True
)

response = query_engine.query("제품 가격 알려줘")

# 답변 출력
print(f"답변: {response}\n")

# 소스 문서 정보 출력
print("📚 참고 문서:")
for i, node in enumerate(response.source_nodes, 1):
    print(f"\n{i}. 파일: {node.metadata.get('file_name', 'Unknown')}")
    print(f"   페이지: {node.metadata.get('page_label', 'N/A')}")
    print(f"   내용 일부: {node.text[:100]}...")
    print(f"   유사도 점수: {node.score:.3f}")
이렇게 하면 사용자가 답변을 더 신뢰할 수 있고, 필요하면 원본 문서를 직접 확인할 수도 있어요! 기업용 시스템에서는 필수 기능입니다 📋
pip install streamlit 설치하고 간단한 웹 UI 만들어보세요. 버튼 클릭하고 채팅창에서 대화하는 형태로요 ㅎㅎ
개발하다 보면 에러가 나는 건 당연해요! 자주 나오는 에러들과 해결 방법을 정리해봤습니다 🔧
증상: OpenAI API 호출 제한 초과
해결:
# 재시도 로직 추가
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=4, max=10)
)
def query_with_retry(query_engine, question):
return query_engine.query(question)해결:
• 청크 크기를 줄이세요 (1024 → 512)
• 벡터 DB 사용 (Chroma, Pinecone 등)
• 문서를 여러 개의 인덱스로 분할
• 배치 크기 조정
해결:
• 한국어 특화 임베딩 모델 사용
• 프롬프트에 "한국어로 답변해주세요" 명시
• GPT-4 같은 더 좋은 모델 사용
• 문서 전처리 시 인코딩 확인 (UTF-8)
verbose=True 옵션 켜면 내부 동작 과정이 다 보여요. 뭐가 문제인지 파악하기 쉬워집니다!
query_engine = index.as_query_engine(verbose=True)개발은 끝났고 이제 실제로 서비스해야죠? 배포 방법을 알려드릴게요! 🚀
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import uvicorn

app = FastAPI(title="문서 Q&A API")

# 봇 초기화 (전역 변수)
bot = ManualQABot(documents_path="./documents")
bot.load_index()

class Question(BaseModel):
    text: str

class Answer(BaseModel):
    answer: str
    sources: list = []

@app.post("/ask", response_model=Answer)
async def ask_question(question: Question):
    try:
        response = bot.ask(question.text)

        # 소스 정보 추출
        sources = []
        if hasattr(response, 'source_nodes'):
            for node in response.source_nodes:
                sources.append({
                    "file": node.metadata.get('file_name', 'Unknown'),
                    "score": float(node.score)
                })

        return Answer(
            answer=str(response),
            sources=sources
        )
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))

@app.get("/health")
async def health_check():
    return {"status": "healthy"}

if __name__ == "__main__":
    uvicorn.run(app, host="0.0.0.0", port=8000)
이제 http://localhost:8000/ask로 POST 요청 보내면 답변을 받을 수 있어요! Swagger UI도 자동으로 생성됩니다 (/docs 접속) 📡
배포를 쉽게 하려면 Docker 사용하는 게 좋아요!
# Dockerfile
FROM python:3.10-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

EXPOSE 8000

CMD ["python", "api.py"]
# requirements.txt
llama-index==0.9.0
openai==1.0.0
fastapi==0.104.0
uvicorn==0.24.0
pypdf==3.17.0
python-docx==1.1.0# 빌드 및 실행
docker build -t qa-bot .
docker run -p 8000:8000 -v ./documents:/app/documents qa-bot이제 어디서든 똑같은 환경으로 실행할 수 있어요! 클라우드 배포도 쉬워집니다 ☁️
AWS EC2: 가장 기본적인 방법. 서버 하나 빌려서 직접 설치
Google Cloud Run: 서버리스로 자동 스케일링. 사용한 만큼만 과금
Heroku: 간단하게 배포 가능. 소규모 프로젝트에 좋음
Azure Container Instances: 컨테이너 기반 배포. 관리 편함
개인적으로는 Cloud Run 추천해요! 설정 간단하고 비용도 저렴합니다 ㅎㅎ
- ✅ API 키는 환경 변수로 관리
- ✅ HTTPS 사용 (SSL 인증서 적용)
- ✅ Rate Limiting 설정 (남용 방지)
- ✅ 인증/인가 시스템 구현
- ✅ 로그 모니터링 설정
- ✅ 정기적인 보안 업데이트
OpenAI API 쓰다 보면 비용이 생각보다 많이 나올 수 있어요. 똑똑하게 절약하는 방법들을 알려드릴게요! 💸
쿼리 비용: 질문할 때마다 발생 (GPT 호출)
토큰 수: 입력 + 출력 토큰 합계로 계산
GPT-3.5-turbo: $0.0015 / 1K tokens (입력), $0.002 / 1K tokens (출력)
GPT-4: 약 20배 더 비쌈 (하지만 품질은 더 좋음)
from functools import lru_cache
import hashlib

class CachedQABot:
    def __init__(self):
        self.cache = {}

    def get_cache_key(self, question):
        return hashlib.md5(question.encode()).hexdigest()

    def ask(self, question):
        cache_key = self.get_cache_key(question)

        # 캐시에 있으면 바로 반환
        if cache_key in self.cache:
            print("💾 캐시에서 답변 가져옴!")
            return self.cache[cache_key]

        # 없으면 새로 생성
        response = self.query_engine.query(question)
        self.cache[cache_key] = response

        return response
같은 질문이 반복되면 API 호출 안 하고 저장된 답변을 재사용해요. 비용이 확 줄어듭니다! 🎉
from llama_index.llms import Ollama

# Ollama로 로컬 LLM 사용 (무료!)
llm = Ollama(model="llama2", request_timeout=120.0)

service_context = ServiceContext.from_defaults(
    llm=llm,
    embed_model="local"  # 로컬 임베딩 모델
)
Ollama 설치하면 Llama 2, Mistral 같은 오픈소스 모델을 로컬에서 무료로 돌릴 수 있어요! GPU 있으면 속도도 괜찮습니다 🖥️
배운 걸 활용해서 만들 수 있는 재미있는 프로젝트들을 소개할게요! 포트폴리오에도 좋고 실제로 쓸모도 있어요 😊
"내가 읽은 책 중에 생산성 관련된 내용 정리해줘" 이런 질문 가능 ㅋㅋ
활용 문서: PDF 논문, 전자책, 마크다운 노트
추가 기능: 태그 시스템, 날짜별 검색, 요약 기능
"연차 신청은 어떻게 해?" → 즉시 답변 + 관련 문서 링크
활용 문서: 인사 규정, IT 가이드, FAQ
추가 기능: 슬랙/팀즈 연동, 티켓 자동 생성
"이 챕터의 핵심 개념 3가지만 알려줘" 같은 질문으로 효율적 학습
활용 문서: 교과서 PDF, 강의 노트, 참고 자료
추가 기능: 퀴즈 생성, 요약 기능, 진도 추적
(주의: 실제 진료에는 전문가 검증 필수)
활용 문서: 진료 가이드라인, 논문, 약물 정보
추가 기능: 참고 문헌 자동 인용, 신뢰도 표시
"20만원대 노트북 추천해줘" → 조건에 맞는 상품 + 상세 설명
활용 문서: 상품 설명서, 리뷰, 스펙 시트
추가 기능: 가격 비교, 재고 확인, 구매 링크
이런 프로젝트들 만들어서 재능넷에 등록하면 수익도 낼 수 있어요! 요즘 AI 기반 서비스 수요가 엄청 많거든요 💰
LlamaIndex와 문서 기반 Q&A 시스템은 계속 발전하고 있어요. 앞으로 어떻게 변할지 살펴봅시다! 🚀
텍스트뿐만 아니라 이미지, 표, 그래프도 이해하는 시스템으로 진화 중이에요. GPT-4V 같은 비전 모델과 결합하면 가능합니다!
• 실시간 업데이트:
문서가 수정되면 자동으로 인덱스 업데이트하는 기능. 항상 최신 정보 유지 가능 ㅎㅎ
• 더 작고 빠른 모델:
Mistral 7B, Phi-2 같은 소형 모델들이 성능은 좋으면서 빠르고 저렴해지고 있어요. 로컬 실행도 쉬워집니다!
• RAG 고도화:
Retrieval-Augmented Generation 기술이 계속 발전해서 더 정확하고 신뢰할 수 있는 답변 생성 가능
• 에이전트 시스템:
단순 Q&A를 넘어서 복잡한 작업을 자동으로 수행하는 AI 에이전트로 진화 중
• Hugging Face 커뮤니티에서 최신 모델 탐색
• Reddit r/MachineLearning, r/LocalLLaMA 구독
• 오픈소스 프로젝트에 기여하면서 실력 향상
• 재능넷 같은 플랫폼에서 실전 경험 쌓기!
와 여기까지 읽으셨다면 정말 대단하세요! 👏👏👏
Python과 LlamaIndex로 문서 기반 Q&A 시스템 만드는 방법을 처음부터 끝까지 다뤄봤어요. 기본 개념부터 시작해서 실전 배포, 최적화, 고급 기능까지 정말 많은 내용을 담았네요 ㅎㅎ
처음에는 복잡해 보일 수 있지만, 하나씩 따라하다 보면 생각보다 어렵지 않아요! 중요한 건 직접 해보는 것입니다. 작은 프로젝트부터 시작해서 점점 기능을 추가해나가세요 🚀
이 기술은 정말 다양한 분야에 적용할 수 있어요. 회사 업무 자동화, 고객 서비스, 교육, 의료, 법률 등등... 가능성은 무궁무진합니다! 💡
혹시 막히는 부분이 있거나 더 배우고 싶으시다면 재능넷에서 관련 전문가들을 찾아보세요. 실전 경험이 풍부한 분들한테 배우면 훨씬 빠르게 성장할 수 있습니다 😊
여러분도 멋진 AI 시스템 만들어서 세상을 더 편리하게 만들어보세요! 화이팅입니다 🔥🔥🔥
🌟 핵심 요약 🌟
✅ LlamaIndex는 문서 기반 AI 시스템 구축을 쉽게 만들어줘요
✅ 기본 Q&A 시스템은 몇 줄의 코드로 구현 가능
✅ 청크 크기, 임베딩 모델, 벡터 DB 등으로 최적화
✅ 하이브리드 검색, 대화 기록, 소스 추적 등 고급 기능 추가 가능
✅ FastAPI + Docker로 실전 배포
✅ 캐싱과 로컬 모델로 비용 절감
✅ 다양한 실전 프로젝트에 활용 가능
✅ 계속 발전하는 분야니까 꾸준히 공부하세요!
행복한 코딩 되세요! 🎉💻✨

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.