

Ver3.0
전체 열람
Ver3.0 🚀 C++ 병렬 컴퓨팅과 OpenMP, CUDA를 활용한 고성능 계산의 모든 것
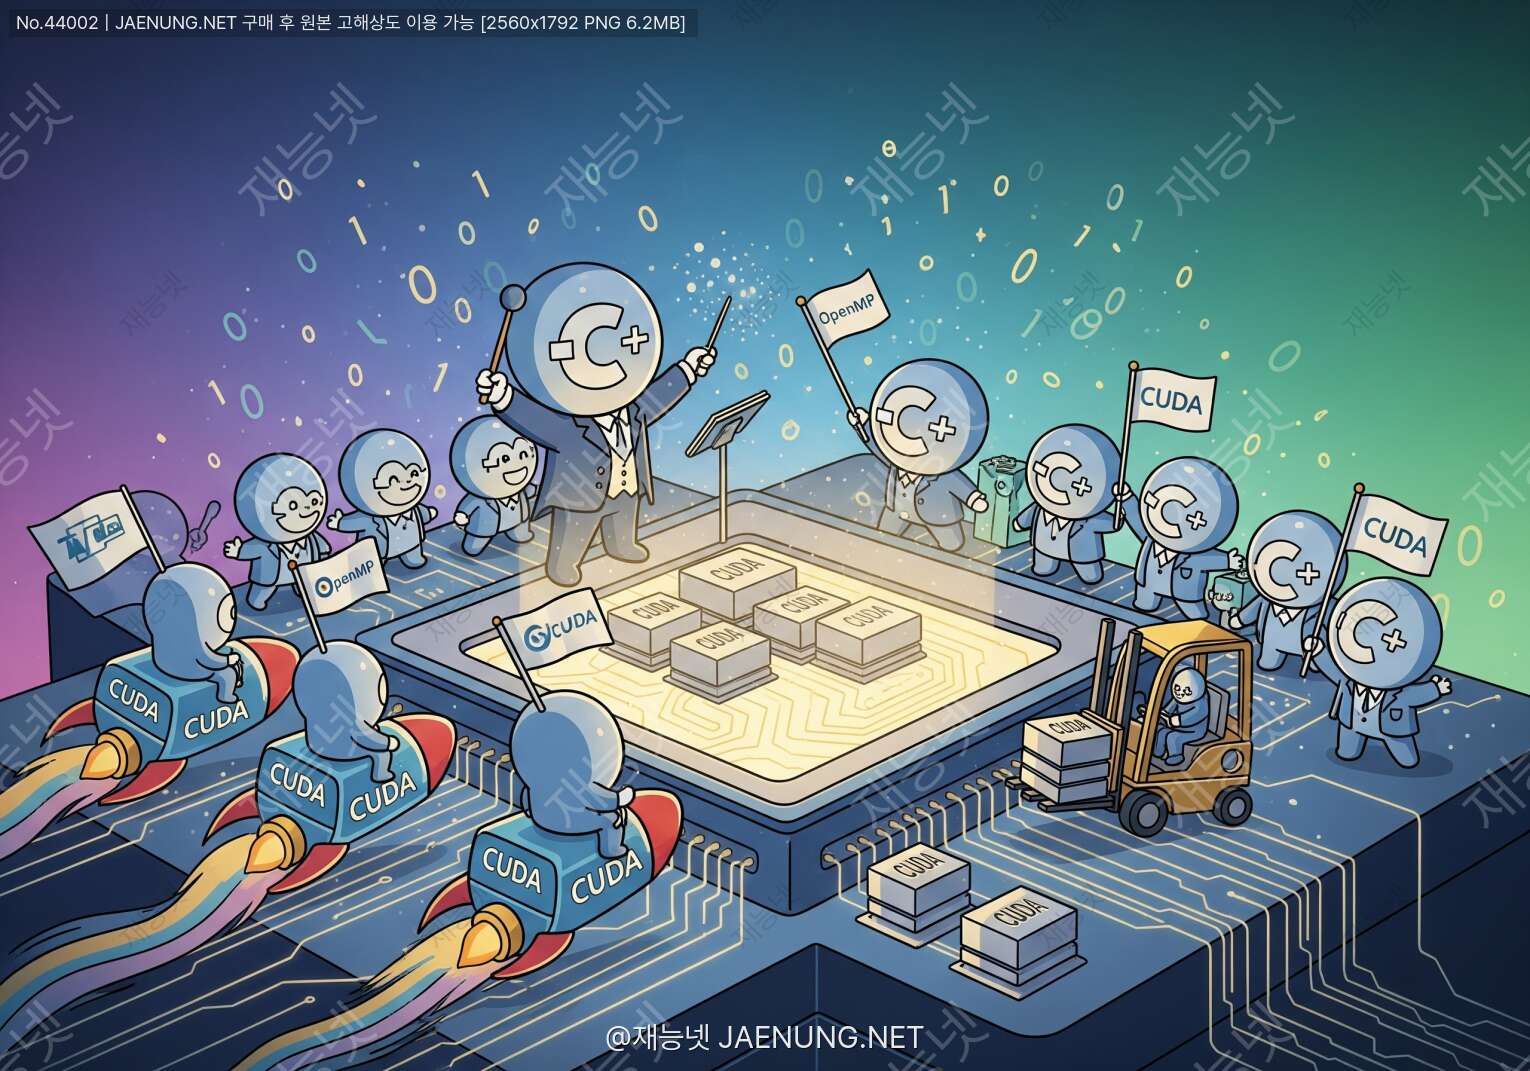
🚀 C++ 병렬 컴퓨팅과 OpenMP, CUDA를 활용한 고성능 계산의 모든 것
친구처럼 쉽게 배우는 병렬 프로그래밍의 세계 ⚡
## 🎯 왜 지금 병렬 컴퓨팅을 배워야 할까?
안녕! 오늘은 정말 흥미진진한 주제를 가지고 왔어. 바로 **C++ 병렬 컴퓨팅**이야. 혹시 프로그램이 너무 느려서 답답했던 경험 있어? 🐌
요즘 세상은 데이터가 폭발적으로 증가하고 있잖아. 인공지능, 빅데이터 분석, 게임 그래픽, 과학 시뮬레이션... 이 모든 것들이 엄청난 계산 능력을 요구해. 근데 CPU 클럭 속도는 더 이상 예전처럼 빠르게 증가하지 않아. 그래서 등장한 게 바로 **병렬 컴퓨팅**이야! 💪
요즘 세상은 데이터가 폭발적으로 증가하고 있잖아. 인공지능, 빅데이터 분석, 게임 그래픽, 과학 시뮬레이션... 이 모든 것들이 엄청난 계산 능력을 요구해. 근데 CPU 클럭 속도는 더 이상 예전처럼 빠르게 증가하지 않아. 그래서 등장한 게 바로 **병렬 컴퓨팅**이야! 💪
💡 병렬 컴퓨팅이란?
한 명이 10시간 걸릴 일을 10명이 나눠서 하면 1시간에 끝낼 수 있잖아? 컴퓨터도 마찬가지야. 하나의 작업을 여러 개의 작은 작업으로 나눠서 동시에 처리하는 거지. 이게 바로 병렬 컴퓨팅의 핵심이야!
특히 C++는 성능이 중요한 분야에서 여전히 최고의 선택이야. 게임 엔진, 금융 시스템, 과학 연구... 이런 곳에서 C++의 병렬 프로그래밍은 필수 스킬이 되었어. 그리고 **재능넷** 같은 플랫폼에서도 이런 고급 프로그래밍 기술을 가진 개발자들의 수요가 점점 늘어나고 있다고 해! 🌟
한 명이 10시간 걸릴 일을 10명이 나눠서 하면 1시간에 끝낼 수 있잖아? 컴퓨터도 마찬가지야. 하나의 작업을 여러 개의 작은 작업으로 나눠서 동시에 처리하는 거지. 이게 바로 병렬 컴퓨팅의 핵심이야!
## 🏗️ 병렬 컴퓨팅의 기초 개념
본격적으로 들어가기 전에 기본 개념부터 확실히 잡고 가자!
### 📌 동시성 vs 병렬성 많은 사람들이 헷갈려하는 부분인데, 이 둘은 완전히 다른 개념이야.
예시: 싱글 코어 CPU에서 멀티태스킹
예시: 멀티 코어 CPU에서 실제 동시 실행
### 🎭 프로세스 vs 스레드
### 📌 동시성 vs 병렬성 많은 사람들이 헷갈려하는 부분인데, 이 둘은 완전히 다른 개념이야.
🔄 동시성 (Concurrency)
여러 작업을 번갈아가며 처리하는 것. 마치 요리사 한 명이 여러 요리를 동시에 하는 것처럼, 실제로는 빠르게 전환하면서 처리해.예시: 싱글 코어 CPU에서 멀티태스킹
⚡ 병렬성 (Parallelism)
여러 작업을 정말로 동시에 처리하는 것. 요리사 여러 명이 각자 다른 요리를 동시에 만드는 거지.예시: 멀티 코어 CPU에서 실제 동시 실행
프로세스 (Process) 🏢
독립적인 실행 단위. 각자의 메모리 공간을 가지고 있어서 서로 간섭하지 않아. 하지만 생성 비용이 크고 프로세스 간 통신이 복잡해.
스레드 (Thread) 👥
프로세스 내부의 실행 단위. 같은 메모리 공간을 공유해서 데이터 교환이 쉽고 생성 비용이 적어. 하지만 동기화 문제를 조심해야 해!
독립적인 실행 단위. 각자의 메모리 공간을 가지고 있어서 서로 간섭하지 않아. 하지만 생성 비용이 크고 프로세스 간 통신이 복잡해.
스레드 (Thread) 👥
프로세스 내부의 실행 단위. 같은 메모리 공간을 공유해서 데이터 교환이 쉽고 생성 비용이 적어. 하지만 동기화 문제를 조심해야 해!
## 🔧 OpenMP: CPU 병렬 프로그래밍의 시작
자, 이제 본격적으로 코드를 만져볼 시간이야! 먼저 OpenMP부터 시작해보자. 🎉
### 🌟 OpenMP가 뭐야? OpenMP는 **Open Multi-Processing**의 약자로, C/C++/Fortran에서 멀티스레드 병렬 프로그래밍을 쉽게 할 수 있게 해주는 API야. 가장 큰 장점은 기존 코드에 몇 줄만 추가하면 병렬화가 가능하다는 거지!
### 🎨 실전 활용: 이미지 처리
이미지 처리는 병렬화의 완벽한 예시야! 각 픽셀을 독립적으로 처리할 수 있거든.
### 🌟 OpenMP가 뭐야? OpenMP는 **Open Multi-Processing**의 약자로, C/C++/Fortran에서 멀티스레드 병렬 프로그래밍을 쉽게 할 수 있게 해주는 API야. 가장 큰 장점은 기존 코드에 몇 줄만 추가하면 병렬화가 가능하다는 거지!
✨ OpenMP의 장점
• 간단한 지시문(directive)으로 병렬화 가능
• 점진적 병렬화 가능 (한 번에 전체를 바꿀 필요 없음)
• 이식성이 좋음 (대부분의 컴파일러 지원)
• 공유 메모리 시스템에 최적화
### 💻 첫 번째 OpenMP 프로그램
가장 기본적인 예제부터 시작해보자!• 간단한 지시문(directive)으로 병렬화 가능
• 점진적 병렬화 가능 (한 번에 전체를 바꿀 필요 없음)
• 이식성이 좋음 (대부분의 컴파일러 지원)
• 공유 메모리 시스템에 최적화
#include <iostream>
#include <omp.h>

int main() {
    // 병렬 영역 시작!
    #pragma omp parallel
    {
        int thread_id = omp_get_thread_num();
        int total_threads = omp_get_num_threads();

        std::cout << "안녕! 나는 스레드 " << thread_id
                  << " / 전체 " << total_threads << "개 중 하나야!"
                  << std::endl;
    }

    return 0;
}
🔍 코드 분석
#pragma omp parallel: 이 한 줄이 마법을 일으켜! 이 지시문 아래의 코드 블록이 여러 스레드에서 동시에 실행돼.
omp_get_thread_num(): 현재 스레드의 ID를 반환해 (0부터 시작)
omp_get_num_threads(): 전체 스레드 개수를 알려줘
### 🔄 실전 예제: 배열 합계 계산
이제 좀 더 실용적인 예제를 봐볼까? 큰 배열의 합계를 계산하는 프로그램이야.#pragma omp parallel: 이 한 줄이 마법을 일으켜! 이 지시문 아래의 코드 블록이 여러 스레드에서 동시에 실행돼.
omp_get_thread_num(): 현재 스레드의 ID를 반환해 (0부터 시작)
omp_get_num_threads(): 전체 스레드 개수를 알려줘
#include <iostream>
#include <vector>
#include <omp.h>
#include <chrono>

// 순차 버전
double sequential_sum(const std::vector<double>& data) {
    double sum = 0.0;
    for (size_t i = 0; i < data.size(); i++) {
        sum += data[i];
    }
    return sum;
}

// OpenMP 병렬 버전
double parallel_sum(const std::vector<double>& data) {
    double sum = 0.0;

    #pragma omp parallel for reduction(+:sum)
    for (size_t i = 0; i < data.size(); i++) {
        sum += data[i];
    }

    return sum;
}

int main() {
    const size_t N = 100000000; // 1억 개의 데이터
    std::vector<double> data(N, 1.0);

    // 순차 실행 시간 측정
    auto start = std::chrono::high_resolution_clock::now();
    double result1 = sequential_sum(data);
    auto end = std::chrono::high_resolution_clock::now();
    auto duration1 = std::chrono::duration_cast<std::chrono::milliseconds>(end - start);

    std::cout << "순차 실행 결과: " << result1 << std::endl;
    std::cout << "순차 실행 시간: " << duration1.count() << "ms" << std::endl;

    // 병렬 실행 시간 측정
    start = std::chrono::high_resolution_clock::now();
    double result2 = parallel_sum(data);
    end = std::chrono::high_resolution_clock::now();
    auto duration2 = std::chrono::duration_cast<std::chrono::milliseconds>(end - start);

    std::cout << "병렬 실행 결과: " << result2 << std::endl;
    std::cout << "병렬 실행 시간: " << duration2.count() << "ms" << std::endl;
    std::cout << "속도 향상: " << (double)duration1.count() / duration2.count() << "배!" << std::endl;

    return 0;
}
⚠️ reduction 절이 중요해!
reduction(+:sum)은 각 스레드가 자신만의 sum 변수를 가지고 계산한 후, 마지막에 모든 결과를 합쳐주는 역할을 해. 이게 없으면 여러 스레드가 동시에 같은 변수를 수정하려고 해서 결과가 엉망이 될 수 있어! 😱
### 📊 OpenMP의 주요 지시문들
OpenMP에는 다양한 지시문들이 있어. 자주 쓰이는 것들을 정리해볼게!reduction(+:sum)은 각 스레드가 자신만의 sum 변수를 가지고 계산한 후, 마지막에 모든 결과를 합쳐주는 역할을 해. 이게 없으면 여러 스레드가 동시에 같은 변수를 수정하려고 해서 결과가 엉망이 될 수 있어! 😱
| 지시문 | 설명 | 사용 예시 |
|---|---|---|
| parallel | 병렬 영역 생성 | #pragma omp parallel |
| for | 반복문 병렬화 | #pragma omp parallel for |
| sections | 서로 다른 작업을 병렬 실행 | #pragma omp sections |
| critical | 한 번에 한 스레드만 실행 | #pragma omp critical |
| atomic | 원자적 연산 보장 | #pragma omp atomic |
| barrier | 모든 스레드 동기화 | #pragma omp barrier |
| reduction | 결과 합산 | reduction(+:sum) |
#include <vector>
#include <omp.h>

struct Pixel {
    unsigned char r, g, b;
};

class Image {
private:
    std::vector<Pixel> data;
    int width, height;

public:
    Image(int w, int h) : width(w), height(h), data(w * h) {}

    // 그레이스케일 변환 (병렬 버전)
    void convertToGrayscale() {
        #pragma omp parallel for collapse(2)
        for (int y = 0; y < height; y++) {
            for (int x = 0; x < width; x++) {
                int idx = y * width + x;
                Pixel& p = data[idx];

                // 그레이스케일 공식: 0.299R + 0.587G + 0.114B
                unsigned char gray = static_cast<unsigned char>(
                    0.299 * p.r + 0.587 * p.g + 0.114 * p.b
                );

                p.r = p.g = p.b = gray;
            }
        }
    }

    // 블러 효과 (병렬 버전)
    void applyBlur(int radius) {
        std::vector<Pixel> temp = data;

        #pragma omp parallel for collapse(2)
        for (int y = radius; y < height - radius; y++) {
            for (int x = radius; x < width - radius; x++) {
                int sumR = 0, sumG = 0, sumB = 0;
                int count = 0;

                // 주변 픽셀 평균 계산
                for (int dy = -radius; dy <= radius; dy++) {
                    for (int dx = -radius; dx <= radius; dx++) {
                        int idx = (y + dy) * width + (x + dx);
                        sumR += temp[idx].r;
                        sumG += temp[idx].g;
                        sumB += temp[idx].b;
                        count++;
                    }
                }

                int idx = y * width + x;
                data[idx].r = sumR / count;
                data[idx].g = sumG / count;
                data[idx].b = sumB / count;
            }
        }
    }
};
💡 collapse(2)의 의미
collapse(2)는 중첩된 2개의 반복문을 하나의 큰 반복문으로 합쳐서 병렬화해. 이렇게 하면 더 많은 작업을 스레드들에게 고르게 분배할 수 있어서 효율이 좋아져! 🚀
collapse(2)는 중첩된 2개의 반복문을 하나의 큰 반복문으로 합쳐서 병렬화해. 이렇게 하면 더 많은 작업을 스레드들에게 고르게 분배할 수 있어서 효율이 좋아져! 🚀
## 🎮 CUDA: GPU의 강력한 힘을 활용하자!
자, 이제 진짜 강력한 무기를 꺼낼 시간이야! CUDA는 NVIDIA GPU를 활용한 병렬 컴퓨팅 플랫폼이야. CPU가 몇 개에서 수십 개의 코어를 가진다면, GPU는 **수천 개의 코어**를 가지고 있어! 🤯
### 🌈 CUDA가 특별한 이유
### 🏗️ CUDA 프로그래밍 모델 CUDA 프로그래밍의 핵심 개념들을 알아보자!
### 💻 첫 번째 CUDA 프로그램
전통적인 "Hello World"부터 시작해보자!
### 🔥 최적화 기법: Shared Memory 활용
Shared Memory를 사용하면 성능을 크게 향상시킬 수 있어! 행렬 곱셈 예제를 봐보자.
### 🌈 CUDA가 특별한 이유
GPU vs CPU: 설계 철학의 차이
CPU 🧠: 복잡한 작업을 빠르게 처리하도록 설계됨. 각 코어가 매우 강력하고 독립적으로 다양한 작업 수행 가능.
GPU 💪: 단순한 작업을 대량으로 동시에 처리하도록 설계됨. 수천 개의 작은 코어가 같은 작업을 동시에 수행.
GPU는 원래 그래픽 렌더링을 위해 만들어졌어. 화면의 수백만 개 픽셀을 동시에 계산해야 하니까! 그런데 이 구조가 과학 계산, 딥러닝, 암호화폐 채굴 등 다양한 분야에 완벽하게 맞아떨어진 거지.CPU 🧠: 복잡한 작업을 빠르게 처리하도록 설계됨. 각 코어가 매우 강력하고 독립적으로 다양한 작업 수행 가능.
GPU 💪: 단순한 작업을 대량으로 동시에 처리하도록 설계됨. 수천 개의 작은 코어가 같은 작업을 동시에 수행.
### 🏗️ CUDA 프로그래밍 모델 CUDA 프로그래밍의 핵심 개념들을 알아보자!
🏠 Host (호스트)
CPU와 시스템 메모리를 의미해. 일반적인 C++ 코드가 실행되는 곳이야.🎯 Device (디바이스)
GPU와 GPU 메모리를 의미해. CUDA 커널이 실행되는 곳이지.⚙️ Kernel (커널)
GPU에서 실행되는 함수야. 수천 개의 스레드가 동시에 실행해!🧵 Thread (스레드)
GPU에서 실행되는 가장 작은 단위. 수천~수만 개가 동시에 실행돼!#include <iostream>
#include <cuda_runtime.h>
// __global__은 이 함수가 GPU에서 실행됨을 의미해
__global__ void helloFromGPU() {
int threadId = threadIdx.x + blockIdx.x * blockDim.x;
printf("안녕! 나는 GPU 스레드 %d야!\n", threadId);
}
int main() {
std::cout << "CPU에서 시작!" << std::endl;
// 10개의 블록, 각 블록당 10개의 스레드 = 총 100개 스레드
helloFromGPU<<<10, 10>>>();
// GPU 작업이 끝날 때까지 대기
cudaDeviceSynchronize();
std::cout << "CPU에서 종료!" << std::endl;
return 0;
}
🔍 CUDA 문법 해설
__global__: GPU에서 실행되는 커널 함수 선언
<<<블록 수, 스레드 수>>>: 커널 실행 설정. 이게 CUDA의 시그니처야!
threadIdx.x: 블록 내에서의 스레드 인덱스
blockIdx.x: 그리드 내에서의 블록 인덱스
blockDim.x: 블록당 스레드 개수
### 🚀 실전 예제: 벡터 덧셈
이제 실제로 계산을 해보자! 두 개의 큰 배열을 더하는 프로그램이야.__global__: GPU에서 실행되는 커널 함수 선언
<<<블록 수, 스레드 수>>>: 커널 실행 설정. 이게 CUDA의 시그니처야!
threadIdx.x: 블록 내에서의 스레드 인덱스
blockIdx.x: 그리드 내에서의 블록 인덱스
blockDim.x: 블록당 스레드 개수
#include <iostream>
#include <cuda_runtime.h>
#include <chrono>

// CPU 버전
void vectorAddCPU(const float* a, const float* b, float* c, int n) {
    for (int i = 0; i < n; i++) {
        c[i] = a[i] + b[i];
    }
}

// GPU 커널
__global__ void vectorAddGPU(const float* a, const float* b, float* c, int n) {
    int idx = threadIdx.x + blockIdx.x * blockDim.x;

    if (idx < n) {
        c[idx] = a[idx] + b[idx];
    }
}

int main() {
    const int N = 10000000; // 1천만 개의 원소
    const int bytes = N * sizeof(float);

    // 호스트 메모리 할당
    float *h_a = new float[N];
    float *h_b = new float[N];
    float *h_c = new float[N];

    // 데이터 초기화
    for (int i = 0; i < N; i++) {
        h_a[i] = static_cast<float>(i);
        h_b[i] = static_cast<float>(i * 2);
    }

    // CPU 버전 실행 시간 측정
    auto start = std::chrono::high_resolution_clock::now();
    vectorAddCPU(h_a, h_b, h_c, N);
    auto end = std::chrono::high_resolution_clock::now();
    auto cpuTime = std::chrono::duration_cast<std::chrono::milliseconds>(end - start);

    std::cout << "CPU 실행 시간: " << cpuTime.count() << "ms" << std::endl;

    // 디바이스 메모리 할당
    float *d_a, *d_b, *d_c;
    cudaMalloc(&d_a, bytes);
    cudaMalloc(&d_b, bytes);
    cudaMalloc(&d_c, bytes);

    // GPU 버전 실행 시간 측정 (메모리 복사 포함)
    start = std::chrono::high_resolution_clock::now();

    // 호스트 → 디바이스 메모리 복사
    cudaMemcpy(d_a, h_a, bytes, cudaMemcpyHostToDevice);
    cudaMemcpy(d_b, h_b, bytes, cudaMemcpyHostToDevice);

    // 커널 실행 설정
    int threadsPerBlock = 256;
    int blocksPerGrid = (N + threadsPerBlock - 1) / threadsPerBlock;

    vectorAddGPU<<<blocksPerGrid, threadsPerBlock>>>(d_a, d_b, d_c, N);

    // 디바이스 → 호스트 메모리 복사
    cudaMemcpy(h_c, d_c, bytes, cudaMemcpyDeviceToHost);

    end = std::chrono::high_resolution_clock::now();
    auto gpuTime = std::chrono::duration_cast<std::chrono::milliseconds>(end - start);

    std::cout << "GPU 실행 시간 (메모리 복사 포함): " << gpuTime.count() << "ms" << std::endl;
    std::cout << "속도 향상: " << (double)cpuTime.count() / gpuTime.count() << "배!" << std::endl;

    // 결과 검증
    bool correct = true;
    for (int i = 0; i < N; i++) {
        if (abs(h_c[i] - (h_a[i] + h_b[i])) > 1e-5) {
            correct = false;
            break;
        }
    }
    std::cout << "결과 검증: " << (correct ? "성공! ✅" : "실패! ❌") << std::endl;

    // 메모리 해제
    delete[] h_a;
    delete[] h_b;
    delete[] h_c;
    cudaFree(d_a);
    cudaFree(d_b);
    cudaFree(d_c);

    return 0;
}
⚠️ 메모리 복사 오버헤드
GPU 프로그래밍에서 가장 중요한 것 중 하나가 바로 메모리 복사야! CPU와 GPU는 서로 다른 메모리 공간을 사용하기 때문에, 데이터를 주고받는 데 시간이 걸려. 그래서 작은 데이터는 오히려 CPU가 더 빠를 수 있어. GPU의 진가는 **대량의 데이터를 처리할 때** 발휘돼! 💡
### 🎯 CUDA 메모리 계층 구조
CUDA의 성능을 최대로 끌어내려면 메모리 구조를 이해해야 해!GPU 프로그래밍에서 가장 중요한 것 중 하나가 바로 메모리 복사야! CPU와 GPU는 서로 다른 메모리 공간을 사용하기 때문에, 데이터를 주고받는 데 시간이 걸려. 그래서 작은 데이터는 오히려 CPU가 더 빠를 수 있어. GPU의 진가는 **대량의 데이터를 처리할 때** 발휘돼! 💡
| 메모리 종류 | 범위 | 속도 | 크기 | 용도 |
|---|---|---|---|---|
| Register | 스레드 | ⚡⚡⚡⚡⚡ | 매우 작음 | 지역 변수 |
| Shared Memory | 블록 | ⚡⚡⚡⚡ | 작음 (~48KB) | 블록 내 공유 데이터 |
| Local Memory | 스레드 | ⚡⚡ | 중간 | 레지스터 오버플로우 |
| Global Memory | 전체 | ⚡ | 큼 (수GB) | 주 메모리 |
| Constant Memory | 전체 | ⚡⚡⚡ | 작음 (64KB) | 읽기 전용 상수 |
| Texture Memory | 전체 | ⚡⚡⚡ | 큼 | 공간 지역성 데이터 |
#include <cuda_runtime.h>

#define TILE_SIZE 16

// 기본 버전 (느림)
__global__ void matrixMulBasic(float* A, float* B, float* C, int N) {
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    if (row < N && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < N; k++) {
            sum += A[row * N + k] * B[k * N + col];
        }
        C[row * N + col] = sum;
    }
}

// 최적화 버전 (빠름!) - Shared Memory 사용
__global__ void matrixMulOptimized(float* A, float* B, float* C, int N) {
    // Shared Memory 선언
    __shared__ float tileA[TILE_SIZE][TILE_SIZE];
    __shared__ float tileB[TILE_SIZE][TILE_SIZE];

    int row = blockIdx.y * TILE_SIZE + threadIdx.y;
    int col = blockIdx.x * TILE_SIZE + threadIdx.x;

    float sum = 0.0f;

    // 타일 단위로 처리
    for (int t = 0; t < (N + TILE_SIZE - 1) / TILE_SIZE; t++) {
        // Global Memory → Shared Memory로 데이터 로드
        if (row < N && t * TILE_SIZE + threadIdx.x < N) {
            tileA[threadIdx.y][threadIdx.x] = A[row * N + t * TILE_SIZE + threadIdx.x];
        } else {
            tileA[threadIdx.y][threadIdx.x] = 0.0f;
        }

        if (col < N && t * TILE_SIZE + threadIdx.y < N) {
            tileB[threadIdx.y][threadIdx.x] = B[(t * TILE_SIZE + threadIdx.y) * N + col];
        } else {
            tileB[threadIdx.y][threadIdx.x] = 0.0f;
        }

        // 모든 스레드가 데이터 로드를 완료할 때까지 대기
        __syncthreads();

        // Shared Memory에서 계산 (빠름!)
        for (int k = 0; k < TILE_SIZE; k++) {
            sum += tileA[threadIdx.y][k] * tileB[k][threadIdx.x];
        }

        // 다음 타일로 넘어가기 전 동기화
        __syncthreads();
    }

    if (row < N && col < N) {
        C[row * N + col] = sum;
    }
}
✨ 왜 Shared Memory가 빠를까?
Global Memory는 GPU 칩 외부에 있어서 접근이 느려 (수백 사이클). 반면 Shared Memory는 칩 내부에 있어서 접근이 매우 빠르지 (수 사이클). 데이터를 한 번 로드해서 여러 번 사용할 때 Shared Memory를 쓰면 엄청난 속도 향상을 얻을 수 있어! 🚀
Global Memory는 GPU 칩 외부에 있어서 접근이 느려 (수백 사이클). 반면 Shared Memory는 칩 내부에 있어서 접근이 매우 빠르지 (수 사이클). 데이터를 한 번 로드해서 여러 번 사용할 때 Shared Memory를 쓰면 엄청난 속도 향상을 얻을 수 있어! 🚀
## 🎪 OpenMP vs CUDA: 언제 무엇을 써야 할까?
자, 이제 두 기술을 다 배웠으니 언제 어떤 걸 써야 할지 알아보자! 🤔
### 📊 비교표
### 🎯 선택 가이드
• 작업이 불규칙하거나 조건부 분기가 많을 때
• GPU가 없거나 이식성이 중요할 때
• 데이터 크기가 작거나 중간 정도일 때
• 빠른 프로토타이핑이 필요할 때
예시: 파일 처리, 데이터베이스 쿼리, 웹 서버
• 작업이 규칙적이고 반복적일 때
• 최고의 성능이 필요할 때
• 행렬 연산이나 이미지 처리 같은 작업
• 딥러닝, 과학 시뮬레이션 등
예시: 딥러닝, 암호화폐 채굴, 영상 처리
### 🤝 함께 사용하기
사실 가장 좋은 방법은 둘 다 사용하는 거야! CPU와 GPU를 동시에 활용하면 최고의 성능을 얻을 수 있어.
### 📊 비교표
| 특성 | OpenMP | CUDA |
|---|---|---|
| 하드웨어 | CPU (멀티코어) | NVIDIA GPU |
| 병렬화 수준 | 수십 개 스레드 | 수천~수만 개 스레드 |
| 학습 난이도 | 쉬움 ⭐⭐ | 어려움 ⭐⭐⭐⭐ |
| 코드 수정 | 최소한 (지시문만 추가) | 많음 (커널 작성 필요) |
| 메모리 관리 | 자동 (공유 메모리) | 수동 (명시적 복사) |
| 적합한 작업 | 불규칙한 병렬성 | 규칙적인 대량 병렬성 |
| 이식성 | 높음 (모든 CPU) | 낮음 (NVIDIA GPU만) |
| 성능 | 좋음 | 매우 좋음 (적합한 작업에서) |
🔵 OpenMP를 선택해야 할 때
• 기존 코드를 빠르게 병렬화하고 싶을 때• 작업이 불규칙하거나 조건부 분기가 많을 때
• GPU가 없거나 이식성이 중요할 때
• 데이터 크기가 작거나 중간 정도일 때
• 빠른 프로토타이핑이 필요할 때
예시: 파일 처리, 데이터베이스 쿼리, 웹 서버
🟢 CUDA를 선택해야 할 때
• 대량의 데이터를 처리해야 할 때• 작업이 규칙적이고 반복적일 때
• 최고의 성능이 필요할 때
• 행렬 연산이나 이미지 처리 같은 작업
• 딥러닝, 과학 시뮬레이션 등
예시: 딥러닝, 암호화폐 채굴, 영상 처리
#include <iostream>
#include <omp.h>
#include <cuda_runtime.h>

// GPU 커널
__global__ void processChunkGPU(float* data, int size) {
    int idx = threadIdx.x + blockIdx.x * blockDim.x;
    if (idx < size) {
        // GPU에서 처리할 작업
        data[idx] = data[idx] * data[idx];
    }
}

// CPU 함수
void processChunkCPU(float* data, int size) {
    #pragma omp parallel for
    for (int i = 0; i < size; i++) {
        // CPU에서 처리할 작업
        data[i] = data[i] * data[i];
    }
}

int main() {
    const int TOTAL_SIZE = 10000000;
    const int GPU_PORTION = 8000000; // 80%는 GPU에서
    const int CPU_PORTION = 2000000; // 20%는 CPU에서

    float *data = new float[TOTAL_SIZE];
    float *d_data;

    // 데이터 초기화
    for (int i = 0; i < TOTAL_SIZE; i++) {
        data[i] = static_cast<float>(i);
    }

    // GPU 메모리 할당
    cudaMalloc(&d_data, GPU_PORTION * sizeof(float));

    // CPU와 GPU 동시 실행!
    #pragma omp parallel sections
    {
        #pragma omp section
        {
            // GPU 작업
            cudaMemcpy(d_data, data, GPU_PORTION * sizeof(float),
                      cudaMemcpyHostToDevice);

            int threadsPerBlock = 256;
            int blocksPerGrid = (GPU_PORTION + threadsPerBlock - 1) / threadsPerBlock;
            processChunkGPU<<<blocksPerGrid, threadsPerBlock>>>(d_data, GPU_PORTION);

            cudaMemcpy(data, d_data, GPU_PORTION * sizeof(float),
                      cudaMemcpyDeviceToHost);
        }

        #pragma omp section
        {
            // CPU 작업
            processChunkCPU(data + GPU_PORTION, CPU_PORTION);
        }
    }

    std::cout << "CPU와 GPU가 함께 작업 완료! 🎉" << std::endl;

    // 정리
    delete[] data;
    cudaFree(d_data);

    return 0;
}
💡 하이브리드 접근법의 장점
CPU와 GPU를 동시에 활용하면 각각의 장점을 살릴 수 있어! GPU가 대량의 규칙적인 작업을 처리하는 동안, CPU는 불규칙한 작업이나 제어 로직을 담당하는 거지. 이렇게 하면 전체 시스템의 활용도를 최대화할 수 있어! 🚀
CPU와 GPU를 동시에 활용하면 각각의 장점을 살릴 수 있어! GPU가 대량의 규칙적인 작업을 처리하는 동안, CPU는 불규칙한 작업이나 제어 로직을 담당하는 거지. 이렇게 하면 전체 시스템의 활용도를 최대화할 수 있어! 🚀
## 🛠️ 실전 프로젝트: 이미지 필터링 시스템
이제 배운 걸 종합해서 실전 프로젝트를 만들어보자! 대용량 이미지에 다양한 필터를 적용하는 시스템이야. 📸
### 🎨 프로젝트 구조
### 🎨 프로젝트 구조
시스템 구성
1. 이미지 로딩: CPU에서 파일 읽기
2. 전처리: OpenMP로 병렬 처리
3. 필터 적용: CUDA로 GPU 가속
4. 후처리: OpenMP로 병렬 처리
5. 저장: CPU에서 파일 쓰기
### 💻 구현 코드
1. 이미지 로딩: CPU에서 파일 읽기
2. 전처리: OpenMP로 병렬 처리
3. 필터 적용: CUDA로 GPU 가속
4. 후처리: OpenMP로 병렬 처리
5. 저장: CPU에서 파일 쓰기
#include <iostream>
#include <vector>
#include <omp.h>
#include <cuda_runtime.h>

// 픽셀 구조체
struct Pixel {
    unsigned char r, g, b, a;
};

// CUDA 커널: 가우시안 블러
__global__ void gaussianBlurKernel(Pixel* input, Pixel* output,
                                   int width, int height, float sigma) {
    int x = blockIdx.x * blockDim.x + threadIdx.x;
    int y = blockIdx.y * blockDim.y + threadIdx.y;

    if (x >= width || y >= height) return;

    const int radius = 5;
    float sumR = 0, sumG = 0, sumB = 0, sumWeight = 0;

    for (int dy = -radius; dy <= radius; dy++) {
        for (int dx = -radius; dx <= radius; dx++) {
            int nx = x + dx;
            int ny = y + dy;

            if (nx >= 0 && nx < width && ny >= 0 && ny < height) {
                float distance = sqrtf(dx * dx + dy * dy);
                float weight = expf(-(distance * distance) / (2 * sigma * sigma));

                int idx = ny * width + nx;
                sumR += input[idx].r * weight;
                sumG += input[idx].g * weight;
                sumB += input[idx].b * weight;
                sumWeight += weight;
            }
        }
    }

    int idx = y * width + x;
    output[idx].r = static_cast<unsigned char>(sumR / sumWeight);
    output[idx].g = static_cast<unsigned char>(sumG / sumWeight);
    output[idx].b = static_cast<unsigned char>(sumB / sumWeight);
    output[idx].a = input[idx].a;
}

// CUDA 커널: 엣지 검출 (Sobel)
__global__ void sobelEdgeKernel(Pixel* input, Pixel* output,
                                int width, int height) {
    int x = blockIdx.x * blockDim.x + threadIdx.x;
    int y = blockIdx.y * blockDim.y + threadIdx.y;

    if (x >= width || y >= height || x == 0 || y == 0 ||
        x == width - 1 || y == height - 1) return;

    // Sobel 연산자
    int gx = 0, gy = 0;

    for (int dy = -1; dy <= 1; dy++) {
        for (int dx = -1; dx <= 1; dx++) {
            int idx = (y + dy) * width + (x + dx);
            int gray = (input[idx].r + input[idx].g + input[idx].b) / 3;

            // Gx 계산
            if (dx == -1) gx -= gray * (dy == 0 ? 2 : 1);
            if (dx == 1) gx += gray * (dy == 0 ? 2 : 1);

            // Gy 계산
            if (dy == -1) gy -= gray * (dx == 0 ? 2 : 1);
            if (dy == 1) gy += gray * (dx == 0 ? 2 : 1);
        }
    }

    int magnitude = static_cast<int>(sqrtf(gx * gx + gy * gy));
    magnitude = min(255, magnitude);

    int idx = y * width + x;
    output[idx].r = output[idx].g = output[idx].b = magnitude;
    output[idx].a = 255;
}

class ImageProcessor {
private:
    std::vector<Pixel> hostImage;
    Pixel *deviceInput, *deviceOutput;
    int width, height;

public:
    ImageProcessor(int w, int h) : width(w), height(h) {
        hostImage.resize(w * h);

        size_t bytes = w * h * sizeof(Pixel);
        cudaMalloc(&deviceInput, bytes);
        cudaMalloc(&deviceOutput, bytes);
    }

    ~ImageProcessor() {
        cudaFree(deviceInput);
        cudaFree(deviceOutput);
    }

    // OpenMP로 이미지 생성 (테스트용)
    void generateTestImage() {
        #pragma omp parallel for collapse(2)
        for (int y = 0; y < height; y++) {
            for (int x = 0; x < width; x++) {
                int idx = y * width + x;

                // 그라디언트 패턴
                hostImage[idx].r = (x * 255) / width;
                hostImage[idx].g = (y * 255) / height;
                hostImage[idx].b = ((x + y) * 255) / (width + height);
                hostImage[idx].a = 255;
            }
        }
        std::cout << "OpenMP로 테스트 이미지 생성 완료! ✅" << std::endl;
    }

    // CUDA로 가우시안 블러 적용
    void applyGaussianBlur(float sigma) {
        size_t bytes = width * height * sizeof(Pixel);

        // 호스트 → 디바이스
        cudaMemcpy(deviceInput, hostImage.data(), bytes, cudaMemcpyHostToDevice);

        // 커널 실행
        dim3 blockSize(16, 16);
        dim3 gridSize((width + 15) / 16, (height + 15) / 16);

        gaussianBlurKernel<<<gridSize, blockSize>>>(
            deviceInput, deviceOutput, width, height, sigma);

        // 디바이스 → 호스트
        cudaMemcpy(hostImage.data(), deviceOutput, bytes, cudaMemcpyDeviceToHost);

        std::cout << "CUDA로 가우시안 블러 적용 완료! ✅" << std::endl;
    }

    // CUDA로 엣지 검출
    void applyEdgeDetection() {
        size_t bytes = width * height * sizeof(Pixel);

        cudaMemcpy(deviceInput, hostImage.data(), bytes, cudaMemcpyHostToDevice);

        dim3 blockSize(16, 16);
        dim3 gridSize((width + 15) / 16, (height + 15) / 16);

        sobelEdgeKernel<<<gridSize, blockSize>>>(
            deviceInput, deviceOutput, width, height);

        cudaMemcpy(hostImage.data(), deviceOutput, bytes, cudaMemcpyDeviceToHost);

        std::cout << "CUDA로 엣지 검출 완료! ✅" << std::endl;
    }

    // OpenMP로 밝기 조정
    void adjustBrightness(float factor) {
        #pragma omp parallel for
        for (int i = 0; i < width * height; i++) {
            hostImage[i].r = min(255, static_cast<int>(hostImage[i].r * factor));
            hostImage[i].g = min(255, static_cast<int>(hostImage[i].g * factor));
            hostImage[i].b = min(255, static_cast<int>(hostImage[i].b * factor));
        }
        std::cout << "OpenMP로 밝기 조정 완료! ✅" << std::endl;
    }

    // OpenMP로 통계 계산
    void calculateStatistics() {
        long long sumR = 0, sumG = 0, sumB = 0;

        #pragma omp parallel for reduction(+:sumR,sumG,sumB)
        for (int i = 0; i < width * height; i++) {
            sumR += hostImage[i].r;
            sumG += hostImage[i].g;
            sumB += hostImage[i].b;
        }

        int totalPixels = width * height;
        std::cout << "평균 색상 - R: " << (sumR / totalPixels)
                  << ", G: " << (sumG / totalPixels)
                  << ", B: " << (sumB / totalPixels) << std::endl;
    }
};

int main() {
    std::cout << "🎨 고성능 이미지 처리 시스템 시작!" << std::endl;
    std::cout << "========================================" << std::endl;

    // 4K 해상도 이미지
    const int WIDTH = 3840;
    const int HEIGHT = 2160;

    ImageProcessor processor(WIDTH, HEIGHT);

    // 1단계: OpenMP로 이미지 생성
    std::cout << "\n[1단계] 이미지 생성 중..." << std::endl;
    processor.generateTestImage();

    // 2단계: OpenMP로 전처리
    std::cout << "\n[2단계] 전처리 중..." << std::endl;
    processor.adjustBrightness(1.2f);

    // 3단계: CUDA로 필터 적용
    std::cout << "\n[3단계] GPU 필터 적용 중..." << std::endl;
    processor.applyGaussianBlur(2.0f);

    // 4단계: CUDA로 엣지 검출
    std::cout << "\n[4단계] 엣지 검출 중..." << std::endl;
    processor.applyEdgeDetection();

    // 5단계: OpenMP로 통계 계산
    std::cout << "\n[5단계] 통계 계산 중..." << std::endl;
    processor.calculateStatistics();

    std::cout << "\n========================================" << std::endl;
    std::cout << "✨ 모든 처리 완료! 4K 이미지를 실시간으로 처리했어!" << std::endl;

    return 0;
}
🎯 실전 팁
이 프로젝트는 CPU와 GPU의 장점을 모두 활용해. 파일 I/O나 간단한 연산은 OpenMP로, 복잡한 필터링은 CUDA로 처리하는 거지. 실제 프로덕션 환경에서도 이런 하이브리드 접근법이 가장 효율적이야! 💪
이 프로젝트는 CPU와 GPU의 장점을 모두 활용해. 파일 I/O나 간단한 연산은 OpenMP로, 복잡한 필터링은 CUDA로 처리하는 거지. 실제 프로덕션 환경에서도 이런 하이브리드 접근법이 가장 효율적이야! 💪
## 🎓 성능 최적화 고급 기법
이제 진짜 고수가 되기 위한 최적화 기법들을 알아보자! 🚀
### ⚡ OpenMP 최적화
### ⚡ OpenMP 최적화
1. 스케줄링 전략
OpenMP는 작업을 스레드에 분배하는 다양한 방법을 제공해.
OpenMP는 작업을 스레드에 분배하는 다양한 방법을 제공해.
// static: 작업을 균등하게 미리 분배 (빠르지만 불균형 가능)
#pragma omp parallel for schedule(static)
for (int i = 0; i < N; i++) {
    // 작업 시간이 비슷할 때 좋음
}

// dynamic: 작업을 동적으로 분배 (균형 좋지만 오버헤드 있음)
#pragma omp parallel for schedule(dynamic, 10)
for (int i = 0; i < N; i++) {
    // 작업 시간이 다를 때 좋음
}

// guided: 처음엔 큰 청크, 나중엔 작은 청크
#pragma omp parallel for schedule(guided)
for (int i = 0; i < N; i++) {
    // 작업 시간이 점점 줄어들 때 좋음
}

// auto: 컴파일러가 알아서 선택
#pragma omp parallel for schedule(auto)
for (int i = 0; i < N; i++) {
    // 잘 모르겠으면 이거!
}
2. False Sharing 방지
여러 스레드가 같은 캐시 라인을 공유하면 성능이 떨어져. 이걸 방지하는 방법!
여러 스레드가 같은 캐시 라인을 공유하면 성능이 떨어져. 이걸 방지하는 방법!
// 나쁜 예: False Sharing 발생
struct BadCounter {
    int count[8]; // 모두 같은 캐시 라인에 있을 수 있음
};

BadCounter counter;
#pragma omp parallel for
for (int i = 0; i < 8; i++) {
    for (int j = 0; j < 1000000; j++) {
        counter.count[i]++; // 캐시 라인 경쟁!
    }
}

// 좋은 예: 패딩으로 캐시 라인 분리
struct GoodCounter {
    alignas(64) int count; // 64바이트 정렬 (캐시 라인 크기)
};

GoodCounter counters[8];
#pragma omp parallel for
for (int i = 0; i < 8; i++) {
    for (int j = 0; j < 1000000; j++) {
        counters[i].count++; // 각자 다른 캐시 라인!
    }
}
1. 메모리 접근 패턴 최적화
연속적인 메모리 접근이 핵심이야! (Coalesced Access)
연속적인 메모리 접근이 핵심이야! (Coalesced Access)
// 나쁜 예: 비연속적 접근
__global__ void badMemoryAccess(float* data, int width, int height) {
    int x = blockIdx.x * blockDim.x + threadIdx.x;
    int y = blockIdx.y * blockDim.y + threadIdx.y;

    // 열 우선 접근 - 느림!
    int idx = x * height + y;
    data[idx] = data[idx] * 2.0f;
}

// 좋은 예: 연속적 접근
__global__ void goodMemoryAccess(float* data, int width, int height) {
    int x = blockIdx.x * blockDim.x + threadIdx.x;
    int y = blockIdx.y * blockDim.y + threadIdx.y;

    // 행 우선 접근 - 빠름!
    int idx = y * width + x;
    data[idx] = data[idx] * 2.0f;
}
2. 스트림을 활용한 비동기 실행
여러 작업을 동시에 실행해서 GPU 활용도를 높이자!
여러 작업을 동시에 실행해서 GPU 활용도를 높이자!
#include <cuda_runtime.h>

void processWithStreams(float* h_data, int totalSize) {
    const int NUM_STREAMS = 4;
    const int chunkSize = totalSize / NUM_STREAMS;

    cudaStream_t streams[NUM_STREAMS];
    float *d_data[NUM_STREAMS];

    // 스트림 생성
    for (int i = 0; i < NUM_STREAMS; i++) {
        cudaStreamCreate(&streams[i]);
        cudaMalloc(&d_data[i], chunkSize * sizeof(float));
    }

    // 비동기 실행 - 모든 스트림이 동시에 작동!
    for (int i = 0; i < NUM_STREAMS; i++) {
        int offset = i * chunkSize;

        // 비동기 메모리 복사
        cudaMemcpyAsync(d_data[i], h_data + offset,
                       chunkSize * sizeof(float),
                       cudaMemcpyHostToDevice, streams[i]);

        // 비동기 커널 실행
        int threadsPerBlock = 256;
        int blocksPerGrid = (chunkSize + threadsPerBlock - 1) / threadsPerBlock;
        processKernel<<<blocksPerGrid, threadsPerBlock, 0, streams[i]>>>(
            d_data[i], chunkSize);

        // 비동기 메모리 복사
        cudaMemcpyAsync(h_data + offset, d_data[i],
                       chunkSize * sizeof(float),
                       cudaMemcpyDeviceToHost, streams[i]);
    }

    // 모든 스트림 완료 대기
    for (int i = 0; i < NUM_STREAMS; i++) {
        cudaStreamSynchronize(streams[i]);
        cudaStreamDestroy(streams[i]);
        cudaFree(d_data[i]);
    }
}
⚠️ 성능 측정의 중요성
최적화는 반드시 측정과 함께 해야 해! 추측만으로는 안 돼. CUDA에는 nvprof나 Nsight 같은 훌륭한 프로파일링 도구들이 있어. 이걸 사용해서 병목 지점을 찾고, 최적화하고, 다시 측정하는 과정을 반복해야 해! 📊
### 🎯 실전 벤치마킹
최적화는 반드시 측정과 함께 해야 해! 추측만으로는 안 돼. CUDA에는 nvprof나 Nsight 같은 훌륭한 프로파일링 도구들이 있어. 이걸 사용해서 병목 지점을 찾고, 최적화하고, 다시 측정하는 과정을 반복해야 해! 📊
#include <iostream>
#include <chrono>
#include <cuda_runtime.h>

class PerformanceTimer {
private:
    std::chrono::high_resolution_clock::time_point start;
    std::string name;

public:
    PerformanceTimer(const std::string& n) : name(n) {
        start = std::chrono::high_resolution_clock::now();
    }

    ~PerformanceTimer() {
        auto end = std::chrono::high_resolution_clock::now();
        auto duration = std::chrono::duration_cast<std::chrono::microseconds>(end - start);
        std::cout << name << ": " << duration.count() / 1000.0 << "ms" << std::endl;
    }
};

class CUDATimer {
private:
    cudaEvent_t start, stop;
    std::string name;

public:
    CUDATimer(const std::string& n) : name(n) {
        cudaEventCreate(&start);
        cudaEventCreate(&stop);
        cudaEventRecord(start);
    }

    ~CUDATimer() {
        cudaEventRecord(stop);
        cudaEventSynchronize(stop);

        float milliseconds = 0;
        cudaEventElapsedTime(&milliseconds, start, stop);
        std::cout << name << ": " << milliseconds << "ms" << std::endl;

        cudaEventDestroy(start);
        cudaEventDestroy(stop);
    }
};

// 사용 예시
void benchmarkExample() {
    const int N = 10000000;
    float *data = new float[N];

    {
        PerformanceTimer timer("CPU 초기화");
        #pragma omp parallel for
        for (int i = 0; i < N; i++) {
            data[i] = static_cast<float>(i);
        }
    }

    float *d_data;
    cudaMalloc(&d_data, N * sizeof(float));

    {
        CUDATimer timer("GPU 메모리 복사");
        cudaMemcpy(d_data, data, N * sizeof(float), cudaMemcpyHostToDevice);
    }

    {
        CUDATimer timer("GPU 커널 실행");
        int threadsPerBlock = 256;
        int blocksPerGrid = (N + threadsPerBlock - 1) / threadsPerBlock;
        processKernel<<<blocksPerGrid, threadsPerBlock>>>(d_data, N);
    }

    delete[] data;
    cudaFree(d_data);
}
## 🌟 실무에서의 활용 사례
이론만 배우면 재미없잖아? 실제로 어디에 쓰이는지 알아보자! 🎪
### 🎮 게임 개발
### 💰 금융 공학
### 🎮 게임 개발
물리 시뮬레이션
최신 게임들은 수천 개의 물체가 상호작용해. 이걸 실시간으로 계산하려면 병렬 컴퓨팅이 필수야!
최신 게임들은 수천 개의 물체가 상호작용해. 이걸 실시간으로 계산하려면 병렬 컴퓨팅이 필수야!
// 간단한 파티클 시스템
struct Particle {
    float x, y, z;      // 위치
    float vx, vy, vz;   // 속도
    float mass;         // 질량
};

__global__ void updateParticles(Particle* particles, int count, float dt) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx >= count) return;

    Particle& p = particles[idx];

    // 중력 적용
    p.vy -= 9.8f * dt;

    // 위치 업데이트
    p.x += p.vx * dt;
    p.y += p.vy * dt;
    p.z += p.vz * dt;

    // 바닥 충돌
    if (p.y < 0.0f) {
        p.y = 0.0f;
        p.vy = -p.vy * 0.8f; // 반발 계수
    }
}

// 수만 개의 파티클을 실시간으로 처리!
void simulateParticles(Particle* d_particles, int count) {
    int threadsPerBlock = 256;
    int blocksPerGrid = (count + threadsPerBlock - 1) / threadsPerBlock;

    updateParticles<<<blocksPerGrid, threadsPerBlock>>>(
        d_particles, count, 0.016f); // 60 FPS
}
분자 동역학 시뮬레이션
신약 개발이나 재료 과학에서 수백만 개의 원자 상호작용을 계산해야 해.
신약 개발이나 재료 과학에서 수백만 개의 원자 상호작용을 계산해야 해.
__global__ void calculateForces(float3* positions, float3* forces,
                               int numAtoms) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i >= numAtoms) return;

    float3 force = make_float3(0.0f, 0.0f, 0.0f);
    float3 pos_i = positions[i];

    // 모든 다른 원자와의 상호작용 계산
    for (int j = 0; j < numAtoms; j++) {
        if (i == j) continue;

        float3 pos_j = positions[j];
        float3 r = make_float3(
            pos_j.x - pos_i.x,
            pos_j.y - pos_i.y,
            pos_j.z - pos_i.z
        );

        float dist = sqrtf(r.x*r.x + r.y*r.y + r.z*r.z);

        if (dist < 10.0f && dist > 0.1f) {
            // Lennard-Jones 포텐셜
            float sigma = 1.0f;
            float epsilon = 1.0f;
            float s6 = powf(sigma / dist, 6);
            float s12 = s6 * s6;

            float f_magnitude = 24.0f * epsilon * (2.0f * s12 - s6) / dist;

            force.x += f_magnitude * r.x / dist;
            force.y += f_magnitude * r.y / dist;
            force.z += f_magnitude * r.z / dist;
        }
    }

    forces[i] = force;
}
행렬 연산 가속
딥러닝의 핵심은 거대한 행렬 곱셈이야. CUDA가 없었다면 현대 AI는 불가능했을 거야!
실제로 PyTorch나 TensorFlow 같은 프레임워크들은 내부적으로 CUDA를 사용해. 그래서 GPU가 있으면 학습 속도가 10배~100배 빨라지는 거지! 🚀딥러닝의 핵심은 거대한 행렬 곱셈이야. CUDA가 없었다면 현대 AI는 불가능했을 거야!
### 💰 금융 공학
몬테카를로 시뮬레이션
옵션 가격 계산이나 리스크 분석에서 수백만 번의 시뮬레이션을 돌려야 해.
옵션 가격 계산이나 리스크 분석에서 수백만 번의 시뮬레이션을 돌려야 해.
__global__ void monteCarloOption(float* results, float S0, float K,
                                 float r, float sigma, float T,
                                 int numPaths, unsigned int seed) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx >= numPaths) return;

    // 각 스레드마다 다른 난수 시드
    curandState state;
    curand_init(seed, idx, 0, &state);

    // 주가 경로 시뮬레이션
    float S = S0;
    int steps = 252; // 1년 = 252 거래일
    float dt = T / steps;

    for (int i = 0; i < steps; i++) {
        float z = curand_normal(&state);
        S *= expf((r - 0.5f * sigma * sigma) * dt + sigma * sqrtf(dt) * z);
    }

    // 콜 옵션 페이오프
    results[idx] = fmaxf(S - K, 0.0f) * expf(-r * T);
}

// 수백만 개의 시나리오를 몇 초 만에 계산!
💼 재능넷에서의 기회
이런 고급 기술을 가진 개발자는 정말 귀해! **재능넷** 같은 플랫폼에서 병렬 컴퓨팅 전문가로 활동하면, 게임 개발, 과학 연구, 금융 분석 등 다양한 분야의 프로젝트를 받을 수 있어. 특히 CUDA 최적화 같은 전문 기술은 높은 가치를 인정받을 수 있지! 💎
이런 고급 기술을 가진 개발자는 정말 귀해! **재능넷** 같은 플랫폼에서 병렬 컴퓨팅 전문가로 활동하면, 게임 개발, 과학 연구, 금융 분석 등 다양한 분야의 프로젝트를 받을 수 있어. 특히 CUDA 최적화 같은 전문 기술은 높은 가치를 인정받을 수 있지! 💎
## 🎓 학습 로드맵과 추천 자료
자, 이제 어떻게 공부해야 할지 알려줄게! 📚
### 🗺️ 단계별 학습 경로
### 💻 실습 프로젝트 아이디어
• 배열 정렬 알고리즘
• 간단한 수학 연산 (행렬 덧셈)
• 파일 데이터 병렬 처리
• 행렬 곱셈 최적화
• 파티클 시스템
• 레이 트레이싱 기초
• 물리 시뮬레이션 엔진
• 실시간 비디오 처리
• 분자 동역학 시뮬레이션
• 게임 엔진 물리 시스템
• 금융 리스크 분석 도구
• 과학 시뮬레이션 플랫폼
### 🗺️ 단계별 학습 경로
초급 (1-2개월)
✅ C++ 기초 문법 완벽히 익히기
✅ 멀티스레딩 개념 이해
✅ OpenMP 기본 지시문 연습
✅ 간단한 병렬 프로그램 작성
중급 (3-4개월)
✅ OpenMP 고급 기능 (스케줄링, reduction 등)
✅ CUDA 프로그래밍 모델 이해
✅ 기본 CUDA 커널 작성
✅ 메모리 관리 익히기
✅ 성능 측정 및 프로파일링
고급 (6개월 이상)
✅ CUDA 메모리 최적화
✅ Shared Memory, Constant Memory 활용
✅ 스트림과 비동기 실행
✅ 다중 GPU 프로그래밍
✅ 실전 프로젝트 경험
### 📖 추천 학습 자료
✅ C++ 기초 문법 완벽히 익히기
✅ 멀티스레딩 개념 이해
✅ OpenMP 기본 지시문 연습
✅ 간단한 병렬 프로그램 작성
중급 (3-4개월)
✅ OpenMP 고급 기능 (스케줄링, reduction 등)
✅ CUDA 프로그래밍 모델 이해
✅ 기본 CUDA 커널 작성
✅ 메모리 관리 익히기
✅ 성능 측정 및 프로파일링
고급 (6개월 이상)
✅ CUDA 메모리 최적화
✅ Shared Memory, Constant Memory 활용
✅ 스트림과 비동기 실행
✅ 다중 GPU 프로그래밍
✅ 실전 프로젝트 경험
| 분야 | 자료 | 난이도 |
|---|---|---|
| OpenMP | OpenMP 공식 문서 | ⭐⭐ |
| OpenMP | "Using OpenMP" by Chapman et al. | ⭐⭐⭐ |
| CUDA | NVIDIA CUDA C Programming Guide | ⭐⭐⭐ |
| CUDA | "Programming Massively Parallel Processors" | ⭐⭐⭐⭐ |
| 병렬 알고리즘 | "Parallel Programming in C with MPI and OpenMP" | ⭐⭐⭐⭐ |
| 실전 | NVIDIA Developer Blog | ⭐⭐⭐ |
🎨 초급 프로젝트
• 이미지 필터 (그레이스케일, 블러)• 배열 정렬 알고리즘
• 간단한 수학 연산 (행렬 덧셈)
• 파일 데이터 병렬 처리
🚀 중급 프로젝트
• 이미지 컨볼루션• 행렬 곱셈 최적화
• 파티클 시스템
• 레이 트레이싱 기초
🔥 고급 프로젝트
• 딥러닝 레이어 구현• 물리 시뮬레이션 엔진
• 실시간 비디오 처리
• 분자 동역학 시뮬레이션
💎 전문가 프로젝트
• 커스텀 딥러닝 프레임워크• 게임 엔진 물리 시스템
• 금융 리스크 분석 도구
• 과학 시뮬레이션 플랫폼
## 🐛 자주 하는 실수와 해결법
실전에서 자주 마주치는 문제들을 정리해봤어! 🔧
### ❌ OpenMP 실수들
### ❌ OpenMP 실수들
1. 레이스 컨디션 (Race Condition)
여러 스레드가 동시에 같은 변수를 수정하려고 할 때 발생해.
여러 스레드가 동시에 같은 변수를 수정하려고 할 때 발생해.
// 잘못된 코드
int sum = 0;
#pragma omp parallel for
for (int i = 0; i < 1000; i++) {
    sum += i; // 레이스 컨디션! 결과가 매번 달라져
}

// 올바른 코드 1: reduction 사용
int sum = 0;
#pragma omp parallel for reduction(+:sum)
for (int i = 0; i < 1000; i++) {
    sum += i; // 안전!
}

// 올바른 코드 2: critical 사용 (느림)
int sum = 0;
#pragma omp parallel for
for (int i = 0; i < 1000; i++) {
    #pragma omp critical
    {
        sum += i; // 안전하지만 느림
    }
}

// 올바른 코드 3: atomic 사용 (빠름)
int sum = 0;
#pragma omp parallel for
for (int i = 0; i < 1000; i++) {
    #pragma omp atomic
    sum += i; // 안전하고 빠름
}
2. 데이터 의존성 무시
반복문의 각 반복이 독립적이지 않으면 병렬화하면 안 돼!
반복문의 각 반복이 독립적이지 않으면 병렬화하면 안 돼!
// 잘못된 코드 - 데이터 의존성 있음
#pragma omp parallel for
for (int i = 1; i < N; i++) {
    array[i] = array[i-1] + 1; // i번째가 i-1번째에 의존!
}

// 이런 경우는 병렬화할 수 없어. 순차적으로 실행해야 해.
1. 메모리 누수
GPU 메모리를 할당하고 해제하지 않으면 메모리가 부족해져!
GPU 메모리를 할당하고 해제하지 않으면 메모리가 부족해져!
// 잘못된 코드
void badFunction() {
    float *d_data;
    cudaMalloc(&d_data, 1000 * sizeof(float));
    // ... 작업 ...
    // cudaFree를 안 함! 메모리 누수!
}

// 올바른 코드 - RAII 패턴 사용
class CUDAMemory {
private:
    void* ptr;
    size_t size;

public:
    CUDAMemory(size_t s) : size(s) {
        cudaMalloc(&ptr, size);
    }

    ~CUDAMemory() {
        cudaFree(ptr); // 자동으로 해제!
    }

    void* get() { return ptr; }
};

void goodFunction() {
    CUDAMemory mem(1000 * sizeof(float));
    // ... 작업 ...
    // 자동으로 해제됨!
}
2. 커널 실행 오류 무시
CUDA 커널은 비동기로 실행되기 때문에 오류를 확인하지 않으면 디버깅이 어려워!
CUDA 커널은 비동기로 실행되기 때문에 오류를 확인하지 않으면 디버깅이 어려워!
// 잘못된 코드
myKernel<<<blocks, threads>>>(data);
// 오류 확인 안 함!

// 올바른 코드
myKernel<<<blocks, threads>>>(data);

// 커널 실행 오류 확인
cudaError_t err = cudaGetLastError();
if (err != cudaSuccess) {
    std::cerr << "커널 실행 오류: " << cudaGetErrorString(err) << std::endl;
}

// 커널 완료 대기 및 오류 확인
err = cudaDeviceSynchronize();
if (err != cudaSuccess) {
    std::cerr << "커널 동기화 오류: " << cudaGetErrorString(err) << std::endl;
}
3. 스레드 인덱스 범위 체크 누락
배열 크기가 블록 크기의 배수가 아니면 범위를 벗어날 수 있어!
배열 크기가 블록 크기의 배수가 아니면 범위를 벗어날 수 있어!
// 잘못된 코드
__global__ void badKernel(float* data, int N) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    data[idx] = idx; // N을 초과할 수 있음!
}

// 올바른 코드
__global__ void goodKernel(float* data, int N) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < N) { // 범위 체크!
        data[idx] = idx;
    }
}
OpenMP 디버깅
• 환경 변수 OMP_NUM_THREADS=1로 설정해서 순차 실행으로 테스트
• -g 플래그로 디버그 정보 포함
• Valgrind나 Thread Sanitizer 사용
• 작은 데이터로 먼저 테스트
CUDA 디버깅
• cuda-memcheck로 메모리 오류 검사
• printf를 커널 안에서 사용 가능 (디바이스 코드에서도!)
• cuda-gdb로 커널 디버깅
• Nsight Systems/Compute로 프로파일링
• 작은 그리드/블록 크기로 먼저 테스트
• 환경 변수 OMP_NUM_THREADS=1로 설정해서 순차 실행으로 테스트
• -g 플래그로 디버그 정보 포함
• Valgrind나 Thread Sanitizer 사용
• 작은 데이터로 먼저 테스트
CUDA 디버깅
• cuda-memcheck로 메모리 오류 검사
• printf를 커널 안에서 사용 가능 (디바이스 코드에서도!)
• cuda-gdb로 커널 디버깅
• Nsight Systems/Compute로 프로파일링
• 작은 그리드/블록 크기로 먼저 테스트
## 🎯 마무리하며
와! 여기까지 왔다니 정말 대단해! 🎉
우리가 함께 배운 내용을 정리해보자:
• **다중 GPU 프로그래밍**: 여러 GPU를 동시에 활용
• **분산 컴퓨팅**: MPI를 사용한 클러스터 프로그래밍
• **이기종 컴퓨팅**: CPU, GPU, FPGA를 함께 활용
• **최신 기술**: CUDA Graphs, Cooperative Groups 등
• **AI 프레임워크**: PyTorch, TensorFlow의 내부 구조 이해
### 💪 실력 향상을 위한 조언
그리고 이런 기술을 가진 개발자는 정말 귀해. 게임 회사, 연구소, 금융 회사, AI 스타트업... 어디서든 환영받을 거야. 앞서 말했듯이 **재능넷** 같은 플랫폼에서도 이런 전문 기술은 높은 가치를 인정받을 수 있어!
자, 이제 당신 차례야! 오늘 배운 내용을 바탕으로 첫 번째 병렬 프로그램을 만들어봐. 작은 것부터 시작해서 점점 발전시켜 나가면 돼. 화이팅! 💪🚀
우리가 함께 배운 내용을 정리해보자:
✨ 핵심 요약
1. 병렬 컴퓨팅의 기초
• 동시성 vs 병렬성의 차이
• 프로세스와 스레드
• 병렬화가 가능한 작업의 특징
2. OpenMP
• CPU 멀티코어 활용
• 간단한 지시문으로 병렬화
• 점진적 최적화 가능
• 불규칙한 작업에 적합
3. CUDA
• GPU의 수천 개 코어 활용
• 대량의 규칙적인 작업에 최적
• 메모리 계층 이해가 중요
• 최대 100배 이상의 속도 향상 가능
4. 실전 활용
• 게임, 과학, 금융, AI 등 다양한 분야
• CPU와 GPU를 함께 활용하는 하이브리드 접근
• 성능 측정과 최적화의 중요성
### 🚀 다음 단계
병렬 컴퓨팅은 계속 발전하고 있어. 앞으로 배워볼 만한 것들:1. 병렬 컴퓨팅의 기초
• 동시성 vs 병렬성의 차이
• 프로세스와 스레드
• 병렬화가 가능한 작업의 특징
2. OpenMP
• CPU 멀티코어 활용
• 간단한 지시문으로 병렬화
• 점진적 최적화 가능
• 불규칙한 작업에 적합
3. CUDA
• GPU의 수천 개 코어 활용
• 대량의 규칙적인 작업에 최적
• 메모리 계층 이해가 중요
• 최대 100배 이상의 속도 향상 가능
4. 실전 활용
• 게임, 과학, 금융, AI 등 다양한 분야
• CPU와 GPU를 함께 활용하는 하이브리드 접근
• 성능 측정과 최적화의 중요성
• **다중 GPU 프로그래밍**: 여러 GPU를 동시에 활용
• **분산 컴퓨팅**: MPI를 사용한 클러스터 프로그래밍
• **이기종 컴퓨팅**: CPU, GPU, FPGA를 함께 활용
• **최신 기술**: CUDA Graphs, Cooperative Groups 등
• **AI 프레임워크**: PyTorch, TensorFlow의 내부 구조 이해
### 💪 실력 향상을 위한 조언
1. 꾸준히 연습하기
매일 조금씩이라도 코드를 작성해봐. 작은 프로젝트부터 시작해서 점점 복잡한 것으로!
2. 성능 측정 습관화
항상 측정하고, 분석하고, 최적화하는 습관을 들여. 추측이 아닌 데이터로 판단해!
3. 커뮤니티 활용
NVIDIA Developer Forums, Stack Overflow, GitHub 등에서 다른 개발자들과 소통해!
4. 실전 프로젝트 경험
이론만으로는 부족해. 실제 문제를 해결하면서 배우는 게 가장 빠르지!
5. 최신 트렌드 팔로우
GPU 기술은 빠르게 발전해. NVIDIA GTC 같은 컨퍼런스 영상을 보면서 최신 기술을 익혀!
### 🌈 마지막 한마디
병렬 컴퓨팅은 처음엔 어렵게 느껴질 수 있어. 하지만 한 번 익숙해지면 정말 강력한 도구가 돼. 순차 프로그램이 몇 시간 걸리던 작업을 몇 초 만에 끝낼 수 있다는 건 정말 짜릿한 경험이야! ⚡매일 조금씩이라도 코드를 작성해봐. 작은 프로젝트부터 시작해서 점점 복잡한 것으로!
2. 성능 측정 습관화
항상 측정하고, 분석하고, 최적화하는 습관을 들여. 추측이 아닌 데이터로 판단해!
3. 커뮤니티 활용
NVIDIA Developer Forums, Stack Overflow, GitHub 등에서 다른 개발자들과 소통해!
4. 실전 프로젝트 경험
이론만으로는 부족해. 실제 문제를 해결하면서 배우는 게 가장 빠르지!
5. 최신 트렌드 팔로우
GPU 기술은 빠르게 발전해. NVIDIA GTC 같은 컨퍼런스 영상을 보면서 최신 기술을 익혀!
그리고 이런 기술을 가진 개발자는 정말 귀해. 게임 회사, 연구소, 금융 회사, AI 스타트업... 어디서든 환영받을 거야. 앞서 말했듯이 **재능넷** 같은 플랫폼에서도 이런 전문 기술은 높은 가치를 인정받을 수 있어!
자, 이제 당신 차례야! 오늘 배운 내용을 바탕으로 첫 번째 병렬 프로그램을 만들어봐. 작은 것부터 시작해서 점점 발전시켜 나가면 돼. 화이팅! 💪🚀
🎓 당신은 이제 병렬 컴퓨팅의 세계로 첫 발을 내디뎠어!
계속 배우고, 실험하고, 성장하자! 🌟
계속 배우고, 실험하고, 성장하자! 🌟
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.





댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.