
Ver2.5 Go 언어 프로파일링, pprof로 CPU와 메모리 병목 현상 정복하기 🚀
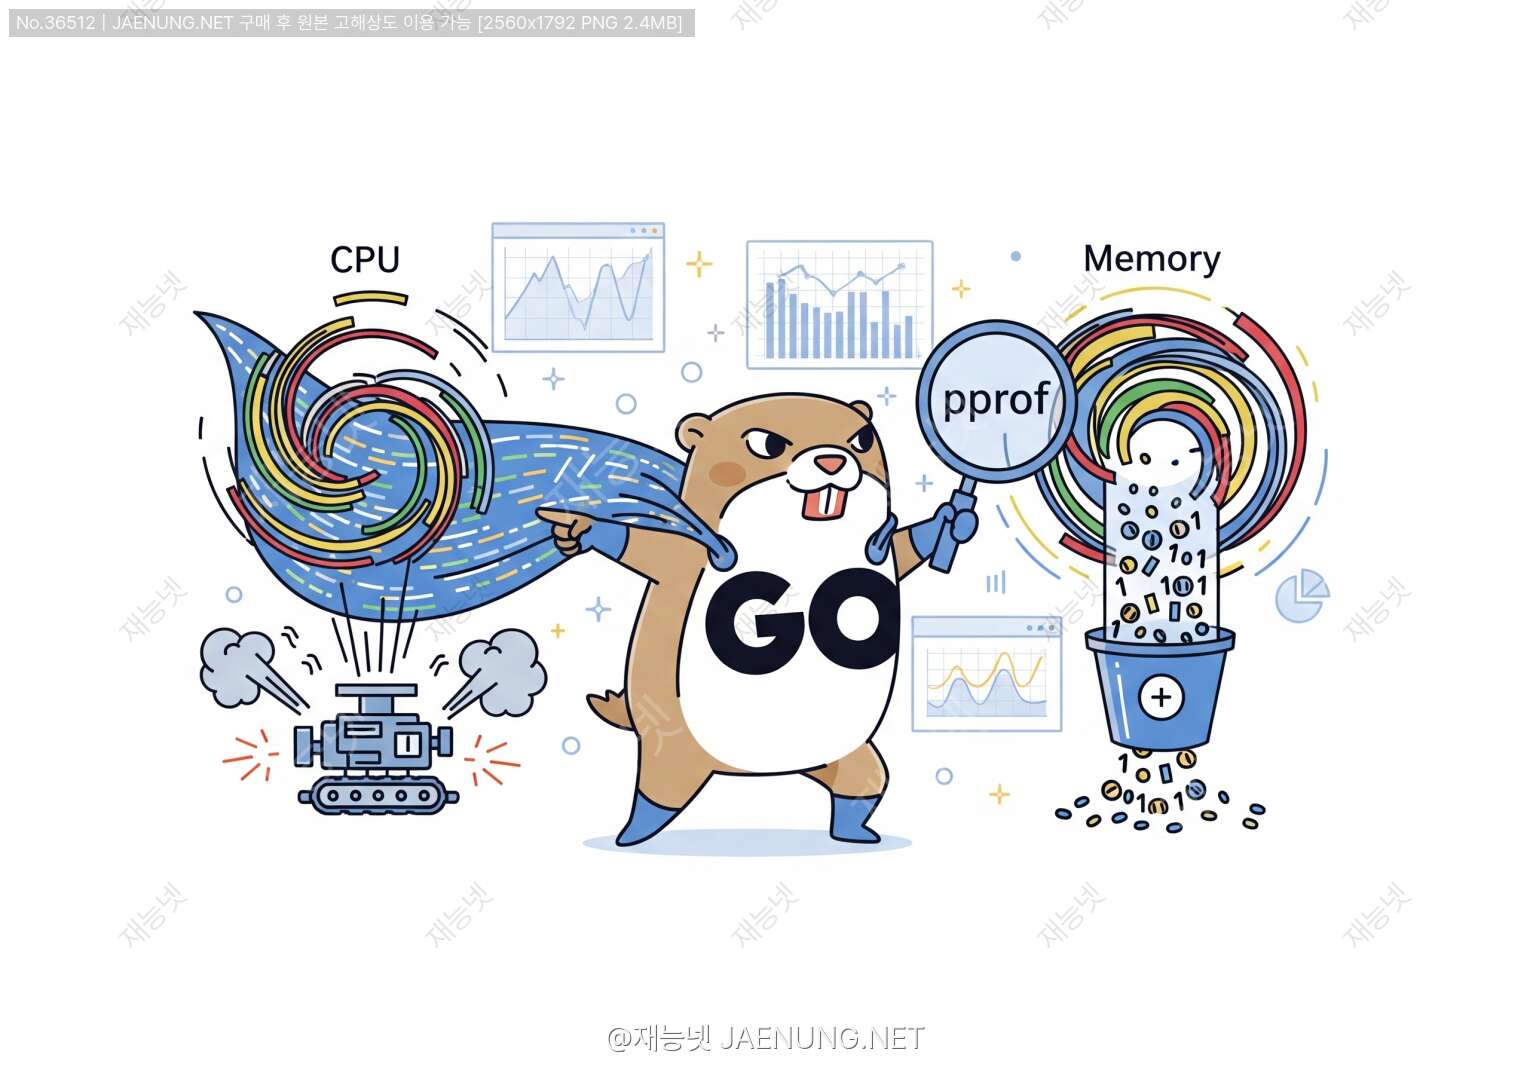
Go 언어 프로파일링, pprof로 CPU와 메모리 병목 현상 정복하기 🚀
내 코드가 왜 느린지, 메모리는 누가 다 먹는지!
더 이상 감으로 추측하지 말고 데이터로 직접 확인하고 해결해봐요!
안녕, 우리 개발자 동지! 👋
혹시 이런 경험 없어? 내가 밤새워 만든 Go 애플리케이션이 어느 날부터인가 시름시름 앓기 시작하는 거야.
분명 로컬에서는 날아다녔는데, 서버에만 올리면 CPU는 100%를 찍고 메모리는 미친 듯이 치솟고... 😱
이럴 때 우리는 보통 '개발자의 감'이라는 초능력(?)에 의존하곤 해.
"아마 이 부분이 문제일 거야", "이 함수가 좀 무거워 보이는데?" 하면서 코드를 뒤적이지.
물론 가끔은 이 감이 맞을 때도 있지만, 대부분은 허공에 삽질하는 경우가 더 많아. 범인은 항상 예상치 못한 곳에 숨어있거든.🕵️
오늘 우리는 이 '감'의 시대를 끝내고, '데이터'의 시대를 열어볼 거야.
바로 Go 언어에 내장된 강력한 성능 분석 도구, pprof와 함께 말이지.
pprof는 우리 코드의 건강 상태를 속속들이 알려주는 종합 건강검진 키트 같은 녀석이야.
CPU를 누가 많이 쓰는지, 메모리는 어디서 새고 있는지, 심지어 우리 고루틴(goroutine)들이 어디서 놀고 있는지까지 전부 다 알려주거든.
이 글을 끝까지 함께한다면, 너는 더 이상 성능 문제 앞에서 작아지지 않을 거야.
마치 명탐정처럼 날카롭게 문제의 원인을 찾아내고, 외과 의사처럼 정교하게 코드를 최적화하는 '성능 해결사'로 거듭나게 될 거라고 확신해. 자, 그럼 이제 우리 코드의 숨겨진 비밀을 파헤치러 떠나볼까? Let's Go! 💨
프로파일링(Profiling)은 아주 간단하게 말해서 '프로그램의 성능 병목 지점을 찾는 기술'이야.
어떤 함수가 CPU 시간을 가장 많이 잡아먹는지, 어떤 코드 라인이 메모리를 가장 많이 할당하는지 등을 측정하고 분석해서 '성능 보고서'를 만들어주는 거지.
이 보고서를 통해 우리는 추측이 아닌, 정확한 데이터를 기반으로 최적화를 진행할 수 있어. 시간 낭비는 줄이고, 효율은 극대화하는 개발자의 필수 스킬이라고 할 수 있지! ✨
1. pprof, 우리 앱을 위한 응급 구조대 준비시키기 🚑
자, 가장 먼저 우리 Go 애플리케이션에 pprof라는 응급 구조대를 상주시켜야 해.
방법은 놀라울 정도로 간단해. 그냥 딱 두 줄만 추가하면 돼. 정말이야!
보통 Go 애플리케이션은 웹 서버로 동작하는 경우가 많으니까, 웹 서버 코드에 pprof를 붙여볼게.
만약 네가 만드는 게 웹 서버가 아니더라도 걱정 마. pprof 데이터를 파일로 직접 생성하는 방법도 나중에 다룰 거니까!
가장 일반적인 방법은 `net/http/pprof` 패키지를 임포트(import)하는 거야.
이 패키지는 임포트되는 것만으로 마법 같은 일을 벌여. 바로 `DefaultServeMux`에 여러 프로파일링 엔드포인트(endpoint)를 자동으로 등록해주거든.
백문이 불여일견, 코드를 직접 보자.
package main
import (
"fmt"
"log"
"net/http"
_ "net/http/pprof" // 바로 이 녀석이 주인공! ✨
"time"
)
func main() {
// pprof 엔드포인트를 위한 웹 서버 실행
// 이 서버는 실제 서비스 로직과 함께 실행될 수도 있고,
// 이렇게 프로파일링만을 위해 별도로 실행될 수도 있어.
go func() {
log.Println(http.ListenAndServe("localhost:6060", nil))
}()
fmt.Println("서버가 시작되었습니다. 프로파일링은 http://localhost:6060/debug/pprof/ 에서 확인 가능합니다.")
fmt.Println("이제 애플리케이션의 메인 로직을 실행합니다...")
// 여기에 여러분의 실제 애플리케이션 로직이 들어갑니다.
// 지금은 간단한 예제를 위해 무한 루프를 돌려볼게요.
for {
log.Println("애플리케이션이 열심히 일하는 중... 🏃♂️")
time.Sleep(10 * time.Second)
}
}
코드에서 가장 중요한 부분은 바로 `_ "net/http/pprof"` 이 라인이야.
앞에 붙은 언더스코어(`_`)는 "이 패키지를 직접 사용하지는 않지만, 패키지의 `init()` 함수를 실행시켜줘"라는 의미야.
`net/http/pprof` 패키지는 `init()` 함수 안에서 `/debug/pprof/` 경로로 시작하는 여러 핸들러들을 등록하는 코드를 가지고 있어.
이제 위 코드를 실행하고 웹 브라우저에서 `http://localhost:6060/debug/pprof/`로 접속해봐.
그럼 이런 화면을 만나게 될 거야.
- allocs: 모든 과거 메모리 할당 샘플
- block: 동기화 프리미티브(예: 뮤텍스)에서 대기 중인 스택 트레이스
- cmdline: 현재 프로그램의 명령줄 인수
- goroutine: 모든 현재 고루틴의 스택 트레이스
- heap: 현재 활성 객체들의 메모리 할당 샘플
- mutex: 경합 중인 뮤텍스 홀더들의 스택 트레이스
- profile: CPU 프로파일 (가장 많이 사용!)
- threadcreate: 새로운 OS 스레드를 생성한 스택 트레이스
- trace: 현재 프로그램의 실행 추적
이 링크들이 바로 우리 코드의 건강 상태를 확인할 수 있는 각종 검사 항목들이야. 이제부터 하나씩 정복해 나갈 테니 기대해도 좋아! 😉
이렇게 pprof를 우리 코드에 심는 건 정말 간단하지? 이제 진짜 게임을 시작할 시간이야.
가장 흔한 문제인 'CPU 과부하'의 범인을 잡으러 가보자!
2. CPU 프로파일링: "내 CPU 누가 다 썼어?" 범인 추적 작전 🔍
CPU 사용량이 100%에 육박하면 서버는 버벅대고, 응답 시간은 하늘로 치솟지.
사용자들은 떠나가고, 우리 마음은 타들어 가고... 🔥 이럴 때 pprof가 명탐정으로 변신할 시간이야.
범인을 잡으려면 먼저 범죄 현장을 만들어야겠지? 일부러 CPU를 많이 사용하도록 조작된 코드를 만들어보자.
아래 코드는 피보나치 수열을 아주 비효율적인 재귀 함수로 계산해서 CPU에 부하를 주는 예제야.
package main

import (
	"fmt"
	"log"
	"net/http"
	_ "net/http/pprof"
	"time"
)

// 아주 비효율적인 피보나치 함수 (CPU 부하 유발용)
func fib(n int) int {
	if n <= 1 {
		return n
	}
	return fib(n-1) + fib(n-2)
}

// 이 함수는 계속해서 피보나치 함수를 호출하며 CPU를 사용한다.
func busyWork() {
	for i := 0; ; i++ {
		n := 35 // 숫자가 클수록 부하가 커짐
		fmt.Printf("Calculating fib(%d)...\n", n)
		result := fib(n)
		fmt.Printf("fib(%d) = %d\n", n, result)
		time.Sleep(1 * time.Second)
	}
}

func main() {
	// pprof 서버 실행
	go func() {
		log.Println(http.ListenAndServe("localhost:6060", nil))
	}()

	// CPU 부하를 주는 함수를 고루틴으로 실행
	go busyWork()

	fmt.Println("서버가 시작되었습니다. 프로파일링은 http://localhost:6060/debug/pprof/ 에서 확인 가능합니다.")

	// 프로그램이 종료되지 않도록 대기
	select {}
}
이 코드를 실행하면 `busyWork` 함수가 `fib(35)`를 끊임없이 계산하면서 CPU를 야금야금 먹기 시작할 거야.
이제 `go tool pprof`라는 도구를 사용해서 이 범인을 체포해 보자.
2.1. 증거 수집: 프로파일 데이터 캡처하기
터미널을 열고 아래 명령어를 입력해봐.
이 명령어는 30초 동안 CPU 사용 내역을 수집해서 분석하겠다는 의미야.
go tool pprof http://localhost:6060/debug/pprof/profile?seconds=3030초가 지나면 pprof가 프로파일 데이터를 수집하고 분석해서, `(pprof)` 라는 프롬프트가 뜨는 대화형 콘솔로 진입할 거야. 이제부터가 진짜 분석의 시작이지.
이건 Go SDK에 포함된 아주 강력한 커맨드라인 도구야.
pprof가 수집한 프로파일링 데이터를 가져와서 사람이 보기 쉽게 분석하고 시각화해주는 역할을 해.
웹 서버에서 실시간으로 데이터를 가져올 수도 있고, 파일로 저장된 프로파일을 읽어서 분석할 수도 있어. 우리는 이 도구와 아주 친해져야 해! 🤝
2.2. 용의선상 좁히기: `top` 명령어로 핵심 용의자 찾기
pprof 콘솔에 들어왔다면, 가장 먼저 사용해야 할 명령어는 바로 `top`이야.
`top`은 CPU를 가장 많이 사용한 함수들을 순서대로 보여주는, 마치 용의자 목록 같은 거지.
콘솔에 `top`이라고 입력하고 엔터를 쳐봐.
(pprof) top아마 아래와 비슷한 결과를 보게 될 거야. (숫자는 조금씩 다를 수 있어)
Showing nodes accounting for 29.56s, 99.97% of 29.57s total
Dropped 15 nodes (cum <= 0.15s)
      flat  flat%   sum%        cum   cum%
    29.48s 99.70% 99.70%     29.48s 99.70%  main.fib
     0.05s  0.17% 99.86%     29.56s 99.97%  main.busyWork
     0.02s  0.07% 99.93%      0.02s  0.07%  runtime.asyncPreempt
     0.01s  0.03% 99.97%      0.01s  0.03%  runtime.newstack
         0     0% 99.97%     29.56s 99.97%  main.main.func2
         0     0% 99.97%     29.56s 99.97%  runtime.main
결과를 한번 해석해볼까?
- flat: 해당 함수 자체에서만 소모한 시간. (다른 함수 호출 시간은 제외)
- flat%: flat 시간이 전체 CPU 시간에서 차지하는 비율.
- sum%: 위에서부터 flat%를 누적한 값. 상위 몇 개가 전체의 대부분을 차지하는지 보기 편해.
- cum (cumulative): 해당 함수와 그 함수가 호출한 다른 모든 함수들에서 소모한 시간의 총합.
- cum%: cum 시간이 전체 CPU 시간에서 차지하는 비율.
자, 용의자 목록을 봐. `main.fib` 함수가 `flat` 기준으로 무려 99.70%를 차지하고 있어!
이건 거의 "범인은 바로 나야!"라고 외치는 수준이지. `cum` 시간도 거의 동일한 걸 보니, `fib` 함수가 호출하는 다른 함수는 거의 없고, 자기 자신이 재귀 호출되면서 시간을 다 잡아먹고 있다는 걸 알 수 있어.
이제 범인은 특정됐어. 바로 `main.fib` 함수야. 하지만 여기서 멈추면 안 돼.
이 함수의 어떤 부분이 문제인지 코드 레벨까지 더 깊게 파고들어가야 해.
2.3. 범행 현장 급습: `list` 명령어로 문제의 코드 라인 찾기
`list` 명령어는 특정 함수의 소스 코드를 보여주면서 각 라인별로 CPU 소모 시간을 알려주는 아주 강력한 도구야.
마치 CCTV를 돌려보며 범행 순간을 포착하는 것과 같지.
콘솔에 `list fib` 라고 입력해보자. (`list 함수이름` 형식이야)
(pprof) list fib그럼 이런 화면이 나올 거야.
Total: 29.57s
ROUTINE ======================== main.fib in /path/to/your/project/main.go
    29.48s     29.48s (flat, cum) 99.70% of Total
         .          .      9:func fib(n int) int {
         .          .     10:	if n <= 1 {
         .          .     11:		return n
         .          .     12:	}
    29.48s     29.48s     13:	return fib(n-1) + fib(n-2)
         .          .     14:}
결과를 봐! 13번 라인, `return fib(n-1) + fib(n-2)`에서 무려 29.48초를 사용했어.
전체 프로파일링 시간의 거의 전부를 이 한 줄에서 보냈다는 뜻이야. 이제 우리는 '감'이 아니라 '데이터'로 문제의 원인을 100% 확신하게 되었어. 바로 이 비효율적인 재귀 호출이 CPU를 잡아먹는 주범이었던 거지.
2.4. 사건의 재구성: `web` 명령어로 호출 관계 시각화하기
때로는 코드가 복잡하게 얽혀 있어서 `top`이나 `list`만으로는 전체적인 흐름을 파악하기 어려울 때가 있어.
이럴 때 사용하는 비장의 무기가 바로 `web` 명령어! 이 명령어는 함수 호출 관계와 각 함수에서 소모한 시간을 그래프 형태로 시각화해서 보여줘. (Graphviz라는 도구가 설치되어 있어야 해. `brew install graphviz` 또는 `apt-get install graphviz`로 설치할 수 있어.)
콘솔에 `web`이라고 입력하면, 자동으로 웹 브라우저가 열리면서 멋진 그래프가 나타날 거야.
(pprof) web이 그래프를 통해 우리는 어떤 함수가 어떤 함수를 호출하고, 그 과정에서 시간이 얼마나 걸리는지를 한눈에 파악할 수 있어. 범죄의 전체적인 흐름을 조망하는 거지.
그래프를 해석하는 방법은 이래:
- 박스(노드): 각각의 함수를 의미해.
- 박스 크기 & 색상: 박스가 크고 붉은색에 가까울수록 해당 함수 자체의 리소스(CPU, 메모리) 사용량이 많다는 뜻이야. 우리 예제에서는 `main.fib` 박스가 압도적으로 크고 붉게 표시될 거야.
- 화살표: 함수 호출 관계를 나타내. A에서 B로 화살표가 있다면 A가 B를 호출했다는 의미.
- 화살표 위의 숫자: 호출 과정에서 소모된 리소스 양을 나타내.
- 화살표 굵기: 호출 빈도를 나타내. 굵을수록 더 자주 호출되었다는 뜻.
이 그래프를 보면 `main.busyWork`가 `main.fib`를 호출하고, `main.fib`는 자기 자신을 미친 듯이 재귀 호출하면서 모든 CPU 시간을 삼켜버리는 모습이 한눈에 들어오지. 이제 범행의 전모가 완벽하게 밝혀졌어!
2.5. 문제 해결 및 검증
원인을 알았으니 해결은 간단해. 비효율적인 재귀 함수를 효율적인 방식으로 바꾸면 돼.
피보나치 수열의 경우, 메모이제이션(memoization)을 사용하거나 반복문으로 바꾸면 성능이 극적으로 향상되지.
예를 들어, 메모이제이션을 적용해 코드를 수정해볼까?
// ... (기존 코드)

// 메모이제이션을 위한 맵
var memo = make(map[int]int)

// 메모이제이션을 적용하여 최적화된 피보나치 함수
func fibOptimized(n int) int {
	if val, ok := memo[n]; ok {
		return val
	}
	if n <= 1 {
		return n
	}
	result := fibOptimized(n-1) + fibOptimized(n-2)
	memo[n] = result
	return result
}

// busyWork 함수가 최적화된 함수를 호출하도록 수정
func busyWork() {
	for i := 0; ; i++ {
		n := 35
		fmt.Printf("Calculating fibOptimized(%d)...\n", n)
		// result := fib(n) // 기존 코드
		result := fibOptimized(n) // 수정된 코드
		fmt.Printf("fibOptimized(%d) = %d\n", n, result)
		time.Sleep(1 * time.Second)
	}
}

// ... (main 함수는 동일)
코드를 이렇게 수정하고 다시 실행한 뒤, 똑같이 30초 동안 CPU 프로파일링을 해봐.
그리고 `top` 명령어를 실행하면... 놀라운 변화를 목격하게 될 거야!
Showing nodes accounting for 0.02s, 66.67% of 0.03s total
      flat  flat%   sum%        cum   cum%
     0.01s 33.33% 33.33%      0.01s 33.33%  runtime.futex
     0.01s 33.33% 66.67%      0.01s 33.33%  runtime.notesleep
         0     0% 66.67%      0.01s 33.33%  main.busyWork
         0     0% 66.67%      0.01s 33.33%  time.Sleep
...
이제 `main.fibOptimized` 함수는 `top` 목록 상위권에서 찾아볼 수도 없어! CPU 사용량이 거의 0에 가까워졌기 때문이지.
대신 `time.Sleep`이나 `runtime` 관련 함수들이 상위권에 보이는데, 이건 우리 프로그램이 이제 CPU를 거의 안 쓰고 대부분의 시간을 잠자면서 보낸다는 아주 좋은 신호야. 😎
어때? pprof를 이용한 CPU 병목 현상 해결, 생각보다 어렵지 않지?
이런 체계적인 접근 방식은 복잡한 실제 프로젝트에서 더욱 빛을 발할 거야. 더 이상 어둠 속에서 헤매지 말고, pprof라는 밝은 등불을 켜고 나아가자!
3. 메모리 프로파일링: "내 RAM은 누가 다 먹었나?" 누수 탐지 작전 💧
CPU 문제만큼이나 골치 아픈 게 바로 메모리 문제야.
특히 '메모리 누수(Memory Leak)'는 프로그램을 오래 실행할수록 메모리 사용량이 계속 증가해서 결국에는 OOM(Out Of Memory) 에러로 서버를 다운시키는 무서운 녀석이지.
Go는 가비지 컬렉터(GC)가 있어서 C/C++처럼 메모리를 직접 해제해주지 않아도 되지만, 그렇다고 메모리 누수에서 100% 자유로운 건 아니야.
예를 들어, 전역 변수나 클로저 등에서 더 이상 필요 없는 객체에 대한 참조를 계속 들고 있으면 GC가 메모리를 수거해가지 못해서 누수가 발생할 수 있어.
자, 이번에도 일부러 메모리 누수를 일으키는 코드를 만들고 pprof로 추적해보자.
package main

import (
	"fmt"
	"log"
	"net/http"
	_ "net/http/pprof"
	"time"
)

// 메모리 누수를 유발할 전역 슬라이스
var leakyData []string

// 1MB 크기의 문자열을 계속해서 슬라이스에 추가하는 함수
func memoryLeaker() {
	// 1MB 크기의 더미 데이터 생성
	dummy := make([]byte, 1024*1024)
	for i := range dummy {
		dummy[i] = 'a'
	}
	strDummy := string(dummy)

	for {
		log.Println("메모리 누수 발생 중... 💧 1MB 추가!")
		leakyData = append(leakyData, strDummy)
		time.Sleep(1 * time.Second)
	}
}

func main() {
	// pprof 서버 실행
	go func() {
		log.Println(http.ListenAndServe("localhost:6060", nil))
	}()

	// 메모리 누수를 일으키는 함수를 고루틴으로 실행
	go memoryLeaker()

	fmt.Println("서버가 시작되었습니다. 프로파일링은 http://localhost:6060/debug/pprof/ 에서 확인 가능합니다.")

	select {}
}
이 코드는 1초에 1MB씩 전역 변수인 `leakyData` 슬라이스에 데이터를 계속 추가해. 이 데이터는 프로그램이 종료될 때까지 절대 해제되지 않으니, 완벽한 메모리 누수 상황이지.
3.1. 힙 프로파일의 종류 이해하기
메모리 프로파일링을 시작하기 전에, pprof가 제공하는 힙(Heap) 프로파일의 네 가지 종류를 알아두면 분석에 큰 도움이 돼. 힙은 프로그램이 동적으로 할당하는 메모리 공간을 말해.
- inuse_space: 현재 사용 중인 메모리의 총 크기. (가장 중요! 누수 찾을 때 주로 사용)
- inuse_objects: 현재 사용 중인 객체의 총 개수.
- alloc_space: 프로그램 시작 후 할당된 메모리의 누적 총 크기. (GC로 해제된 것도 포함)
- alloc_objects: 프로그램 시작 후 할당된 객체의 누적 총 개수.
메모리 누수를 찾을 때는 주로 `inuse_space` 프로파일을 사용해. 시간이 지남에 따라 `inuse_space`가 계속 증가한다면 누수를 강력하게 의심해볼 수 있지.
3.2. 증거 수집: 시간차를 두고 힙 프로파일 캡처하기
메모리 누수는 특정 시점의 스냅샷만으로는 찾기 어려워. '시간이 지나면서 메모리가 증가하는 현상'을 포착해야 하거든.
그래서 우리는 두 개의 프로파일을 시간 간격을 두고 수집한 뒤, 그 차이를 비교하는 전략을 사용할 거야.
먼저, 프로그램을 실행하고 1분 정도 기다려서 메모리가 어느 정도 쌓이게 해.
그리고 첫 번째 힙 프로파일을 수집해서 파일로 저장하자.
# 첫 번째 힙 프로파일 수집 (base.heap)
go tool pprof -o base.heap http://localhost:6060/debug/pprof/heap
이제 다시 1분 정도 더 기다려. 그동안 `memoryLeaker` 함수는 메모리를 2배로 더 쌓았을 거야.
그리고 두 번째 힙 프로파일을 수집하자.
# 두 번째 힙 프로파일 수집 (current.heap)
go tool pprof -o current.heap http://localhost:6060/debug/pprof/heap
좋아, 이제 우리는 `base.heap`(과거)과 `current.heap`(현재)이라는 두 개의 증거 파일을 확보했어.
3.3. 비교 분석: 두 프로파일의 차이점으로 누수 지점 찾기
이제 `go tool pprof`의 `-base` 옵션을 사용해서 두 프로파일을 비교 분석할 차례야.
이 옵션은 두 번째 파일(`current.heap`)에서 첫 번째 파일(`base.heap`)의 정보를 뺀, 즉 '그 시간 동안 새로 증가한 메모리'만 보여주는 마법 같은 기능이야.
터미널에 아래 명령어를 입력해봐.
go tool pprof -base base.heap current.heap자, 이제 pprof 콘솔로 들어왔어. 여기서도 CPU 때와 마찬가지로 `top` 명령어를 사용해볼까?
(pprof) top결과는 아마 이럴 거야.
Showing nodes accounting for 60MB, 100% of 60MB total
      flat  flat%   sum%        cum   cum%
      60MB   100%   100%       60MB   100%  main.memoryLeaker
         0     0%   100%       60MB   100%  main.main.func2
         0     0%   100%       60MB   100%  runtime.main
결과를 봐! `main.memoryLeaker` 함수가 지난 1분 동안 무려 60MB의 메모리를 새로 할당했고, 이게 전체 증가량의 100%를 차지한다고 나와.
범인은 `main.memoryLeaker`라는 게 명백해졌지?
더 확실한 증거를 잡기 위해 `list memoryLeaker`를 입력해서 코드 레벨로 들어가 보자.
(pprof) list memoryLeakerTotal: 60MB
ROUTINE ======================== main.memoryLeaker in /path/to/your/project/main.go
60MB 60MB (flat, cum) 100% of Total
. . 19: strDummy := string(dummy)
. . 20:
. . 21: for {
. . 22: log.Println("메모리 누수 발생 중... 💧 1MB 추가!")
60MB 60MB 23: leakyData = append(leakyData, strDummy)
. . 24: time.Sleep(1 * time.Second)
. . 25: }
. . 26:}
결과가 모든 걸 말해주고 있어. 23번 라인, `leakyData = append(leakyData, strDummy)`에서 60MB의 메모리 증가가 발생했어.
전역 변수 `leakyData`에 계속해서 데이터를 쌓는 바로 이 코드가 메모리 누수의 원흉이었던 거야.
물론 `web` 명령어를 사용하면 이 관계를 시각적으로도 확인할 수 있어. `main.memoryLeaker`가 거대한 붉은 박스로 표시되면서 모든 메모리를 차지하고 있는 모습을 보게 될 거야.
3.4. 문제 해결 및 검증
이 메모리 누수를 해결하는 방법은 상황에 따라 다양해.
- 정말로 더 이상 필요 없는 데이터라면, 슬라이스에서 해당 요소를 제거하고 nil로 만들어 GC가 수거해가도록 해야 해.
- 만약 데이터가 계속 필요한데 너무 커지는 게 문제라면, 오래된 데이터는 파일이나 데이터베이스에 저장하고 메모리에서는 지우는 로직을 추가할 수 있어.
- 또는 슬라이스의 크기에 제한(capacity)을 두어 무한정 커지는 것을 막을 수도 있지.
예를 들어, 슬라이스 크기를 10개로 제한하는 코드를 추가해볼까?
// ...
const maxLeakyDataSize = 10

func memoryLeaker() {
	// ...
	for {
		log.Println("데이터 추가 시도...")
		if len(leakyData) >= maxLeakyDataSize {
			log.Println("슬라이스가 꽉 찼습니다. 가장 오래된 데이터를 제거합니다.")
			// 가장 오래된 데이터(첫 번째 요소)를 제거
			leakyData = leakyData[1:]
		}
		leakyData = append(leakyData, strDummy)
		log.Printf("현재 슬라이스 크기: %d\n", len(leakyData))
		time.Sleep(1 * time.Second)
	}
}
// ...
이렇게 코드를 수정하고 다시 프로파일링을 해보면, 시간이 지나도 `inuse_space`가 더 이상 증가하지 않고 일정 수준을 유지하는 것을 확인할 수 있을 거야. 메모리 누수 검거 완료! 🎉
pprof 콘솔이 강력하긴 하지만, 때로는 더 직관적인 UI가 필요할 때가 있어.
이럴 때 `go tool pprof -http=:8080 profile.prof` 와 같이 `-http` 플래그를 사용해봐.
그러면 pprof가 수집한 데이터를 분석해서 보여주는 웹 UI가 `localhost:8080`에 실행돼.
여기서는 Flame Graph, Top 뷰, 소스 코드 뷰 등을 클릭 몇 번으로 쉽게 오갈 수 있어서 분석이 훨씬 편해져. 꼭 한번 써보길 추천해!
4. pprof 고급 스킬: 고루틴과 동기화 문제까지 파헤치기
CPU와 메모리 문제만 해결해도 대부분의 성능 이슈는 잡을 수 있어.
하지만 Go의 강력함은 '동시성(Concurrency)'에 있고, 이건 또 다른 종류의 문제를 낳기도 해. 바로 '고루틴 누수'나 '뮤텍스 경합' 같은 것들이지.
pprof는 이런 문제들을 진단하는 도구도 모두 갖추고 있어. 간단하게 어떤 것들이 있는지 알아보자.
4.1. 고루틴 프로파일링: "사라지지 않는 유령 고루틴을 찾아라!"
고루틴은 아주 가볍지만, 그렇다고 무한정 생성해도 되는 건 아니야.
만약 고루틴이 작업을 끝내고도 종료되지 않고 계속 살아있다면? 이게 바로 '고루틴 누수'야.
수만, 수십만 개의 고루틴이 좀비처럼 떠돌아다니면 결국 시스템 리소스를 고갈시키게 돼.
고루틴 프로파일은 현재 실행 중인 모든 고루틴의 스택 트레이스(stack trace)를 보여줘.
아래 명령어로 확인할 수 있지.
go tool pprof http://localhost:6060/debug/pprof/goroutine만약 특정 위치에서 멈춰있는 고루틴의 수가 비정상적으로 많다면, 그 부분이 바로 누수 지점일 가능성이 높아.
예를 들어, 채널에서 데이터를 기다리는데 아무도 데이터를 보내주지 않아서 영원히 대기하는 고루틴 같은 것들을 찾아낼 수 있어.
4.2. 블록 & 뮤텍스 프로파일링: "우리 앱은 왜 맨날 기다리기만 할까?"
때로는 CPU도, 메모리도 널널한데 프로그램이 느릴 때가 있어.
이건 고루틴들이 일을 안 하고 무언가를 '기다리느라' 시간을 보내고 있다는 신호일 수 있어.
주로 채널 I/O나 뮤텍스 락(lock)을 기다리는 경우지.
- 블록 프로파일 (`/debug/pprof/block`): 고루틴이 동기화(채널, 뮤텍스 등) 때문에 얼마나 오래 대기했는지를 측정해. 이 프로파일을 보면 어떤 코드에서 고루틴들이 발이 묶여 있는지 알 수 있어.
- 뮤텍스 프로파일 (`/debug/pprof/mutex`): 여러 고루틴이 하나의 뮤텍스를 차지하기 위해 경쟁(contention)하는 상황을 보여줘. 특정 뮤텍스에서 경합이 너무 심하게 발생하면, 그 부분이 전체 시스템의 병목 지점이 될 수 있어.
이 프로파일들은 기본적으로 비활성화되어 있어서, 코드에 `runtime.SetBlockProfileRate(1)` 이나 `runtime.SetMutexProfileFraction(1)` 을 추가해서 활성화해야 제대로 된 데이터를 수집할 수 있어. 동시성 프로그램의 성능을 극한까지 끌어올리고 싶을 때 아주 유용한 도구들이야.
5. 벤치마크와 프로파일링의 환상적인 조합 🧪
지금까지는 실행 중인 서버에 pprof를 붙여서 분석하는 방법을 알아봤어.
하지만 개발 단계에서 특정 함수의 성능을 미리 측정하고 최적화하고 싶을 때도 많잖아?
이럴 때 Go의 내장 벤치마킹 도구와 pprof를 함께 사용하면 환상의 시너지를 낼 수 있어.
`go test` 명령어에 몇 가지 플래그만 추가하면 벤치마크를 실행하면서 동시에 프로파일링 데이터까지 파일로 생성할 수 있어.
먼저, `main_test.go` 같은 테스트 파일을 만들고 벤치마크 함수를 작성해야 해.
package main

import "testing"

// 비효율적인 fib 함수를 벤치마킹
func BenchmarkFib(b *testing.B) {
	for i := 0; i < b.N; i++ {
		fib(30) // 벤치마크에서는 너무 오래 걸리지 않도록 숫자를 조절
	}
}

// 최적화된 fibOptimized 함수를 벤치마킹
func BenchmarkFibOptimized(b *testing.B) {
	for i := 0; i < b.N; i++ {
		fibOptimized(30)
	}
}
이제 아래 명령어를 실행해봐.
go test -bench . -cpuprofile cpu.prof -memprofile mem.prof이 명령어는 현재 패키지의 모든 벤치마크를 실행하면서, CPU 프로파일은 `cpu.prof` 파일에, 메모리 프로파일은 `mem.prof` 파일에 저장해줘.
벤치마크가 끝나면 생성된 프로파일 파일을 `go tool pprof`로 열어서 분석할 수 있어.
go tool pprof cpu.prof이 방법을 사용하면, 서버를 직접 띄우지 않고도 특정 코드 조각의 성능을 정밀하게 측정하고 최적화할 수 있어.
코드 변경 전후의 벤치마크 결과와 프로파일링 데이터를 비교하면, 내 최적화 작업이 얼마나 효과가 있었는지 정확한 수치로 증명할 수 있지. 정말 멋지지 않아? 😎
마치며: 이제 당신도 성능 탐정!
자, 오늘 우리는 Go의 강력한 프로파일링 도구 pprof와 함께 CPU 과부하의 범인을 잡고, 메모리 누수의 흔적을 추적하는 긴 여정을 함께했어.
처음에는 막막하게만 느껴졌던 성능 문제가, pprof라는 강력한 도구를 손에 쥐니 생각보다 명쾌하게 해결되는 것을 경험했을 거야.
가장 중요한 것은 이것이야: 추측하지 말고, 측정하라! (Don't guess, measure!)
성능 최적화의 세계에서 '감'은 때로 우리를 잘못된 길로 인도해.
하지만 pprof가 제공하는 정확한 데이터는 언제나 진실을 가리키는 나침반이 되어줄 거야.
오늘 배운 내용들을 잊지 말고, 네가 만드는 다음 프로젝트부터는 pprof를 적극적으로 활용해봐.
코드가 느려지거나 메모리가 불안정할 때, 더 이상 당황하지 않고 자신감 있게 원인을 분석하고 해결하는 너의 모습을 발견하게 될 거야.
물론 오늘 다룬 내용이 pprof의 전부는 아니야. 트레이싱(tracing), 더 복잡한 동시성 문제 분석 등 파고들면 파고들수록 더 깊은 세계가 펼쳐지지.
만약 혼자서 해결하기 어려운 문제에 부딪히거나, Go 전문가의 도움이 필요하다면 재능넷 같은 플랫폼에서 실력 있는 전문가들의 도움을 받아보는 것도 좋은 방법이야. 함께 고민하면 더 빠르고 확실하게 문제를 해결할 수 있을 테니까!
이제 너는 단순한 코더가 아니라, 코드의 건강 상태를 진단하고 치료하는 '성능 탐정'이자 '코드 닥터'야.
자, 이제 pprof와 함께 네 코드가 가진 잠재력을 100% 끌어내러 가보자! 🚀

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.






아직 댓글이 없습니다.