
Ver2.0 신경망의 패턴 인식과 일반화 능력 대해부 🧠✨
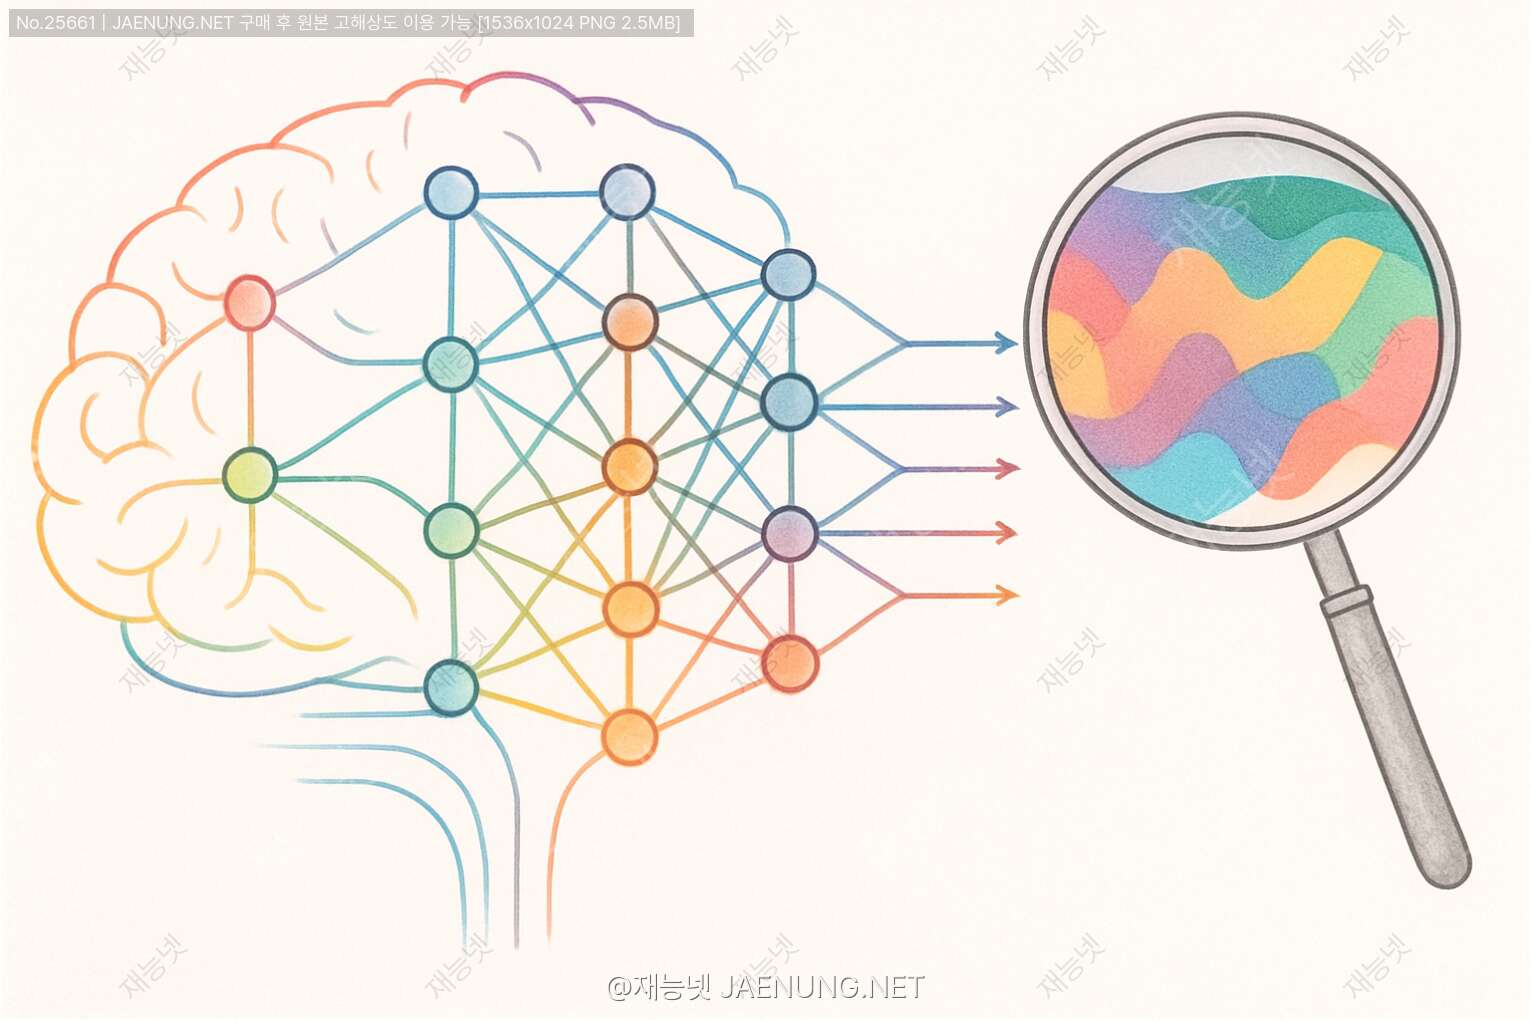
신경망의 패턴 인식과 일반화 능력 대해부 🧠✨
인공지능의 마법 같은 학습 과정, 어떻게 이루어질까요?
안녕하세요, AI 덕후 여러분! 🙌 오늘은 정말 흥미진진한 주제로 찾아왔어요. 바로 신경망이 어떻게 패턴을 인식하고 일반화하는지에 대한 이야기입니다. 인공지능이 어떻게 고양이 사진을 보고 "아, 이건 고양이구나!"라고 알아차리는지, 또 한 번도 본 적 없는 고양이 사진도 어떻게 인식할 수 있는지 궁금하셨죠? 지금부터 그 비밀을 풀어볼게요! ㅋㅋㅋ
요즘 재능넷 같은 플랫폼에서도 AI 관련 재능 거래가 핫하다고 하던데, 이런 기본 원리를 알면 AI 서비스를 더 잘 활용할 수 있겠죠? 그럼 본격적으로 신경망의 세계로 들어가 볼까요? 레츠고~! 🚀
1. 인간 뇌에서 영감을 받은 신경망 🧠
우리 뇌는 대략 860억 개의 뉴런으로 구성되어 있고, 이 뉴런들은 서로 연결되어 정보를 주고받아요. 인공 신경망(Artificial Neural Network, ANN)은 이런 인간 뇌의 구조와 작동 방식에서 영감을 받았답니다. 뇌를 100% 복제한 건 아니고, 핵심 아이디어만 가져온 거죠!
인공 신경망은 뉴런 대신 '노드(Node)'라는 계산 단위를 사용해요. 이 노드들이 여러 층(Layer)을 이루면서 복잡한 패턴을 인식할 수 있게 되는 거죠. 마치 우리가 고양이를 볼 때 눈-코-입-귀-수염 등의 특징을 종합해서 "아, 고양이구나!"라고 인식하는 것처럼요! 🐱
위 그림처럼 인공 신경망은 보통 입력층, 은닉층, 출력층으로 구성되어 있어요. 입력층은 데이터를 받아들이고, 은닉층은 패턴을 학습하며, 출력층은 최종 결과를 내놓는 역할을 해요. 이게 바로 딥러닝의 기본 구조랍니다! 😎
2. 신경망은 어떻게 학습할까? 🤔
자, 이제 진짜 꿀잼 파트가 시작됩니다! 신경망이 어떻게 학습하는지 알아볼게요. 사실 신경망의 학습 과정은 우리가 새로운 기술을 배우는 것과 비슷해요. 처음에는 엉망진창이다가 점점 나아지는 거죠! ㅋㅋㅋ
신경망 학습의 핵심은 가중치(Weight)와 편향(Bias)의 조정이에요. 각 노드 간의 연결에는 가중치가 있고, 이 가중치가 높을수록 해당 연결이 중요하다는 뜻이에요. 마치 우리가 고양이를 인식할 때 귀 모양이 중요한 특징이라면, '귀' 특징에 높은 가중치를 두는 것과 같죠!
🧮 신경망 학습의 4단계
- 순전파(Forward Propagation): 입력 데이터가 신경망을 통과하면서 예측값을 계산해요.
- 손실 계산(Loss Calculation): 예측값과 실제값의 차이(오차)를 계산해요.
- 역전파(Backpropagation): 오차를 줄이기 위해 가중치를 어떻게 조정해야 할지 계산해요.
- 가중치 업데이트(Weight Update): 계산된 값을 바탕으로 가중치를 실제로 조정해요.
이 과정을 엄청나게 많이 반복하면 신경망은 점점 더 정확한 예측을 할 수 있게 돼요. 마치 우리가 피아노를 연습할 때 처음에는 서툴다가 반복 연습을 통해 점점 나아지는 것처럼요! 🎹
특히 역전파 알고리즘은 신경망 학습의 핵심인데, 이건 마치 시험을 본 후에 오답 노트를 만드는 것과 비슷해요. "여기서 틀렸으니까 다음에는 이렇게 해야지!"라고 계획을 세우는 거죠. 근데 이걸 컴퓨터가 자동으로 해준다니... 진짜 대박이죠? 👏
학습 과정에서 중요한 개념 중 하나가 경사 하강법(Gradient Descent)이에요. 이건 마치 산에서 가장 낮은 곳을 찾아가는 것과 비슷해요. 우리의 목표는 오차(손실)가 가장 적은 지점을 찾는 거니까요! 🏔️
경사 하강법은 현재 위치에서 경사가 가장 가파른 방향으로 조금씩 이동하면서 최저점을 찾아가는 방법이에요. 마치 눈을 가린 채로 산을 내려가는데, 발로 땅을 더듬어 가장 가파르게 내려가는 방향을 찾는 것과 같죠! 근데 이게 생각보다 어려운 게, 지역 최저점(Local Minimum)에 빠질 수도 있어요. 마치 작은 웅덩이에 빠져서 "여기가 가장 낮은 곳이다!"라고 착각하는 거죠. 그래서 다양한 최적화 알고리즘들이 개발되었답니다! 💡
3. 패턴 인식: 특징 추출의 마법 ✨
이제 진짜 신기한 부분이 나옵니다! 신경망이 어떻게 패턴을 인식하는지 알아볼게요. 사실 이건 특징 추출(Feature Extraction)이라는 과정을 통해 이루어져요.
예를 들어, 고양이 사진을 인식하는 신경망을 생각해봅시다. 초기 층에서는 단순한 선이나 모서리 같은 기본적인 특징을 감지해요. 그다음 층에서는 이런 기본 특징들을 조합해서 눈, 코, 귀 같은 더 복잡한 특징을 인식하죠. 마지막 층에서는 이런 특징들을 종합해서 "이건 고양이다!"라고 판단하는 거예요. 완전 신기방기! 🙀
🔍 CNN(Convolutional Neural Network)의 특징 추출 과정
CNN은 이미지 인식에 특화된 신경망 구조로, 특징 추출을 위한 특별한 레이어들을 가지고 있어요:
- 컨볼루션 레이어(Convolution Layer): 필터를 사용해 이미지의 특징을 추출해요.
- 풀링 레이어(Pooling Layer): 특징의 크기를 줄이고 중요한 정보만 남겨요.
- 완전 연결 레이어(Fully Connected Layer): 추출된 특징을 바탕으로 최종 분류를 수행해요.
이런 계층적 특징 추출이 바로 딥러닝의 강력한 힘이에요! 인간이 직접 "고양이는 이런 특징이 있어"라고 알려주지 않아도, 신경망이 스스로 데이터에서 중요한 특징을 찾아내는 거죠. 이게 바로 표현 학습(Representation Learning)이라고 불리는 개념이에요. 🤯
위 그림처럼 CNN은 단계적으로 특징을 추출해요. 이런 방식으로 신경망은 복잡한 패턴도 인식할 수 있게 되는 거죠! 이제 재능넷에서 AI 이미지 생성 서비스를 이용할 때도 "아, 이런 원리로 작동하는구나!"라고 이해할 수 있겠죠? 😉
4. 일반화: 본 적 없는 데이터도 인식하는 능력 🔮
자, 이제 가장 신기한 부분이 나왔어요! 신경망의 일반화(Generalization) 능력이란, 학습 데이터에 없던 새로운 데이터도 올바르게 처리할 수 있는 능력을 말해요. 이건 마치 우리가 몇 마리의 고양이만 보고도 처음 보는 고양이를 "고양이"라고 인식할 수 있는 것과 비슷하죠! 🐱
하지만 여기서 중요한 문제가 있어요. 바로 과적합(Overfitting)과 과소적합(Underfitting)이라는 문제예요.
⚠️ 과적합(Overfitting)
학습 데이터를 너무 잘 외워버려서 새로운 데이터에 대응하지 못하는 상태예요. 마치 시험 문제만 달달 외워서 응용 문제는 못 푸는 학생 같은 거죠! ㅋㅋㅋ
⚠️ 과소적합(Underfitting)
학습이 충분히 이루어지지 않아 패턴을 제대로 파악하지 못한 상태예요. 공부를 너무 안 해서 기본 문제도 못 푸는 상황이라고 볼 수 있죠! 😅
좋은 일반화 능력을 갖추려면 이 두 가지 문제를 피해야 해요. 그래서 다양한 정규화(Regularization) 기법들이 사용돼요:
- 드롭아웃(Dropout): 학습 중에 일부 뉴런을 무작위로 비활성화시켜 과적합을 방지해요. 마치 시험 볼 때 일부 노트를 못 보게 해서 진짜 이해했는지 확인하는 것과 비슷해요!
- 가중치 감소(Weight Decay): 가중치가 너무 커지지 않도록 제한해요. 이렇게 하면 모델이 특정 특징에 너무 의존하지 않게 돼요.
- 배치 정규화(Batch Normalization): 각 층의 입력을 정규화해서 학습을 안정화시키고 과적합을 줄여요.
- 데이터 증강(Data Augmentation): 기존 데이터를 변형해서 더 많은 학습 데이터를 만들어요. 이미지를 회전하거나 자르거나 색상을 바꾸는 등의 방법이 있죠!
위 그림에서 볼 수 있듯이, 적절한 적합 상태가 가장 이상적이에요. 이 상태에서는 모델이 데이터의 일반적인 패턴을 잘 파악하면서도 노이즈(잡음)에는 영향을 받지 않죠. 이런 모델이 바로 좋은 일반화 능력을 가진 모델이라고 할 수 있어요! 🎯
일반화 능력을 높이는 또 다른 방법은 교차 검증(Cross Validation)이에요. 이건 데이터를 여러 부분으로 나누어 번갈아가며 학습과 검증에 사용하는 방법이에요. 이렇게 하면 모델이 특정 데이터에만 최적화되는 것을 방지할 수 있죠! 👍
5. 실생활 응용 사례: 신경망의 패턴 인식 능력 🌟
이제 이론은 충분히 알아봤으니, 실제로 신경망의 패턴 인식과 일반화 능력이 어떻게 활용되는지 살펴볼까요? 진짜 대박인 사례들이 많답니다! 😲
🖼️ 이미지 인식 및 생성
이미지 인식은 신경망의 가장 대표적인 응용 분야예요. 요즘은 스마트폰으로 식물을 찍으면 어떤 종인지 알려주는 앱도 있잖아요? 이게 다 CNN의 패턴 인식 능력 덕분이에요!
또한 GAN(Generative Adversarial Network)이라는 신경망은 실제 같은 가짜 이미지를 생성할 수 있어요. 요즘 핫한 AI 아트 생성기들이 바로 이 기술을 활용하고 있죠! 재능넷에서도 AI 아트 관련 재능 거래가 인기라던데, 이런 기술 덕분이랍니다! 🎨
🔊 음성 인식 및 자연어 처리
시리, 빅스비, 알렉사 같은 음성 비서들도 신경망의 패턴 인식 능력을 활용해요. RNN(Recurrent Neural Network)이나 Transformer 같은 구조가 음성 패턴을 인식하고 언어를 이해하는 데 사용되죠!
또한 ChatGPT 같은 대화형 AI도 텍스트의 패턴을 학습해서 자연스러운 대화를 생성할 수 있어요. 이런 기술이 발전하면 더 똑똑한 AI 비서가 등장할 날도 머지않았어요! 🤖
🏥 의료 분야
신경망은 의료 영상(X-ray, MRI 등)에서 질병의 패턴을 인식하는 데도 활용돼요. 때로는 인간 의사보다 더 정확하게 암이나 다른 질병을 조기에 발견할 수 있죠!
특히 일반화 능력이 중요한데, 다양한 환자의 데이터로 학습한 모델이 처음 보는 환자의 데이터도 정확하게 분석할 수 있어야 하니까요. 정말 생명을 구하는 기술이라고 할 수 있어요! 💉
🚗 자율주행
자율주행 자동차는 카메라, 라이다, 레이더 등의 센서로 수집한 데이터에서 패턴을 인식해 도로, 차량, 보행자 등을 식별해요. 이것도 신경망의 패턴 인식 능력 덕분이죠!
여기서 일반화 능력은 정말 중요해요. 학습 데이터에 없던 새로운 상황(예: 특이한 형태의 장애물)도 올바르게 인식하고 대응해야 하니까요. 말 그대로 생명이 달린 문제랍니다! 🚦
이렇게 신경망의 패턴 인식과 일반화 능력은 우리 생활 곳곳에서 활용되고 있어요. 앞으로 더 많은 분야에서 AI가 활약할 텐데, 그 핵심에는 항상 이 두 가지 능력이 있을 거예요! 🌈
6. 신경망의 한계와 미래 전망 🔭
지금까지 신경망의 놀라운 능력에 대해 알아봤는데요, 사실 신경망에도 한계가 있어요. 그리고 이런 한계를 극복하기 위한 연구들이 활발히 진행 중이랍니다! 🧪
⚠️ 신경망의 한계
- 블랙박스 문제: 신경망이 왜 그런 결정을 내렸는지 설명하기 어려워요. 이건 특히 의료나 법률 같은 중요한 결정을 내리는 분야에서 문제가 될 수 있죠.
- 데이터 의존성: 신경망은 학습 데이터의 품질과 양에 크게 의존해요. 데이터가 편향되어 있으면 결과도 편향될 수 있어요.
- 계산 비용: 깊은 신경망을 학습시키려면 엄청난 컴퓨팅 파워가 필요해요. 이건 환경적으로도 문제가 될 수 있죠.
- 적대적 예제(Adversarial Examples): 사람 눈에는 거의 차이가 없지만, 신경망을 완전히 속일 수 있는 입력이 존재해요. 이건 보안 측면에서 큰 문제가 될 수 있죠.
하지만 이런 한계에도 불구하고, 신경망과 딥러닝의 미래는 정말 밝아 보여요! 🌞 다음과 같은 흥미로운 연구 방향들이 있답니다:
🚀 미래 연구 방향
- 설명 가능한 AI(XAI): 신경망의 결정 과정을 더 투명하게 만들어 사람이 이해할 수 있게 하는 연구예요.
- 자기 지도 학습(Self-supervised Learning): 레이블이 없는 데이터에서도 효과적으로 학습할 수 있는 방법을 연구하고 있어요.
- 메타 러닝(Meta Learning): 적은 데이터로도 빠르게 학습할 수 있는 "학습하는 법을 학습하는" 방법이에요.
- 뉴로모픽 컴퓨팅(Neuromorphic Computing): 인간 뇌의 구조를 더 정확히 모방한 하드웨어를 개발하는 연구예요.
- 양자 신경망(Quantum Neural Networks): 양자 컴퓨팅을 활용해 더 효율적인 신경망을 구현하는 연구예요.
이런 연구들이 성공하면, 미래의 AI는 더 적은 데이터와 에너지로도 더 정확하고 설명 가능한 결과를 낼 수 있을 거예요. 그리고 이런 기술들이 재능넷 같은 플랫폼을 통해 더 많은 사람들에게 접근 가능해진다면, 정말 멋진 미래가 펼쳐질 거예요! 💫
7. 결론: 신경망의 마법 같은 능력 🌈
와~ 정말 긴 여정이었네요! 지금까지 신경망이 어떻게 패턴을 인식하고 일반화하는지에 대해 알아봤어요. 정말 신기하지 않나요? 🤩
요약해보자면:
- 신경망은 인간 뇌에서 영감을 받아 만들어진 계산 모델이에요. 뉴런 대신 노드를 사용하고, 이 노드들이 여러 층을 이루면서 복잡한 패턴을 인식할 수 있게 돼요.
- 학습 과정은 가중치와 편향을 조정하는 것이에요. 순전파, 손실 계산, 역전파, 가중치 업데이트의 과정을 반복하면서 점점 더 정확한 예측을 할 수 있게 돼요.
- 패턴 인식은 계층적 특징 추출을 통해 이루어져요. 초기 층에서는 단순한 특징을, 후기 층에서는 복잡한 특징을 추출해요.
- 일반화 능력은 학습 데이터에 없던 새로운 데이터도 올바르게 처리할 수 있는 능력이에요. 과적합과 과소적합을 피하고 적절한 정규화 기법을 사용하면 좋은 일반화 능력을 갖출 수 있어요.
- 신경망은 이미지 인식, 자연어 처리, 의료, 자율주행 등 다양한 분야에서 활용되고 있어요. 그리고 앞으로 더 많은 분야로 확장될 거예요!
물론 신경망에도 한계가 있지만, 연구자들은 이런 한계를 극복하기 위해 끊임없이 노력하고 있어요. 미래의 AI는 더 적은 데이터와 에너지로도 더 정확하고 설명 가능한 결과를 낼 수 있을 거예요. 🚀
여러분도 이제 재능넷에서 AI 관련 서비스를 이용하거나 제공할 때, 그 뒤에 숨겨진 원리를 조금이나마 이해할 수 있게 되셨길 바랍니다! AI의 세계는 정말 무궁무진하니, 더 많은 것을 배우고 경험해보세요! 🌟
마지막으로, 신경망의 패턴 인식과 일반화 능력은 정말 마법 같지만, 사실은 수학과 컴퓨터 과학의 결정체랍니다. 인간의 지능을 모방하려는 노력이 이렇게 놀라운 결과를 만들어냈다니, 정말 대단하지 않나요? 앞으로 AI가 어디까지 발전할지 정말 기대되네요! 💫

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
아직 댓글이 없습니다.