

Ver2.0 검증 데이터 vs 테스트 데이터: 모델 평가 전략 🧠🔍
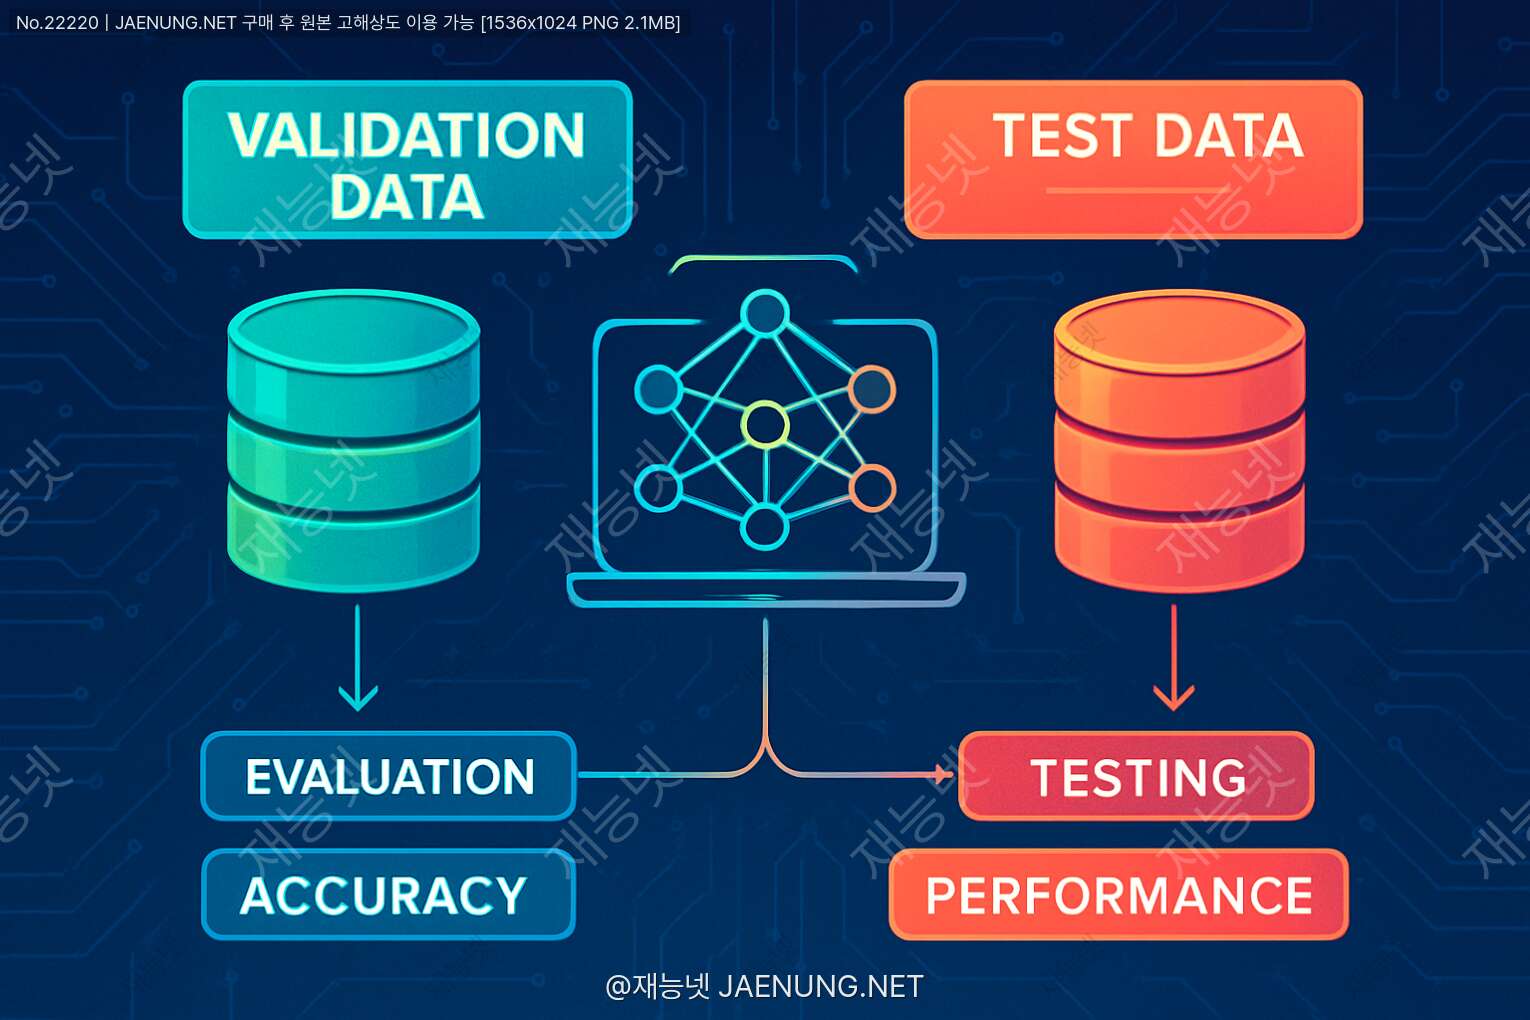
검증 데이터 vs 테스트 데이터: 모델 평가 전략 🧠🔍
머신러닝 모델의 성능을 제대로 평가하는 방법을 알아보자!
안녕! 오늘은 머신러닝과 딥러닝에서 정말 중요한 주제인 검증 데이터와 테스트 데이터의 차이에 대해 함께 알아볼 거야. 이 개념들은 모델 평가 전략의 핵심이지만, 많은 사람들이 헷갈려하는 부분이기도 해. 🤔
재능넷에서 프로그래밍이나 데이터 분석 관련 재능을 거래하는 사람이라면 이 개념을 확실히 알아두는 게 좋을 거야! 특히 AI 모델을 개발하거나 평가하는 작업을 의뢰받았다면 더더욱! 자, 그럼 시작해볼까? 🚀
📊 데이터 분할의 기본 개념
머신러닝 모델을 만들 때 가장 먼저 하는 일이 뭔지 알아? 바로 데이터를 나누는 거야! 근데 왜 데이터를 나눠야 할까? 🤷♂️
생각해봐. 네가 시험공부를 한다고 치자. 문제집으로 공부하고, 그 문제집에서 본 문제들만 시험에 나온다면? 그건 진짜 실력을 측정하는 게 아니지! 마찬가지로, 머신러닝 모델도 학습에 사용한 데이터로만 평가하면 실제 성능을 알 수 없어.
그래서 우리는 데이터를 보통 세 부분으로 나눠:
- 학습 데이터(Training Data): 모델이 패턴을 배우는 데 사용 📚
- 검증 데이터(Validation Data): 모델 튜닝에 사용 🔧
- 테스트 데이터(Test Data): 최종 성능 평가에 사용 🎯
이렇게 나누는 이유가 뭘까? 간단히 말하면 '치팅'을 방지하기 위해서야! 모델이 단순히 데이터를 '암기'하는 게 아니라 진짜 '이해'하도록 만들기 위한 전략이지. 😉
🔍 검증 데이터(Validation Data)란?
검증 데이터는 모델 개발 과정에서 하이퍼파라미터 튜닝과 모델 선택에 사용돼. 쉽게 말하면, 모델의 '설정'을 조정하는 데 도움을 주는 데이터라고 생각하면 돼! 🛠️
🌟 검증 데이터의 역할
검증 데이터는 마치 중간고사 같아. 최종 시험(테스트) 전에 자신의 실력을 점검하고 공부 방향을 조정하는 거지! 모델도 마찬가지로 검증 데이터로 성능을 확인하고 설정을 조정해.
검증 데이터를 사용하는 주요 목적:
- 모델의 하이퍼파라미터 조정하기 (학습률, 층의 수, 뉴런 수 등) 🎛️
- 과적합(Overfitting) 감지하기 🕵️♀️
- 여러 모델 구조 중 최적의 모델 선택하기 🏆
- 조기 종료(Early Stopping) 시점 결정하기 ⏱️
예를 들어, 너가 재능넷에서 이미지 분류 모델을 만드는 재능을 판매한다고 해보자. 고객의 데이터로 여러 모델을 시도해볼 텐데, 이때 검증 데이터를 통해 어떤 모델이 가장 좋은지 판단할 수 있어. 이렇게 하면 최종 테스트 전에 최적의 모델을 고를 수 있지! 👍
🎯 테스트 데이터(Test Data)란?
테스트 데이터는 모델 개발이 완전히 끝난 후에 최종 성능을 평가하는 데 사용돼. 이건 마치 기말고사와 같은 역할이야. 진짜 실력을 확인하는 최종 관문인 셈이지! 📝
🌟 테스트 데이터의 특징
테스트 데이터는 단 한 번만 사용해야 해! 여러 번 사용하면 그 데이터에 맞춰 모델을 조정하게 되고, 이는 일종의 '치팅'이 돼버려. 테스트 데이터는 모델이 한 번도 보지 못한 완전히 새로운 데이터여야 해.
테스트 데이터의 중요성:
- 모델의 일반화 능력 측정 🌐
- 실제 환경에서의 예상 성능 추정 📊
- 모델 간 공정한 비교 기준 제공 ⚖️
- 과적합 여부 최종 확인 🔍
재능넷에서 데이터 사이언스 관련 서비스를 제공하는 전문가라면, 고객에게 테스트 데이터로 측정한 성능 지표를 제공하는 것이 신뢰도를 높이는 좋은 방법이야. 이건 네 모델이 실제로 얼마나 잘 작동하는지 보여주는 투명한 방법이니까! 💯
🤼♂️ 검증 데이터 vs 테스트 데이터: 핵심 차이점
이제 두 데이터셋의 차이점을 명확하게 정리해볼게. 이 부분은 정말 중요하니까 집중해서 봐줘! 👀
| 비교 항목 | 검증 데이터 (Validation Data) | 테스트 데이터 (Test Data) |
|---|---|---|
| 사용 시점 ⏱️ | 모델 개발 과정 중 | 모델 개발 완료 후 |
| 사용 횟수 🔄 | 여러 번 (반복적으로) | 단 한 번 |
| 주요 목적 🎯 | 하이퍼파라미터 튜닝, 모델 선택 | 최종 성능 평가 |
| 피드백 반영 🔄 | 결과를 모델 개선에 반영함 | 결과를 모델에 반영하지 않음 |
| 데이터 노출 👁️ | 간접적으로 모델에 노출됨 | 모델에 전혀 노출되지 않음 |
검증 데이터는 모델 개발 과정에서 여러 번 사용되지만, 테스트 데이터는 최종 평가에서 단 한 번만 사용된다는 점이 가장 큰 차이야. 이건 마치 학교에서 모의고사(검증)와 수능(테스트)의 차이와 비슷해! 🏫
🔀 데이터 분할 방법
자, 이제 데이터를 어떻게 나누는지 알아볼까? 데이터 분할 방법은 여러 가지가 있는데, 상황에 맞게 선택하는 게 중요해! 🧩
1. 홀드아웃 방법 (Hold-out Method)
가장 기본적인 방법으로, 데이터를 학습/검증/테스트 세트로 한 번에 나누는 방식이야. 보통 70:15:15 또는 80:10:10 비율로 나눠. 간단하지만 데이터가 적을 때는 불안정할 수 있어.
from sklearn.model_selection import train_test_split

# 먼저 학습+검증 세트와 테스트 세트로 분할
X_temp, X_test, y_temp, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 다시 학습 세트와 검증 세트로 분할
X_train, X_val, y_train, y_val = train_test_split(X_temp, y_temp, test_size=0.25, random_state=42)  # 0.25 x 0.8 = 0.2
2. K-겹 교차 검증 (K-Fold Cross-Validation)
데이터를 K개의 폴드(부분집합)로 나누고, 각 반복에서 하나의 폴드를 검증 세트로 사용하는 방법이야. 이렇게 하면 모든 데이터가 한 번씩 검증 세트로 사용되기 때문에 더 안정적인 평가가 가능해! 🔄
from sklearn.model_selection import KFold

kf = KFold(n_splits=5, shuffle=True, random_state=42)

for fold, (train_idx, val_idx) in enumerate(kf.split(X)):
    X_train, X_val = X[train_idx], X[val_idx]
    y_train, y_val = y[train_idx], y[val_idx]

    # 모델 학습
    model.fit(X_train, y_train)

    # 검증
    val_score = model.score(X_val, y_val)
    print(f"폴드 {fold+1} 검증 점수: {val_score:.4f}")
3. 계층적 k-겹 교차 검증 (Stratified K-Fold)
클래스 불균형이 있는 분류 문제에서 각 폴드가 원본 데이터의 클래스 비율을 유지하도록 하는 방법이야. 이건 분류 문제에서 특히 중요해! ⚖️
from sklearn.model_selection import StratifiedKFold

skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

for fold, (train_idx, val_idx) in enumerate(skf.split(X, y)):
    X_train, X_val = X[train_idx], X[val_idx]
    y_train, y_val = y[train_idx], y[val_idx]

    # 모델 학습 및 검증
    ...
데이터의 특성과 양에 따라 적절한 분할 방법을 선택하는 것이 중요해. 데이터가 적다면 K-겹 교차 검증이 좋고, 데이터가 많다면 홀드아웃 방법도 충분할 수 있어! 🧮
⚠️ 흔한 실수와 주의사항
머신러닝 모델을 평가할 때 많은 사람들이 저지르는 실수들이 있어. 이런 함정에 빠지지 않도록 주의해야 해! 🚨
🚫 절대 하지 말아야 할 실수들
- 데이터 누수(Data Leakage): 테스트 데이터의 정보가 학습 과정에 유입되는 것
- 테스트 데이터로 튜닝하기: 테스트 결과를 보고 모델을 조정하는 것
- 전처리 실수: 전체 데이터를 먼저 전처리한 후 분할하는 것
1. 데이터 누수(Data Leakage) 방지하기
데이터 누수는 테스트 데이터의 정보가 모델 학습에 간접적으로 사용되는 현상이야. 이건 모델의 실제 성능을 과대평가하게 만들어! 🔍
예를 들어, 재능넷에서 주식 예측 모델을 만드는 재능을 판매한다고 해보자. 미래 데이터가 학습 데이터에 포함되면? 그건 마치 시험 문제를 미리 아는 것과 같아! 😱
2. 올바른 전처리 순서
항상 데이터를 먼저 분할한 후에 전처리해야 해! 특히 정규화나 표준화 같은 작업은 학습 데이터만으로 계산한 통계치를 사용해야 해.
# 잘못된 방법 ❌
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)  # 전체 데이터로 스케일링
X_train, X_test = train_test_split(X_scaled)  # 그 후 분할

# 올바른 방법 ✅
X_train, X_test = train_test_split(X)  # 먼저 분할
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)  # 학습 데이터로만 fit
X_test_scaled = scaler.transform(X_test)  # 학습 데이터의 통계치로 변환
3. 테스트 데이터는 신성불가침!
테스트 데이터는 단 한 번, 최종 평가에만 사용해야 해. 여러 번 테스트하고 모델을 조정하면 테스트 데이터에 과적합되어 버려. 이건 마치 수능 기출문제로만 공부해서 실제 수능에서 다른 유형이 나오면 망하는 것과 같아! 📚
💡 프로 팁
테스트 데이터는 마치 금고에 넣어두고 모델 개발이 완전히 끝날 때까지 열어보지 않는다고 생각해! 그리고 한 번 성능을 측정한 후에는 더 이상의 모델 조정은 없어야 해.
📈 모델 평가 지표
검증 및 테스트 데이터로 모델을 평가할 때 사용하는 다양한 지표들이 있어. 문제 유형에 따라 적절한 지표를 선택하는 것이 중요해! 📊
분류 문제의 평가 지표
- 정확도(Accuracy): 전체 중 맞게 예측한 비율 (불균형 데이터에선 부적절) ✓
- 정밀도(Precision): 양성으로 예측한 것 중 실제 양성인 비율 🎯
- 재현율(Recall): 실제 양성 중 양성으로 예측한 비율 🔍
- F1 점수: 정밀도와 재현율의 조화평균 ⚖️
- ROC-AUC: 다양한 임계값에서의 모델 성능을 종합적으로 평가 📉
회귀 문제의 평가 지표
- MAE(Mean Absolute Error): 예측값과 실제값 차이의 절대값 평균 📏
- MSE(Mean Squared Error): 예측값과 실제값 차이의 제곱 평균 📊
- RMSE(Root Mean Squared Error): MSE의 제곱근 (원래 단위로 해석 가능) 📉
- R² (결정계수): 모델이 데이터의 분산을 얼마나 설명하는지 나타내는 지표 📈
문제의 특성에 맞는 평가 지표를 선택하는 것이 중요해. 예를 들어, 암 진단 모델에서는 재현율(Recall)이 중요할 수 있고, 스팸 필터링에서는 정밀도(Precision)가 중요할 수 있어! 🎭
재능넷에서 머신러닝 모델 개발 서비스를 제공할 때, 고객의 비즈니스 목표에 맞는 평가 지표를 선택하고 설명해주는 것이 전문성을 보여주는 좋은 방법이야! 💼
🛠️ 실전 예제: 파이썬으로 구현하기
이제 실제로 파이썬에서 검증 데이터와 테스트 데이터를 활용하는 방법을 살펴볼게! 코드를 따라해보면 개념이 더 명확해질 거야. 👨💻
예제 1: 기본적인 데이터 분할
import numpy as np
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 데이터 로드
iris = load_iris()
X, y = iris.data, iris.target

# 데이터 분할 (학습:검증:테스트 = 60:20:20)
X_train_val, X_test, y_train_val, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train, X_val, y_train, y_val = train_test_split(X_train_val, y_train_val, test_size=0.25, random_state=42)

# 모델 학습
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)

# 검증 데이터로 평가
val_pred = model.predict(X_val)
val_accuracy = accuracy_score(y_val, val_pred)
print(f"검증 정확도: {val_accuracy:.4f}")

# 하이퍼파라미터 튜닝 (실제로는 여러 조합을 시도)
tuned_model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
tuned_model.fit(X_train, y_train)

# 튜닝된 모델 검증
tuned_val_pred = tuned_model.predict(X_val)
tuned_val_accuracy = accuracy_score(y_val, tuned_val_pred)
print(f"튜닝 후 검증 정확도: {tuned_val_accuracy:.4f}")

# 최종 모델 선택 후 테스트 데이터로 평가
test_pred = tuned_model.predict(X_test)
test_accuracy = accuracy_score(y_test, test_pred)
print(f"테스트 정확도: {test_accuracy:.4f}")
예제 2: 교차 검증 활용하기
from sklearn.model_selection import cross_val_score, GridSearchCV

# 교차 검증으로 모델 평가
model = RandomForestClassifier(random_state=42)
cv_scores = cross_val_score(model, X_train_val, y_train_val, cv=5)
print(f"5-겹 교차 검증 정확도: {cv_scores.mean():.4f} ± {cv_scores.std():.4f}")

# GridSearchCV로 하이퍼파라미터 튜닝
param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [None, 5, 10]
}

grid_search = GridSearchCV(
    RandomForestClassifier(random_state=42),
    param_grid,
    cv=5,
    scoring='accuracy',
    return_train_score=True
)

grid_search.fit(X_train_val, y_train_val)
print(f"최적 하이퍼파라미터: {grid_search.best_params_}")
print(f"최적 교차 검증 점수: {grid_search.best_score_:.4f}")

# 최종 모델로 테스트 데이터 평가
best_model = grid_search.best_estimator_
test_accuracy = best_model.score(X_test, y_test)
print(f"최종 테스트 정확도: {test_accuracy:.4f}")
이런 코드를 직접 실행해보면 검증 데이터와 테스트 데이터의 역할이 확실히 구분되는 걸 볼 수 있어. 검증 데이터는 모델 튜닝에 사용되고, 테스트 데이터는 최종 성능 평가에만 사용된다는 점을 기억해! 🧠
🔮 고급 전략: 중첩 교차 검증
더 견고한 모델 평가를 위해 중첩 교차 검증(Nested Cross-Validation)이라는 고급 기법도 있어. 이건 하이퍼파라미터 튜닝과 성능 평가를 모두 교차 검증으로 수행하는 방법이야! 🔄
중첩 교차 검증은 다음과 같이 작동해:
- 외부 루프: 데이터를 K개 폴드로 나누고, 각 반복에서 하나의 폴드를 테스트 세트로 사용 🔄
- 내부 루프: 외부 루프의 학습 데이터를 다시 J개 폴드로 나누어 하이퍼파라미터 튜닝 수행 🔍
- 각 외부 폴드마다 최적의 하이퍼파라미터를 찾고, 테스트 세트로 평가 📊
- K개의 테스트 점수를 평균내어 최종 성능 추정 📈
from sklearn.model_selection import GridSearchCV, KFold, cross_val_score

# 중첩 교차 검증 구현
outer_cv = KFold(n_splits=5, shuffle=True, random_state=42)
inner_cv = KFold(n_splits=3, shuffle=True, random_state=42)

# 하이퍼파라미터 그리드
param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [None, 5, 10]
}

# 외부 루프
outer_scores = []

for train_idx, test_idx in outer_cv.split(X):
    X_train_outer, X_test_outer = X[train_idx], X[test_idx]
    y_train_outer, y_test_outer = y[train_idx], y[test_idx]

    # 내부 루프 (GridSearchCV)
    clf = GridSearchCV(
        RandomForestClassifier(random_state=42),
        param_grid,
        cv=inner_cv,
        scoring='accuracy'
    )

    clf.fit(X_train_outer, y_train_outer)

    # 최적 모델로 외부 테스트 세트 평가
    best_model = clf.best_estimator_
    score = best_model.score(X_test_outer, y_test_outer)
    outer_scores.append(score)

    print(f"외부 폴드 최적 파라미터: {clf.best_params_}, 테스트 점수: {score:.4f}")

# 최종 성능 추정
print(f"중첩 교차 검증 평균 점수: {np.mean(outer_scores):.4f} ± {np.std(outer_scores):.4f}")
중첩 교차 검증은 모델 선택 편향을 최소화하고 더 신뢰할 수 있는 성능 추정치를 제공해. 특히 데이터가 적을 때 유용하지만, 계산 비용이 높다는 단점도 있어! 🧮
💡 실무 팁과 베스트 프랙티스
지금까지 배운 내용을 바탕으로, 실제 프로젝트에서 활용할 수 있는 몇 가지 꿀팁을 알려줄게! 🍯
🌟 데이터 분할 비율 정하기
데이터 크기에 따라 적절한 분할 비율을 선택해:
- • 데이터가 많을 때 (10만 건 이상): 80:10:10 또는 90:5:5
- • 중간 규모 (1만~10만 건): 70:15:15
- • 데이터가 적을 때 (1만 건 미만): 교차 검증 사용 권장
🌟 시계열 데이터 처리
시계열 데이터는 시간 순서를 고려해 분할해야 해:
- • 과거 데이터로 학습, 최근 데이터로 테스트
- • 시간 기반 교차 검증(Time Series Split) 사용
- • 미래 정보 누수에 특히 주의
🌟 불균형 데이터 처리
클래스 불균형이 있는 경우:
- • 계층적 샘플링(Stratified Sampling) 사용
- • 정확도보다 F1, AUC 같은 지표 활용
- • 학습 데이터에만 오버/언더 샘플링 적용
🌟 앙상블 기법 활용
여러 모델의 결과를 결합해 성능 향상:
- • 교차 검증 폴드마다 모델 학습 후 앙상블
- • 서로 다른 알고리즘 결합
- • 검증 데이터로 앙상블 가중치 최적화
재능넷에서 데이터 분석이나 머신러닝 관련 서비스를 제공한다면, 이런 베스트 프랙티스를 적용해서 더 신뢰할 수 있는 모델을 만들 수 있어! 고객에게 모델 평가 방법론을 명확히 설명하면 전문성을 인정받을 수 있지. 😎
🎓 마무리: 핵심 요약
오늘 우리가 배운 내용을 간단히 정리해볼게! 🧠
📌 핵심 포인트
- 검증 데이터는 모델 개발 과정에서 하이퍼파라미터 튜닝과 모델 선택에 사용돼. 여러 번 사용 가능! 🔄
- 테스트 데이터는 모델 개발이 완전히 끝난 후 최종 성능 평가에 단 한 번만 사용해. 절대 이 결과로 모델을 다시 조정하면 안 돼! 🚫
- 데이터 분할은 학습 전에 먼저 해야 하며, 전처리는 학습 데이터만 사용해 계산해야 해. ✂️
- 교차 검증은 데이터를 더 효율적으로 활용하고 안정적인 성능 추정을 제공해. 특히 데이터가 적을 때 유용해! 🔄
- 문제에 맞는 평가 지표를 선택하는 것이 중요해. 정확도만으로는 충분하지 않을 수 있어! 📊
머신러닝 모델 개발에서 검증 데이터와 테스트 데이터를 올바르게 활용하는 것은 정말 중요해. 이 개념을 제대로 이해하고 적용하면, 더 신뢰할 수 있고 실제 환경에서도 잘 작동하는 모델을 만들 수 있을 거야! 🚀
재능넷에서 AI나 머신러닝 관련 재능을 거래할 때, 이런 모델 평가 전략을 잘 활용하면 더 높은 품질의 서비스를 제공할 수 있을 거야. 고객들도 네가 제대로 된 방법론을 사용한다는 것을 알면 더 신뢰할 수 있겠지? 💪
오늘 배운 내용이 도움이 됐길 바라! 다음에 또 다른 흥미로운 주제로 만나자! 👋
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.
댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.