
Ver2.0 멀티 에이전트 시스템의 협력 및 경쟁 전략 학습
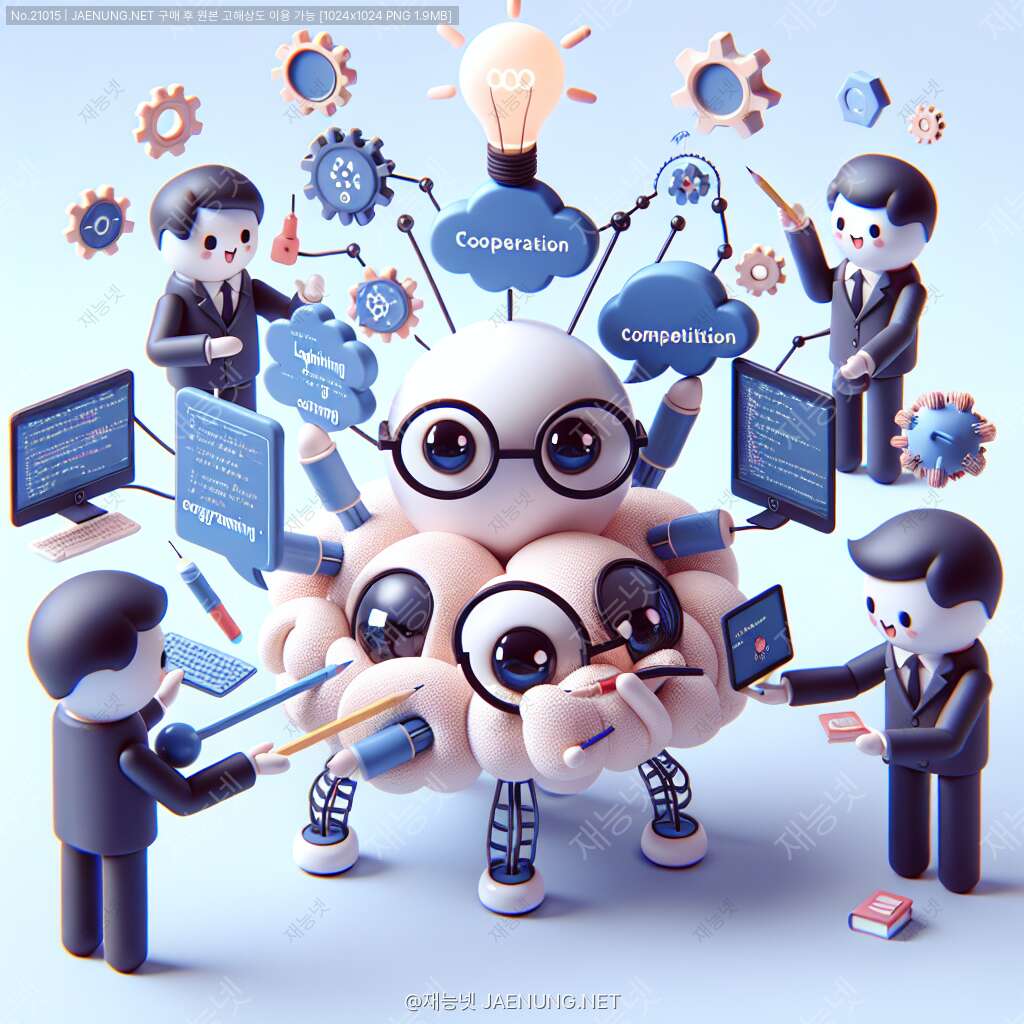
멀티 에이전트 시스템의 협력 및 경쟁 전략 학습
인공지능 에이전트들이 함께 일하고 경쟁하는 흥미로운 세계로 떠나볼까? 🚀
안녕! 오늘은 정말 흥미진진한 주제인 멀티 에이전트 시스템에 대해 함께 알아볼 거야. 마치 여러 명의 AI 친구들이 모여서 협력하거나 경쟁하면서 문제를 해결하는 방법이라고 생각하면 돼. 🤖🤝🤖
이 글을 통해 복잡한 개념들을 쉽고 재미있게 설명해줄게. 프로그래밍이나 AI에 대한 전문 지식이 없어도 충분히 이해할 수 있을 거야! 그럼 지금부터 멀티 에이전트의 세계로 함께 떠나보자! 🎮
🌟 멀티 에이전트 시스템이 뭐야?
멀티 에이전트 시스템은 여러 개의 지능형 에이전트(프로그램)가 함께 일하는 환경이야. 마치 여러 명의 사람들이 팀을 이뤄 일하는 것처럼, 여러 AI 프로그램들이 서로 소통하고, 협력하거나 경쟁하면서 복잡한 문제를 해결하는 거지. 😎
예시: 자율주행 자동차들이 도로에서 서로 정보를 주고받으며 안전하게 운행하는 시스템, 온라인 게임에서 서로 다른 전략을 가진 AI 캐릭터들, 또는 주식 시장에서 거래하는 여러 AI 트레이딩 봇들을 생각해보면 돼!
이런 시스템은 단일 에이전트로는 해결하기 어려운 복잡한 문제를 여러 에이전트가 나눠서 처리하기 때문에 더 효율적이고 강력해. 마치 혼자서 집을 짓는 것보다 여러 명의 전문가가 함께 일하는 게 더 빠르고 좋은 결과를 내는 것과 같은 원리지! 🏗️
🧠 에이전트는 어떻게 학습할까?
멀티 에이전트 시스템에서 각 에이전트는 강화학습(Reinforcement Learning)이라는 방법으로 학습하는 경우가 많아. 이건 마치 아이가 시행착오를 통해 배우는 것과 비슷해. 좋은 행동을 하면 보상을 받고, 나쁜 행동을 하면 페널티를 받으면서 점점 더 나은 결정을 내리게 되는 거지! 🍬
이 과정에서 중요한 건 다른 에이전트들의 행동도 함께 고려해야 한다는 점이야. 혼자 있을 때의 최적 전략과 여럿이 있을 때의 최적 전략은 완전히 달라질 수 있거든. 마치 혼자 게임할 때와 친구들과 함께 게임할 때 전략이 달라지는 것처럼 말이야! 🎲
에이전트 학습 과정 🔄
- 관찰하기: 환경과 다른 에이전트들의 상태를 파악해
- 행동 선택하기: 현재 상황에서 최선의 행동을 결정해
- 보상 받기: 행동의 결과에 따라 보상이나 페널티를 받아
- 전략 업데이트하기: 받은 피드백을 바탕으로 전략을 개선해
- 반복하기: 이 과정을 계속 반복하면서 점점 더 나아져!
이런 학습 방식은 재능넷과 같은 재능 공유 플랫폼에서도 활용될 수 있어. 예를 들어, 사용자들의 선호도를 학습하는 여러 추천 에이전트들이 서로 협력하면서 더 정확한 재능 매칭을 제공할 수 있지! 🎯
🤝 협력 전략: 함께라면 더 강해져!
멀티 에이전트 시스템에서 가장 흥미로운 부분 중 하나는 에이전트들이 서로 협력하는 방법을 스스로 배울 수 있다는 점이야. 처음에는 서로를 방해하거나 무시할 수 있지만, 시간이 지나면서 협력이 더 큰 보상을 가져온다는 것을 학습하게 돼. 😊
협력 예시: 축구 로봇 팀을 생각해봐. 각 로봇은 독립적인 에이전트지만, 패스를 주고받고 서로의 위치를 고려하면서 골을 넣기 위해 협력해야 해. 처음에는 서툴지만 점점 팀워크가 좋아지는 거지! ⚽
협력 학습의 핵심 요소 🔑
- 공유 목표: 모든 에이전트가 같은 목표를 향해 노력해
- 커뮤니케이션: 에이전트 간 정보 교환이 필수적이야
- 역할 분담: 각자 잘하는 일에 집중하면 시너지가 생겨
- 신뢰 구축: 다른 에이전트의 행동을 예측하고 의존할 수 있어야 해
협력 전략을 학습하는 과정에서 에이전트들은 이타적인 행동이 장기적으로는 자신에게도 이익이 된다는 것을 발견하게 돼. 이건 실제 사회에서도 마찬가지지! 🌍
🥊 경쟁 전략: 승자는 하나!
협력이 항상 최선은 아니야. 때로는 에이전트들이 서로 경쟁하는 것이 더 좋은 결과를 가져올 수도 있어. 경쟁은 각 에이전트가 최대한의 성능을 발휘하도록 자극하고, 더 빠른 발전을 이끌어내기도 하지. 🏆
경쟁 예시: 여러 트레이딩 AI가 주식 시장에서 서로 경쟁하면서 더 나은 투자 전략을 개발하는 상황을 생각해봐. 각자 자신의 이익을 최대화하려고 하지만, 결과적으로는 시장 전체의 효율성이 높아질 수 있어. 📈
경쟁 학습의 특징 🔥
- 제로섬 게임: 한 에이전트의 승리는 다른 에이전트의 패배를 의미할 수 있어
- 적응과 진화: 상대방의 전략에 맞춰 자신의 전략을 계속 발전시켜
- 탐색과 활용: 새로운 전략을 탐색하면서도 효과적인 전략을 활용해야 해
- 게임 이론: 상대방의 행동을 예측하고 대응하는 전략이 중요해
경쟁 환경에서는 상대방보다 한 발 앞서 생각하는 능력이 중요해져. 마치 체스나 바둑에서 상대의 다음 수를 예측하는 것처럼 말이야! ♟️
🎮 게임 이론: 멀티 에이전트 학습의 수학적 기반
멀티 에이전트 시스템을 이해하는 데 게임 이론(Game Theory)은 정말 중요한 역할을 해. 게임 이론은 여러 의사 결정자들이 서로의 결정에 영향을 주고받는 상황을 수학적으로 분석하는 학문이야. 🧮
죄수의 딜레마 - 게임 이론의 유명한 예시 🚔
두 명의 범죄 용의자 A와 B가 있어. 둘 다 자백하면 각각 3년씩, 둘 다 침묵하면 각각 1년씩, 한 명만 자백하면 자백한 사람은 즉시 석방되고 침묵한 사람은 5년형을 받게 돼.
| B가 침묵 | B가 자백 | |
|---|---|---|
| A가 침묵 | A: 1년, B: 1년 | A: 5년, B: 0년 |
| A가 자백 | A: 0년, B: 5년 | A: 3년, B: 3년 |
이론적으로는 둘 다 침묵하는 게 가장 좋지만, 개인의 이익만 생각하면 자백하게 돼. 이런 상황에서 AI 에이전트들은 어떤 선택을 할까? 🤔
게임 이론의 개념들은 멀티 에이전트 시스템에서 에이전트들이 최적의 전략을 찾아가는 과정을 이해하는 데 도움을 줘. 협력이 더 나을지, 경쟁이 더 나을지, 아니면 둘의 균형점을 찾아야 할지를 수학적으로 분석할 수 있게 해주는 거지! 📊
🛠️ 멀티 에이전트 시스템 구현하기
이론은 충분히 알아봤으니, 이제 간단한 멀티 에이전트 시스템을 어떻게 구현하는지 살펴볼까? 파이썬을 사용한 간단한 예제를 통해 기본 개념을 이해해보자! 🐍
간단한 멀티 에이전트 시스템 구현 예제
import numpy as np

class Agent:
    def __init__(self, agent_id, learning_rate=0.1):
        self.id = agent_id
        self.learning_rate = learning_rate
        self.strategy = np.array([0.5, 0.5])  # [협력 확률, 경쟁 확률]
        self.last_action = None
        self.reward_history = []

    def choose_action(self):
        # 현재 전략에 기반하여 행동 선택 (0: 협력, 1: 경쟁)
        action = np.random.choice([0, 1], p=self.strategy)
        self.last_action = action
        return action

    def update_strategy(self, reward):
        # 받은 보상에 따라 전략 업데이트
        self.reward_history.append(reward)

        # 간단한 강화학습 업데이트 규칙
        if self.last_action == 0:  # 협력을 선택했을 경우
            self.strategy[0] += self.learning_rate * reward
        else:  # 경쟁을 선택했을 경우
            self.strategy[1] += self.learning_rate * reward

        # 확률 정규화
        self.strategy = self.strategy / np.sum(self.strategy)

    def __str__(self):
        return f"Agent {self.id}: 협력 확률 = {self.strategy[0]:.2f}, 경쟁 확률 = {self.strategy[1]:.2f}"

# 보상 매트릭스 정의 (죄수의 딜레마 형태)
# [행 에이전트 행동][열 에이전트 행동] = (행 에이전트 보상, 열 에이전트 보상)
reward_matrix = [
    [(3, 3), (0, 5)],  # 행 에이전트가 협력할 때
    [(5, 0), (1, 1)]   # 행 에이전트가 경쟁할 때
]

# 에이전트 생성
agent1 = Agent(1)
agent2 = Agent(2)

# 1000번의 상호작용 시뮬레이션
for i in range(1000):
    action1 = agent1.choose_action()
    action2 = agent2.choose_action()

    # 보상 계산
    reward1, reward2 = reward_matrix[action1][action2]

    # 전략 업데이트
    agent1.update_strategy(reward1)
    agent2.update_strategy(reward2)

    # 100번마다 현재 전략 출력
    if (i+1) % 100 == 0:
        print(f"라운드 {i+1}:")
        print(agent1)
        print(agent2)
        print()
이 코드는 두 에이전트가 죄수의 딜레마 같은 게임을 반복적으로 플레이하면서 자신의 전략을 학습해가는 과정을 보여줘. 시간이 지남에 따라 에이전트들은 어떤 전략이 더 많은 보상을 가져다주는지 배우게 될 거야! 📝
이런 방식으로 재능넷에서도 사용자 맞춤형 추천 시스템을 구현할 수 있어. 여러 추천 에이전트가 서로 다른 접근 방식으로 사용자의 선호도를 학습하고, 가장 효과적인 추천 방식을 찾아내는 거지! 🎁
🌐 실제 응용 사례: 멀티 에이전트 시스템의 활약
멀티 에이전트 시스템은 이론적으로만 흥미로운 것이 아니라 실제 세계의 다양한 문제를 해결하는 데 활용되고 있어. 몇 가지 흥미로운 응용 사례를 살펴볼까? 🔍
1. 자율주행 자동차의 협력 🚗
도로 위의 여러 자율주행 차량들이 서로 정보를 공유하고 협력하면 교통 흐름을 최적화하고 사고를 예방할 수 있어. 각 차량은 독립적인 에이전트지만, 함께 일하면서 전체 교통 시스템의 효율성을 높이는 거지!
2. 스마트 그리드 에너지 관리 ⚡
전력망의 여러 지점에 배치된 에이전트들이 전력 수요와 공급을 실시간으로 조절하면서 효율적인 에너지 분배를 가능하게 해. 각 에이전트는 자신의 구역을 관리하면서도 다른 구역과 협력해 전체 시스템의 안정성을 유지해!
3. 로봇 팀의 협업 작업 🤖
여러 로봇이 함께 복잡한 작업을 수행할 때, 각 로봇은 독립적인 에이전트로 작동하면서도 팀으로 협력해. 예를 들어, 창고에서 물건을 정리하거나 재난 현장에서 구조 작업을 할 때 효과적이지!
4. 금융 시장 시뮬레이션 💰
여러 트레이딩 에이전트가 서로 경쟁하면서 시장 동향을 예측하고 투자 결정을 내리는 시스템을 통해 실제 금융 시장의 복잡한 역학을 시뮬레이션하고 분석할 수 있어.
5. 게임 AI의 발전 🎮
현대 게임에서는 여러 AI 캐릭터가 서로 협력하거나 경쟁하면서 플레이어에게 도전적이고 재미있는 경험을 제공해. 이런 AI들은 플레이어의 행동에 적응하면서 계속 발전하기도 해!
이런 응용 사례들을 보면, 멀티 에이전트 시스템이 단순한 이론을 넘어 우리 일상에 점점 더 깊숙이 들어오고 있다는 걸 알 수 있어. 미래에는 더 많은 분야에서 이런 시스템들이 활용될 거야! 🚀
🔮 미래 전망: 멀티 에이전트 시스템의 발전 방향
멀티 에이전트 시스템은 아직 발전 초기 단계에 있어. 앞으로 어떤 방향으로 발전할지 함께 살펴볼까? 🔭
미래 발전 방향 🚀
- 더 복잡한 협력 패턴: 에이전트들이 단순한 협력을 넘어 복잡한 팀워크와 역할 분담을 학습할 거야
- 인간-AI 협력: 멀티 에이전트 시스템이 인간 팀과 함께 일하는 방법을 배우게 될 거야
- 자기 조직화: 에이전트들이 스스로 최적의 조직 구조를 형성하는 능력이 발전할 거야
- 윤리적 의사결정: 에이전트들이 윤리적 가치와 사회적 규범을 고려한 결정을 내리게 될 거야
- 메타 학습: 에이전트들이 새로운 환경에 빠르게 적응하는 방법을 학습하게 될 거야
재능넷과 같은 플랫폼에서도 멀티 에이전트 시스템의 발전은 큰 변화를 가져올 수 있어. 예를 들어, 여러 전문 분야의 에이전트들이 협력해 사용자에게 최적의 재능 매칭을 제공하거나, 프로젝트 팀 구성을 최적화하는 데 도움을 줄 수 있지! 🌟
미래에는 우리가 인식하지 못할 정도로 자연스럽게 여러 AI 에이전트들이 우리 주변에서 협력하고 경쟁하면서 복잡한 문제들을 해결해 나갈 거야. 마치 우리 몸의 세포들이 각자의 역할을 하면서도 전체 몸의 건강을 위해 협력하는 것처럼 말이야! 🧬
🎓 마무리: 함께 배우고 성장하는 AI의 세계
지금까지 멀티 에이전트 시스템의 협력 및 경쟁 전략 학습에 대해 알아봤어. 복잡해 보이는 개념이지만, 결국은 여러 AI 프로그램이 함께 일하면서 더 나은 결과를 만들어내는 방법에 관한 이야기였지! 🤝
핵심 요약 📝
- 멀티 에이전트 시스템은 여러 AI 프로그램이 함께 일하는 환경이야
- 에이전트들은 강화학습을 통해 협력 또는 경쟁 전략을 배워나가
- 게임 이론은 에이전트들의 상호작용을 이해하는 수학적 기반을 제공해
- 실제로 자율주행, 로봇공학, 금융 등 다양한 분야에 응용되고 있어
- 미래에는 더 복잡한 협력 패턴과 인간-AI 협력이 발전할 거야
이런 기술들은 우리의 일상을 더 편리하고 효율적으로 만들어줄 잠재력을 가지고 있어. 자율주행 자동차부터 스마트홈, 개인 비서 AI까지, 여러 AI 시스템이 서로 협력하면서 우리의 삶을 지원하게 될 거야. 🏙️
멀티 에이전트 시스템은 프로그래밍과 AI의 미래를 보여주는 흥미로운 분야야. 이 분야에 관심이 생겼다면, 파이썬이나 다른 프로그래밍 언어로 간단한 멀티 에이전트 시뮬레이션을 만들어보는 것부터 시작해봐! 직접 경험해보면 더 깊이 이해할 수 있을 거야. 💻
함께 배우고 성장하는 AI의 세계, 정말 흥미롭지 않니? 앞으로도 계속해서 발전하는 이 분야를 함께 지켜보자! 👀✨

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.






아직 댓글이 없습니다.