
Ver2.0 시맨틱 세그멘테이션의 혁명: U-Net 아키텍처 완전 정복하기 🚀
시맨틱 세그멘테이션의 혁명: U-Net 아키텍처 완전 정복하기 🚀
안녕하세요, 여러분! 오늘은 딥러닝의 세계에서 엄청난 존재감을 뽐내고 있는 U-Net 아키텍처에 대해 함께 알아볼게요. 이미지 세그멘테이션계의 절대강자! 진짜 대박 기술이라 할 수 있죠. ㅋㅋㅋ
의료 영상부터 자율주행까지, 이미지의 각 픽셀이 무엇을 나타내는지 정확하게 분류해내는 시맨틱 세그멘테이션은 요즘 AI 기술의 핵심이라고 해도 과언이 아니에요. 그리고 이 분야에서 U-Net은 진짜 '갓벽'한 성능을 보여주고 있답니다! 😎
🧩 시맨틱 세그멘테이션이 뭐길래? 기초부터 탄탄히!
일단 시맨틱 세그멘테이션이 뭔지부터 알아볼까요? 쉽게 말해서 이미지의 각 픽셀이 어떤 클래스(사람, 자동차, 도로 등)에 속하는지 분류하는 작업이에요. 사진 속 모든 픽셀에 '이름표'를 다는 거라고 생각하면 됩니다!
예를 들어 도로 사진이 있다면:
- 하늘 픽셀 → '하늘' 클래스
- 자동차 픽셀 → '자동차' 클래스
- 사람 픽셀 → '사람' 클래스
- 도로 픽셀 → '도로' 클래스
이렇게 모든 픽셀에 의미를 부여하는 거죠. 완전 섬세한 작업이라 실력자들만 가능했는데... U-Net이 등장하면서 이 게임의 룰이 완전 바뀌었어요! 🎮
🔍 U-Net 아키텍처: 대체 왜 이름이 U자예요?
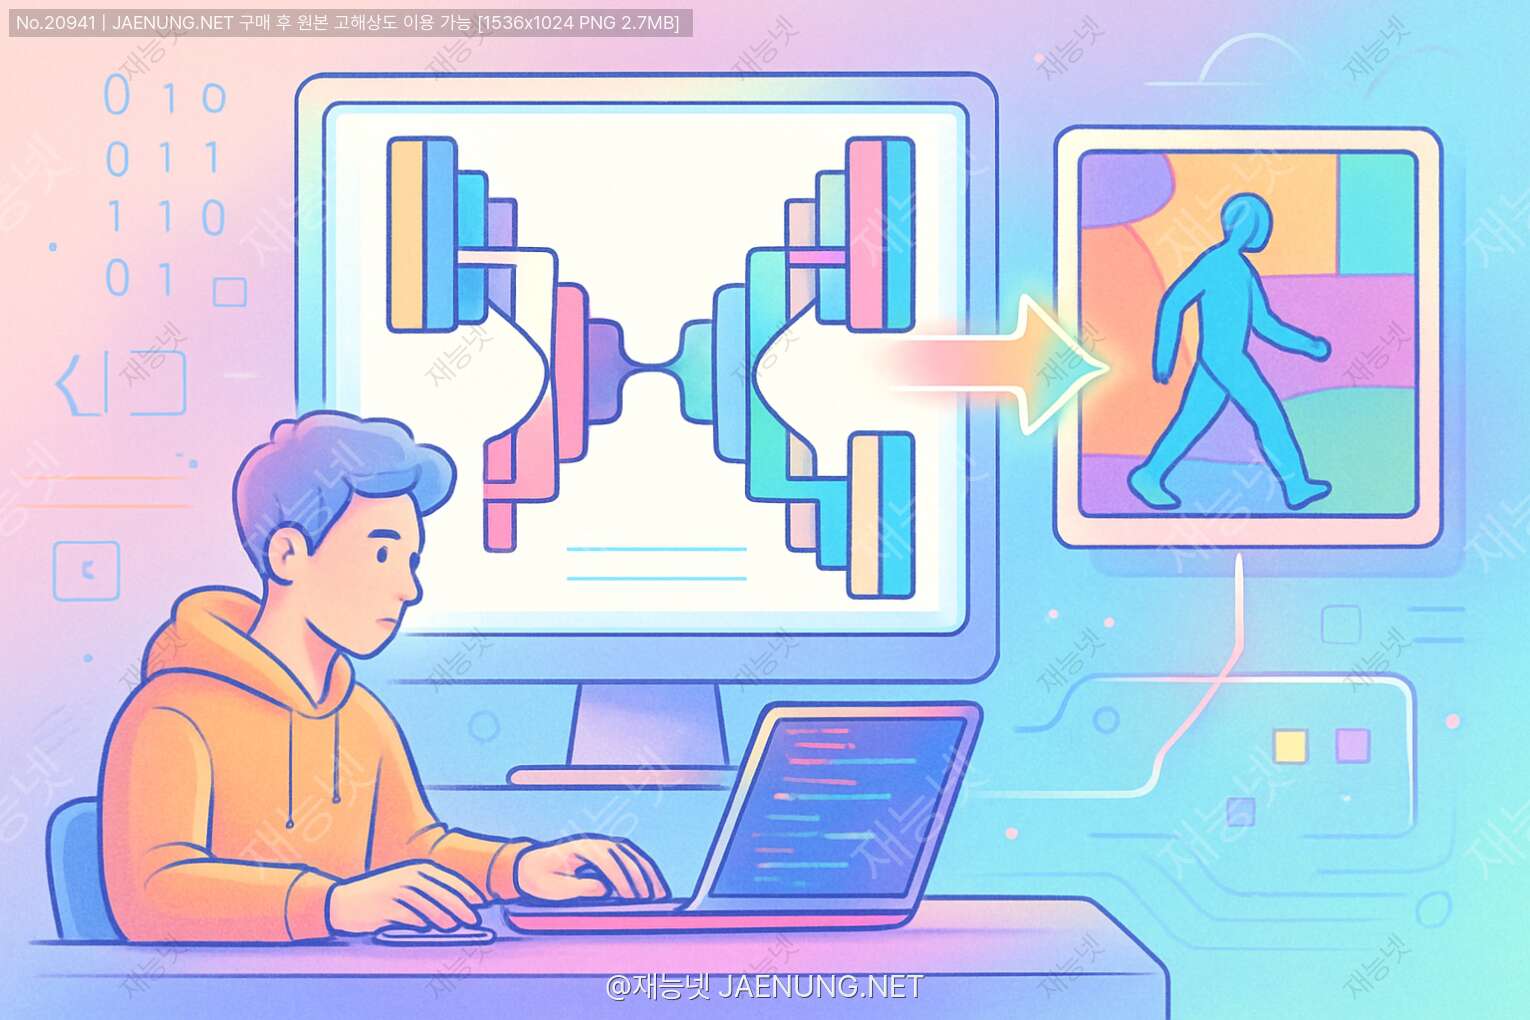
U-Net은 2015년 독일 프라이부르크 대학의 연구팀이 의료 영상 세그멘테이션을 위해 개발했어요. 이름이 U-Net인 이유는 네트워크 구조가 알파벳 'U'자 모양이기 때문이랍니다. 진짜 직관적인 이름이죠? ㅋㅋㅋ
U-Net의 구조는 크게 두 부분으로 나뉘어요:
- 인코더(Contracting Path): 이미지의 특징을 추출하는 부분
- 디코더(Expanding Path): 추출한 특징을 바탕으로 세그멘테이션 맵을 생성하는 부분
이 두 경로가 U자 모양으로 연결되어 있어서 U-Net이라고 부르는 거예요. 완전 찰떡같은 이름이죠? 😄
위 그림에서 볼 수 있듯이, U-Net은 왼쪽에서 오른쪽으로 갈수록 점점 좁아졌다가 다시 넓어지는 U자 형태를 가지고 있어요. 이 구조가 이미지의 문맥 정보와 공간 정보를 모두 잘 활용할 수 있게 해주는 비결이랍니다! 👍
⚙️ U-Net의 핵심 컴포넌트: 어떻게 작동하는 걸까요?
U-Net이 어떻게 그렇게 대박 성능을 내는지 궁금하시죠? 그 비밀은 바로 아키텍처의 세부 구성요소에 있어요! 하나씩 살펴볼게요~
1. 인코더(Contracting Path) 🔍
인코더는 CNN(합성곱 신경망)의 일반적인 구조를 따라요. 주요 구성요소는:
- 3x3 합성곱 레이어(Convolution Layer): 이미지의 특징을 추출
- ReLU 활성화 함수: 비선형성 추가
- 2x2 맥스 풀링(Max Pooling): 이미지 크기를 절반으로 줄이고 특징을 압축
각 다운샘플링 단계마다 특징 맵(feature map)의 채널 수는 2배로 증가해요. 이렇게 하면 네트워크가 더 복잡한 특징을 학습할 수 있게 되죠. 완전 똑똑한 구조예요! 🧠
2. 디코더(Expanding Path) 🔮
디코더는 인코더에서 압축된 정보를 다시 원래 이미지 크기로 복원하는 역할을 해요:
- 2x2 업컨볼루션(Up-convolution): 특징 맵의 크기를 2배로 키움
- 3x3 합성곱 레이어: 특징을 정제
- ReLU 활성화 함수: 비선형성 추가
각 업샘플링 단계마다 특징 맵의 채널 수는 절반으로 줄어들어요. 이렇게 하면 최종 출력에 가까워질수록 더 구체적인 공간 정보를 복원할 수 있게 되죠.
3. 스킵 커넥션(Skip Connections) ⛓️
U-Net의 진짜 핵심 비결은 바로 스킵 커넥션! 인코더의 특징 맵을 디코더의 해당 레이어에 직접 연결해주는 구조예요. 이게 왜 중요할까요?
- 다운샘플링 과정에서 손실된 공간 정보를 복원하는 데 도움을 줌
- 그래디언트 소실 문제를 완화하여 더 깊은 네트워크 학습이 가능
- 저수준 특징(경계선 등)과 고수준 특징(객체 인식 등)을 결합
스킵 커넥션 덕분에 U-Net은 적은 학습 데이터로도 정확한 세그멘테이션이 가능해졌어요. 진짜 혁신적인 아이디어죠! 👏
📝 PyTorch로 구현한 U-Net 핵심 구조
import torch
import torch.nn as nn

class DoubleConv(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.double_conv = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.double_conv(x)

class UNet(nn.Module):
    def __init__(self, in_channels=3, out_channels=1, features=[64, 128, 256, 512]):
        super().__init__()
        self.downs = nn.ModuleList()
        self.ups = nn.ModuleList()
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)

        # 인코더 부분
        for feature in features:
            self.downs.append(DoubleConv(in_channels, feature))
            in_channels = feature

        # 디코더 부분
        for feature in reversed(features):
            self.ups.append(
                nn.ConvTranspose2d(feature*2, feature, kernel_size=2, stride=2)
            )
            self.ups.append(DoubleConv(feature*2, feature))

        self.bottleneck = DoubleConv(features[-1], features[-1]*2)
        self.final_conv = nn.Conv2d(features[0], out_channels, kernel_size=1)

    def forward(self, x):
        skip_connections = []

        # 인코더 경로
        for down in self.downs:
            x = down(x)
            skip_connections.append(x)
            x = self.pool(x)

        x = self.bottleneck(x)
        skip_connections = skip_connections[::-1]  # 리스트 뒤집기

        # 디코더 경로
        for idx in range(0, len(self.ups), 2):
            x = self.ups[idx](x)
            skip_connection = skip_connections[idx//2]

            # 크기가 맞지 않을 경우 조정 (패딩 문제로 인해)
            if x.shape != skip_connection.shape:
                x = nn.functional.resize(x, size=skip_connection.shape[2:])

            concat_skip = torch.cat((skip_connection, x), dim=1)
            x = self.ups[idx+1](concat_skip)

        return self.final_conv(x)
위 코드는 PyTorch로 구현한 U-Net의 기본 구조예요. 실제로 이렇게 간단한 코드로 놀라운 성능을 발휘한다니... 딥러닝의 매력이죠! 😍
🚀 U-Net의 장점: 왜 이렇게 인기 있을까요?
U-Net이 시맨틱 세그멘테이션 분야에서 이렇게 인기를 끄는 이유가 있어요. 진짜 장점이 많거든요! 한번 살펴볼까요?
1. 적은 학습 데이터로도 좋은 성능 💪
U-Net의 가장 큰 장점은 적은 양의 학습 데이터로도 훌륭한 성능을 낸다는 점이에요. 의료 영상처럼 라벨링된 데이터를 구하기 어려운 분야에서 특히 유용하죠. 데이터 증강(Data Augmentation) 기법과 함께 사용하면 더욱 효과적이에요!
2. 정확한 경계 탐지 능력 🔎
스킵 커넥션 덕분에 U-Net은 객체의 경계를 매우 정확하게 탐지할 수 있어요. 이는 의료 영상에서 종양의 정확한 경계를 찾거나, 자율주행에서 도로와 보행자의 경계를 구분하는 데 아주 중요한 능력이죠!
3. 다양한 응용 분야 🌐
U-Net은 원래 의료 영상 세그멘테이션을 위해 개발됐지만, 지금은 다양한 분야에서 활용되고 있어요:
- 의료 영상 분석 (MRI, CT 스캔 등)
- 자율주행 차량의 도로 인식
- 위성 이미지 분석
- 얼굴 인식 및 분할
- 산업용 결함 탐지
이렇게 다양한 분야에 적용할 수 있다는 것도 U-Net의 큰 장점이에요. 재능넷에서도 이미지 처리 관련 프로젝트에 U-Net을 활용한 서비스가 인기를 끌고 있다고 하네요! 😉
4. 빠른 추론 속도 ⚡
U-Net은 구조가 상대적으로 단순해서 추론 속도가 빠른 편이에요. 실시간 처리가 필요한 응용 프로그램에서도 충분히 활용할 수 있죠. 요즘 같은 실시간 시대에 완전 필수 조건이잖아요! ㅋㅋ
🧪 U-Net 변형 모델들: 더 강력해진 버전들!
U-Net이 등장한 이후로 많은 연구자들이 이를 개선한 다양한 변형 모델들을 제안했어요. 몇 가지 주요 변형 모델을 살펴볼까요?
1. U-Net++ (Nested U-Net) 🔄
U-Net++는 인코더와 디코더 사이에 중첩된 스킵 경로를 추가한 모델이에요. 이렇게 하면 서로 다른 스케일의 특징들이 더 효과적으로 융합될 수 있어요.
주요 특징:
- 중첩된 스킵 경로로 더 정확한 세그멘테이션
- 깊이별 감독(Deep Supervision) 기법 적용
- 모델 가지치기(Pruning)를 통한 경량화 가능
2. Attention U-Net 👁️
Attention U-Net은 어텐션 메커니즘을 U-Net에 통합한 모델이에요. 어텐션 게이트(Attention Gate)를 사용해 중요한 특징에 더 집중할 수 있게 해줘요.
주요 특징:
- 어텐션 게이트로 관심 영역에 집중
- 노이즈와 관련 없는 영역의 영향 감소
- 작은 구조나 객체 검출 성능 향상
3. 3D U-Net 🧊
3D U-Net은 2D 이미지가 아닌 3D 볼륨 데이터(CT, MRI 등)를 처리하기 위해 확장된 모델이에요. 2D 연산을 3D로 확장했다고 보면 돼요.
주요 특징:
- 3D 합성곱 사용으로 볼륨 데이터 처리
- 의료 영상에서 종양 등의 3D 구조 세그멘테이션에 효과적
- 비디오 시퀀스 처리에도 활용 가능
4. TransUNet 🔄
최근에는 트랜스포머(Transformer) 구조를 U-Net에 결합한 TransUNet이 등장했어요. CNN의 지역적 특징 추출 능력과 트랜스포머의 전역적 관계 모델링 능력을 결합했죠.
주요 특징:
- CNN과 트랜스포머의 장점 결합
- 장거리 의존성(Long-range dependency) 포착 능력 향상
- 복잡한 구조의 세그멘테이션에서 뛰어난 성능
이런 다양한 변형 모델들 덕분에 U-Net은 계속해서 발전하고 있어요. 여러분의 프로젝트에 맞는 최적의 모델을 선택하는 것이 중요하겠죠? 재능넷에서도 이런 최신 기술을 활용한 프로젝트들이 많이 공유되고 있어요! 🚀
💻 U-Net 실전 적용: 어떻게 구현하고 학습시킬까요?
이론은 충분히 알아봤으니, 이제 U-Net을 실제로 어떻게 구현하고 학습시키는지 알아볼까요? 진짜 실전에서 써먹을 수 있는 팁들을 알려드릴게요! 🛠️
1. 데이터 준비 및 전처리 📊
세그멘테이션 모델 학습을 위해서는 입력 이미지와 해당 마스크(ground truth)가 필요해요:
- 데이터 수집: 도메인에 맞는 이미지와 세그멘테이션 마스크 수집
- 이미지 정규화: 픽셀값을 0~1 사이로 정규화 (모델 학습 안정화)
- 데이터 증강: 회전, 반전, 크기 조정 등으로 학습 데이터 다양화
데이터 증강은 특히 중요해요! U-Net 논문에서도 데이터 증강을 통해 적은 학습 데이터로도 좋은 성능을 낼 수 있다고 강조했거든요. 진짜 꿀팁이에요! 🍯
2. 손실 함수 선택 🎯
세그멘테이션 태스크에 적합한 손실 함수를 선택하는 것이 중요해요:
- Binary Cross-Entropy: 이진 세그멘테이션에 적합
- Dice Loss: 클래스 불균형 문제에 강인한 손실 함수
- Focal Loss: 어려운 샘플에 더 집중하는 손실 함수
- Combined Loss: BCE + Dice Loss 조합으로 더 좋은 성능
특히 의료 영상처럼 배경이 대부분이고 관심 영역이 작은 경우, Dice Loss나 Focal Loss가 효과적이에요. 진짜 성능 차이 엄청나요! 😲
📝 PyTorch로 구현한 Dice Loss
import torch
import torch.nn as nn

class DiceLoss(nn.Module):
    def __init__(self, smooth=1.0):
        super(DiceLoss, self).__init__()
        self.smooth = smooth

    def forward(self, predictions, targets):
        # 예측값과 타겟을 평탄화
        predictions = predictions.view(-1)
        targets = targets.view(-1)

        # 교집합 계산
        intersection = (predictions * targets).sum()

        # Dice 계수 계산
        dice = (2. * intersection + self.smooth) / (
            predictions.sum() + targets.sum() + self.smooth
        )

        # Dice Loss 계산 (1 - Dice 계수)
        return 1 - dice
3. 학습 전략 및 최적화 📈
U-Net 학습을 위한 몇 가지 팁을 알려드릴게요:
- 배치 크기: 메모리 한계 내에서 가능한 큰 배치 사용 (8-16 권장)
- 학습률: 1e-4 ~ 1e-3 사이의 값으로 시작, 학습률 스케줄링 적용
- 옵티마이저: Adam이나 AdamW 옵티마이저가 효과적
- 조기 종료: 검증 손실이 개선되지 않으면 학습 중단
또한 가중치 초기화도 중요해요. Kaiming 초기화나 Xavier 초기화를 사용하면 학습 초기에 안정적인 그래디언트를 얻을 수 있어요.
4. 평가 지표 📏
세그멘테이션 모델의 성능을 평가하기 위한 주요 지표들:
- IoU (Intersection over Union): 예측과 실제 마스크의 겹치는 정도
- Dice 계수: 2 * IoU / (1 + IoU)와 유사한 지표
- Pixel Accuracy: 올바르게 분류된 픽셀의 비율
- Precision & Recall: 정밀도와 재현율
IoU와 Dice 계수는 세그멘테이션에서 가장 많이 사용되는 지표예요. 특히 Dice 계수는 의료 영상 분야에서 표준 평가 지표로 사용되고 있어요.
이런 실전 팁들을 활용하면 여러분도 U-Net을 효과적으로 구현하고 학습시킬 수 있을 거예요! 재능넷에서 이런 딥러닝 프로젝트를 공유하면 많은 관심을 받을 수 있을 것 같네요~ 😊
🔮 U-Net의 미래: 어디로 발전하고 있을까요?
U-Net은 2015년 등장한 이후로 계속해서 발전하고 있어요. 앞으로 어떤 방향으로 발전할지 살펴볼까요?
1. 경량화 및 모바일 최적화 📱
모바일 기기나 엣지 디바이스에서도 U-Net을 효율적으로 실행할 수 있도록 하는 연구가 활발히 진행 중이에요. MobileNet이나 EfficientNet 같은 경량 백본을 U-Net에 적용하는 시도들이 있어요.
이런 경량화 모델들은 의료 현장이나 자율주행 차량 같은 실시간 처리가 필요한 환경에서 특히 중요해요. 진짜 실용적인 연구죠! 👍
2. 자기지도학습(Self-supervised Learning) 🤖
라벨링된 데이터가 부족한 상황에서도 효과적으로 학습할 수 있는 자기지도학습 방법을 U-Net에 적용하는 연구가 늘고 있어요. 이를 통해 적은 양의 라벨링된 데이터로도 더 좋은 성능을 낼 수 있게 되죠.
특히 의료 영상 분야에서는 라벨링이 비용이 많이 들기 때문에, 이런 접근 방식이 매우 유망해요. 완전 미래지향적인 연구죠! 🚀
3. 멀티모달 학습(Multimodal Learning) 🌈
다양한 종류의 데이터(이미지, 텍스트, 시계열 등)를 함께 활용하는 멀티모달 U-Net 모델들이 등장하고 있어요. 예를 들어, 의료 영상과 환자 기록을 함께 활용하는 모델이 있죠.
이런 접근 방식은 더 정확한 진단이나 예측을 가능하게 해요. 정보의 융합이 중요한 시대잖아요! 💡
4. 불확실성 추정(Uncertainty Estimation) 🎲
U-Net이 예측한 세그멘테이션 결과의 불확실성을 함께 제공하는 연구도 활발해요. 특히 의료 분야에서는 모델의 예측을 얼마나 신뢰할 수 있는지 아는 것이 중요하죠.
베이지안 U-Net이나 앙상블 방법을 통해 불확실성을 추정하는 접근 방식들이 연구되고 있어요. 이런 기술은 재능넷 같은 플랫폼에서도 신뢰성 있는 AI 서비스를 제공하는 데 큰 도움이 될 거예요!
이런 다양한 발전 방향을 보면, U-Net은 앞으로도 계속해서 시맨틱 세그멘테이션 분야의 중요한 기술로 자리매김할 것 같아요. 여러분도 이런 최신 트렌드를 따라가면서 프로젝트에 적용해보는 건 어떨까요? 재능넷에서 이런 최신 기술을 활용한 프로젝트를 공유하면 많은 관심을 받을 수 있을 거예요! 💫
📚 마무리: U-Net으로 시맨틱 세그멘테이션 마스터하기
지금까지 U-Net 아키텍처에 대해 깊이 있게 알아봤어요. 정말 많은 내용을 다뤘죠? 마지막으로 핵심 내용을 정리해볼게요!
핵심 요약 ✨
- U-Net은 인코더-디코더 구조와 스킵 커넥션을 결합한 혁신적인 아키텍처예요.
- 적은 학습 데이터로도 뛰어난 세그멘테이션 성능을 보여줘요.
- 의료 영상부터 자율주행까지 다양한 분야에 적용되고 있어요.
- U-Net++, Attention U-Net 등 다양한 변형 모델이 개발되고 있어요.
- 경량화, 자기지도학습 등 다양한 방향으로 발전하고 있어요.
U-Net은 단순하면서도 강력한 아키텍처로, 딥러닝을 처음 접하는 분들도 비교적 쉽게 이해하고 구현할 수 있어요. 그래서 재능넷 같은 플랫폼에서도 U-Net을 활용한 프로젝트가 인기를 끌고 있는 것 같아요! 😊
다음 단계로는? 🚶♂️
U-Net에 대해 더 알아보고 싶다면 다음과 같은 방향으로 공부해보는 것을 추천해요:
- 직접 간단한 U-Net 모델을 구현하고 학습시켜보기
- Kaggle 같은 플랫폼의 세그멘테이션 경진대회에 참여해보기
- 최신 U-Net 변형 모델들의 논문 읽어보기
- 자신만의 응용 분야에 U-Net 적용해보기
특히 의료 영상이나 위성 이미지 분석 같은 분야에서는 U-Net의 활용 가능성이 무궁무진해요. 여러분의 창의적인 아이디어로 U-Net을 활용한 새로운 서비스를 개발해보는 건 어떨까요?
이 글이 여러분의 U-Net 이해에 도움이 되었길 바라요! 딥러닝의 세계는 정말 넓고 깊지만, 한 걸음씩 나아가다 보면 어느새 전문가가 되어 있을 거예요. 화이팅! 🔥
더 많은 딥러닝 관련 지식과 프로젝트를 찾고 계신다면, 재능넷의 '지식인의 숲' 메뉴를 방문해보세요. 다양한 전문가들이 공유하는 유익한 정보들을 만나볼 수 있을 거예요! 💡

댓글 작성
이 글에 대한 여러분의 생각을 들려주세요
로그인이 필요합니다
댓글을 작성하려면 먼저 로그인해주세요.
댓글 0
지식인의 숲 - 지적 재산권 보호 고지
지적 재산권 보호 고지
- 저작권 및 소유권: 본 컨텐츠는 재능넷의 독점 AI 기술로 생성되었으며, 대한민국 저작권법 및 국제 저작권 협약에 의해 보호됩니다.
- AI 생성 컨텐츠의 법적 지위: 본 AI 생성 컨텐츠는 재능넷의 지적 창작물로 인정되며, 관련 법규에 따라 저작권 보호를 받습니다.
- 사용 제한: 재능넷의 명시적 서면 동의 없이 본 컨텐츠를 복제, 수정, 배포, 또는 상업적으로 활용하는 행위는 엄격히 금지됩니다.
- 데이터 수집 금지: 본 컨텐츠에 대한 무단 스크래핑, 크롤링, 및 자동화된 데이터 수집은 법적 제재의 대상이 됩니다.
- AI 학습 제한: 재능넷의 AI 생성 컨텐츠를 타 AI 모델 학습에 무단 사용하는 행위는 금지되며, 이는 지적 재산권 침해로 간주됩니다.






아직 댓글이 없습니다.